Specula如何让AI自动发现并发Bug:形式化验证的工程化突破
在软件工程领域,有一类错误如同幽灵般难以捉摸——它们并非源于明显的逻辑错误或边界条件疏忽,而是在多个线程、进程或节点以特定顺序交互时悄然浮现。这类并发 bug 往往潜伏数年,直到某个极其罕见的执行路径被触发,才导致系统崩溃、数据丢失或服务中断。传统测试手段对此束手无策,因为穷举所有可能的交错组合在计算上不可行。形式化方法,尤其是基于 TLA+ 的模型检查,理论上能系统性地探索所有可达状态,但其高昂的人工成本使其长期局限于学术研究或极少数关键系统。
然而,这一局面正在被改变。截至 2026 年 8 月 19 日,开源项目 Specula 已在 67 个真实世界的开源系统中自动发现了 382 个可复现的并发 bug,覆盖数据库(如 MongoDB、ScyllaDB)、分布式协调服务(如 Etcd、HashiCorp Raft)、消息队列(RabbitMQ/ra)乃至编译器运行时(GCC libgomp、LLVM libomp)。更关键的是,它让普通开发者无需掌握 TLA+ 或模型检查知识,即可启动这一强大的验证流程。
并发 Bug 的本质与形式化验证的困境
并发 bug 的难解之处在于其“非局部性”。单个线程的行为可能是完全正确的,但当多个正确行为在特定时序下组合,却可能违反系统的全局不变量。例如,在分布式共识协议中,“已提交的日志条目不能被覆盖”是一个基本安全属性。然而,若网络分区、节点重启与日志截断操作以某种特定顺序发生,该属性可能被破坏,而这种组合在常规压力测试中几乎不可能被覆盖。
TLA+ 提供了一种数学化的建模语言,允许开发者将系统抽象为状态机,并通过 TLC 模型检查器穷举所有可能的状态转移。一旦某条路径违反了预设的不变量(如“多数派确认的数据永不丢失”),TLC 会返回一个反例轨迹。问题在于,构建一个既精确又可验证的 TLA+ 模型需要深厚的专业知识:既要准确捕捉系统的核心语义,又要避免因过度细节导致状态空间爆炸;既要确保模型与真实代码行为一致,又要能将反例映射回实际执行环境。
过去,为一个复杂系统(如 ZooKeeper)手写高质量规约往往耗费数月时间。这种人力密集型模式显然无法扩展到成千上万的开源项目。因此,尽管形式化方法在理论上强大,但在工程实践中始终未能普及。
Specula 的核心架构:四阶段闭环验证流程
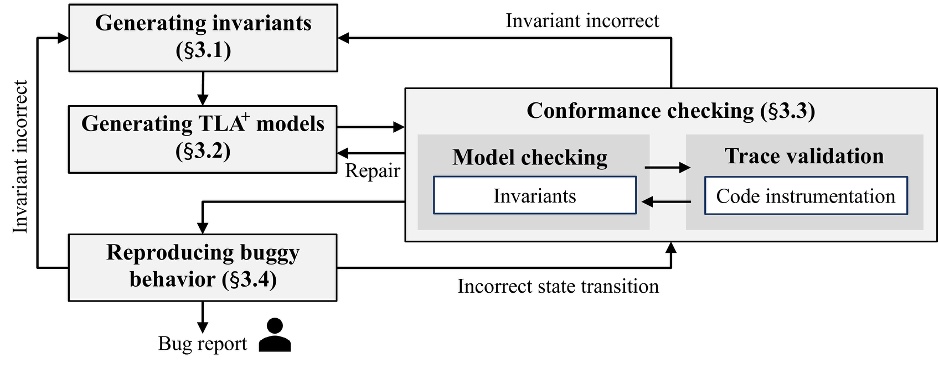
Specula 的突破在于将大语言模型(LLM)作为智能代理(agent),但并非简单地让其“一次性生成 TLA+ 文件”。相反,它设计了一个由四个可验证阶段组成的闭环流程,每个阶段都产出明确的 artifact,并接受下一阶段的检验:
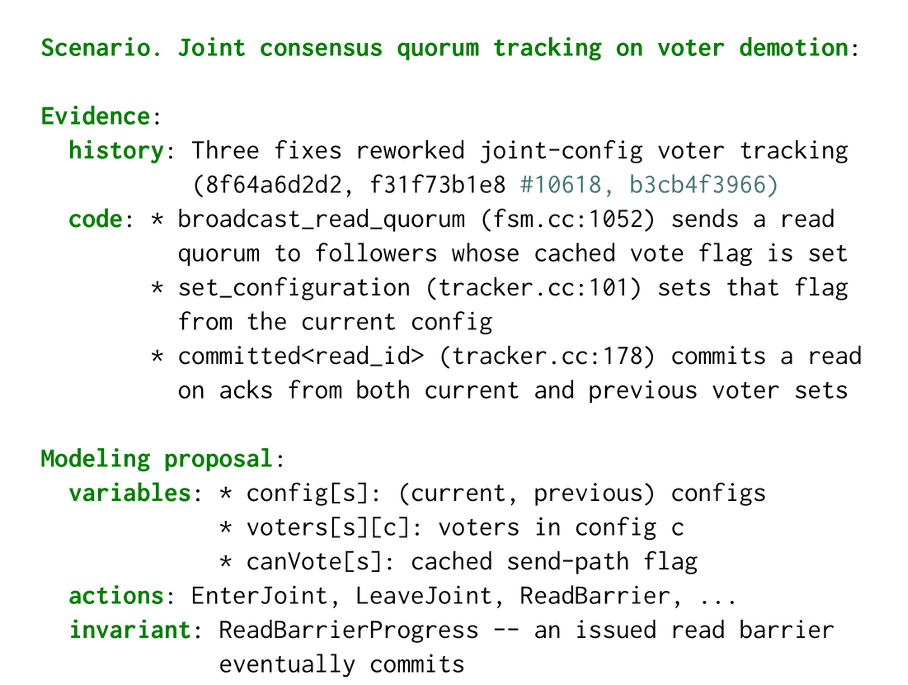
第一阶段:从多源证据中自动提炼不变量。Specula 不依赖模糊的自然语言描述,而是要求 agent 从代码、注释、测试用例、GitHub issue、PR 讨论及安全公告中提取具体的正确性性质。例如,在分析 MongoDB 的 Raft 实现时,agent 发现其并未严格遵循原始论文的持久化假设,而是采用“多数节点内存持有即可提交”的优化策略。这一发现直接来源于对历史提交记录和 issue 讨论的挖掘。据统计,Specula 生成的不变量中,87.35% 引用了代码或注释,74.34% 关联了 issue 或 PR,确保了性质的实现相关性。
第二阶段:基于高风险场景生成定制化模型。并非所有系统行为都需要建模。Specula 从文档、测试失败记录和历史 bug 报告中识别出最易出错的交互场景(如 ScyllaDB Raft 中的 voter demotion 过程),并围绕这些场景构建精简模型。该模型仅保留与场景相关的变量、动作和故障模式,大幅压缩状态空间。正是这种场景驱动的建模策略,使 Specula 能在 ScyllaDB 中发现一个在配置变更期间卡住 read barrier 的新 bug——该问题此前已被修复三次,但仍有遗漏路径。
第三阶段:通过真实执行轨迹验证模型一致性。一个能运行的 TLA+ 模型未必忠于真实代码。Specula 自动对目标程序进行插桩,在受控环境下收集真实执行轨迹(包括线程调度、消息传递、故障注入等事件序列),然后逐步检查这些轨迹是否能被 TLA+ 模型所接受。若在某一步出现分叉(即真实行为无法在模型中重现),系统会定位模型与实现之间的语义差异,触发模型修正。
第四阶段:将反例确定性地复现为代码测试。当模型检查发现违反不变量的反例后,Specula 将其转换为一条精确的事件序列(如“线程 A 在屏障等待,线程 B 完成分离任务但未设置 pending 标记”),并在真实系统中通过控制并发顺序和故障注入重放该行为。成功复现后,整个过程被封装为一个可重复运行的测试用例,便于开发者理解和修复。
双闭环机制:让 AI Agent 在失败中学习
上述四阶段并非线性流水线,而是嵌入了两条相互耦合的自我演化闭环,使系统具备容错与进化能力:
模型—代码一致性闭环在轨迹验证与模型检查之间往返。轨迹验证确保模型不过度偏离实现,而模型检查则防止 agent 为迎合轨迹而弱化不变量或放宽约束。这种张力保证了模型既忠实又具有足够的抽象能力。
Bug 复现闭环处理反例无法在代码中重放的情况。此时,系统将分叉点信息反馈至前一闭环,重新审视模型结构、插桩逻辑或不变量强度。若复现成功但未观察到明显错误(如系统通过恢复机制掩盖了后果),则进一步判断是否性质定义过强,或需引入更精细的可观测指标。
这种设计承认了 LLM 的不完美性——它会犯错,但每次失败都转化为新的证据,推动下一轮更准确的判断,而非陷入无限重试。
实证效果:从 GCC 死锁到大规模验证
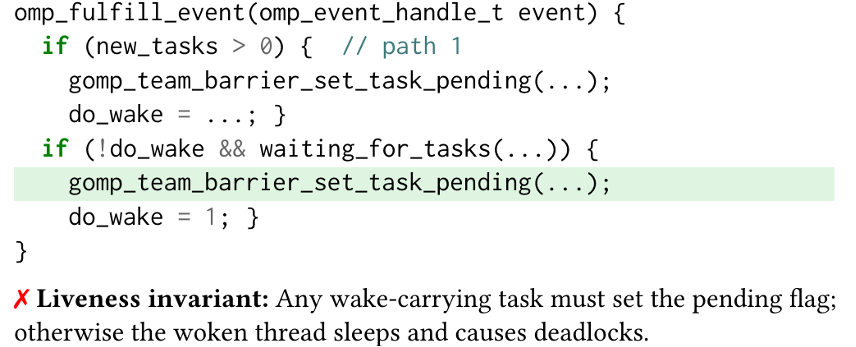
Specula 的有效性在多个真实案例中得到验证。最具代表性的是 GCC 的 OpenMP 运行时库 libgomp 中的一个死锁 bug。该问题自 2021 年引入后潜伏五年,其触发条件极为苛刻:必须有一个外部线程在其他所有线程都进入屏障等待循环后,才完成一个分离任务;而该唤醒路径意外遗漏了“仍有任务待处理”的标记。结果,被唤醒的线程因看不到任务而重新休眠,导致所有线程永久阻塞在屏障处。
Specula 通过分析 libgomp 的代码和历史 issue,提炼出“携带唤醒任务的路径必须设置待处理标记”这一活性不变量,并构建了包含线程创建、任务分发、屏障同步和分离操作的精简模型。模型检查迅速发现违反该不变量的路径,随后在真实环境中成功复现死锁,并生成测试用例提交给 GCC 社区。
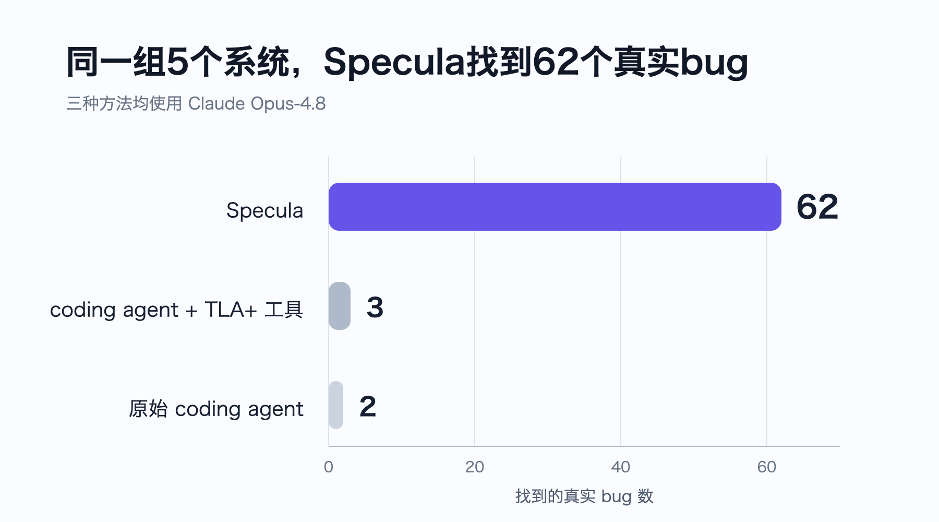
在对比实验中,Specula 的优势更为显著。在 5 个代表性系统(包括 Etcd 和 Raft 库)上,原始 Claude Code 仅发现 2 个 bug,配备 TLA+ 工具的 Claude Code 发现 3 个,而 Specula 找到 62 个经人工核验的真实 bug。差距主要源于其场景化建模、一致性验证和复现闭环——这些机制有效过滤了假阳性,并聚焦于真正危险的执行路径。
在性能方面,Specula 在 48 个项目上的端到端验证耗时中位数为 3.69 小时(范围 1.43–9.86 小时),token 成本中位数 57 美元。这意味着过去需要数月的人工规约工作,如今可在几个小时内自动化完成,使得对大量开源项目的批量验证成为可能。
工程意义:形式化方法的民主化
Specula 的真正价值不仅在于 bug 数量,而在于它改变了形式化验证的使用范式。过去,TLA+ 是专家的专属工具;现在,它通过 Specula 成为普通开发者的工程选项。基础软件团队可在 CI/CD 流程中集成 Specula,作为静态分析和模糊测试之外的深层验证层;形式化专家则从繁琐的建模工作中解放,专注于更高层次的性质设计与结果解释;而对于广大开发者,“用形式化方法检查我的系统”不再是一个遥不可及的概念,而是一条 specula run 命令即可启动的自动化流程。
目前,Specula 支持 Claude Code、Codex、Copilot CLI、OpenCode 和 Pi 等多种 coding agent,并提供灵活的扩展接口。用户既可使用默认配置快速扫描项目,也可自定义场景和不变量模板以适应特定需求。
随着 AI 编程代理能力的持续进化,Specula 所代表的“AI + 形式化方法”融合路径,有望成为保障关键软件可靠性的新标准。它不仅提升了 bug 发现的深度和广度,更重要的是,将一种曾被视为理论奢侈品的技术,转化为了可规模化部署的工程基础设施。