Qwen3.8-Flash逆势降价:大模型价格战转向架构效率竞争
在人工智能产业发展的关键节点上,价格从来不只是数字,而是技术路线与商业逻辑的集中体现。2026年8月,当DeepSeek、Anthropic、OpenAI等头部厂商相继提高API调用费用时,阿里通义千问却反其道而行之,发布了定价仅为Qwen3.8-Max十二分之一的Qwen3.8-Flash。这一举动表面上看是价格策略的调整,实则揭示了大模型竞争范式的根本性转变——从单纯追求参数规模,转向对单位算力智能产出效率的极致优化。
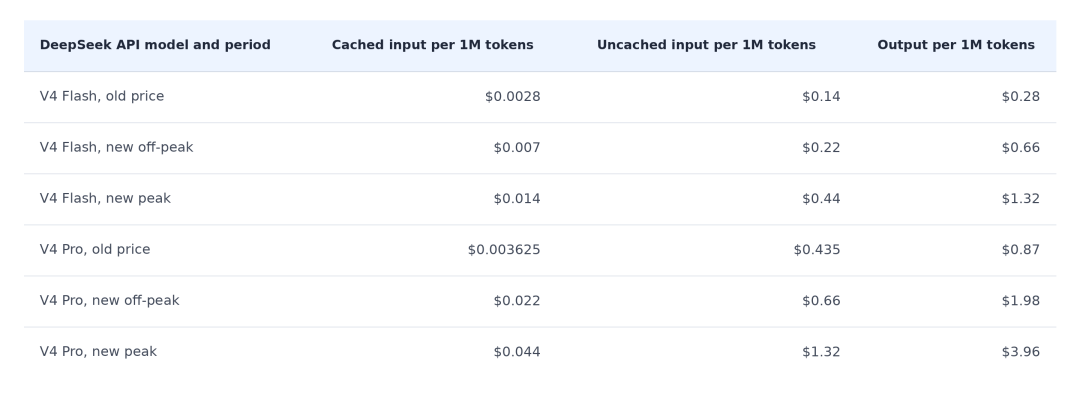
过去两年,大模型行业经历了前所未有的价格下行周期。厂商通过巨额补贴将推理成本压至历史低位,使得开发者能够以极低成本接入先进AI能力。然而,这种模式在2026年下半年遭遇严峻挑战。推理需求的指数级增长远超算力供给的线性扩张,尤其是智能体(Agent)应用的普及,将原本单次问答的调用模式转变为持续数小时的多轮交互任务。账单结构从“按次计费”演变为“按任务时长计费”,使得此前依赖补贴维持的低价体系难以为继。
在此背景下,Qwen3.8-Flash的逆势降价显得尤为引人注目。其核心定价策略为每百万token输入1元、输出3元,显著低于DeepSeek V4 Flash在8月17日调价后的闲时价格。更值得注意的是,这一低价并非源于短期市场补贴,而是建立在全新的模型架构基础之上。Qwen团队明确表示,该模型是Qwen4架构的预演版本,旨在通过底层技术创新重构成本结构。
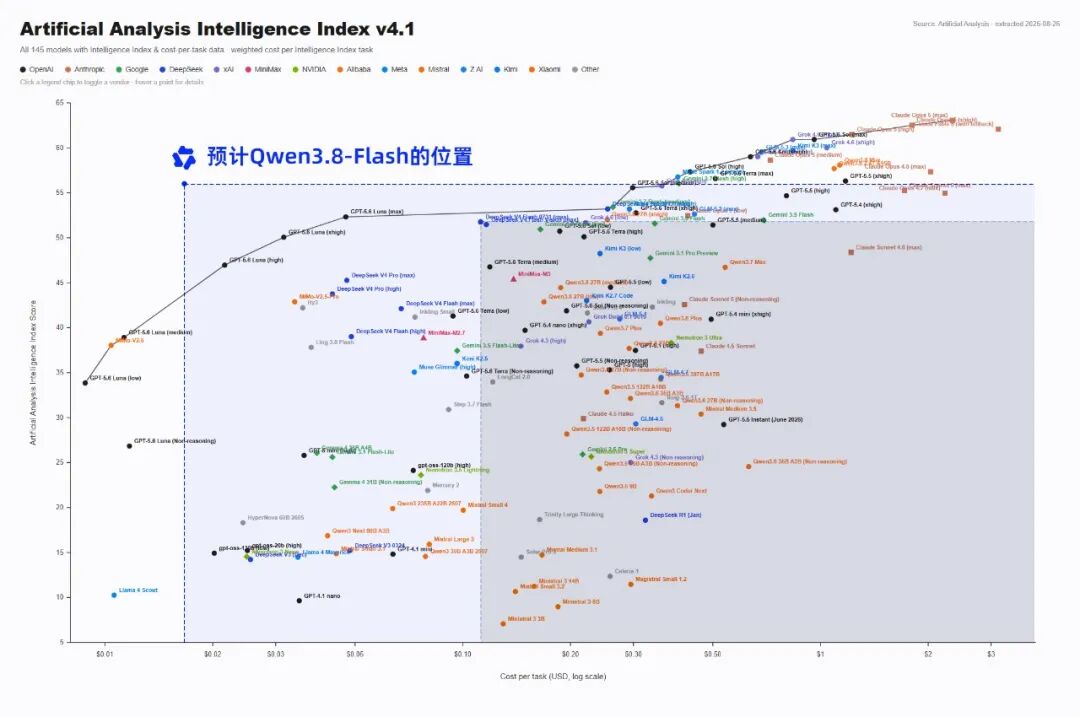
衡量大模型性价比的标准正在发生深刻变化。“每百万token价格”这一传统指标已无法准确反映真实使用成本。行业分析机构Artificial Analysis提出的“每任务成本”概念逐渐成为新的参考基准。该指标综合考虑模型完成特定任务所需的token数量、调用次数及失败重试概率,更能体现实际应用场景中的经济性。例如,Claude Sonnet 5虽然保持了与前代相同的token单价,但由于智能体轮次增加至三倍,导致每任务成本翻倍。这揭示了一个关键事实:在复杂任务场景下,模型的单步成功率与token效率比单纯的单价更具决定性意义。
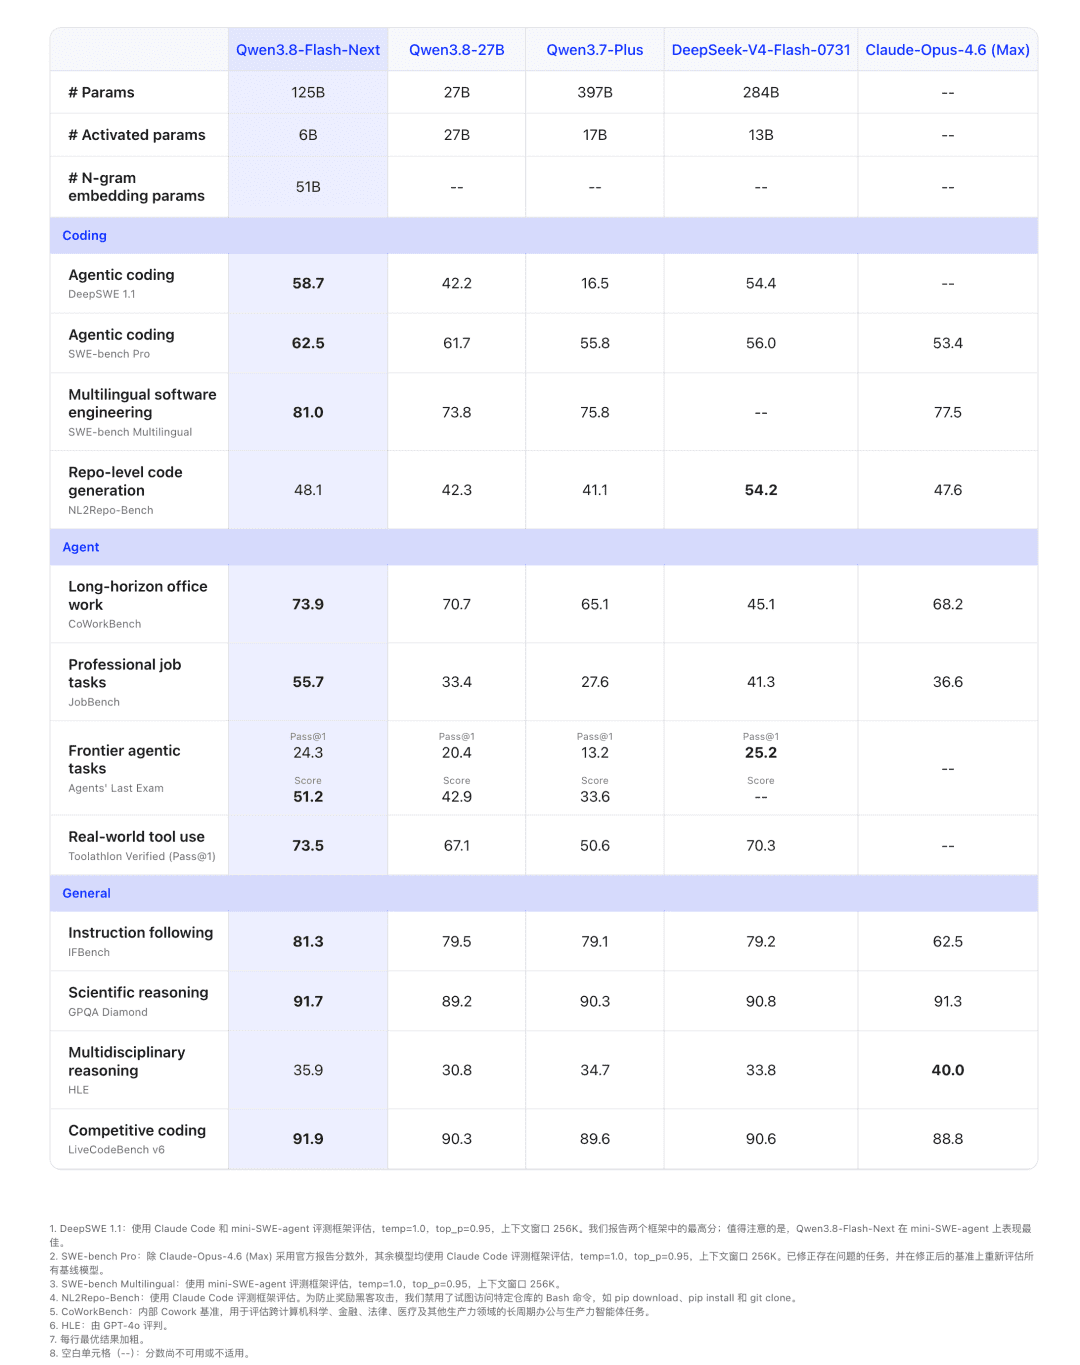
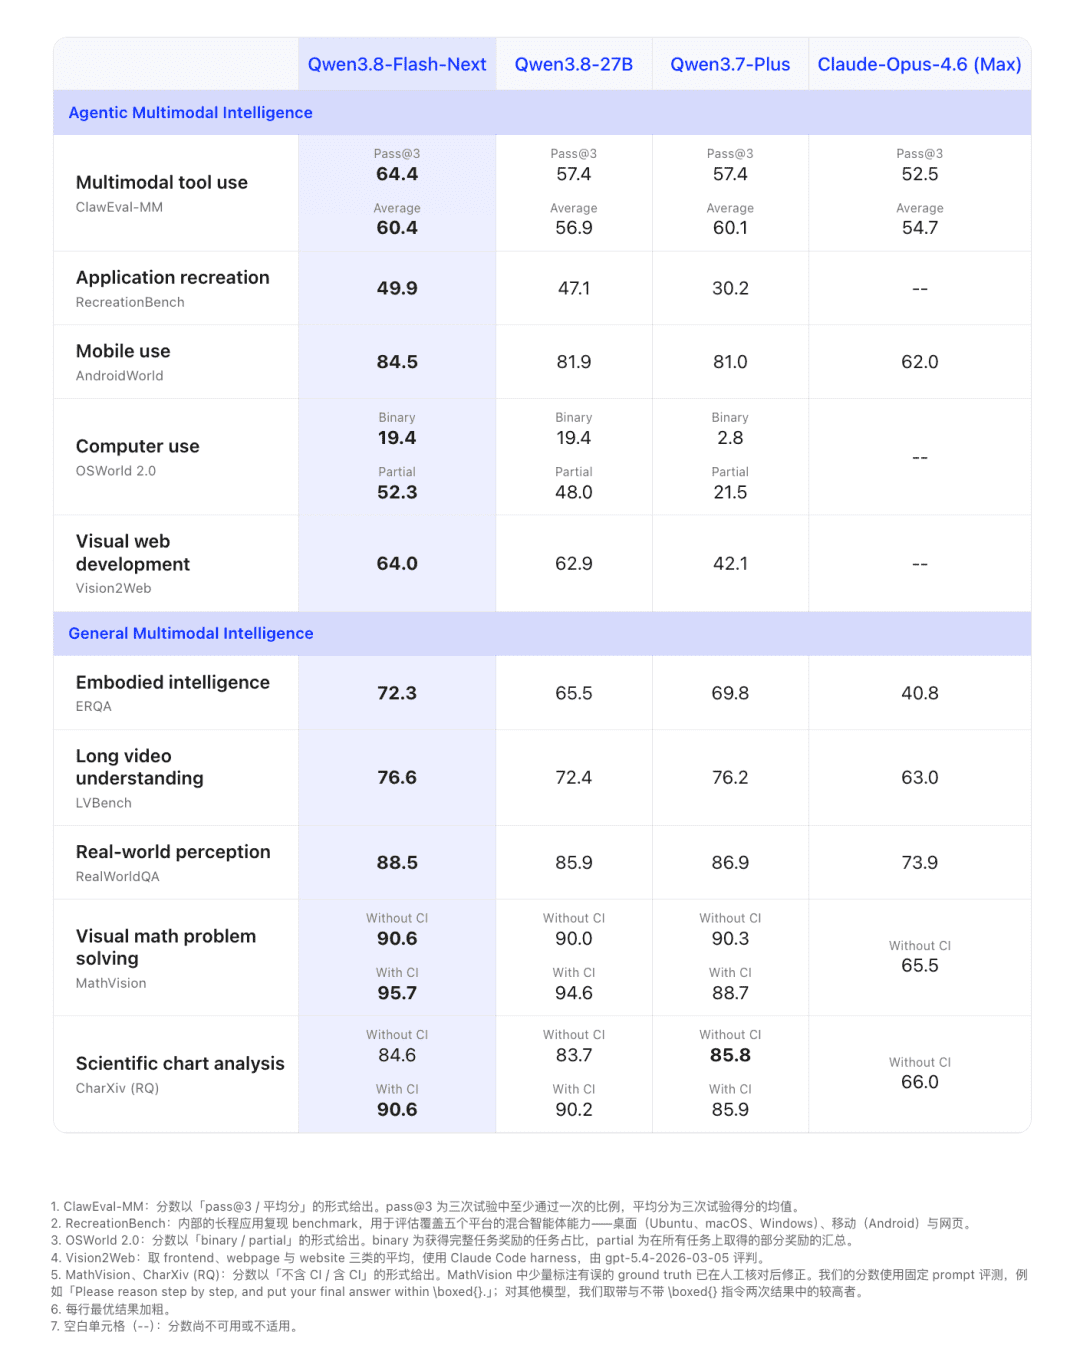
Qwen3.8-Flash正是针对这一新标准进行优化的产物。在DeepSWE 1.1智能体编程基准上,其得分达到58.7分,远超参数规模为其三倍的前代Qwen3.7-Plus(16.5分)。在长周期办公任务CoWorkBench和专业岗位任务JobBench上,分别取得73.9分和55.7分,明显优于Claude Opus 4.6(Max)的68.2分和36.6分。尽管在HLE基准上略逊于Opus 4.6,在仓库级代码生成NL2Repo-Bench上不及DeepSeek-V4-Flash-0731,但其综合性价比优势依然显著。
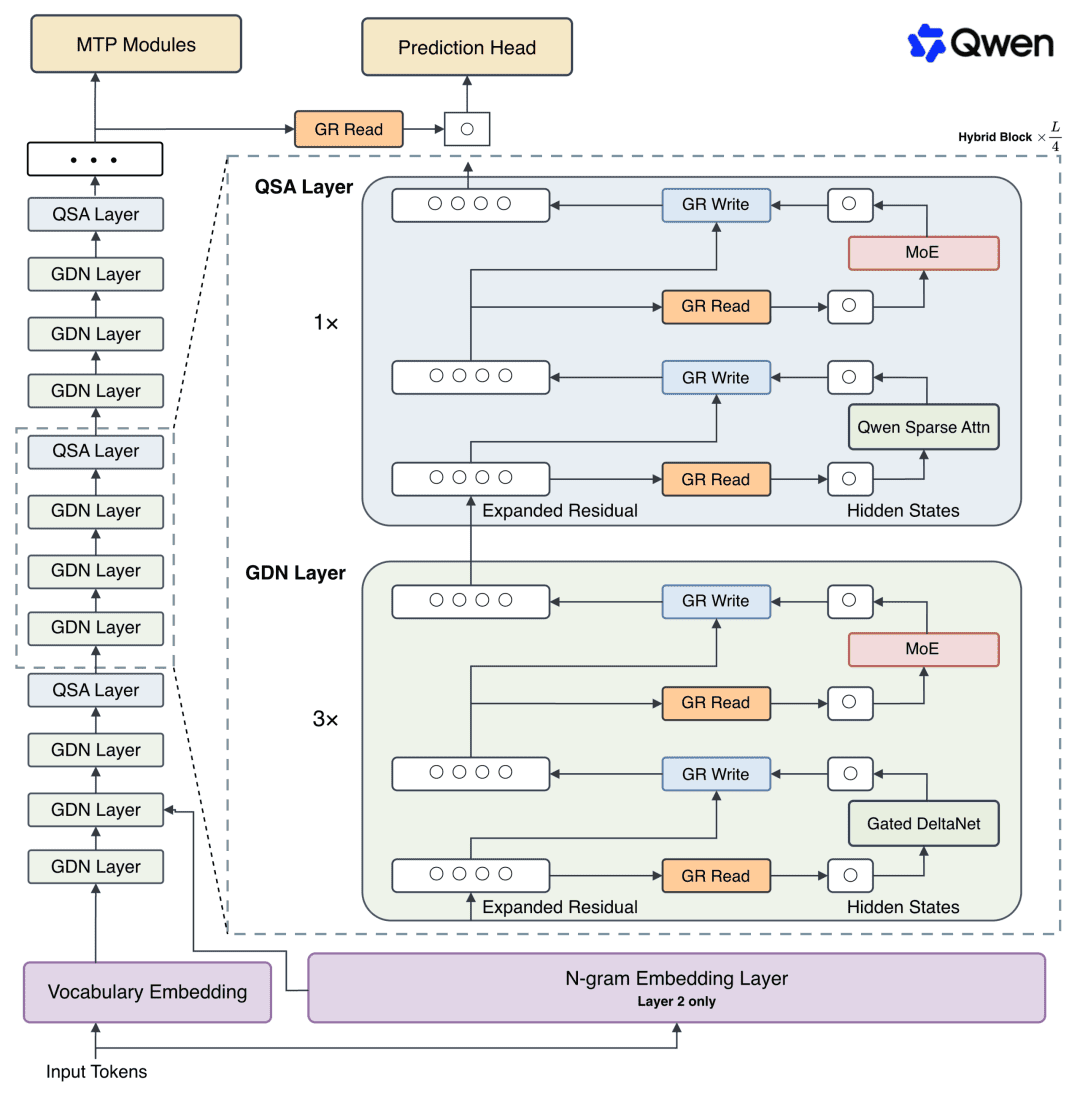
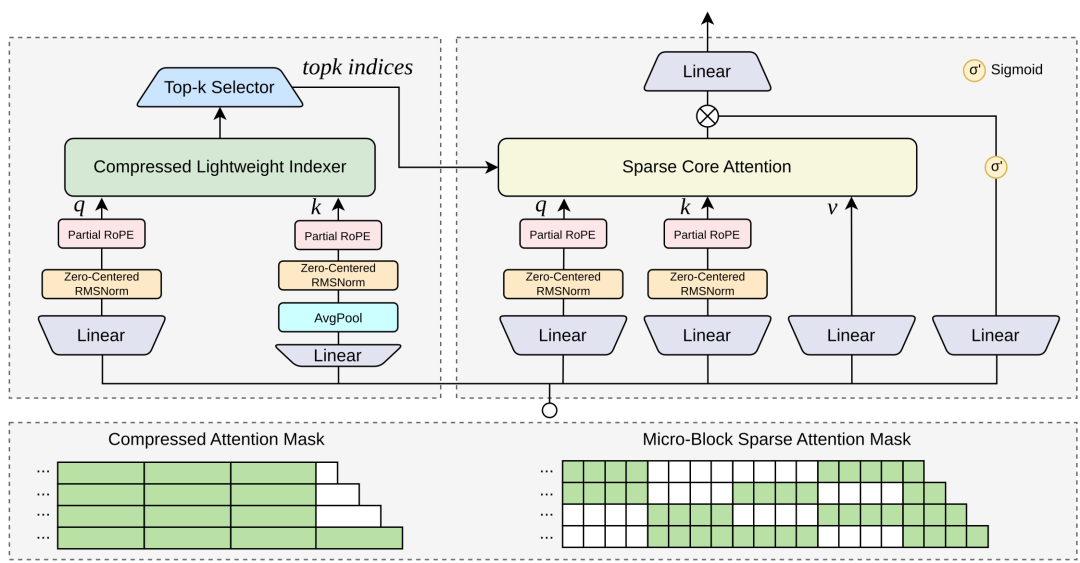
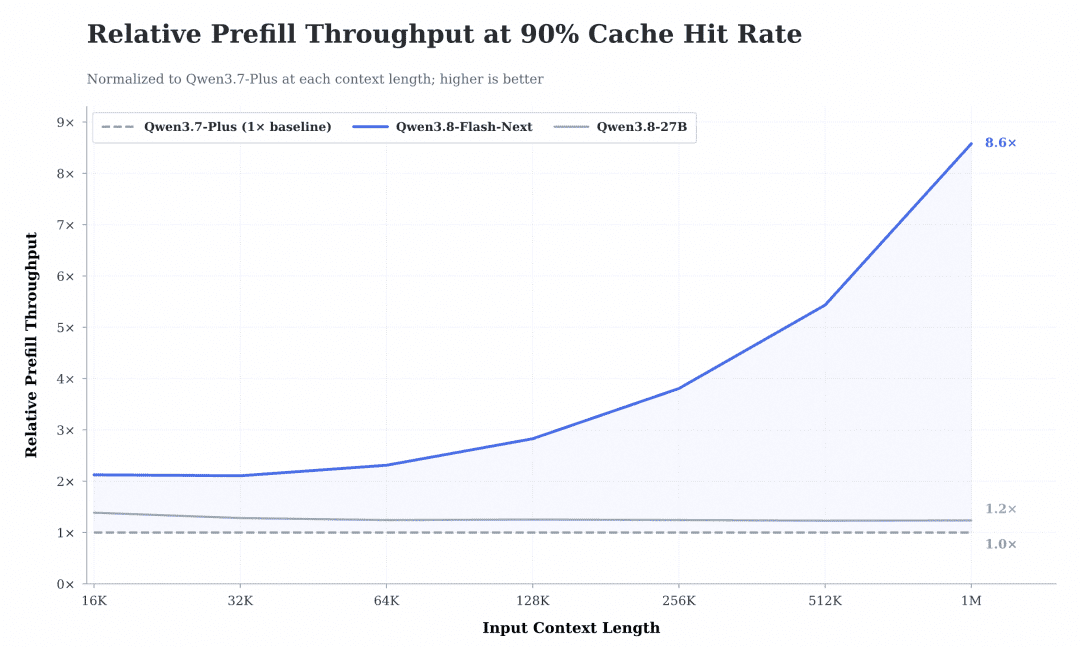
支撑这一性能突破的是四大核心技术革新。首先是注意力机制的混合架构设计。Qwen3.8-Flash采用Gated DeltaNet(GDN)与自研Qwen Sparse Attention(QSA)的组合方案。GDN负责高效记忆管理,通过门控机制快速清除过期信息,delta rule实现特定位置的精确更新;QSA则专注于精准查找,通过micro-block级别的序列压缩减少索引开销。在1M token上下文场景下,该方案实现了Prefill阶段最高7.6倍、Decode阶段4.9倍的加速效果。
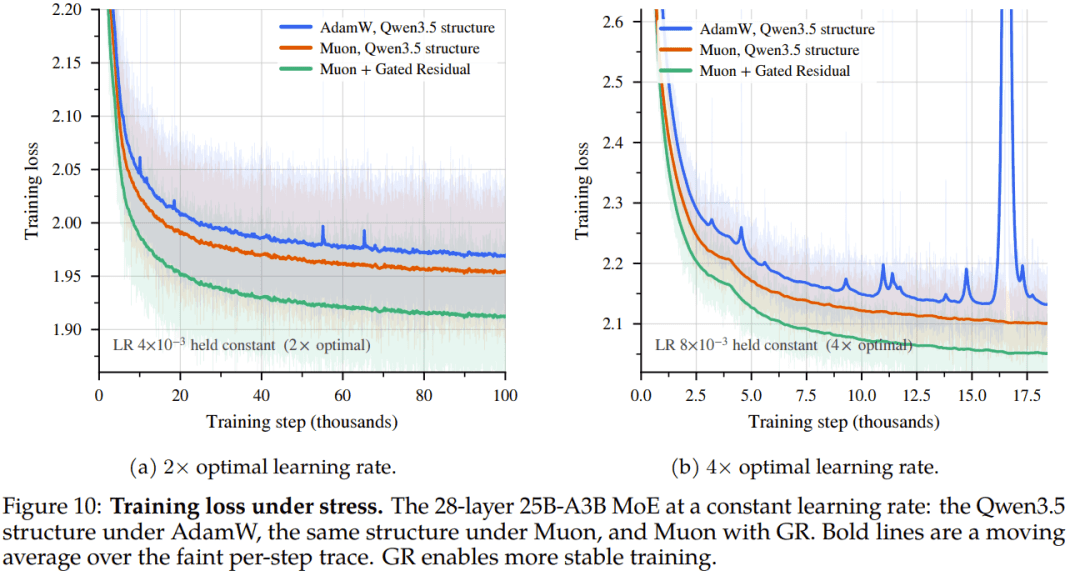
其次是残差连接的重构。传统Transformer的单一残差流容易导致深层网络中的信息稀释问题。Qwen引入的Gated Residual(GR)将信息通道扩展为四条并行分支,模型可根据内容动态分配读写权重。实验观察显示,其中一条分支自然形成了连接首层与中后层的长距离信息通路,有效保留了早期特征。同时,GR支持FP8精度存储,进一步降低访存开销。
第三项创新是N-gram Embedding的大规模应用。Qwen3.8-Flash额外引入51B参数的N-gram Embedding,通过结合当前token与前序token的局部上下文提供增强表示。关键在于,这些参数的查询索引可在计算开始前确定,因此能够存储在主机内存中,通过异步预取与GPU计算重叠,避免占用昂贵的显存资源。这种设计在几乎不增加每token计算成本的前提下,显著扩展了模型的知识容量。
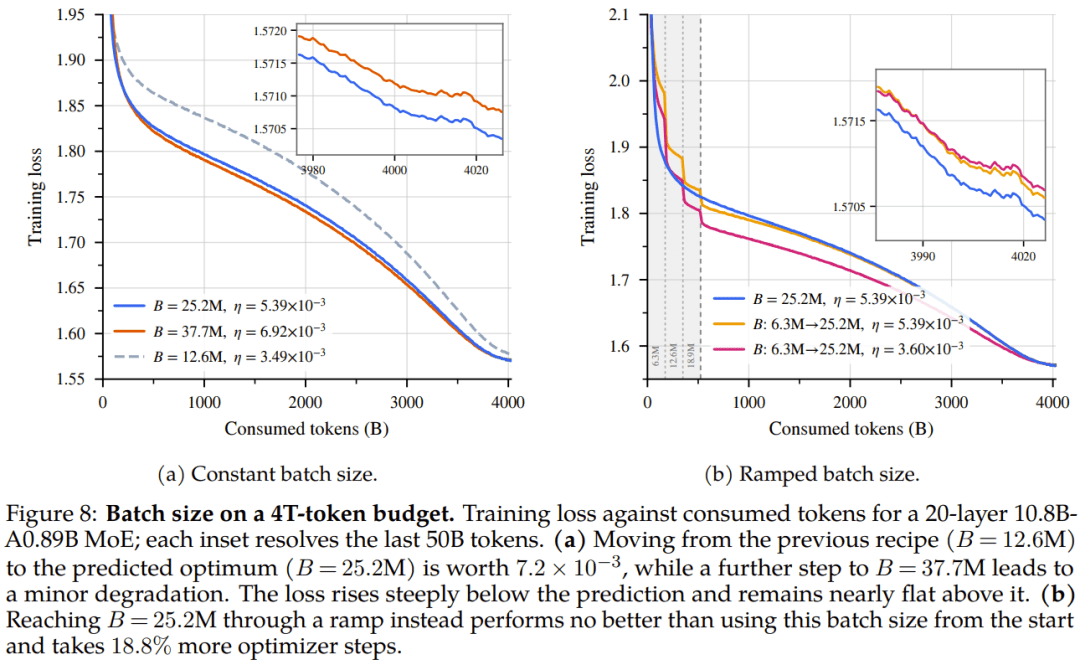
最后是训练优化体系的协同设计。模型采用Muon优化器进行训练,并针对新架构特点进行了工程化改进。具体包括:将真正作为二维线性映射的参数(如Attention、GDN权重)交由Muon处理,而Embedding、MoE Router等低秩参数继续使用AdamW;对融合存储的参数矩阵进行拆分后再执行正交化。这些措施使得模型能够稳定使用更大的学习率和批量大小,训练开销仅为前代Qwen3.7-Plus的九分之一。
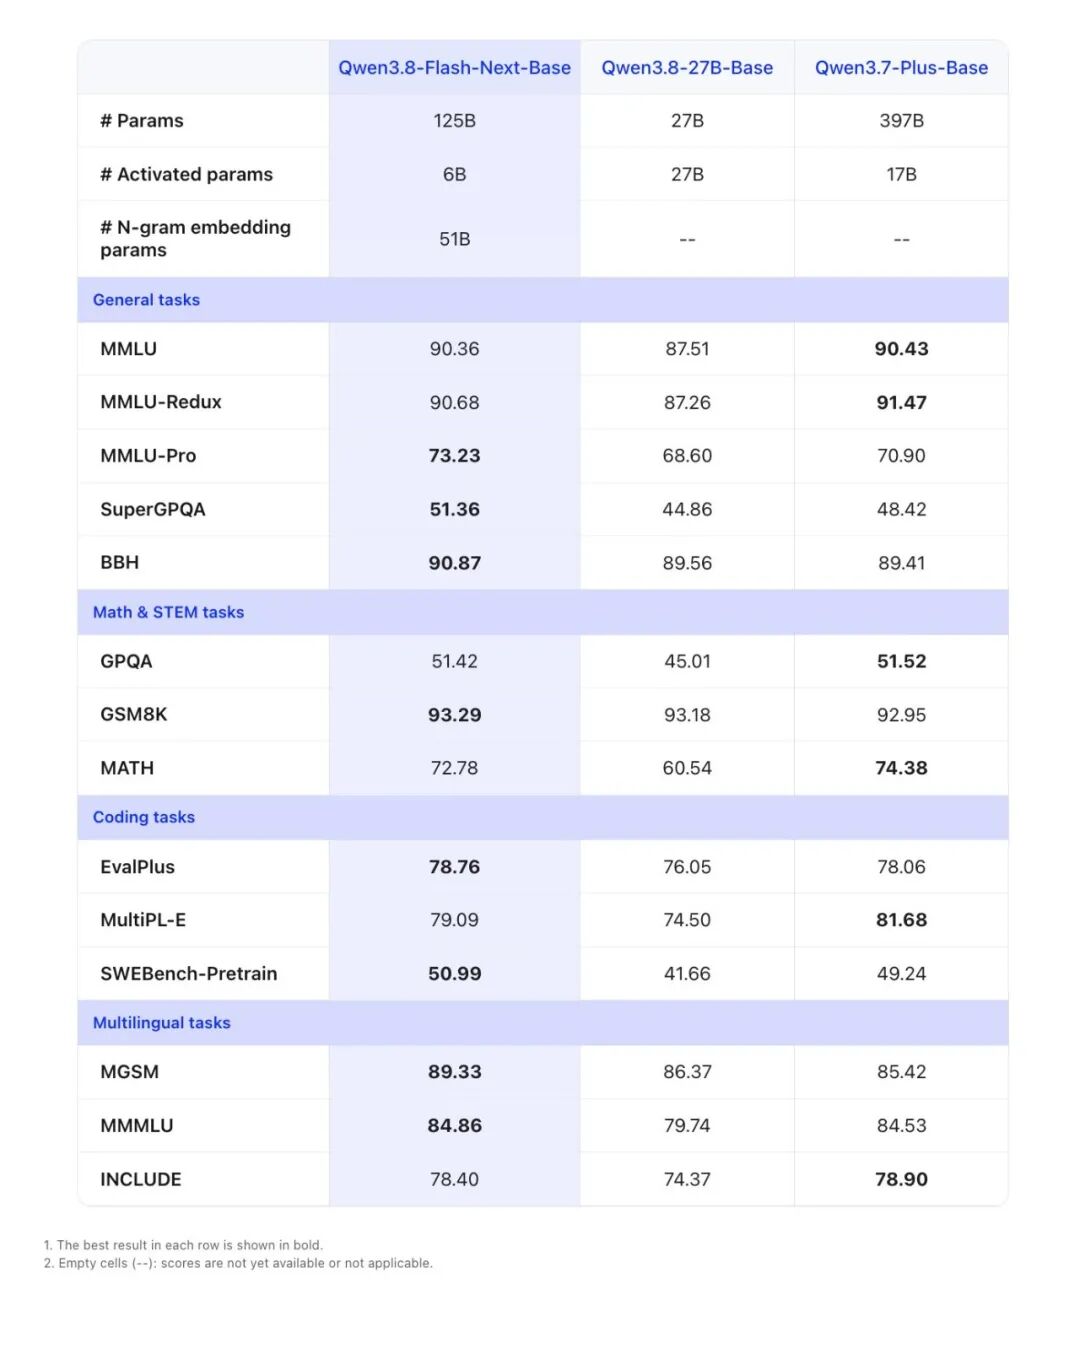
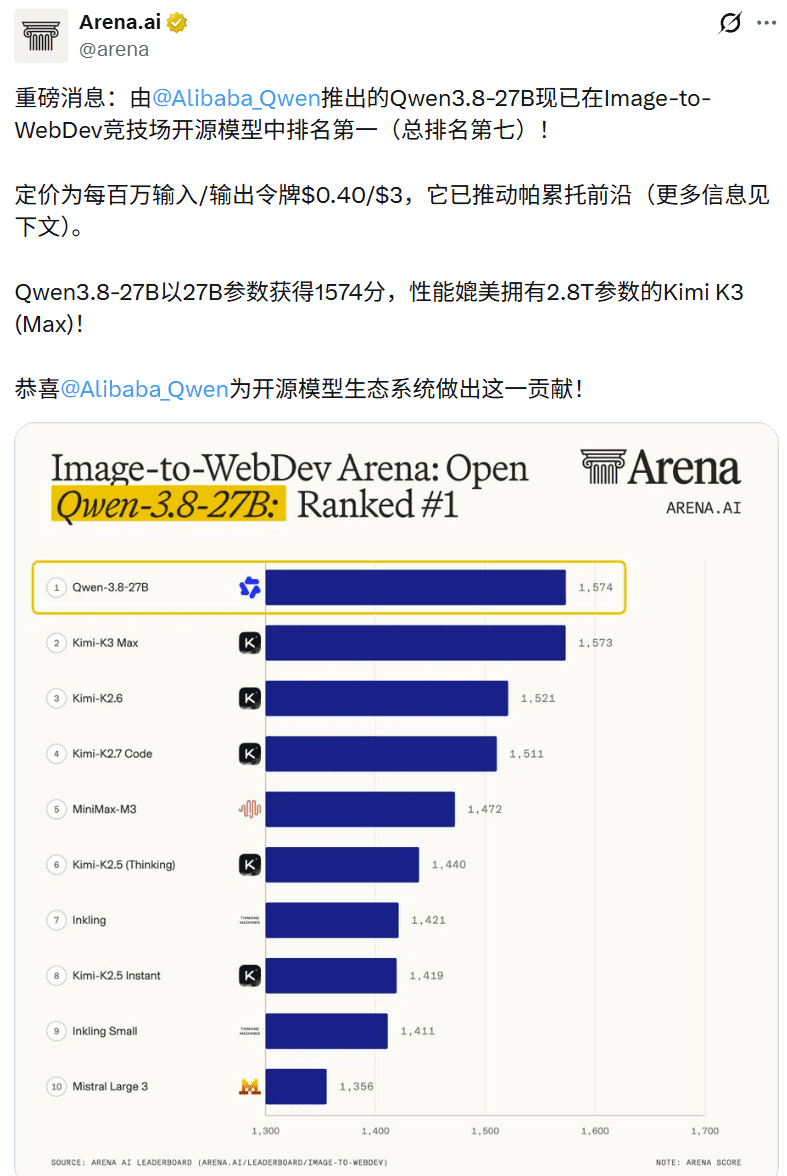
从产品定位来看,Qwen3.8-Flash填补了Qwen3.8系列的最后一块拼图。8月3日发布的Qwen3.8-Max(2.4T总参数,95B激活)代表能力上限,8月14日开源的Qwen3.8-27B面向本地部署场景,而Qwen3.8-Flash则专注于高频、长期、规模化的真实调用需求。值得注意的是,新架构并未首先应用于旗舰型号,而是直接部署在对成本敏感的Flash版本上,这打破了以往“先旗舰后下放”的惯例,反映出Qwen团队对架构效率提升的充分信心。
这一技术路线选择也呼应了产业层面的根本性转变。2026年,超大规模云厂商的推理资本开支首次超过训练开支,系统瓶颈从算力规模转向内存带宽与通信延迟。Qwen3.8-Flash的多项设计——QSA削减索引开销、N-gram Embedding移出显存、GR支持FP8存储——都体现了对GPU、HBM与主机内存分层存储体系的主动适配。这种硬件感知的架构设计,标志着大模型开发进入精细化运营阶段。
市场对效率提升的反应颇具戏剧性。2025年1月DeepSeek R1发布时,“更便宜的模型意味着更少算力需求”的预期曾导致英伟达股价单日暴跌17%。然而到2026年4月DeepSeek V4推出时,市场认知已发生逆转——当日英伟达股价反而上涨4.3%。这十六个月的变化证明:推理成本的下降并不会减少GPU总需求,反而会激发更多应用场景,推动推理需求爆发式增长。
Qwen3.8-Flash的开源版本Qwen3.8-Flash-Next已在Hugging Face和ModelScope平台发布,技术报告详细阐述了架构细节。作为Qwen4的预演,它不仅是一款高性价比的产品,更是对未来大模型发展方向的明确宣示:在补贴退潮后,真正的竞争力来自于对每一个token生产成本的重新定义。当行业集体面临“能力向上,价格还能不能向下”的拷问时,Qwen给出的答案是——通过架构创新,在同一份算力中榨取更多智能。
这种转变的影响将是深远的。开发者将不再仅仅比较token价格,而是评估完成具体业务目标的综合成本;模型厂商的竞争焦点将从参数军备竞赛转向单位算力智能密度的提升;整个AI产业的商业化路径也将更加清晰——不是靠无限烧钱维持低价,而是通过技术创新实现可持续的成本优势。在这个意义上,Qwen3.8-Flash不仅是一款模型,更是大模型产业走向成熟的重要里程碑。