OpenAI自研推理芯片Jalapeño性能曝光:吞吐与延迟双优,为Agent时代铺路
近期,人工智能领域再次因OpenAI的一项重大技术进展而震动——其首款自研推理芯片Jalapeño的性能测试结果正式对外披露。这一消息不仅标志着OpenAI在构建端到端AI基础设施的道路上迈出关键一步,更揭示了未来大模型推理系统可能的发展方向:不再局限于通用GPU的性能边界,而是通过垂直整合实现吞吐量与延迟的双重突破。
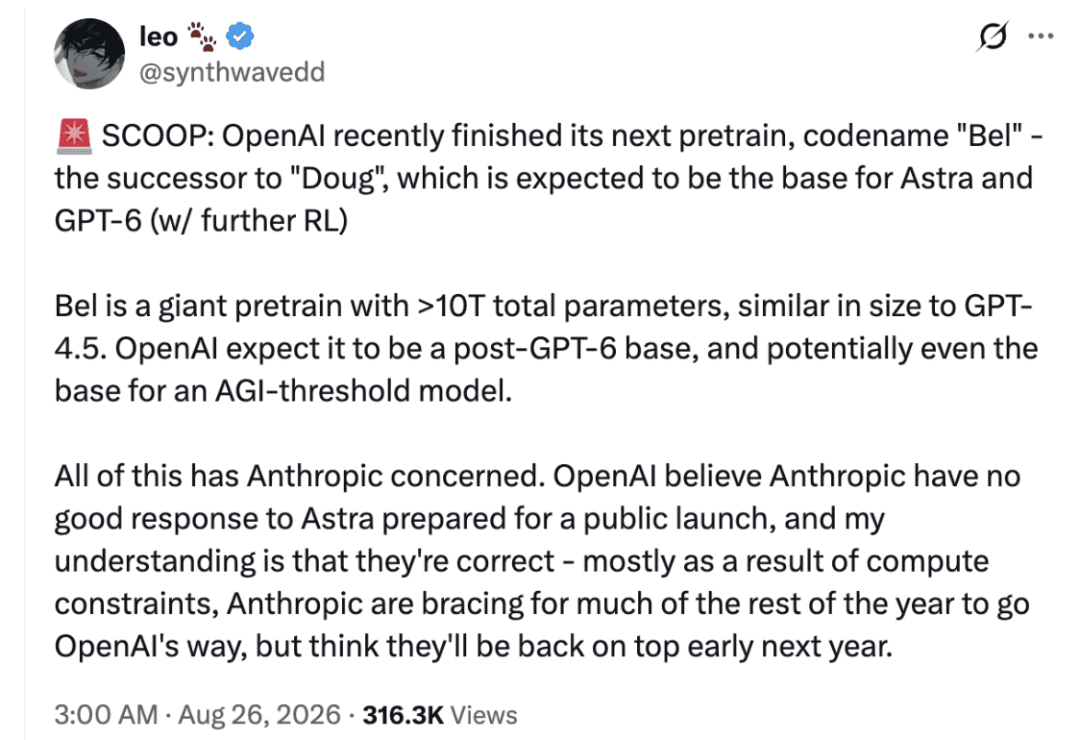
Jalapeño并非用于训练GPT-6或传闻中的“Bel”模型,而是专注于模型上线后的推理阶段。这一区分至关重要。训练阶段追求的是参数更新的精度与收敛速度,而推理阶段则关乎用户体验的核心指标:响应是否迅速、系统能否同时服务海量用户、能耗是否可控。传统硬件架构往往在这三者之间被迫取舍,而Jalapeño的目标正是打破这一桎梏。
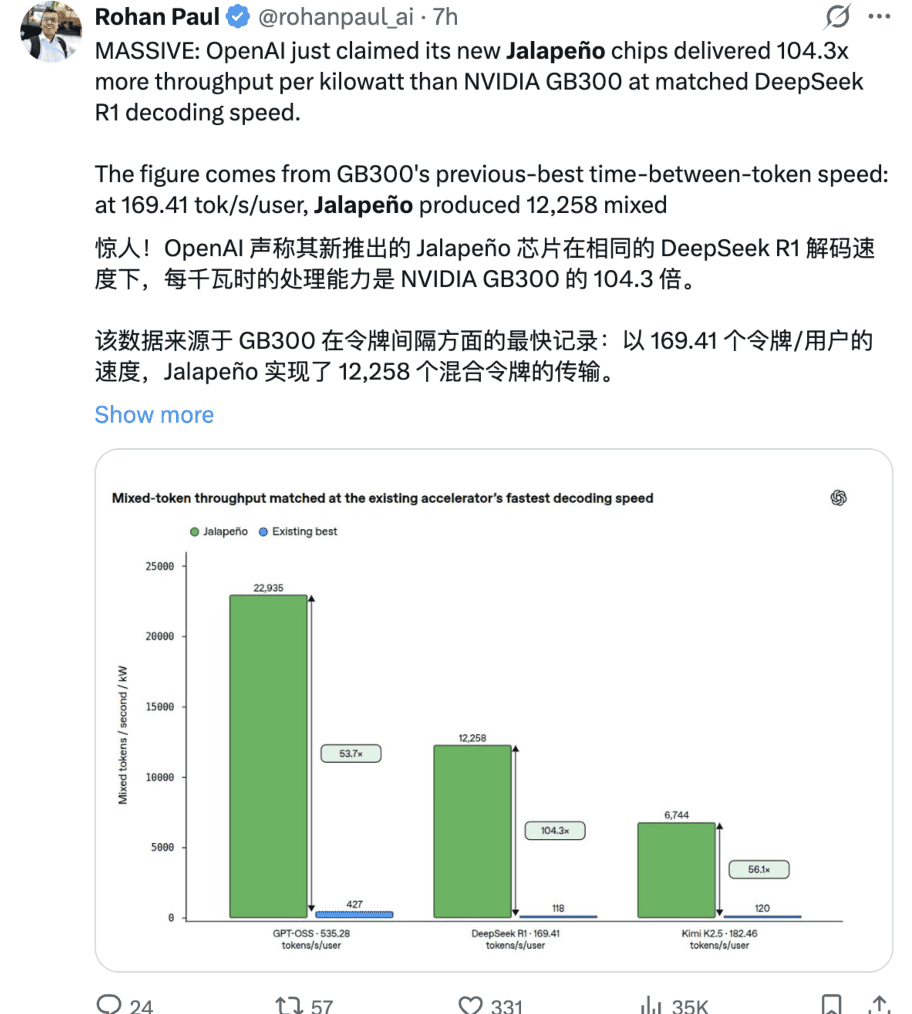
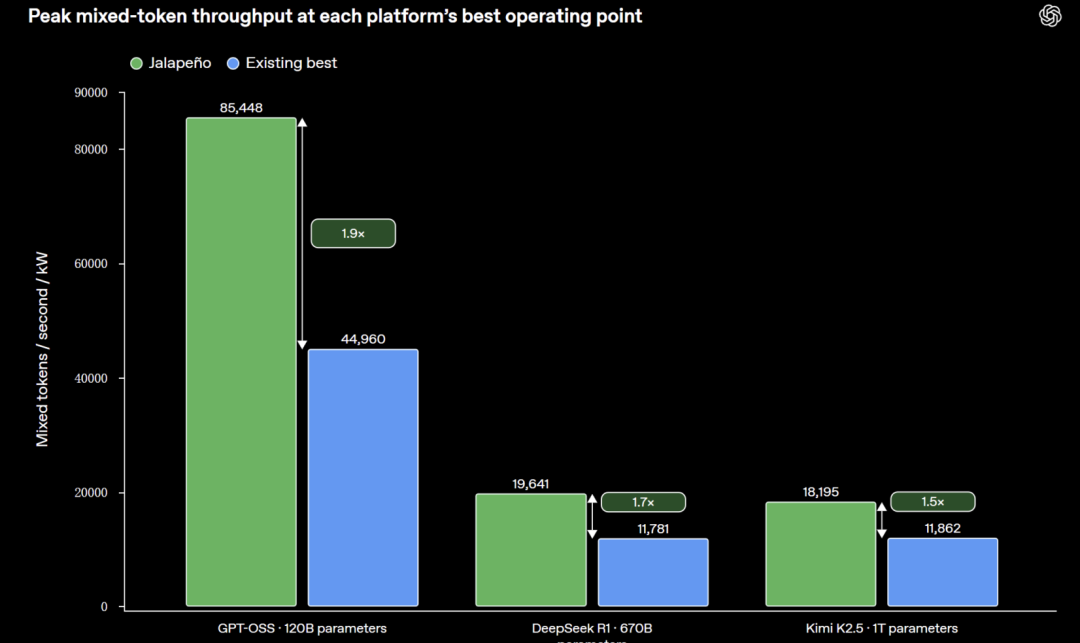
根据OpenAI公布的测试数据,Jalapeño在三个具有代表性的开源大模型上均展现出压倒性优势:GPT-OSS 120B、DeepSeek R1 670B以及Moonshot AI的Kimi K2.5 1T。值得注意的是,后两者并非OpenAI自家模型,这意味着Jalapeño的架构设计并非“闭门造车”,而是具备广泛的模型兼容性。这种通用性对于未来多模型共存的AI生态至关重要。
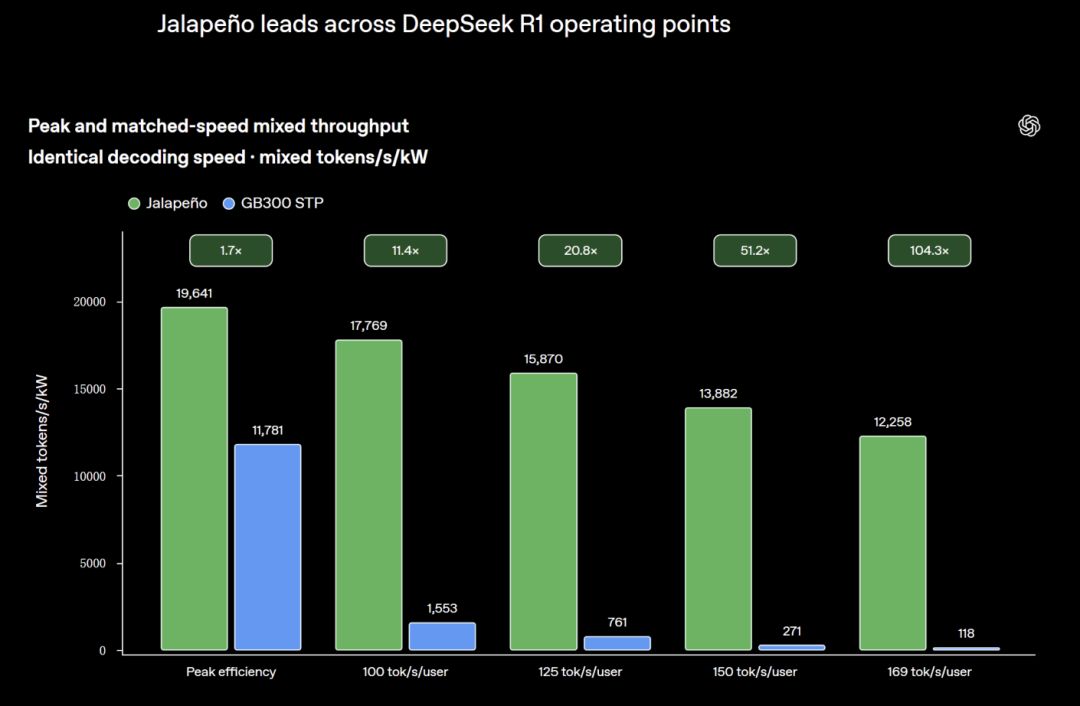
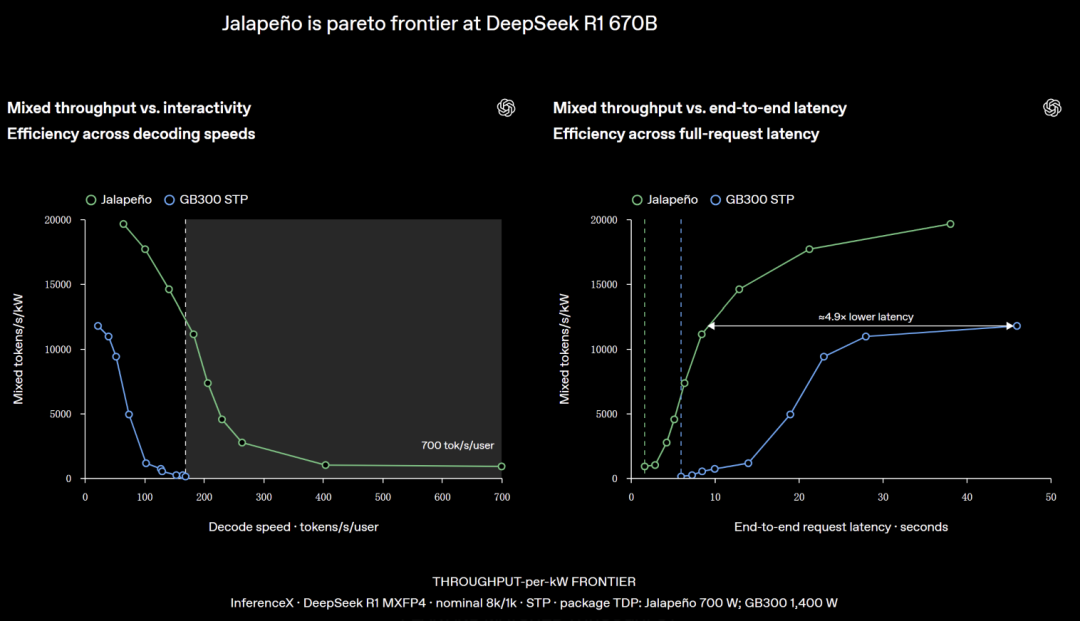
在具体性能指标上,Jalapeño实现了每瓦AI工作量1.5至1.9倍的提升。更令人瞩目的是其在低延迟场景下的表现:端到端延迟降低至对比系统的1/1.7至1/3.6。而在高度交互式的工作负载中,性能优势甚至扩大到2.1至4.1倍。这些数字背后,反映的是对真实用户场景的深刻理解——尤其是面向Agent(智能体)的应用。
Agent不同于单次问答,它需要连续执行多个推理步骤,每一次微小的延迟都会在任务链中累积,最终导致整体体验卡顿。因此,Jalapeño的设计哲学从一开始就围绕“交互式推理”展开。其架构通过协同优化芯片、内存、网络与软件栈,确保关键数据(如KV Cache)尽可能保留在本地,减少跨节点通信带来的延迟开销。这种设计使得芯片能够动态适应Prefill(输入处理)和Decode(输出生成)两个阶段的不同计算瓶颈。
更引人深思的是,AI本身也深度参与了Jalapeño的研发过程。OpenAI团队利用内部大模型,在芯片设计初期快速探索不同架构方案,大幅缩短验证周期。从初始设计到流片定稿(Tape-out),整个过程仅耗时9个月——这在传统芯片行业堪称奇迹。而在软件适配阶段,基于GPT-Astra驱动的Codex系统,团队仅用两个月就让三款未在原始计划中的开源模型在Jalapeño上实现高性能运行。部分由AI生成的Attention和MoE模块代码,甚至比人类专家手写版本快1.5至1.8倍。这预示着一个新范式:AI不仅是我们要部署的对象,更是我们构建下一代基础设施的工具。
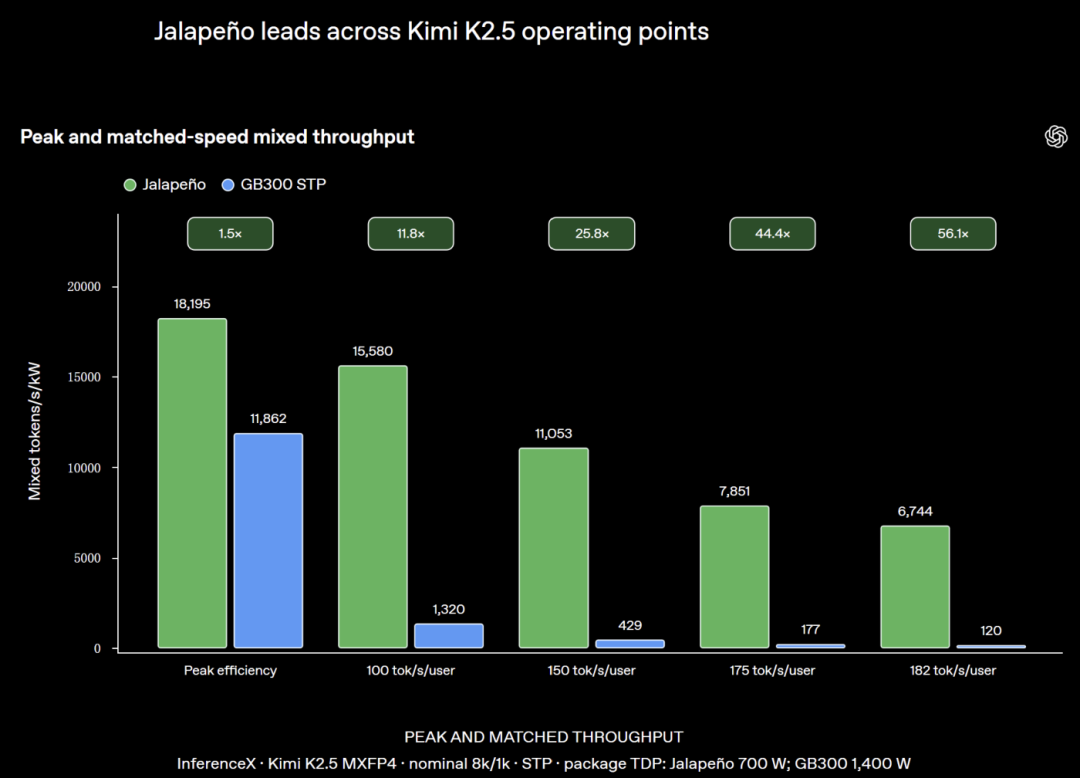
在能效方面,Jalapeño的额定功耗为700W,但在实际测试负载中持续运行功耗始终控制在550W以下。这一细节凸显了OpenAI对实际部署场景的关注——不是追求理论峰值,而是确保在真实工作负载下保持高效稳定。测试采用SemiAnalysis的InferenceX基准,结果显示Jalapeño在所有测试点均位于帕累托前沿(Pareto frontier),即在给定延迟约束下提供最高吞吐,或在给定吞吐目标下实现最低延迟。
其中一组数据尤为震撼:在DeepSeek R1 670B模型上,当系统运行在满足交互式Agent延迟要求的条件下,Jalapeño的每千瓦吞吐量达到12,258 mixed TPS/kW,而对比的GB300系统仅为118,差距高达104.3倍。这并非实验室理想环境下的极端值,而是针对典型Agent工作负载的实测结果,充分说明Jalapeño对下一代AI应用的针对性优化。
OpenAI并未将Jalapeño视为对现有GPU生态的替代,而是作为补充。公司明确表示,仍将大规模采购NVIDIA及其他厂商的加速器,以满足不断增长的训练与推理需求。自研芯片的战略意义在于掌握核心环节的控制权,尤其是在推理这一成本占比日益升高的环节。据估算,大模型服务的长期运营成本中,推理可占70%以上。通过Jalapeño这样的专用芯片,OpenAI有望显著降低单位请求的能耗与硬件成本。
部署计划方面,OpenAI预计在2026年底前将Jalapeño集成到自有数据中心。目前团队正进行生产级验证、软件栈完善及大规模运维准备。更值得关注的是,第二代(Gen 2)芯片已进入深度开发阶段,第三代(Gen 3)也已启动概念设计。这种快速迭代节奏,反映出OpenAI对算力基础设施自主化的坚定决心。
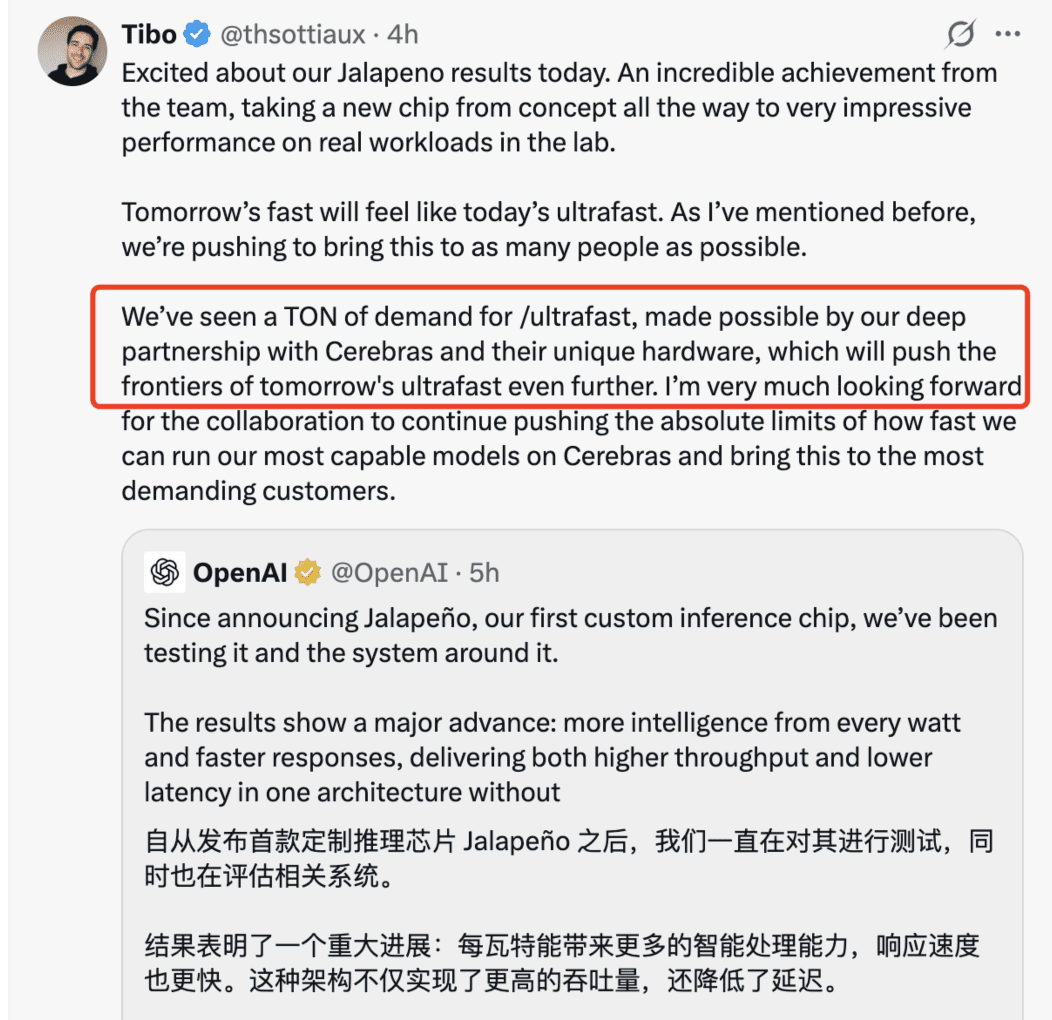
此外,Jalapeño的推出也离不开与Cerebras的深度合作。后者以其晶圆级引擎(WSE)技术闻名,提供独特的高带宽、低延迟互连架构。OpenAI工程负责人Tibo公开致谢Cerebras,并强调这种合作将推动“超快速”AI体验的边界。这表明,即便走向自研,OpenAI仍重视生态协同,而非完全封闭。
从行业视角看,OpenAI加入“造芯”行列并不意外。Google的TPU、Amazon的Trainium/Inferentia、Microsoft的Maia、Meta的MTIA,无一不在尝试摆脱对通用GPU的过度依赖。但Jalapeño的独特之处在于其明确聚焦于推理,尤其是面向未来的Agent工作负载。这一定位使其避开了与NVIDIA在训练市场的正面冲突,转而开辟一条差异化赛道。
综上所述,Jalapeño不仅是一颗芯片,更是OpenAI对未来AI基础设施愿景的具象化。它代表着一种新的设计范式:以真实应用场景为驱动,通过软硬协同、AI辅助开发、跨厂商合作,构建高效、灵活且面向未来的推理平台。随着2026年部署窗口的临近,整个AI行业或将迎来一场关于推理效率的新竞赛。