大模型训练首次全程直播:Marin 535B开源实验如何重塑AI透明度?
近期,人工智能领域发生了一件具有里程碑意义的事件:由斯坦福大学教授、Simile AI创始人Percy Liang主导的Marin开放实验室正式启动Marin 535B-A23B大模型的训练,并宣布整个训练过程将完全公开。这一举措打破了以往顶级大模型研发高度封闭的传统,首次将一个拥有5350亿总参数、230亿激活参数的前沿模型从零开始的训练全过程暴露在公众视野之下。
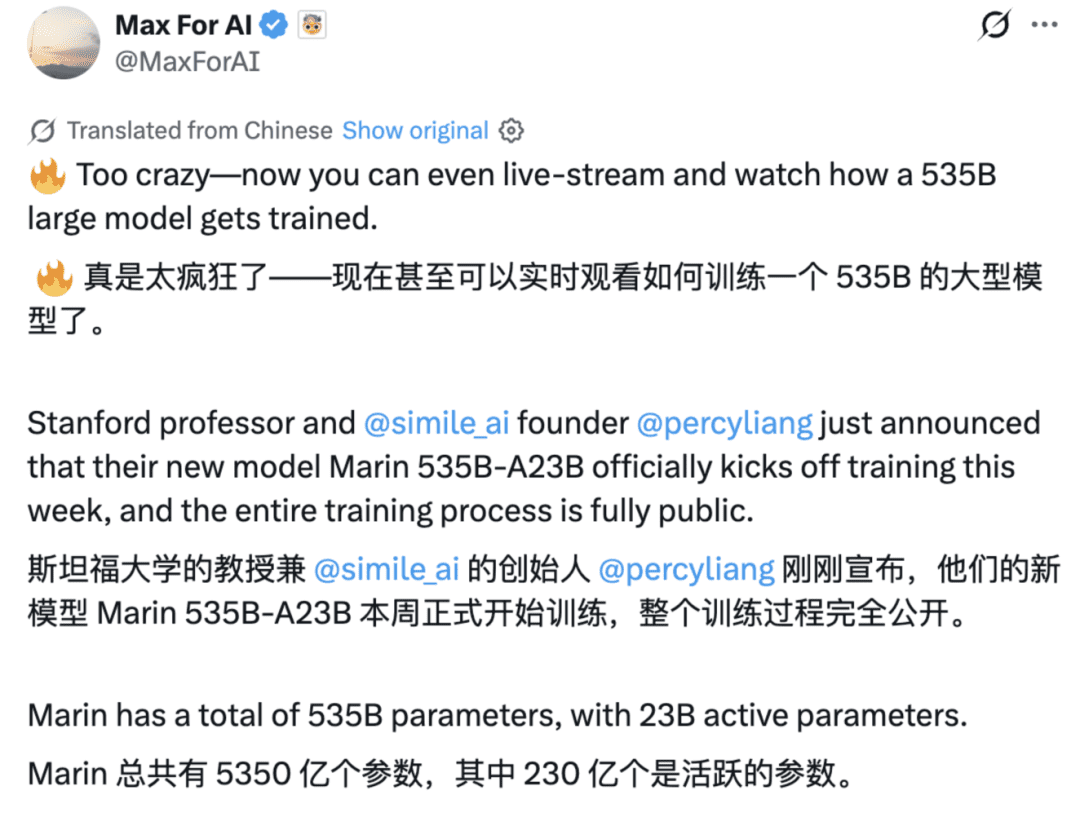
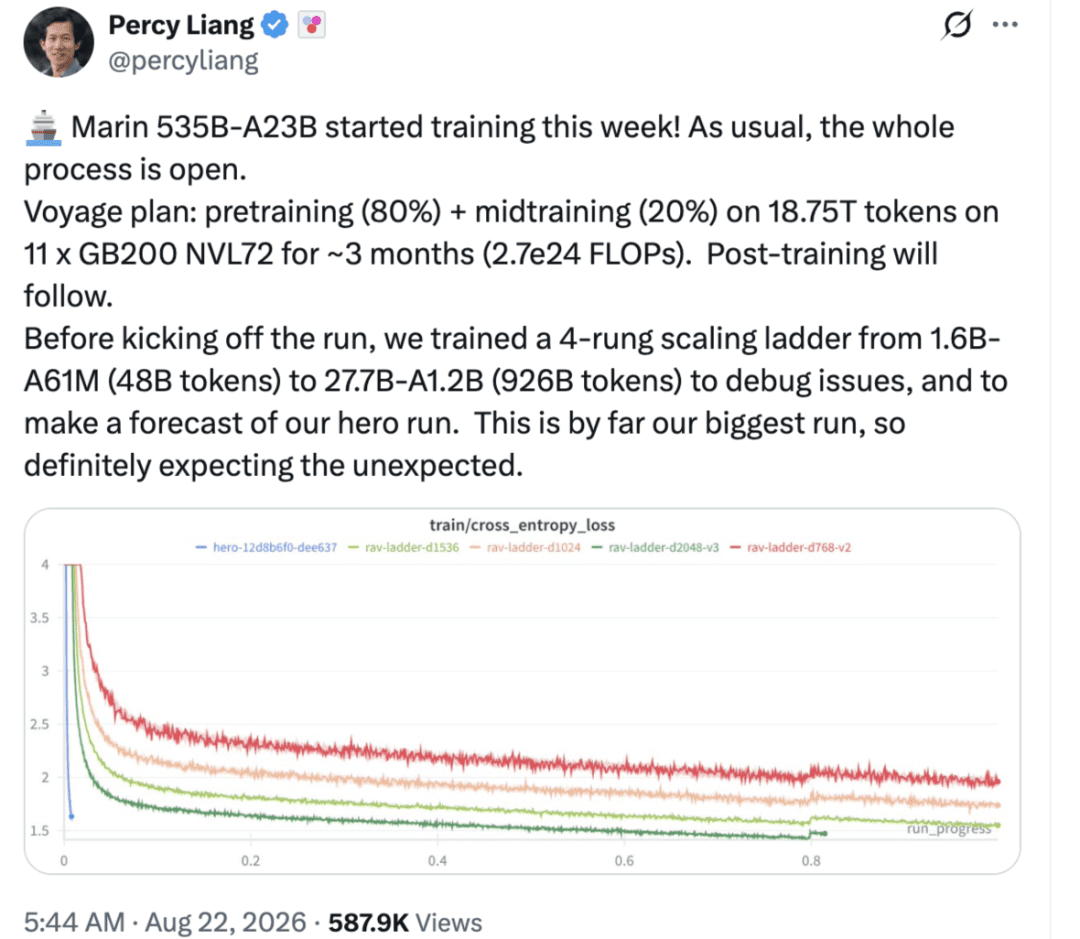
该项目部署了11套NVIDIA GB200 NVL72系统,总计约792颗GB200 GPU,计划连续运行约三个月,累计消耗约2.7×10²⁴ FLOPs的计算量。训练数据总量高达18.75万亿token,覆盖多领域、多语言内容。更关键的是,所有训练配置、数据构成、代码实现、实验日志乃至实时性能指标(如loss曲线、梯度范数、专家路由行为等)均通过公开渠道持续更新,任何人都可随时访问并参与讨论。
这种前所未有的透明度,使得Marin项目迅速在X(原Twitter)、GitHub和AI研究社区引发热烈反响。许多从业者将其誉为“AI研发民主化的第一步”——过去,像GPT-4、Claude 3或Gemini这样的商业大模型,其训练细节几乎完全保密,外界仅能通过有限的论文摘要或基准测试结果推测其能力边界。而如今,一个接近工业级规模的模型训练过程被完整“直播”,这不仅是技术展示,更是一场关于科学可重复性与社区协作的实践实验。
值得注意的是,在启动主模型(即“hero run”)之前,团队已系统性地完成了四阶段的Scaling Ladder预实验。这些小型模型从1.6B-A61M(48B tokens)逐步扩展至27.7B-A1.2B(926B tokens),目的明确:一是提前暴露工程与算法层面的潜在问题,二是基于实证数据校准对主模型训练行为的预测。例如,通过观察小模型在不同数据配比下的收敛速度与loss下降趋势,团队可优化主模型的学习率调度、批大小及混合专家(MoE)路由策略。这种“渐进式验证”方法显著降低了主训练失败的风险,也体现了严谨的科研工程思维。
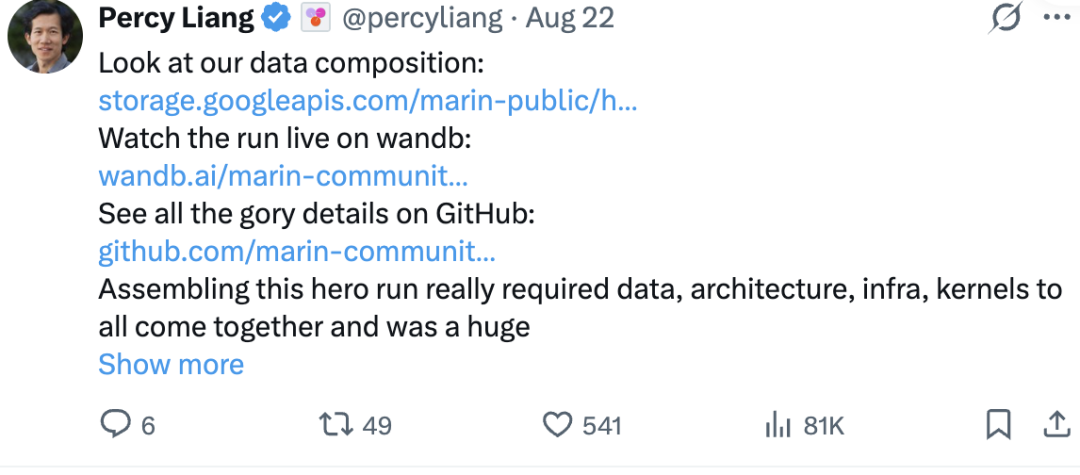
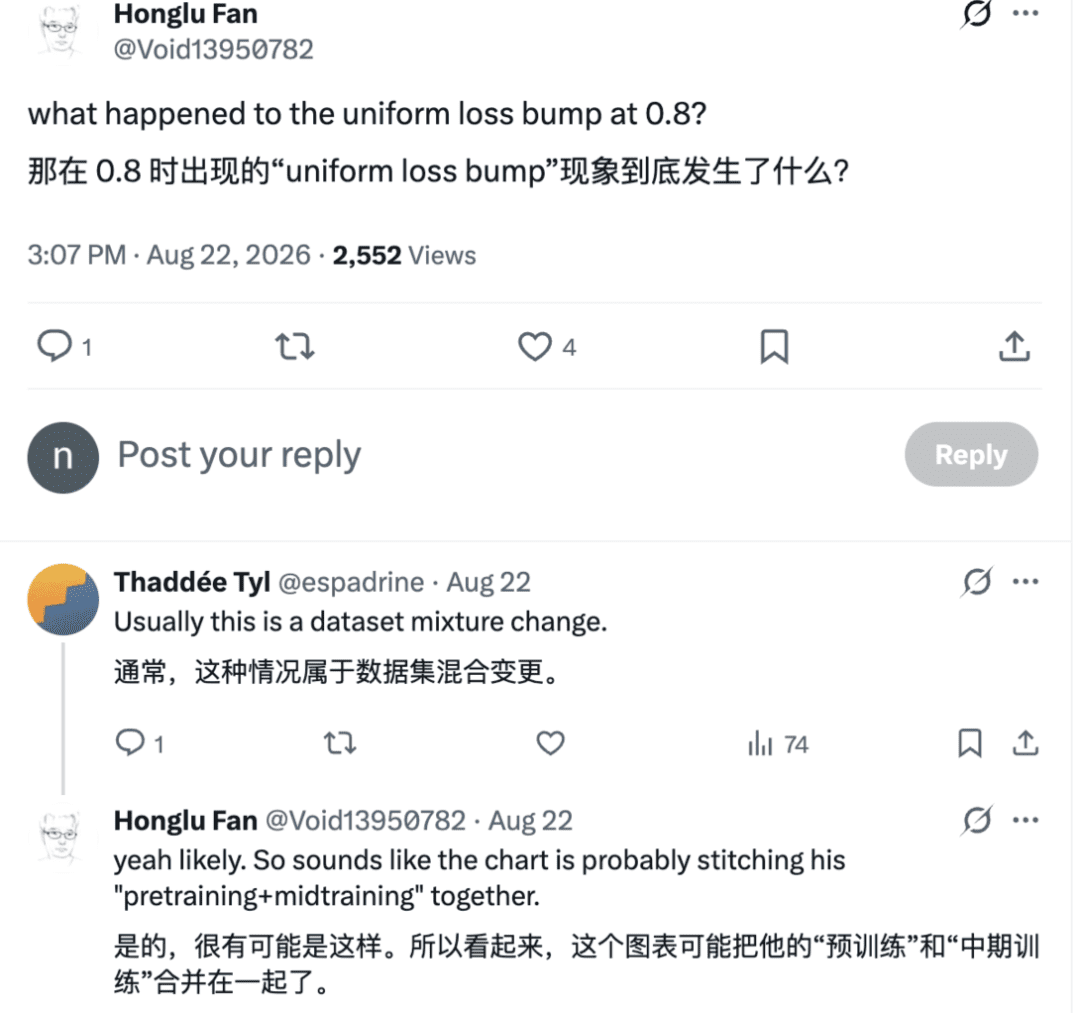
目前,公众可通过多个渠道实时追踪训练进展。在Weights & Biases(wandb)平台上,用户能看到每一步的训练loss、验证loss、各层参数范数、专家激活频率等关键指标;GitHub仓库则详细记录了训练配置文件、数据预处理脚本及已知问题清单;而专门的数据概览页面则展示了训练语料的领域分布、采样策略(如uniform sampling)及去重机制。这种多层次、多维度的信息开放,使得即使是非核心团队成员也能深入理解模型演进的内在逻辑。
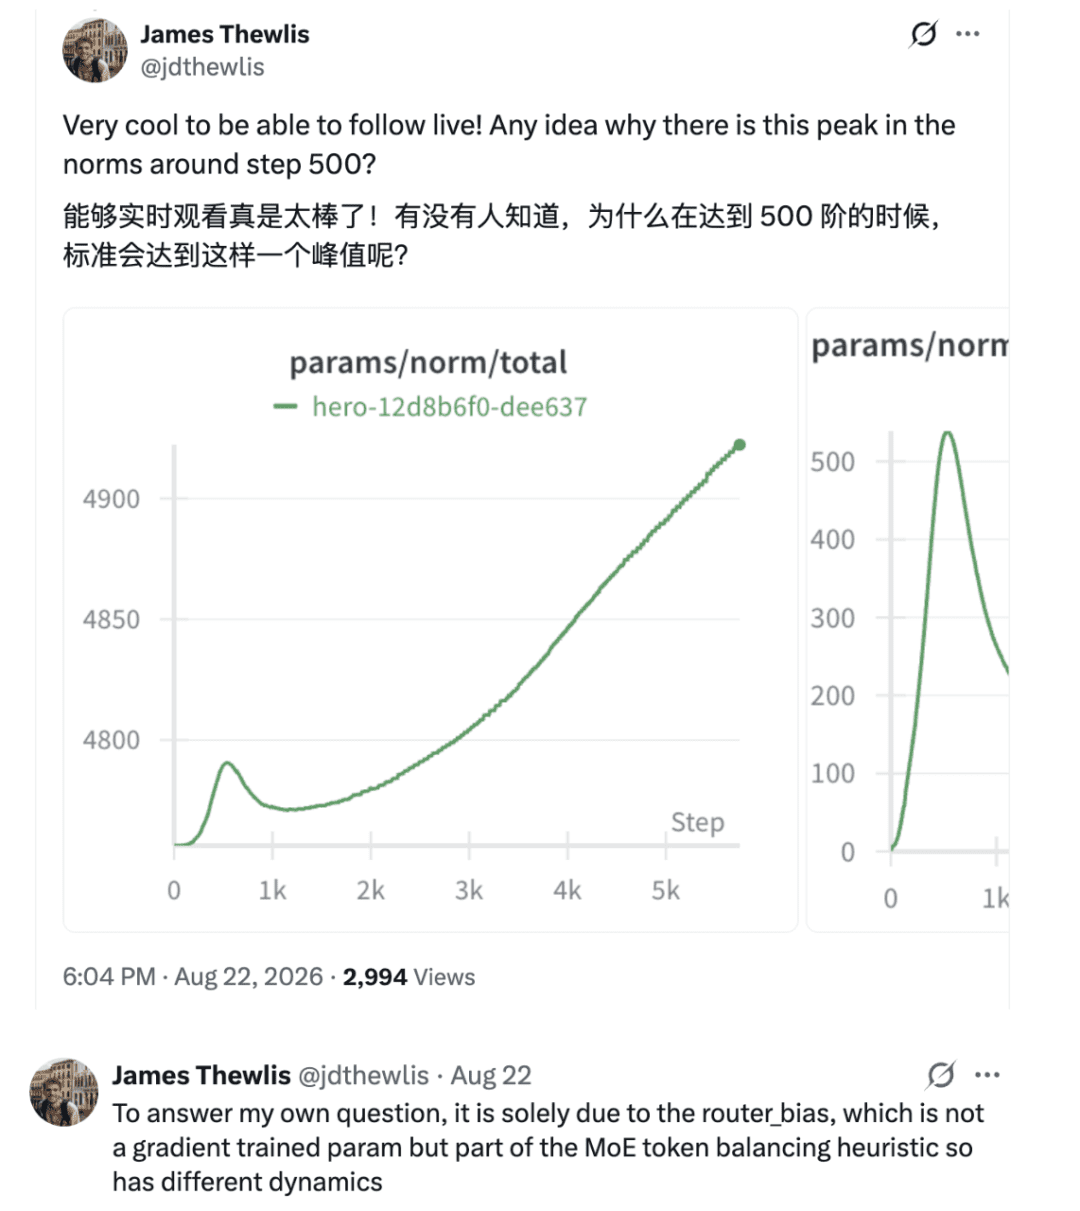
事实上,已有社区成员开始基于公开数据进行独立分析。例如,网友James Thewlis注意到在训练第500步左右出现参数范数异常峰值,经研究后指出这源于MoE架构中的router_bias机制——该参数并非通过反向传播学习,而是用于维持token在专家间的均衡分配,因此其动态行为与常规权重不同。这类自发性的技术探讨,恰恰印证了开放训练所能激发的集体智慧。
从技术架构看,Marin 535B采用混合专家(Mixture of Experts, MoE)设计,仅激活230亿参数(约占总参数的4.3%),这在保证模型容量的同时控制了推理成本。然而,MoE训练本身极具挑战:专家负载不均衡、路由震荡、梯度稀疏等问题极易导致训练不稳定。此次全程公开,或将为学术界提供首个大规模MoE训练的实证案例库,有助于提炼更鲁棒的训练策略。
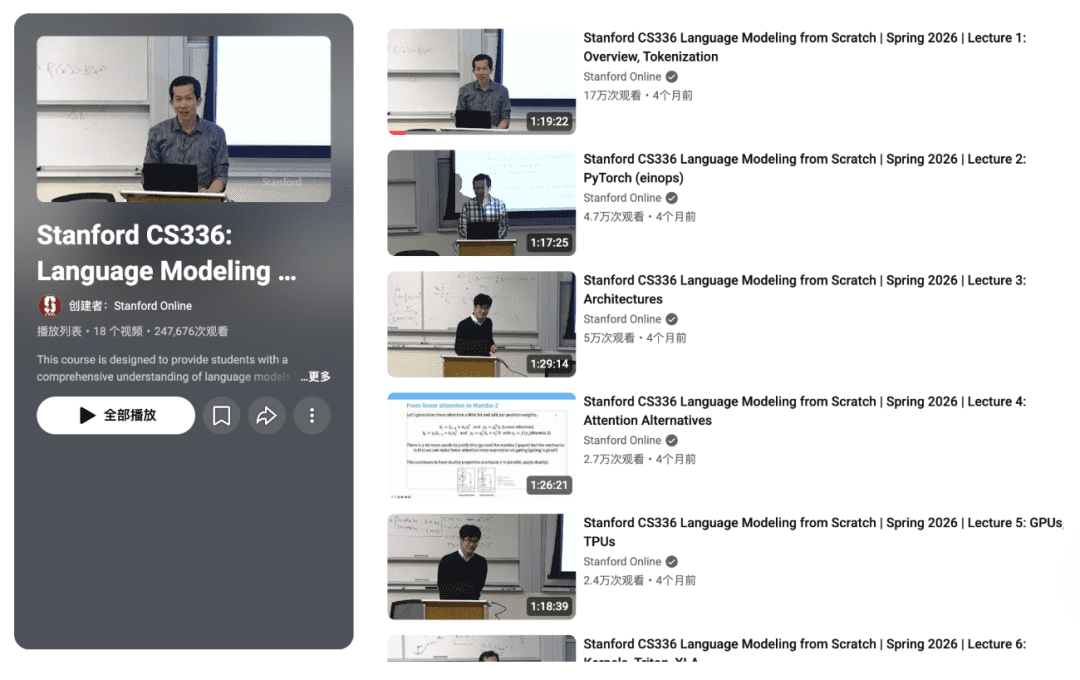
此外,Percy Liang的教育背景也为该项目增添了深层意义。他同时开设了《CS336: Language Models From Scratch》课程,系统讲解从数据清洗、tokenizer设计到分布式训练、评估调优的全流程。Marin项目可视为该课程的“现实延伸”——学生不仅能听理论,还能直接观察一个真实千亿模型如何应对实际训练中的噪声、硬件故障与超参敏感性。这种“教学-实践”闭环,有望加速下一代AI工程师的成长。
当然,公开训练也面临现实挑战。首先是计算资源的巨大投入——792颗GB200 GPU的集群部署成本可能高达数亿美元,远超普通研究机构承受能力。其次,尽管数据已做脱敏处理,但18.75万亿token的庞大规模仍存在潜在隐私或版权风险。再者,实时公开可能被恶意利用,例如通过loss波动反推训练数据分布,或针对特定阶段发起对抗性攻击。不过,团队显然已权衡利弊,选择以“可控透明”推动行业进步。
长远来看,Marin项目的真正价值或许不在于最终模型是否超越GPT-4,而在于它重新定义了大模型研发的范式。当训练不再是少数科技巨头的秘密武器,而成为可观察、可讨论、可协作的公共事业时,AI的发展将更趋健康与多元。未来,我们或许会看到更多“开放英雄训练”(Open Hero Runs),形成类似Linux内核开发那样的全球协作生态。
对于普通开发者而言,这同样是一次难得的学习机会。通过跟踪Marin的训练日志,可以直观理解:为何某些超参组合会导致loss爆炸?数据混合比例如何影响多任务泛化?MoE中的专家何时开始专业化?这些问题的答案不再藏于论文的附录中,而是实时展现在wandb面板上。这种“沉浸式学习”体验,远胜于阅读静态文档。
可以预见,在接下来的三个月里,AI社区将持续关注Marin 535B的每一个关键节点:第一次稳定收敛、首次遇到硬件故障、loss plateau期的突破、post-training阶段的指令微调效果……每一次波动都可能成为新的研究课题。而Percy Liang团队所展现的勇气与开放精神,或将激励更多机构加入这场透明化运动,共同推动AI走向更可信、更可解释的未来。
这场实验的意义,早已超越技术本身。它在问:在一个由算法深度塑造的世界里,我们是否应该有权知道这些算法是如何被制造出来的?Marin的回答是肯定的——而且,它正邀请所有人一起见证。