i1模型启示录:公开可复现的文生图训练配方如何推动AI研究范式变革
近年来,文本到图像(Text-to-Image, T2I)生成模型的发展呈现出爆发式增长。从Stable Diffusion到DALL·E系列,再到近期的Flux、SDXL乃至Qwen-Image,各类模型在图像质量、语义对齐和细节控制方面不断突破。然而,一个长期被忽视的问题逐渐浮出水面:绝大多数前沿工作都建立在私有数据集、不透明的训练流程和复杂的工程调优之上。这种“黑箱式”研发模式虽然能快速产出亮眼结果,却严重阻碍了学术界对技术本质的理解——我们很难判断一个模型的优异表现究竟源于更高质量的数据、更精巧的架构设计,还是仅仅是更大规模的算力堆砌。

正是在这一背景下,普林斯顿大学刘壮团队于2024年发布的 i1 模型(论文编号 arXiv:2606.11289)显得尤为珍贵。这项工作不仅训练出了一个性能强劲的30亿参数文生图模型,更重要的是,它首次提供了一套 完全公开、可复现、经过系统验证的训练配方,涵盖从基础架构选择、数据构建策略到训练细节的完整链条。这一举措有望将文生图研究从经验驱动的“炼丹术”推向科学化的控制实验范式。
为什么需要一个统一的可复现基线?
当前文生图领域的研究存在明显的“碎片化”问题。不同团队使用不同的数据清洗标准、不同的文本编码器、不同的噪声调度策略,甚至不同的评估指标。这导致即使两个模型在相同基准上得分相近,其背后的技术路径也可能天差地别。更严重的是,由于缺乏消融实验,许多论文中宣称的“关键创新”可能只是与其他未公开因素耦合后的偶然结果。
例如,某篇论文声称其新提出的注意力机制提升了图像细节,但若其同时使用了更大规模的私有数据集,那么性能提升究竟来自架构改进还是数据优势?在没有控制变量的情况下,答案无从得知。这种不确定性不仅浪费研究资源,还可能导致整个领域在错误的方向上持续投入。
i1 的核心价值在于它构建了一个 标准化的实验平台。所有300多组控制实验均从同一个256×256分辨率的预训练基线出发,每次仅改变单一变量(如模型结构或数据组成),从而精确量化每一项设计的实际贡献。这种严谨的方法论为后续研究者提供了可靠的参照系。
模型设计:简单组合胜过复杂创新
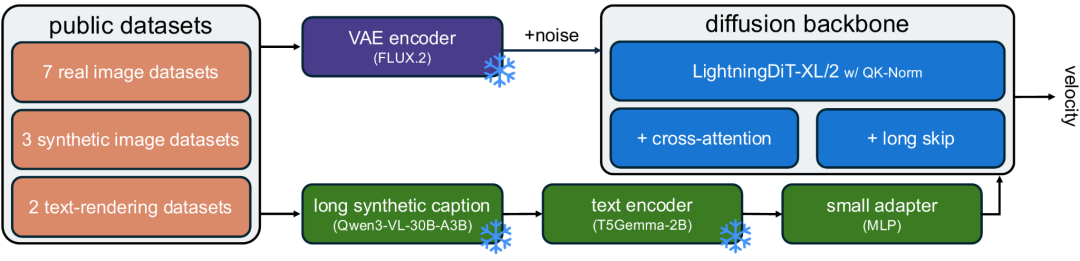
i1 并未引入任何全新的模块或算法,而是通过系统实验验证了一系列已有设计的有效性,并以最简方式组合最优选项。其基础架构采用 浅层融合(shallow fusion) 策略:冻结的文本编码器(如CLIP或T5)提取文本特征后,通过轻量级adapter注入到从头训练的DiT(Diffusion Transformer)主干网络中。整个训练过程基于 flow matching 目标函数,而非传统的DDPM或DDIM。
在模型层面,团队得出了几项反直觉但极具实践意义的结论:
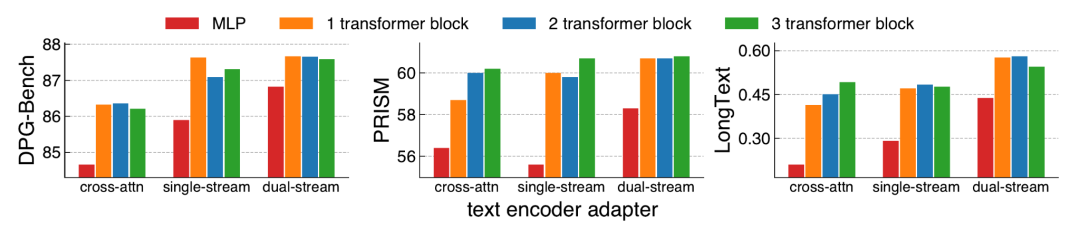
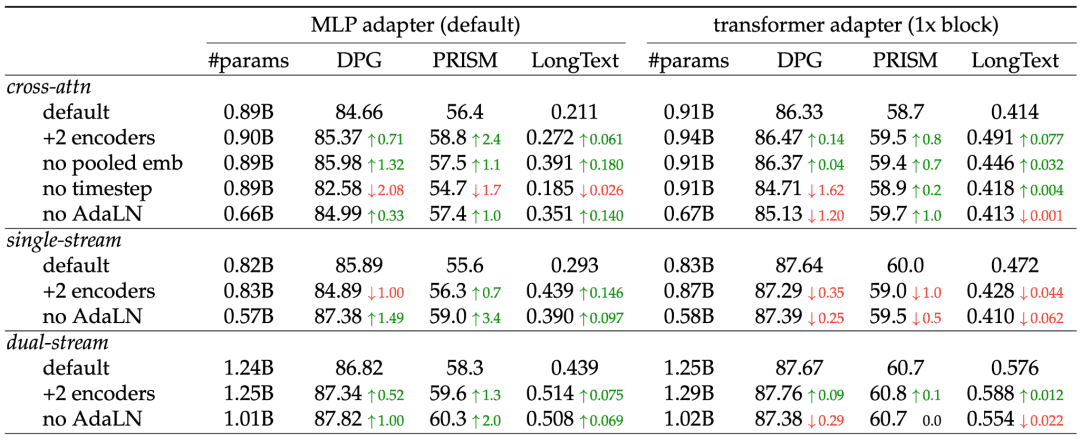
首先,多文本编码器并非必需。实验发现,同时使用CLIP和T5确实能提升性能,但若仅使用单一编码器(如T5),并通过适度增大其adapter的宽度(例如从512维扩展到1024维),即可获得几乎相当的收益,且显著降低推理延迟和显存占用。这一发现对资源受限的部署场景尤为重要。
其次,AdaLN中的全局条件注入收益有限。尽管AdaLN(Adaptive Layer Normalization)是当前DiT类模型的标准组件,用于将时间步和文本池化特征注入归一化层,但i1的消融实验显示,移除pooled text embedding的注入后,性能下降不足1个百分点。这意味着大量参数实际上处于“低效利用”状态,未来模型可考虑简化条件路径。
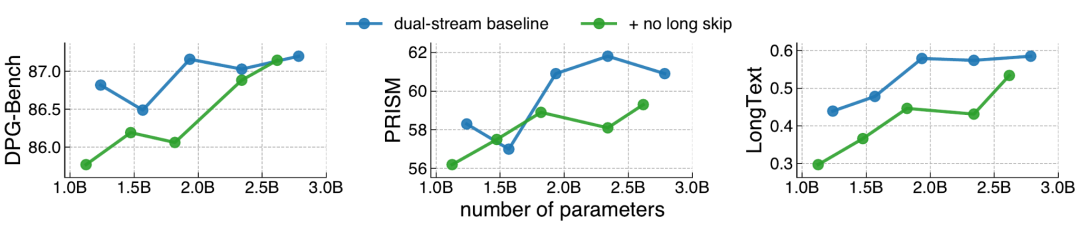
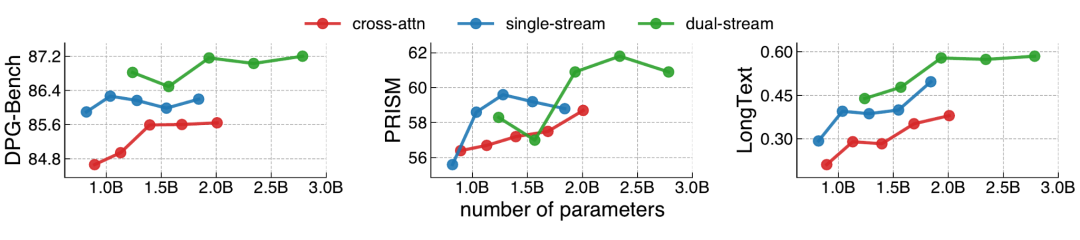
第三,在主干网络结构上,dual-stream 架构优于 single-stream,而后者又优于传统的 cross-attention。具体而言,dual-stream 将图像token和文本token分别处理再融合,能更好地保留各自模态的语义完整性;single-stream 则将两者拼接后统一处理,计算效率更高;而cross-attention因信息瓶颈问题表现最弱。此外,引入 U-ViT式的长跳跃连接(long skip connections)在控制参数量或FLOPs的前提下,始终带来稳定提升,说明残差路径对梯度流动至关重要。
这些结论共同指向一个原则:在文生图任务中,架构的“表达能力”往往比“新颖性”更重要。与其追求复杂的交互机制,不如确保信息能在网络中高效、无损地传递。
数据策略:质量、长度与分辨率的精细权衡
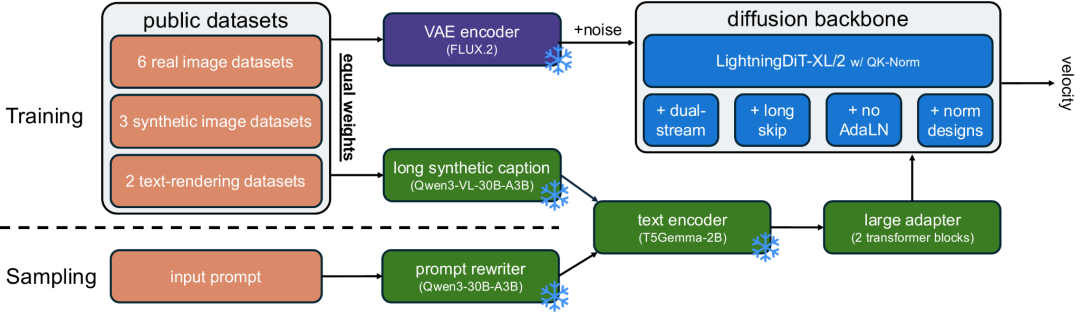
如果说模型设计决定了性能上限,那么数据策略则决定了能否接近这一上限。i1团队在数据方面同样进行了深入探索,其核心数据集由12个公开图像数据集(如LAION、COCO、VisualGenome等)组合而成,并使用强大的视觉语言模型(VLM)对原始短caption进行重写,生成更丰富、更结构化的长描述。
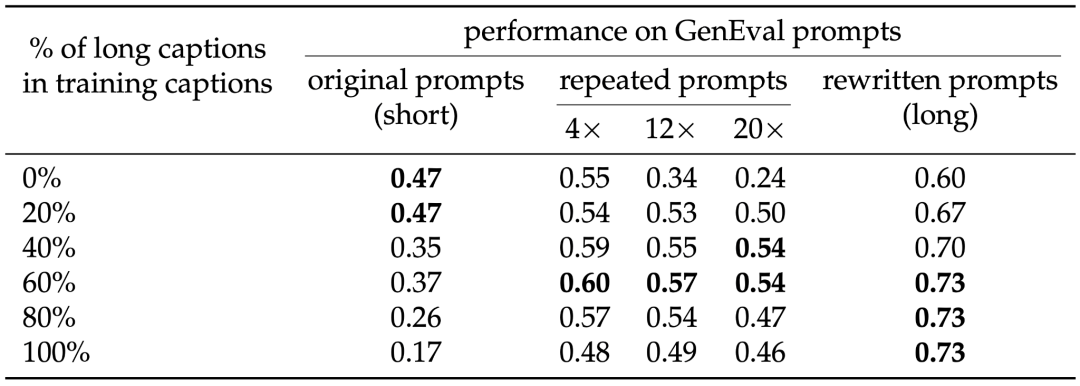
第一项关键发现是:caption长度对模型泛化能力具有双重影响。在纯短caption上训练的模型整体表现较弱;而在长caption上训练的模型虽在复杂提示下表现优异,却在面对用户常用的简短prompt时出现“过拟合”现象——即无法有效压缩冗余信息。解决方案是在推理阶段引入一个轻量级的 prompt rewriter,将短prompt自动扩展为符合训练分布的长描述,从而弥合训练-推理差异。
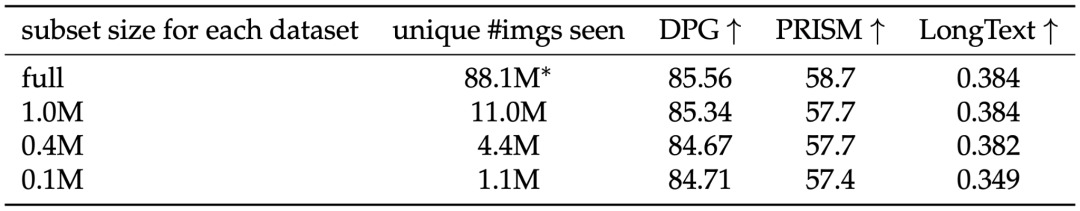
第二,数据多样性比绝对规模更重要。当将原始数据集按比例下采样至10%甚至5%时,只要保持类别和场景的多样性,模型性能下降幅度远小于预期。这表明当前主流文生图模型尚未达到数据饱和点,进一步优化数据质量(如去重、过滤低质样本)可能比盲目扩增数量更具性价比。
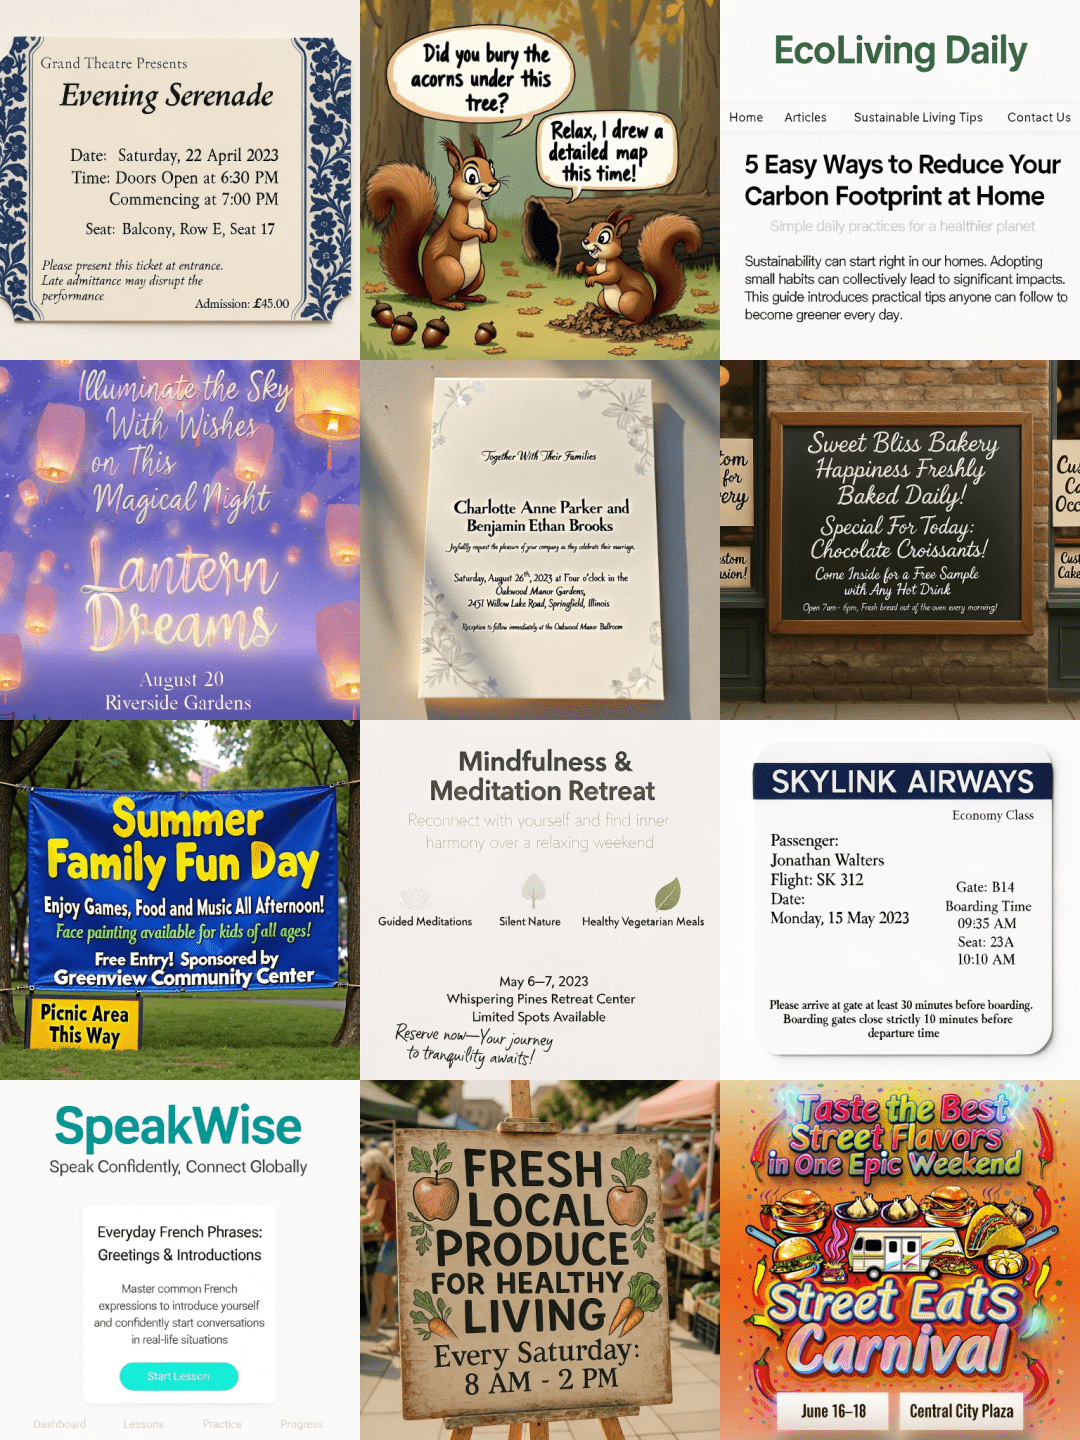
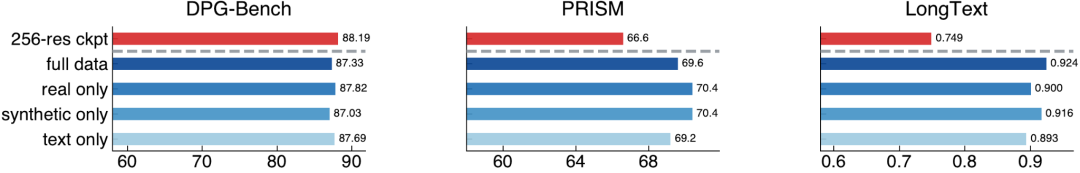
第三,高分辨率微调无需覆盖全量数据。团队在512×512分辨率阶段仅使用包含文字、商品或特定物体的子集进行训练,却发现模型的文字渲染能力(如生成“Happy Birthday”蛋糕上的清晰字母)反而显著提升,且未损害通用生成能力。这说明高分辨率训练可以作为一种“能力强化”手段,而非必须覆盖全分布的负担。
这些发现颠覆了“越多越好”的数据迷信,强调 数据的结构性、语义密度和任务对齐度 才是关键。这也解释了为何i1仅用公开数据就能媲美依赖私有海量数据的闭源模型——其数据配方经过精心设计,而非简单堆砌。
i1的性能表现:公开模型的新标杆
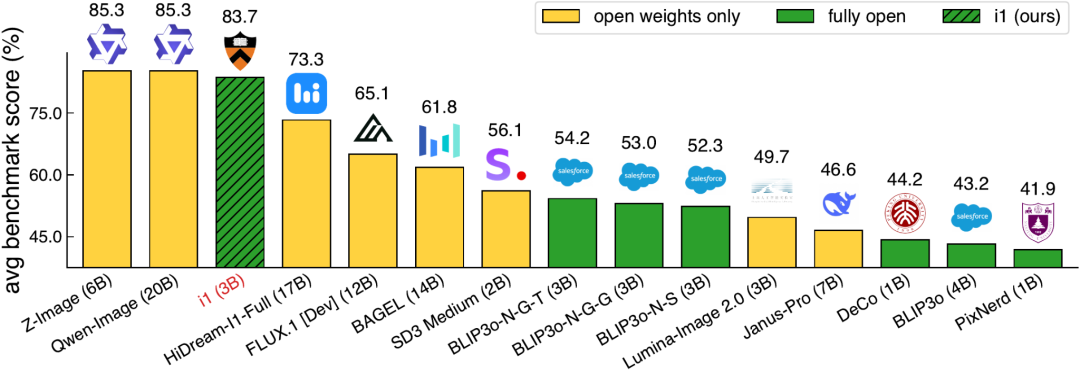
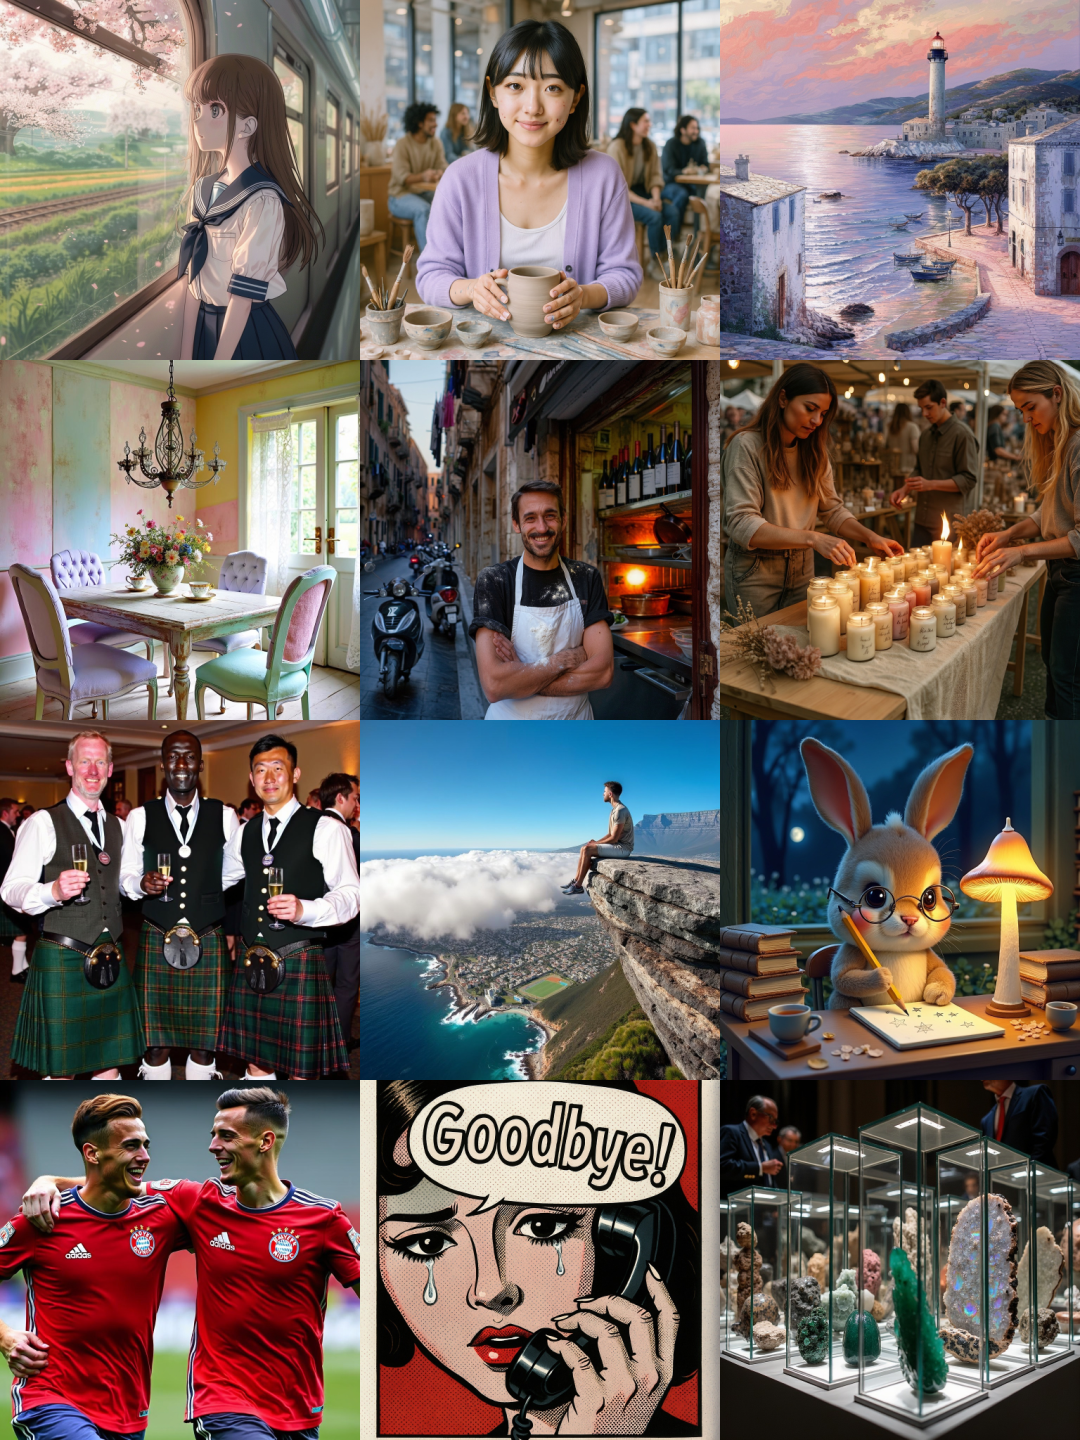
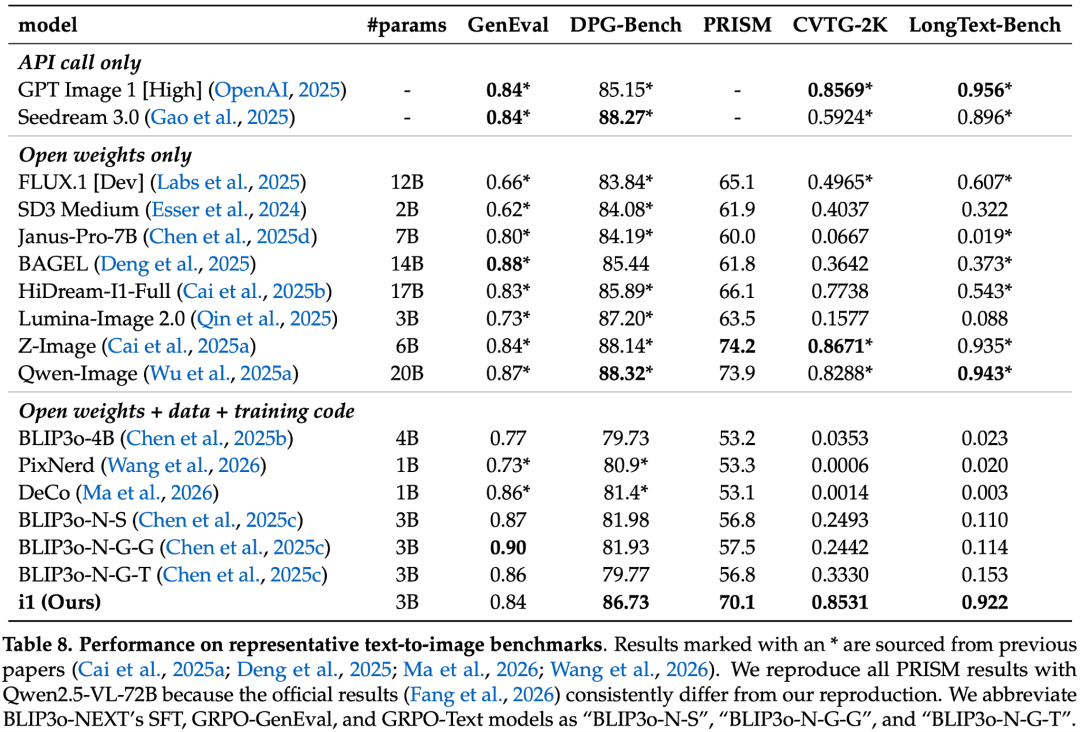
基于上述实验结论,团队最终训练出3B参数的i1模型。在五项主流自动评测基准上——GenEval(综合生成质量)、DPG-Bench(细节与物理合理性)、PRISM-Bench(语义对齐)、CVTG-2K(文字渲染)和LongText-Bench(长文本理解)——i1平均得分比此前最佳全公开模型高出29.5个百分点。尤为突出的是其文字渲染能力:在CVTG-2K上达到0.8531,在LongText-Bench上高达0.922,成为首个能可靠生成可读文字的开源文生图模型。
更值得注意的是,i1的综合表现已接近参数量达20B的Qwen-Image等仅开放权重的模型。考虑到后者可能使用了数倍于i1的私有数据和更复杂的蒸馏策略,这一对比凸显了 科学化训练方法的巨大潜力——即使资源有限,通过严谨的实验设计和数据工程,依然可以逼近顶尖水平。
对AI研究范式的深远影响
i1的意义远不止于一个高性能模型。它实质上提供了一种 新的研究基础设施。以往,研究者若想验证某个新想法(如新型注意力机制或数据增强策略),往往需要从零开始构建整个训练 pipeline,耗时耗力且难以保证公平比较。而有了i1这一统一基线,只需在其基础上修改目标变量,即可快速获得可信的消融结果。
这种转变类似于计算机视觉早期的ImageNet时代——当所有人都在相同数据集和评估协议下竞争时,技术进步才真正可衡量、可积累。i1有望在生成模型领域催生类似的“标准化革命”,推动社区从追求短期SOTA转向长期可复现的知识构建。
此外,i1的完全开源(包括训练代码、数据集、预训练权重)也降低了研究门槛。高校实验室、独立开发者甚至高中生都能基于此开展创新,而不必依赖大公司的闭源API或昂贵的私有集群。这种开放生态正是AI民主化的关键一步。
当然,i1并非终点。其3B参数规模在当前动辄数十B的模型面前仍显小巧,且未涉及视频生成或多模态编辑等前沿方向。但正因其简洁、透明、可扩展,i1更像是一块坚实的基石——在此之上,整个社区可以共同建造更宏伟的生成AI大厦。
综上所述,i1不仅是一个技术成果,更是一种方法论宣言:在AI研究日益工程化的今天,回归科学精神——控制变量、公开数据、可复现实验——或许才是突破瓶颈的真正钥匙。