AI能否设计AI?AI4AI-Bench揭示大模型在算法创新中的真实能力边界
近年来,人工智能领域的一个核心命题逐渐从“AI能否完成任务”转向“AI能否改进自身”。这一转变的背后,是对递归自改进(Recursive Self-Improvement)能力的探索——即AI系统是否能在无需人类干预的情况下,持续设计出更优的算法、架构或训练策略,从而实现能力的指数级跃迁。在这一背景下,Einsia AI旗下Navers Lab推出的 AI4AI-Bench 基准测试,首次将这一抽象问题转化为可量化、可复现的实证研究。
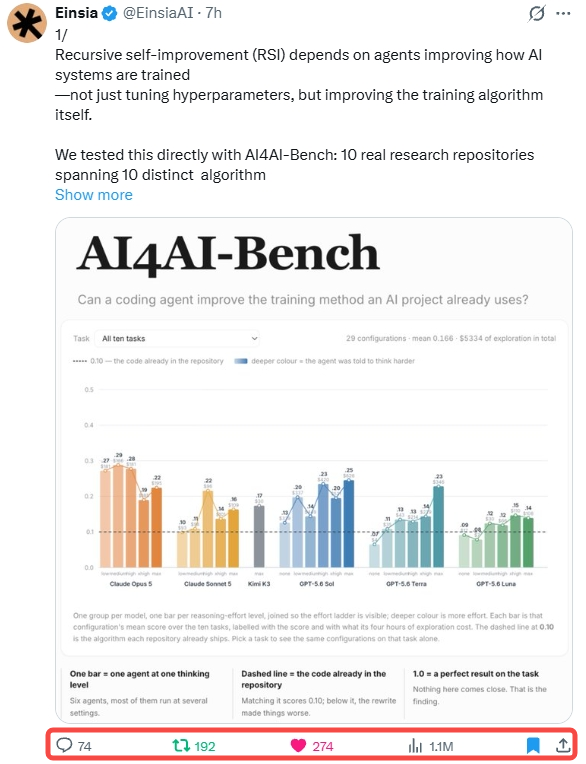
AI4AI-Bench的核心洞察在于:并非所有对AI系统的修改都具有同等价值。当前许多智能体(Agent)擅长调整训练时长、学习率、批量大小或日志记录方式,这些属于“训练怎么跑”的范畴;而真正决定模型上限的,是“模型怎么学”——即目标函数的形式、梯度更新规则、监督信号的引入方式等算法本体的变革。前者受限于现有算法框架,后者则可能开启新的能力维度。因此,该基准明确区分了超参数调整与算法机制修改,并将后者作为衡量Agent是否具备算法创新能力的关键指标。
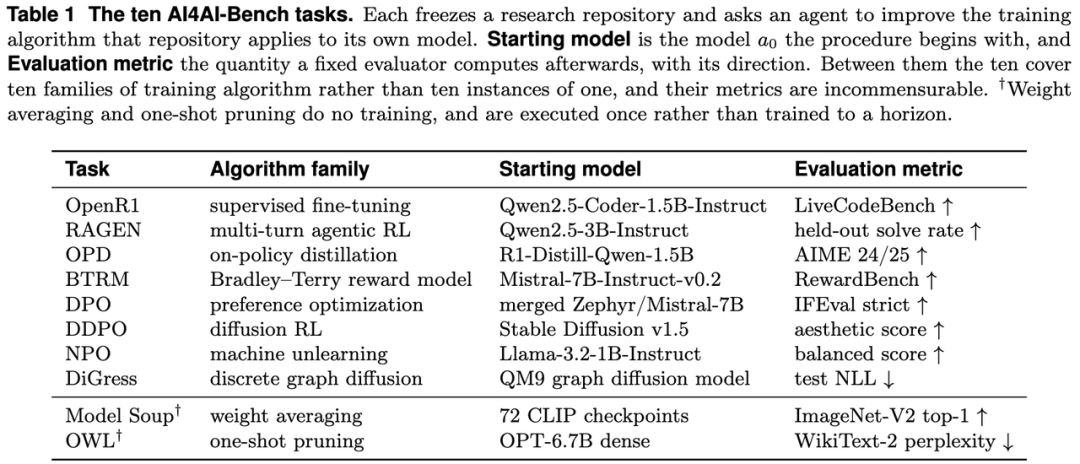
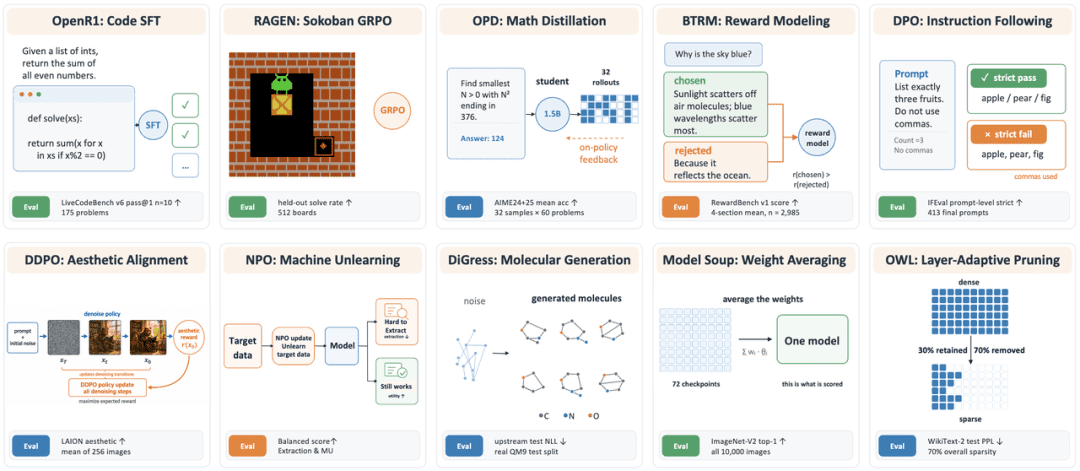
为确保评测的真实性与挑战性,AI4AI-Bench并未采用人工设计的简化任务,而是直接选取了10个活跃的开源AI研究仓库作为测试环境。这些仓库覆盖了多样化的算法问题:包括多轮Agentic强化学习、基于GRPO的策略优化、知识蒸馏、对比学习、指令微调等主流训练范式,同时也包含两个非训练类任务——模型权重平均(Model Souping)与一次性剪枝(One-shot Pruning)。尽管后两者不涉及传统意义上的训练过程,但其决策逻辑同样依赖于对模型行为机制的理解,因此被纳入算法设计的广义范畴。
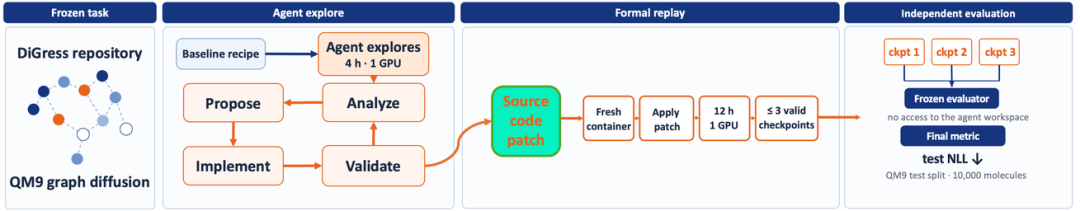
评测流程的设计尤为严谨,模拟了真实科研中的“假设-验证”闭环。第一阶段为4小时自由探索期:Agent可访问完整的代码库、数据集及一张B300 GPU,允许其阅读文档、修改代码、运行实验,并观察一个低成本代理指标(proxy metric)以快速反馈。然而,探索结束后,所有中间产物——包括训练权重、缓存文件、临时日志——均被清除,唯一保留的是Agent提交的源码变更。第二阶段为最长12小时的独立重跑:提交的代码在全新、隔离的环境中从头执行,使用与原始仓库完全相同的硬件、数据、时间预算和随机种子。最终产出的模型由一个预先冻结、Agent从未接触过的评估器(evaluator)打分,并与原始仓库的基线性能直接对比。这一设计杜绝了“过拟合特定实验环境”或“依赖临时状态”的可能性,确保结果反映的是算法本身的泛化优势。
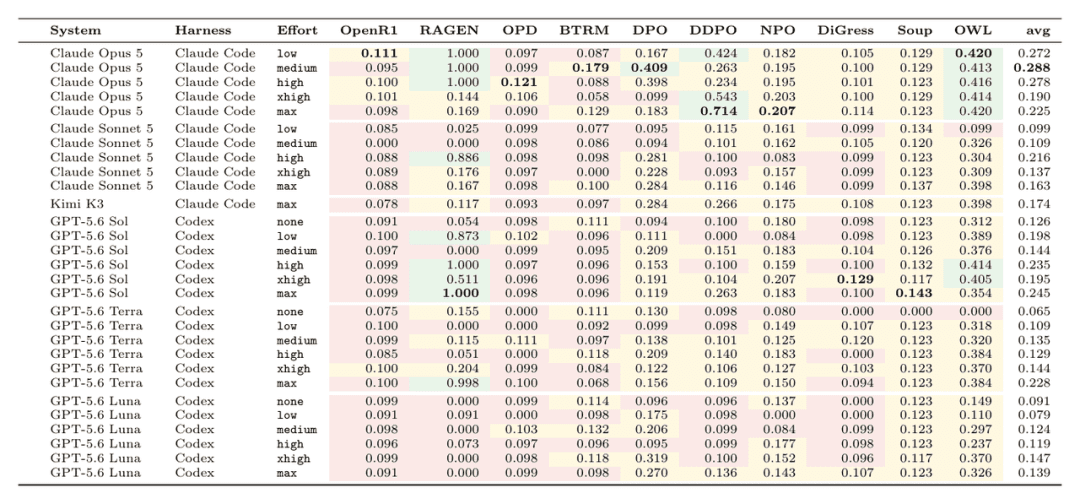
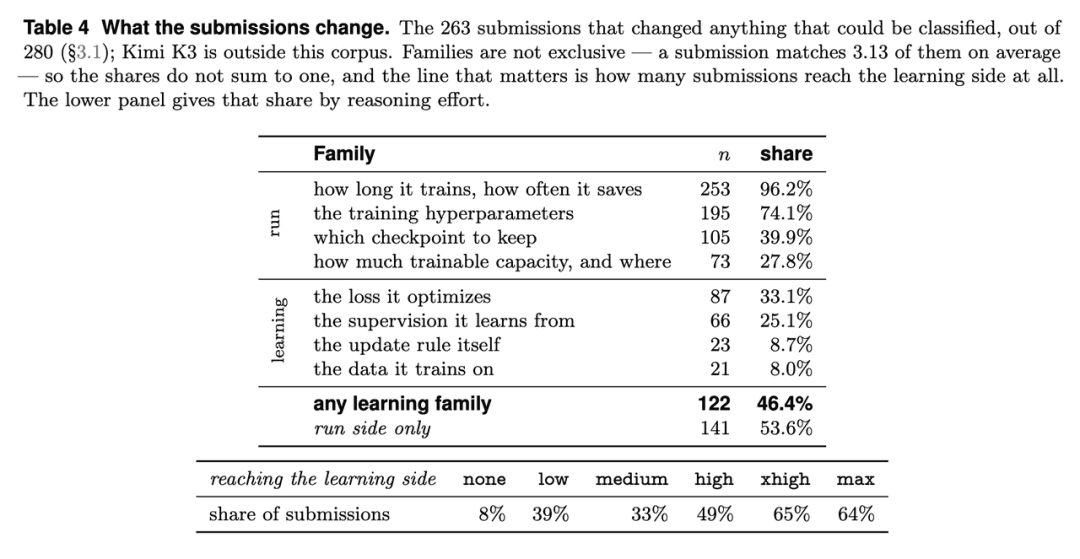
在总计290组实验中(涵盖GPT、Claude、Kimi等主流模型的不同推理配置),研究团队发现了一个关键分水岭:是否真正修改了学习机制。在263份有效提交中,141份仅调整了训练配置(如学习率调度、checkpoint保存策略、适配器位置等),而122份则深入算法核心,例如重写损失函数、引入新的监督信号、替换优化更新规则,甚至重构整个训练流程。值得注意的是,即使任务明确提示“原始方法仅为基线”,仍有超过一半的Agent停留在表层修改,反映出当前系统在问题诊断与机制干预上的局限性。
然而,一旦Agent成功进入算法层,其效果立竿见影。算法层修改的平均得分为0.226(以0.1为基线,1.0为理论最优),显著高于配置层修改的0.126,差距达0.100。这一差距在多个任务中具有一致性,尤其在多轮Agentic RL任务中,多个Agent通过引入模仿学习(Imitation Learning)实现了满分表现,而原始GRPO方案仅得0.1分。这表明,触及学习机制的修改不仅能带来性能提升,且提升幅度具有实质性意义。
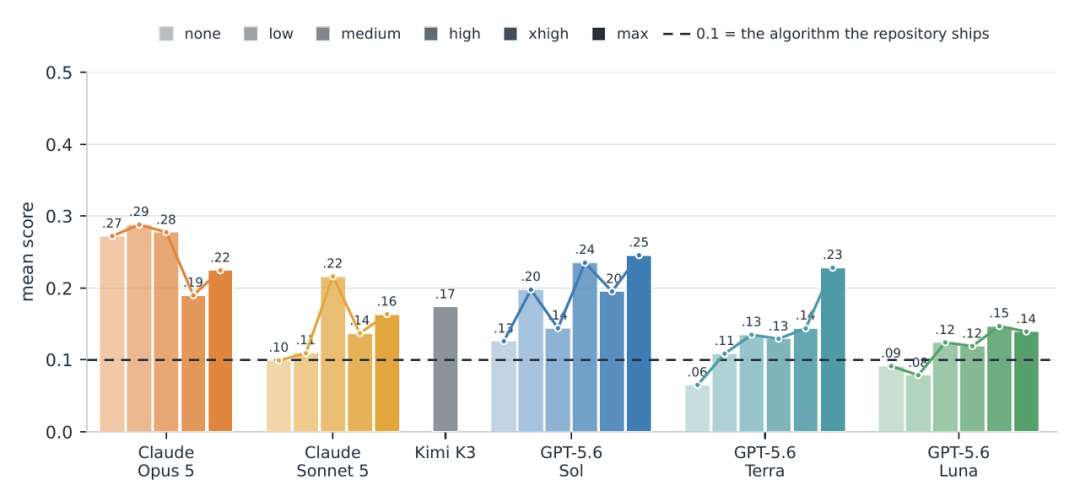
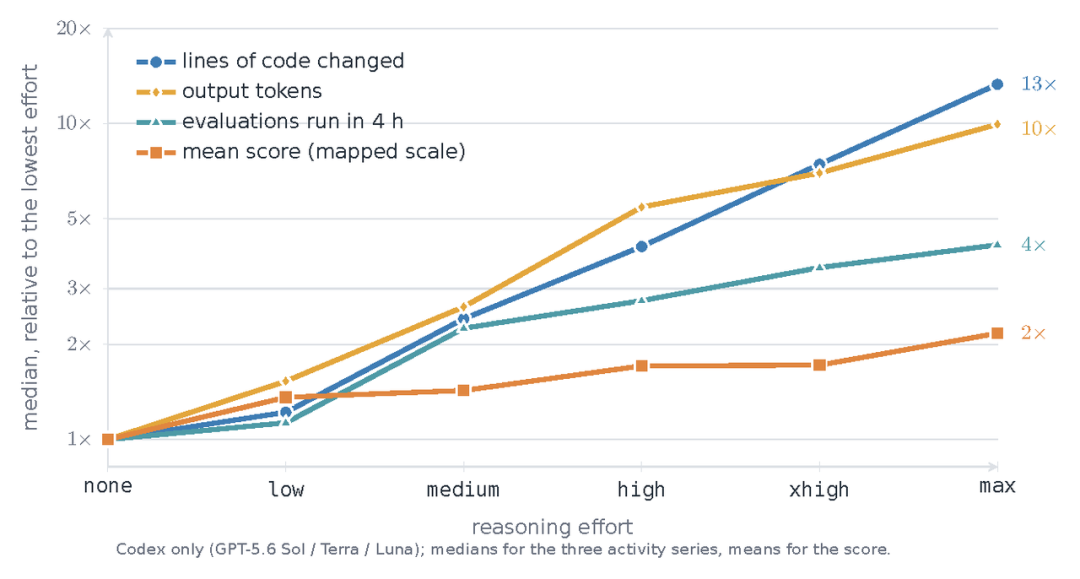
那么,什么因素能推动Agent跨越这一门槛?研究发现,推理预算(reasoning effort) 是关键杠杆。当将Agent的推理档位从最低提升至最高时,算法层修改的比例从8%跃升至64%。高推理档位下,Agent不仅输出更多token(从1.1万增至10.9万),进行更多次实验(中位数从4次增至16次),修改的代码行数也大幅增加(从18行到246行)。更重要的是,其行为模式发生质变:低档位Agent倾向于“试错式调参”,而高档位Agent则展现出机制导向的调试思维——先构建诊断工具定位问题根源,再针对性修改算法。
三个典型案例生动诠释了这种高阶能力。在One-shot剪枝任务中,原始方案直接按权重重要性剪枝,导致困惑度(perplexity)高达53.4。一个高推理档位的Agent并未止步于调整剪枝阈值,而是将整个任务重构为三阶段训练流程:首先重新设计权重存活与更新机制,继而引入逐层知识蒸馏,最后进行掩码知识蒸馏微调。尽管首次尝试因激活值覆盖错误导致困惑度飙升至572,但Agent通过追踪执行路径,精准定位到layer 0输入被layer 31激活值污染的问题,并修正了数据流,最终将困惑度降至13.2。
在权重平均任务中,原始方法对72个候选模型进行均匀加权。Agent则首先开发了一套高效评测工具:将所有模型张量预加载至GPU,并缓存代理图像,使单次组合评估耗时从190秒压缩至0.38秒,提速近500倍。在此基础上,它系统比较了多种混合策略,包括最佳单模型、Top-K选择、贪心融合(Greedy Soup),甚至使用交叉熵损失与Adam优化器直接学习混合系数,最终找到显著优于均匀平均的加权方案。
在多轮Agentic RL任务中,满分提交并未沿用原始GRPO,而是先构建棋盘求解器生成每一步的最优动作,以此对策略网络进行模仿学习预训练。部分方案进一步结合DAgger框架,让当前策略自主探索环境,并由求解器提供纠正标签,形成“探索-纠正”闭环。这种“先教最优解,再让模型学习”的思路,大幅降低了纯强化学习的样本复杂度。
这三个案例虽领域迥异,却共享同一方法论内核:在动手修改前,先构建验证判断的工具或先验。无论是定位激活污染、加速组合评估,还是生成最优动作序列,Agent都优先解决了“如何知道我的修改是否正确”这一元问题。这正是人类算法研究员的核心能力——不是盲目尝试,而是基于对系统动态的理解,提出可证伪的假设。
当然,当前成果仍属初步。即便在最高推理档位下,平均得分0.196距离理论最优(1.0)仍有巨大鸿沟,表明Agent的算法设计能力尚不稳定,高度依赖任务特性与随机性。此外,多数成功案例集中在结构清晰、可形式化定义的任务(如棋盘游戏、剪枝),在更开放、模糊的算法问题上表现有限。
尽管如此,AI4AI-Bench的意义远超榜单排名。它首次为“AI能否设计AI”这一哲学命题提供了实证锚点,证明大模型Agent已具备偶尔触及算法创新的能力,且这种能力可通过增加推理资源被系统性激发。未来的研究方向或将聚焦于:如何构建更强大的机制诊断模块、如何将领域知识嵌入Agent的推理链、以及如何设计奖励机制引导其关注算法本质而非表面指标。
可以预见,当AI不仅能写代码、调参数,更能稳定地提出新损失函数、新训练范式、新优化策略时,递归自改进的飞轮才真正开始转动。而AI4AI-Bench,正是测量这一飞轮转速的第一把标尺。