FreeToken如何让消费级显卡跑起284B大模型?MoE端侧推理的四大技术突破
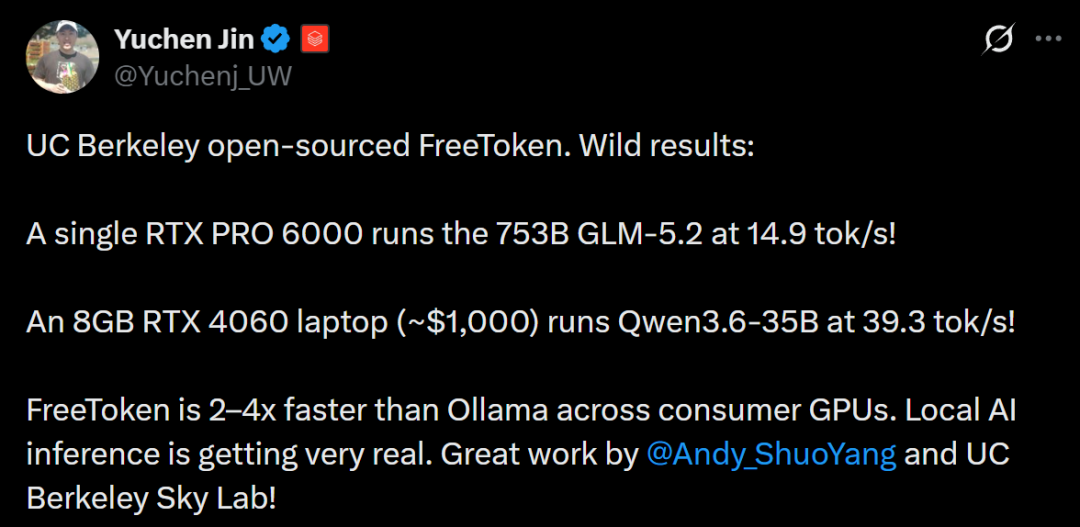
近期,一个名为 FreeToken 的开源项目在 AI 社区引发了广泛关注。它宣称能让搭载 RTX 4060 的普通笔记本流畅运行 Qwen3.6-35B 模型,甚至让桌面级 RTX 5090 单卡承载 DeepSeek-V4-Flash 这样参数量高达 284B 的混合专家(MoE)大模型。更令人惊讶的是,其推理速度不仅达到“可用”水平,部分指标甚至超越了专业云服务——例如在 RTX 4060 上实现 39.3 token/s 的解码速度,已超过 Codex 生产环境的中位数(33 token/s)。这一成果由 UC Berkeley、MIT 等机构联合团队推出,标志着大模型本地化部署迈入新阶段。
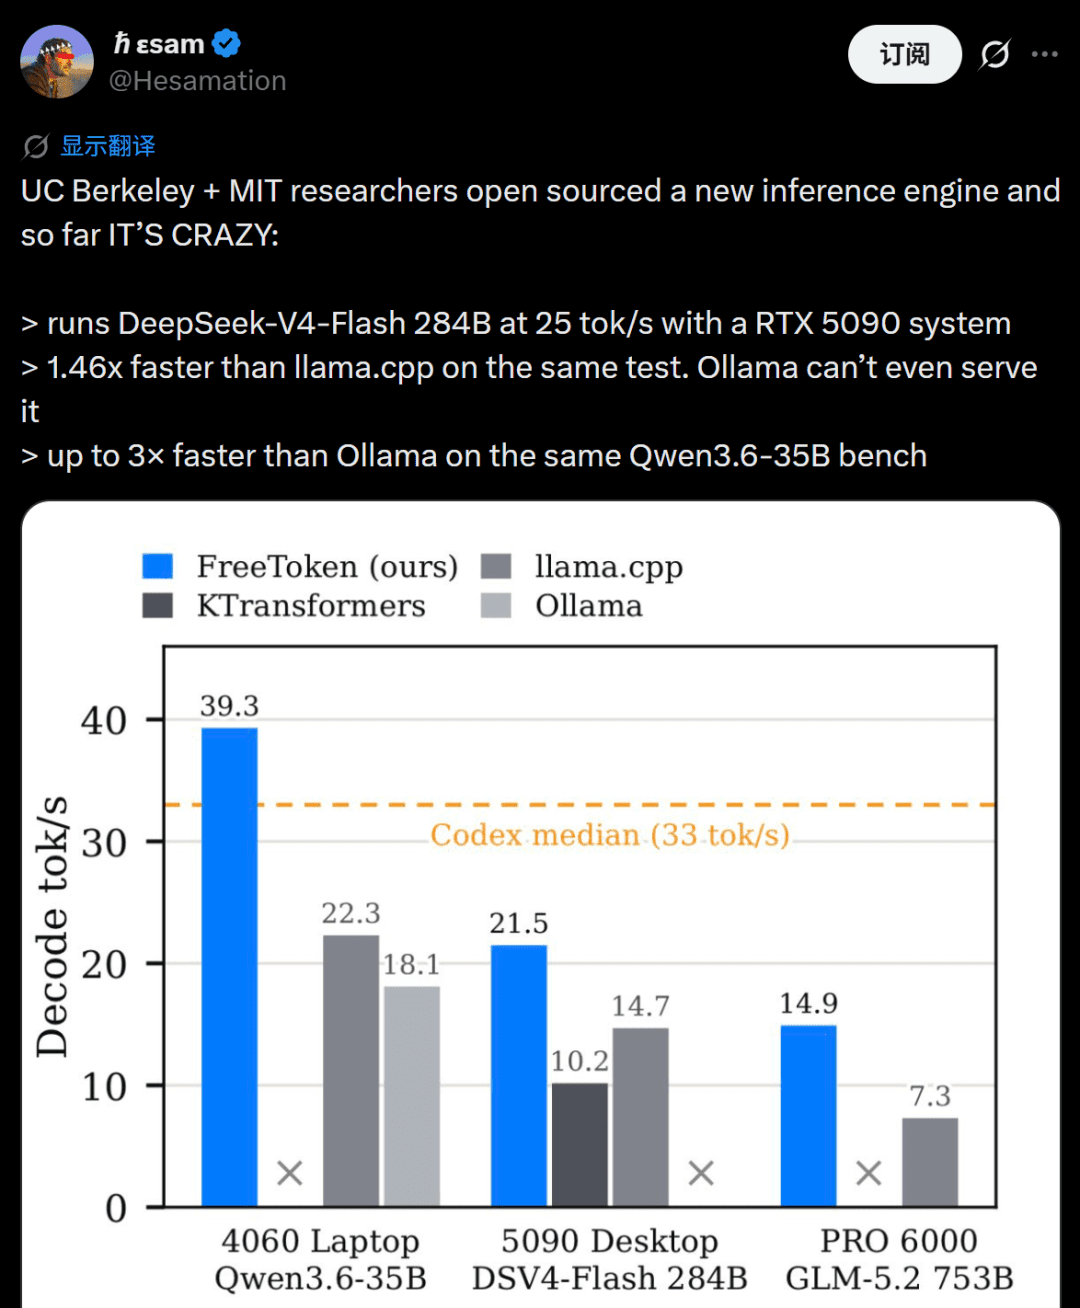
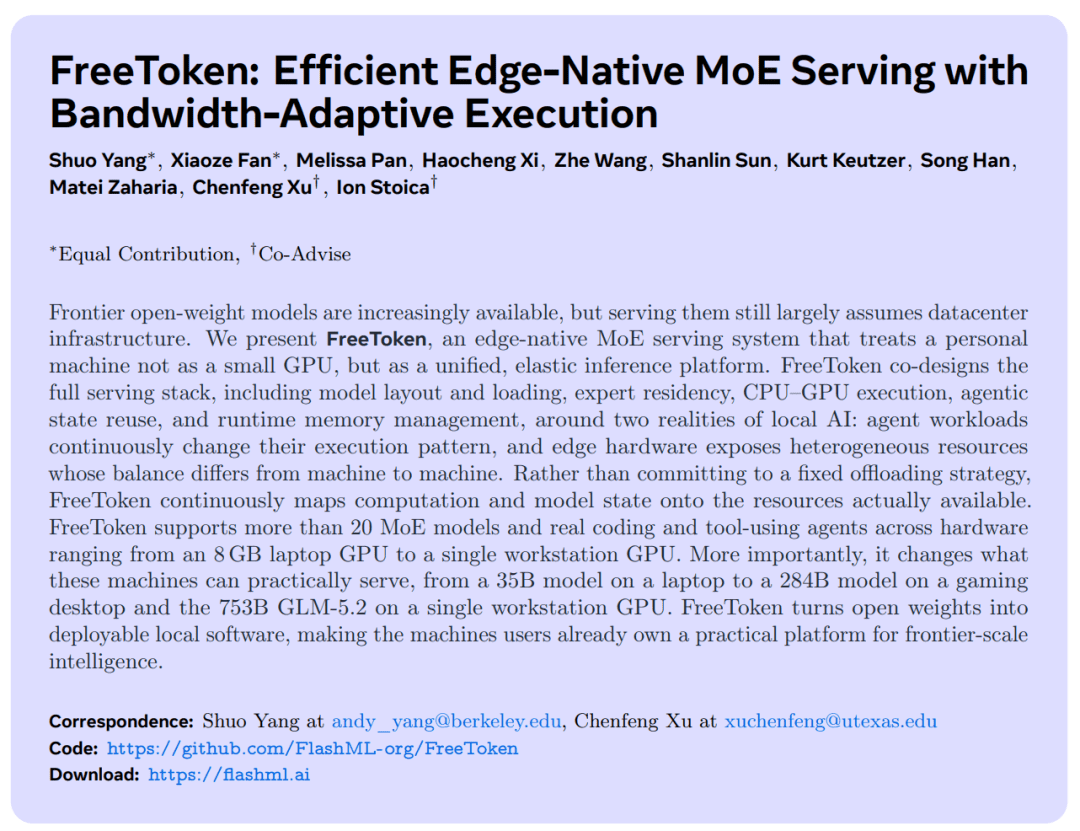
传统观点认为,百亿乃至千亿参数的大模型必须依赖数据中心级别的 GPU 集群才能运行。即便采用权重卸载(offloading)技术将部分模型参数从显存放至系统内存,也常因 PCIe 带宽瓶颈导致推理速度极低,每秒仅几 token,用户体验近乎卡顿。FreeToken 的出现打破了这一限制,其核心在于针对 MoE 架构特性与消费级硬件资源进行深度协同优化,而非简单地将数据中心方案“缩小”到端侧。
MoE 模型虽在计算上具有稀疏性(每次前向传播仅激活部分专家),但其完整专家池的内存占用仍远超消费级 GPU 显存容量。以 DeepSeek-V4-Flash 为例,总参数达 284B,每层包含 256 个专家,每次激活 6 个,单 token 实际计算量约 13B 参数。然而,在处理长提示(prompt)时,prefill 阶段会破坏稀疏性——由于不同 token 可能路由至不同专家,整个 prompt 所涉及的专家集合几乎覆盖所有层的全部专家。这意味着即使只推理一个长文本,也需要将接近完整的专家权重(约 140GB)通过 PCIe 总线从内存传输至 GPU。对于 RTX 5090(32GB 显存)而言,这不仅造成巨大 I/O 压力,还会导致 GPU 在等待数据期间长时间空转,严重拖慢整体吞吐。
FreeToken 的第一项关键技术是全层双缓冲 Prefill(Double-Buffered Prefill)。该机制在 prompt 处理阶段实现了计算与数据搬运的完全重叠。具体而言,当 GPU 正在执行第 l 层的计算时,系统已在后台通过 PCIe 预取第 l+1 层所需的专家权重,并缓存至 GPU 显存中的预留缓冲区。一旦第 l 层计算完成,第 l+1 层的数据已就绪,可立即开始计算,从而基本消除了传统 offloading 中因等待数据而产生的“I/O 气泡”。这种流水线式调度极大提升了 GPU 利用率,使得即使在带宽受限的 PCIe 3.0 x8 环境下,也能维持较高的有效吞吐。
第二项突破在于带宽自适应的混合调度(Bandwidth-Adaptive Execution)。FreeToken 并非简单地将未命中的专家全部卸载至 CPU,而是构建了一个动态决策引擎。系统在运行时持续监测当前 PCIe 实际可用带宽、CPU 瞬时算力以及 GPU 负载状态,实时计算出最优的分流比例 q*。一部分高频访问的专家被保留在 GPU 的 LRU 缓存中;对于未命中的专家,系统根据当前带宽状况智能决定:若带宽充足,则优先传输至 GPU 计算;若带宽紧张或 CPU 空闲,则直接在 CPU 上并行执行相应专家的前向传播。这种策略确保了无论硬件环境如何变化(如后台运行游戏或渲染任务抢占总线),系统总能收敛至该拓扑下的理论最大吞吐上限。
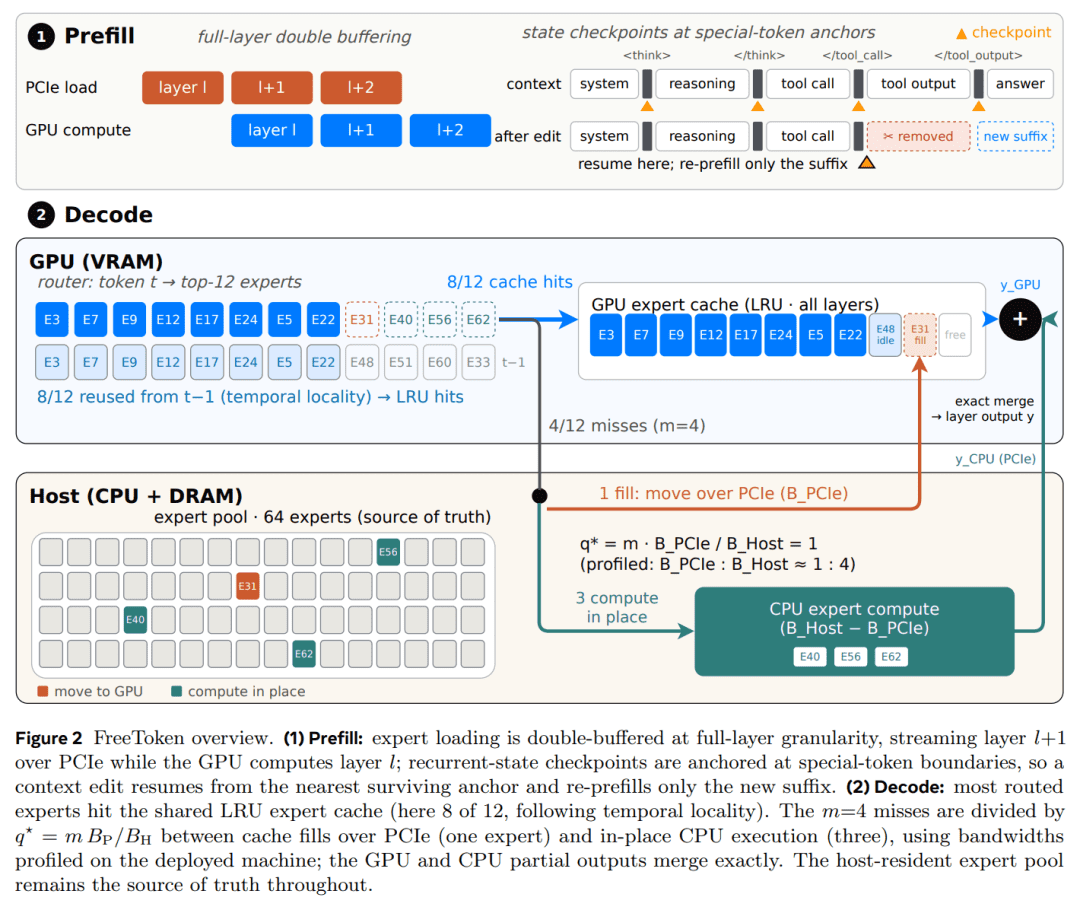
第三项创新聚焦于面向 Agent 的智能状态复用(Agentic State Reuse)。现代 AI 智能体(如 Claude Code、OpenClaw)通常采用循环交互模式:用户输入 → 模型生成思考步骤 → 调用工具 → 接收结果 → 继续推理。每次工具调用都会在上下文中追加新内容,导致历史状态发生局部修改。传统方案因无法增量更新 KV Cache,只能依赖检查点(checkpoint)回退重算。而检查点本身占用大量内存(相当于数百 token 的 KV 状态),且上下文一旦修改,后续所有检查点即失效,需从最近有效点重新计算数千 token,这对消费级 GPU 是沉重负担。
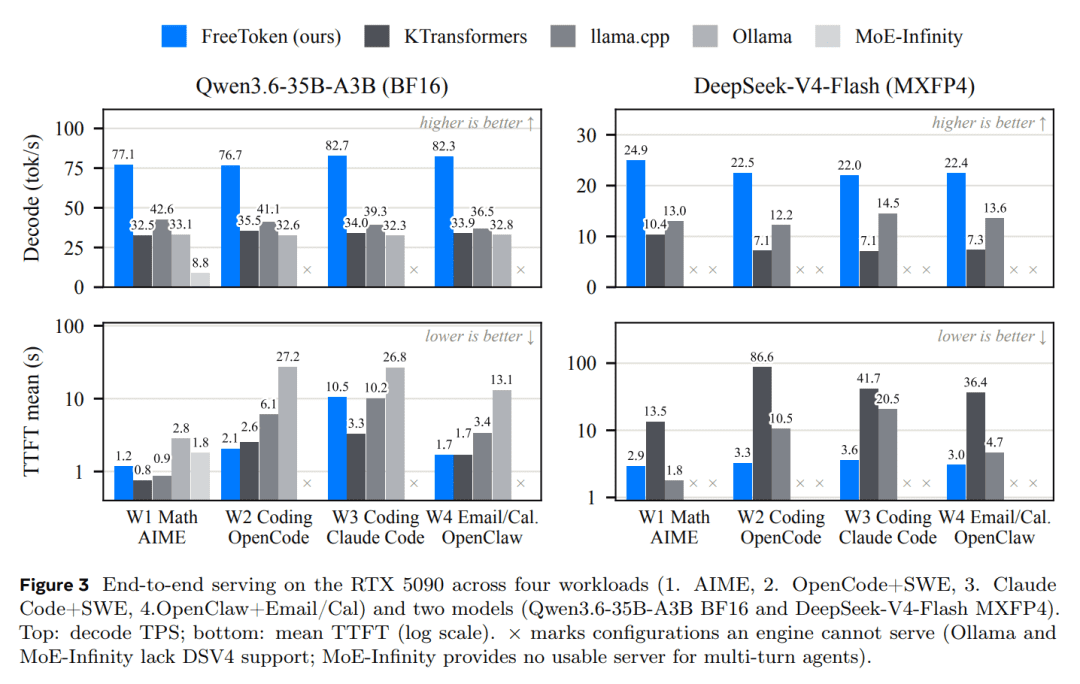
FreeToken 在特殊 token 边界(如工具调用结束符)自动插入轻量级检查点。这些检查点仅记录关键状态指针,体积远小于完整 KV Cache。当上下文被编辑时,系统仅需从最近锚点恢复,并对新增部分进行增量 prefill,避免了全局重算。实测显示,在多轮工具调用场景中,该机制将后续交互的首 Token 延迟(TTFT)降低了 65%–80%,显著提升了智能体的响应流畅度。
最后一项关键技术是弹性显存动态热扩缩容。个人电脑环境复杂,显存常被浏览器、游戏或其他应用动态占用。传统推理框架一旦显存不足即触发 CUDA Out of Memory (OOM) 错误,导致服务中断。FreeToken 引入了显存感知的缓存管理器,可在不重启服务的前提下,根据实时显存压力动态调整 GPU 中专家缓存的大小。当检测到显存骤降(如游戏启动占用 4–8GB),系统会无缝收缩 LRU Cache,将更多未命中专家交由 CPU 处理,实现服务的平滑降级。这种“零停机”容错能力极大增强了端侧部署的鲁棒性。
综合来看,FreeToken 并非单一算法的改进,而是一套针对 MoE 模型与消费级硬件特性的全栈协同设计。它将 CPU、GPU、系统内存和 PCIe 总线视为一个统一的弹性计算平台,通过软硬件协同调度,最大化利用每一部分资源。其效果已在多种硬件配置下得到验证:在配备 RTX 4060(8GB 显存)、DDR5 64GB 内存的笔记本上,Qwen3.6-35B 可稳定输出 39.3 token/s;而在高端桌面平台(RTX 5090 + 192GB DDR5),DeepSeek-V4-Flash 不仅能运行,还能在长上下文和多轮交互中保持低延迟。
当然,这种方案对系统内存提出了较高要求。以 DeepSeek-V4-Flash 为例,其 140GB 的专家池意味着用户至少需要 192GB 内存才能保证流畅运行。但这相比动辄数十万元的数据中心集群,成本已大幅降低。更重要的是,它让顶尖 AI 能力真正走向个人用户——无需联网、无隐私泄露风险、无 API 调用限制,完全掌控在自己手中。
FreeToken 的开源(GitHub 已发布 Windows/Linux GUI 应用及 CLI 工具)为社区提供了强大基础设施。未来,随着更多 MoE 模型开放权重,以及消费级硬件持续升级(如 PCIe 5.0 普及、DDR5 内存价格下降),本地运行百亿级智能体或将成为常态。这不仅推动 AI 民主化,也为开发者探索新型人机交互范式(如离线智能助手、本地代码生成器)开辟了广阔空间。或许正如项目所暗示的那样,我们距离在个人设备上运行 Qwen3.8-A3B 这样的终极模型,已经不远了。