GigaBrain-0.7如何打通具身智能Scaling路径?双金字塔范式与System-3架构深度解析
在2026世界机器人大会(WRC)的C326展台,最引人注目的并非炫目的机械臂或复杂的传感器阵列,而是一张普通的乒乓球台——上面站着一台人形机器人,正与观众进行实时对打。这一看似简单的互动背后,实则承载着极佳视界对具身智能未来路径的系统性思考。作为一家以世界模型技术起家的公司,极佳视界并未止步于展示孤立的技术亮点,而是试图在现场铺开一条从感知、决策到执行的完整能力链路。这条链路的核心,正是8月19日发布的GigaBrain-0.7具身基础模型。
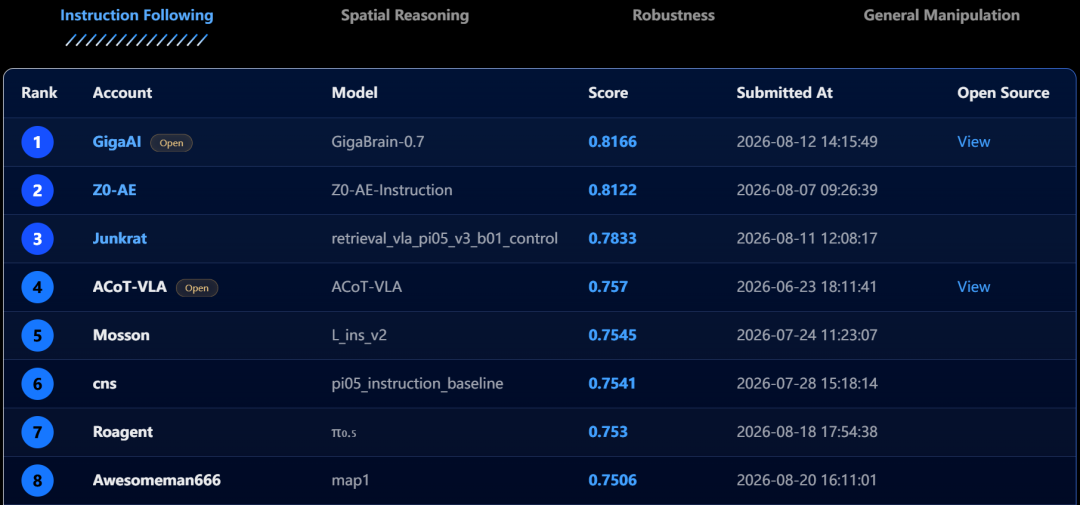
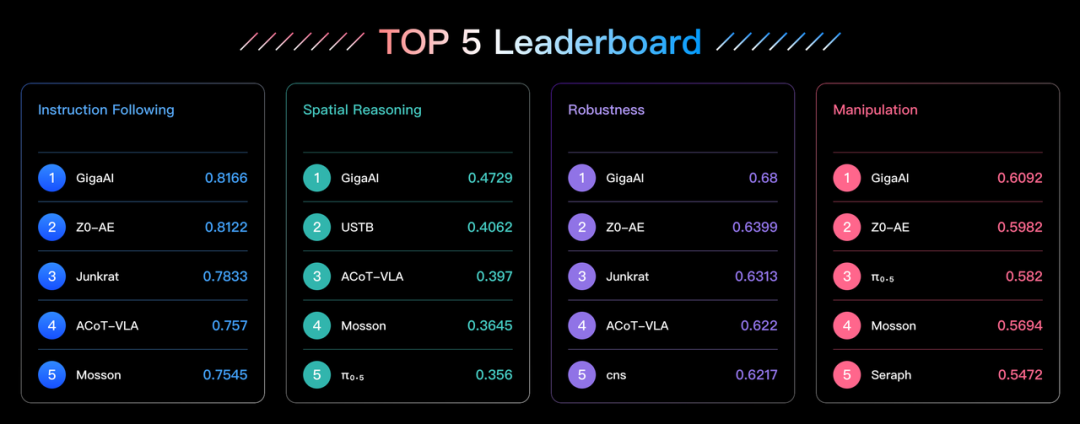
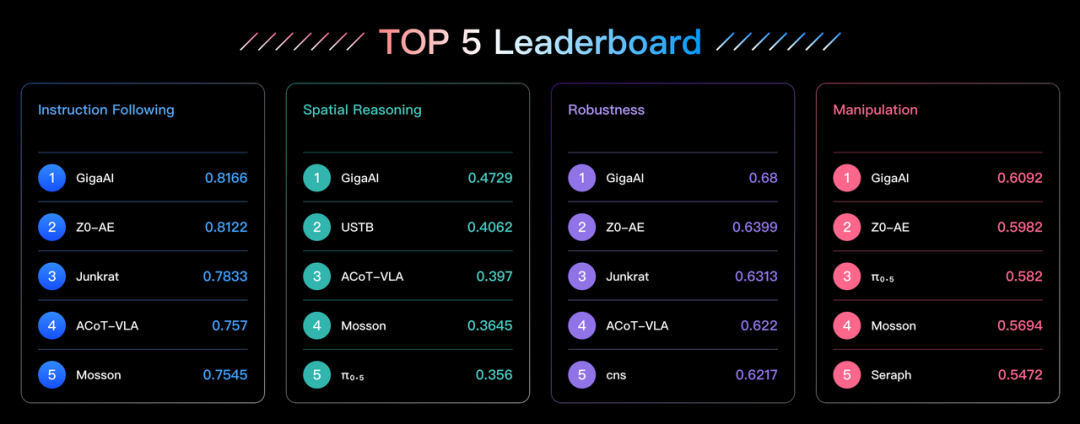
GigaBrain-0.7的发布恰逢其时。就在五天前,智元推出的RoboColiseum评测平台正式上线,该平台以“仿真与真机高度一致”为设计原则,涵盖4类能力维度、78项仿真任务,迅速吸引了全球40余支研究团队参与打擂。令人瞩目的是,GigaBrain-0.7在平台开放后第五天便一举包揽全部四个分项榜首,展现出压倒性的综合性能。这一成绩不仅验证了模型的技术先进性,更折射出极佳视界自今年二季度以来持续推进的“数据金字塔+算法金字塔”双轮驱动范式的初步成效。
双金字塔范式:构建可扩展具身智能的底层逻辑
当前具身智能领域面临一个根本性问题:如何像大语言模型那样实现有效的Scaling?换言之,是否存在一条清晰的技术路径,使得增加数据和算力能稳定带来性能提升,而非陷入边际效益递减的泥潭?极佳视界率先将这一问题提炼为行业核心命题,并提出“双金字塔”作为解决方案。
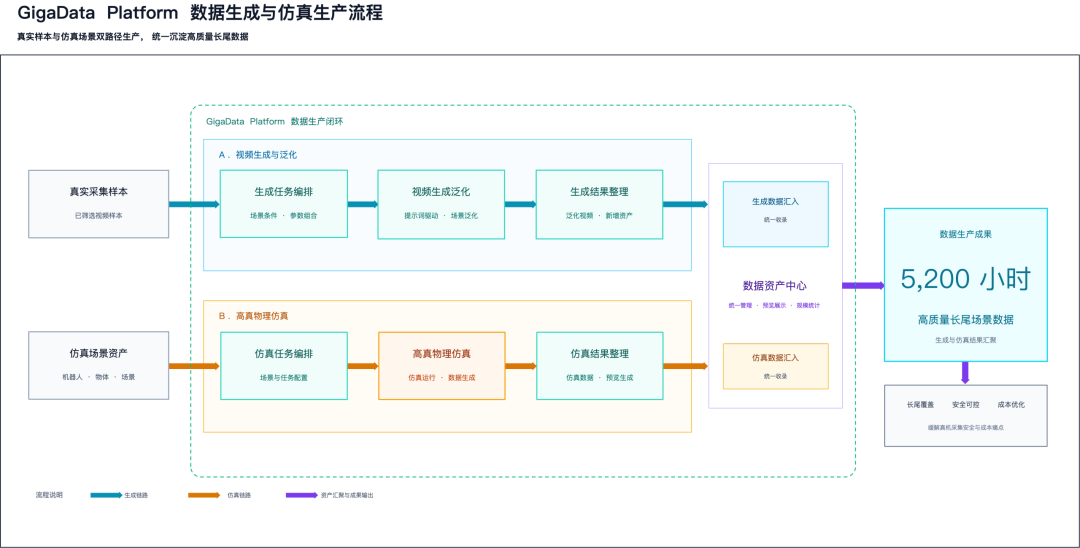
所谓“数据金字塔”,是指从底层到顶层依次包含:海量互联网图文数据、传感器同构的真人示教数据、高保真仿真与生成数据、大规模真机操作数据,以及闭环反馈的经验强化数据。每一层数据不仅规模递增,更重要的是其与物理世界的耦合度逐步加深,为模型提供从通用认知到精细操控的全谱系训练信号。
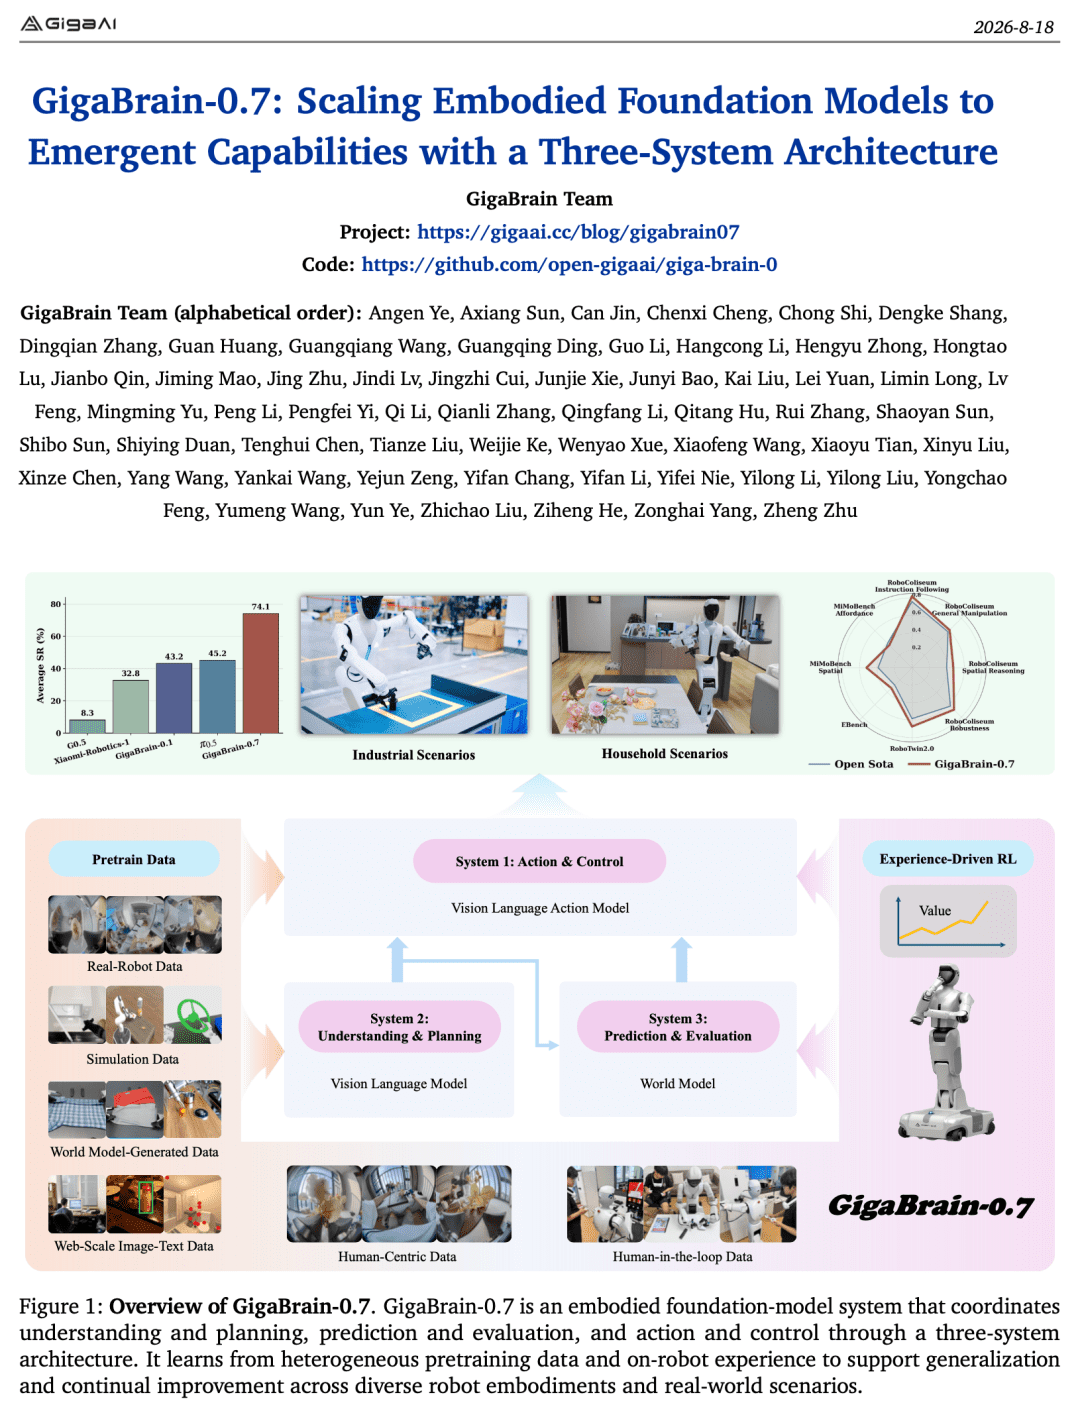
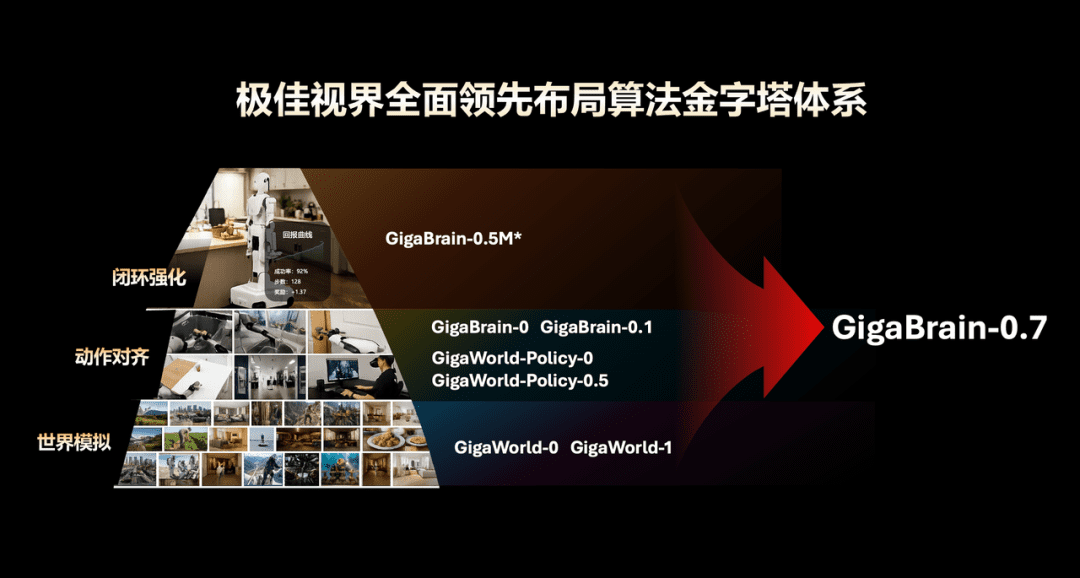
而“算法金字塔”则对应三层架构:第一层是世界模拟(World Simulation),赋予模型对物理规律的理解与未来状态的预判能力;第二层是动作对齐(Action Alignment),实现跨本体的高质量连续动作生成;第三层是经验强化(Experience Reinforcement),通过离线与在线学习持续优化策略。这三层并非简单堆叠,而是通过端到端联合训练形成闭环反馈。
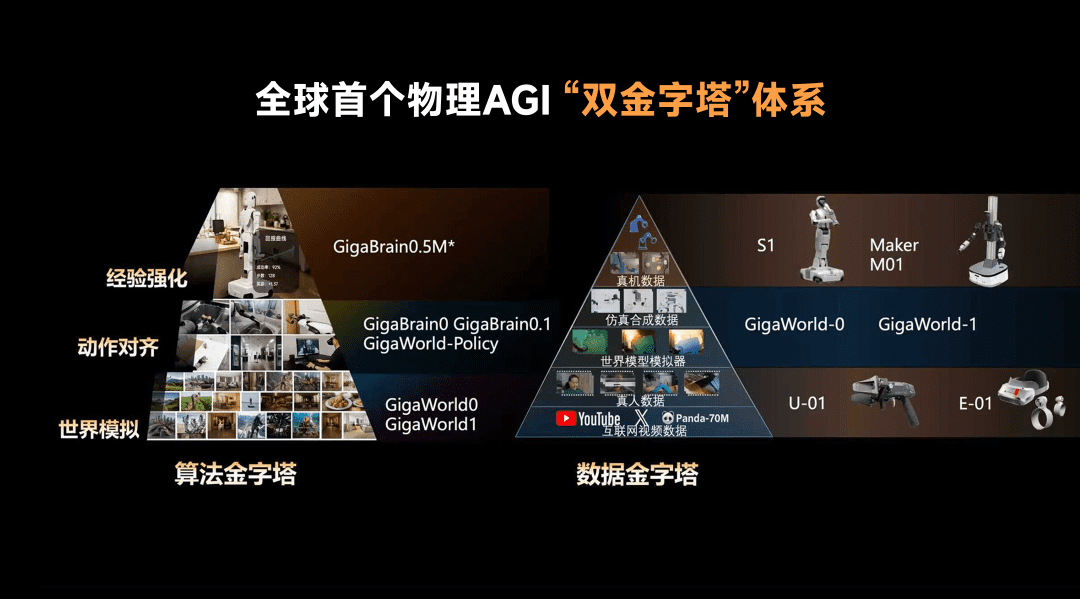
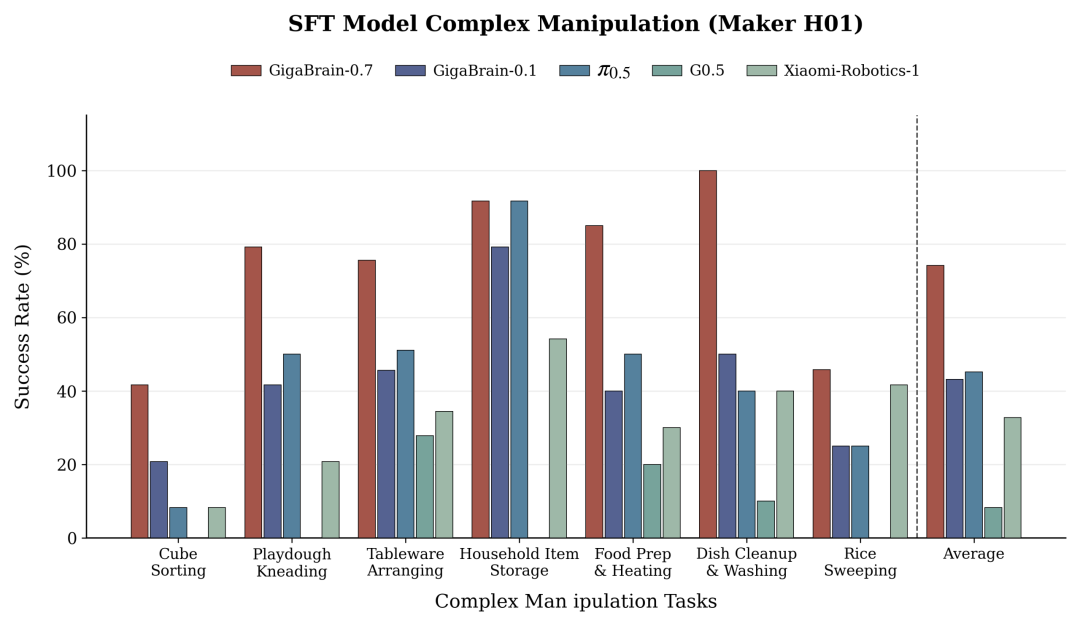
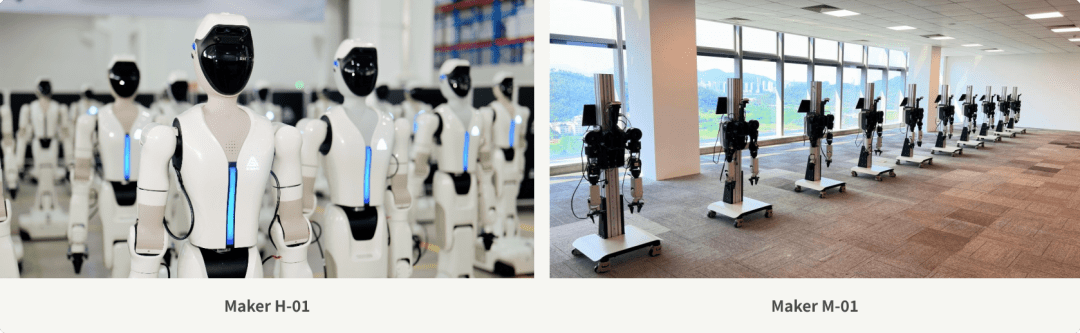
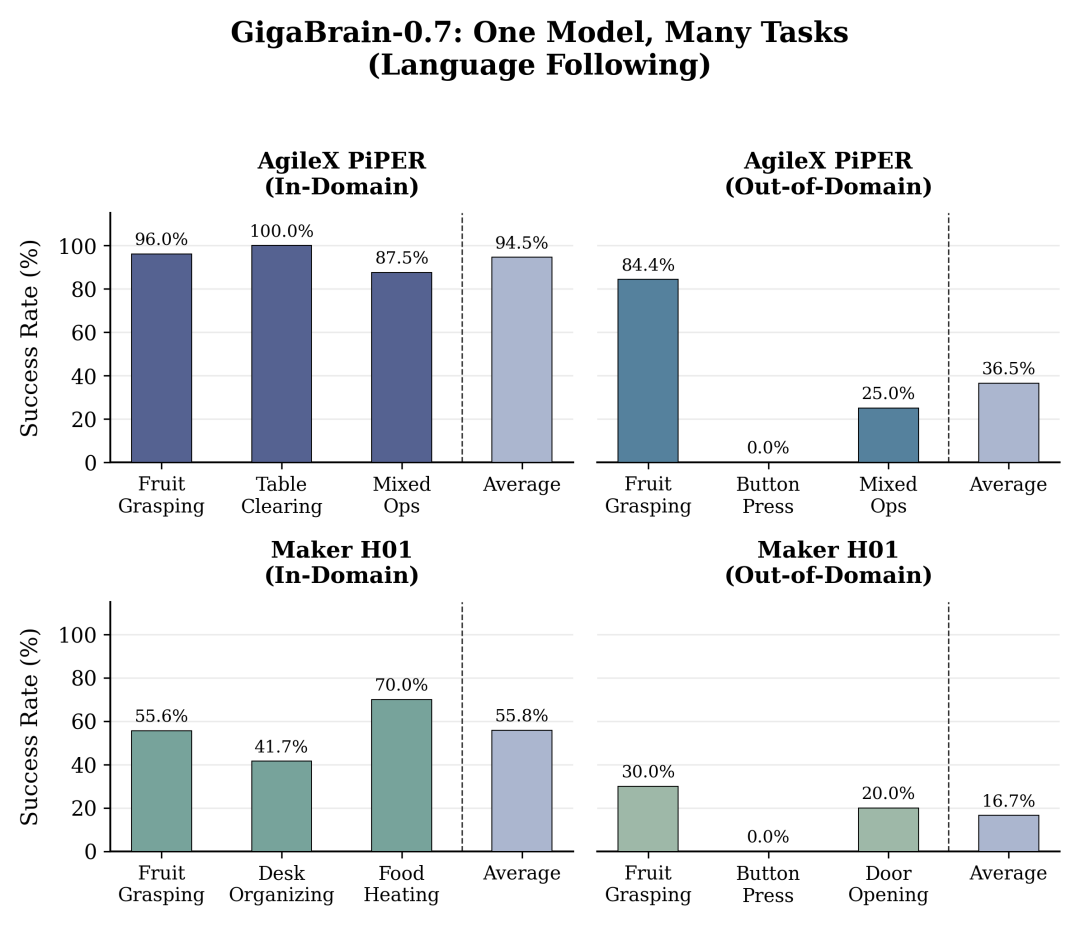
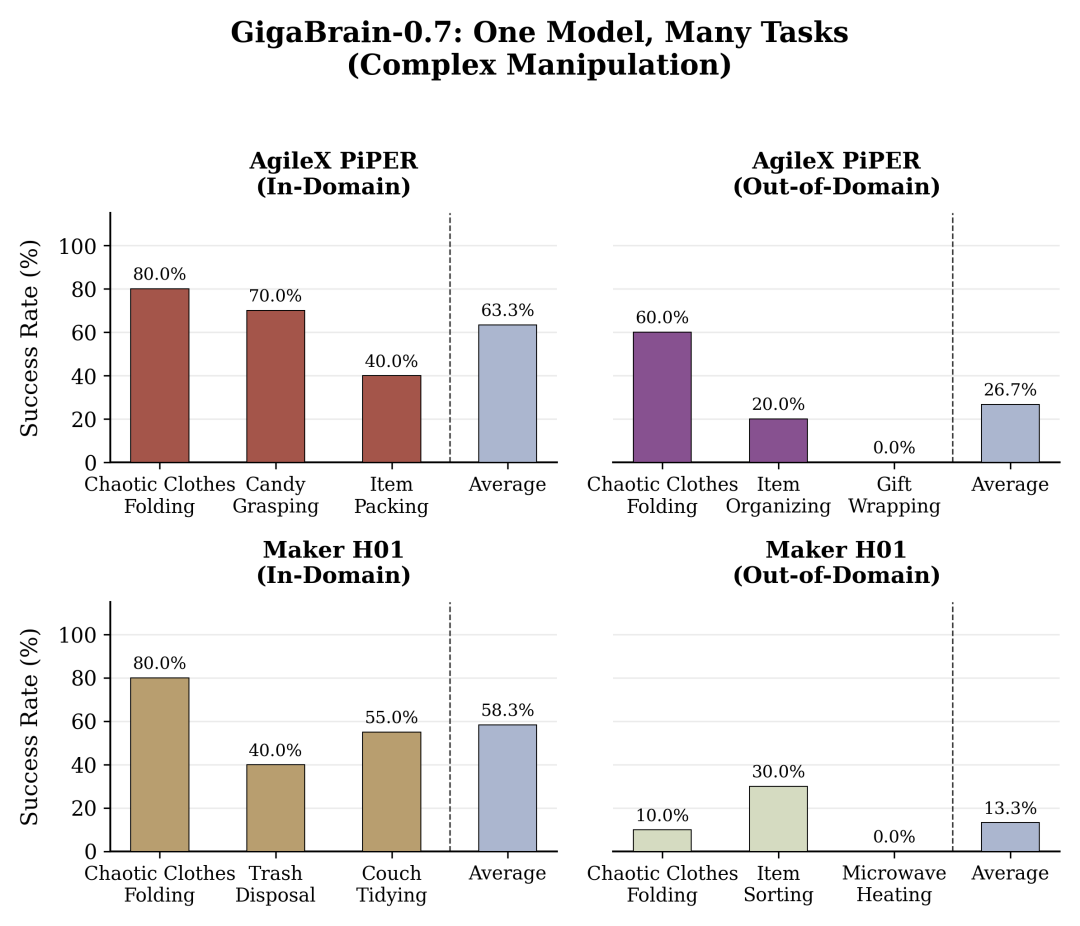
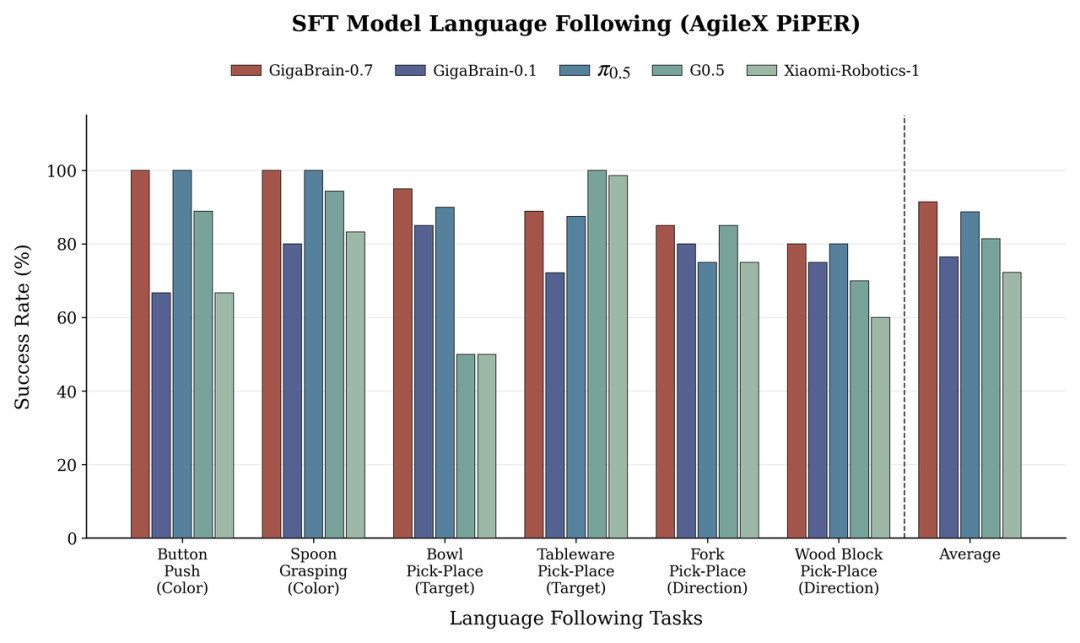
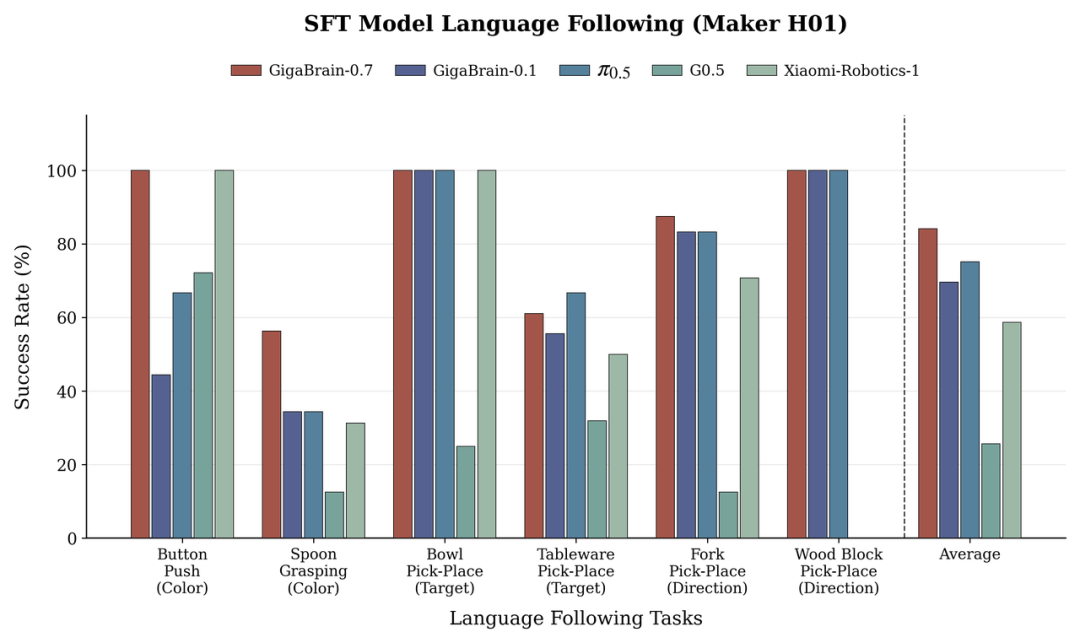
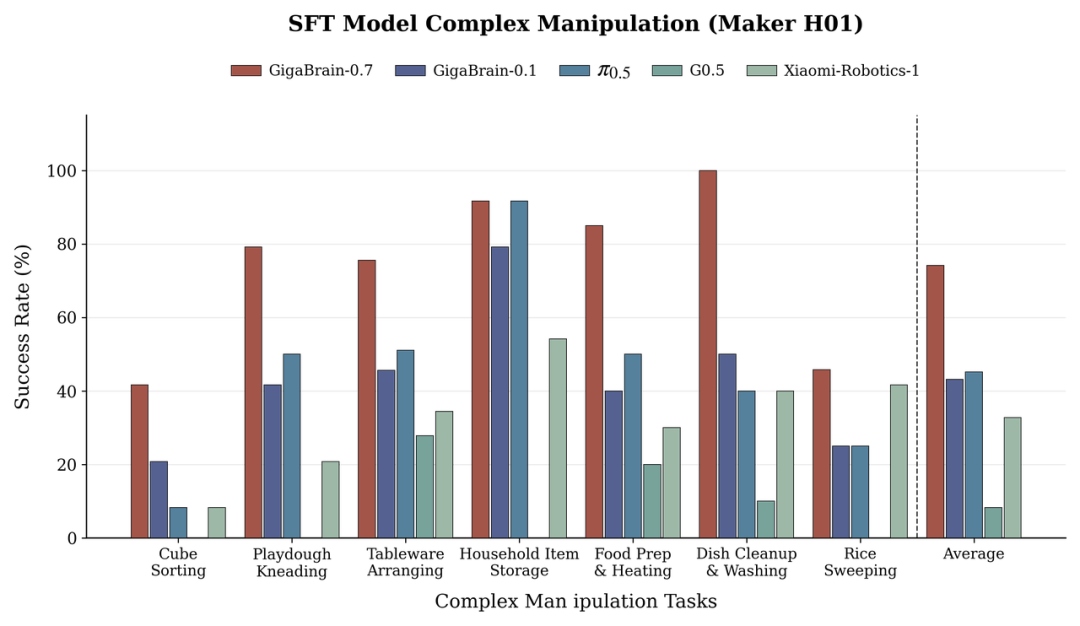
GigaBrain-0.7的价值在于,它首次系统性地验证了这一范式在工程实践中的可行性。在相同真机评估基准下,其性能全面超越全球主流开源模型,尤其在自研人形本体Maker H01上展现出“断档领先”的优势。更关键的是,该模型无需针对每个任务进行微调,即可实现“One Model, Many Tasks”的开箱即用能力,标志着具身基模从概念走向实用。
System-3:将世界模型嵌入实时决策回路
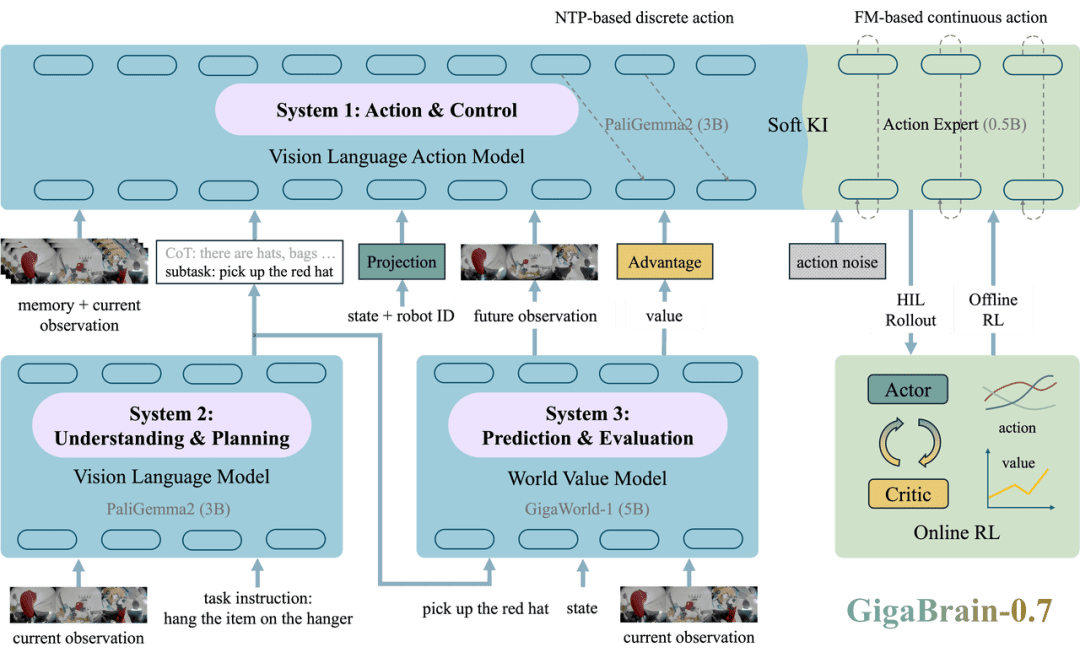
传统视觉-语言-动作(VLA)模型通常采用“感知→规划→执行”的线性流程,缺乏对动作后果的前瞻性判断。这在简单任务中尚可接受,但在长程、高动态或存在不确定性的场景中极易失败。GigaBrain-0.7的突破在于首次提出System-3概念,将世界模型(World Model)直接嵌入机器人的实时决策回路。
具体而言,System-3基于极佳视界此前发布的GigaWorld-1,能够同步生成两项关键输出:一是对未来动作价值的评估(Action Value Feedback),二是对未来关键状态的视觉图像预测。这些“未来表征”被编码后即时注入GigaBrain-0.7的输入提示(prompt)中,使机器人在执行动作前完成一次“内部预演”。
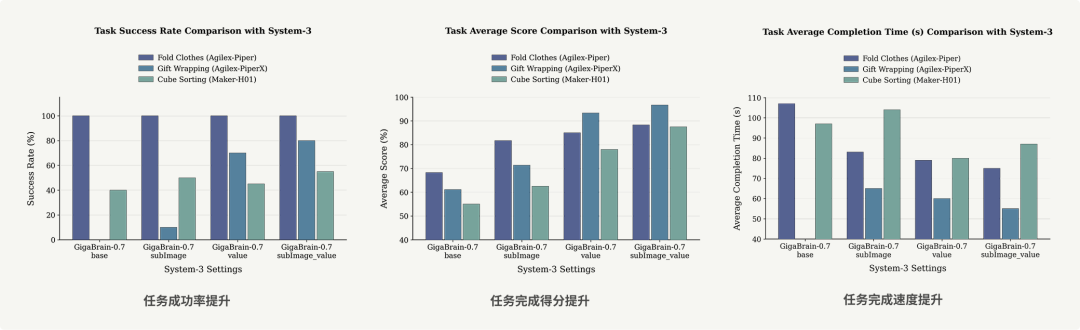
这种机制显著提升了高难度任务的成功率。例如在家庭场景中整理散落物品时,机器人需判断拿起某件物品是否会引发其他物体滑落。传统VLA可能直接执行抓取,而GigaBrain-0.7则会先通过System-3模拟抓取后的桌面状态,若预测存在连锁反应,则调整抓取顺序或施力方式。实验数据显示,在包含10个以上子任务的长程操作中,引入System-3后任务完成速度提升约35%,成功率提高近20个百分点。
值得注意的是,System-3并非独立模块,而是与VLM主干深度融合。通过原生时空交互注意力机制(Temporal-Spatial Block),模型在空间视觉Token中引入相对位置与时间编码,有效解决了具身任务中的长程时序依赖问题。这种设计避免了传统方法中世界模型与策略网络分离导致的信息损失,实现了真正的端到端可微分推理。
动作对齐与经验强化:跨本体泛化与持续进化
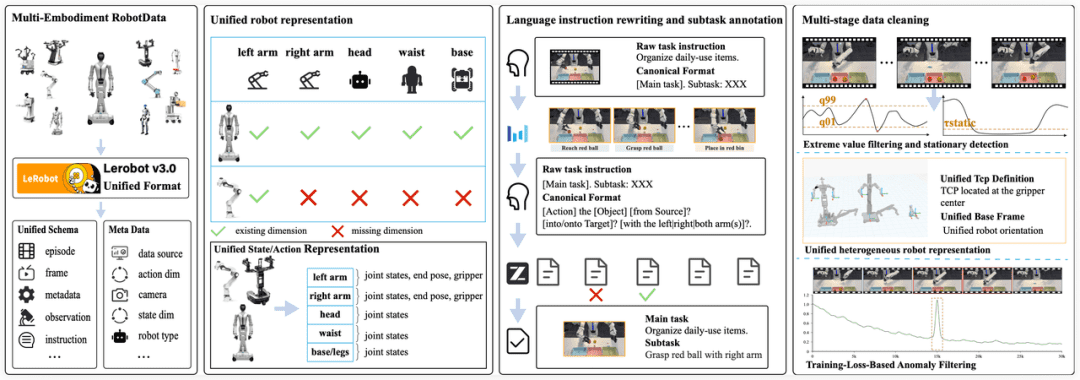
具身智能的另一大挑战是如何实现跨机器人本体的知识迁移。不同形态的机器人(如双臂轮式、人形、四足)在关节自由度、传感器布局、动力学特性上差异巨大,传统方法往往需要为每种本体单独训练模型,成本高昂且难以扩展。
GigaBrain-0.7通过“共享动作专家”(Shared Action Expert)机制破解此难题。其动作生成模块基于MoT(Mixture of Trajectories)架构,采用Flow Matching范式生成连续动作轨迹。核心Transformer参数在所有本体间共享,仅通过本体类型ID(Robot ID)路由至对应的输入/输出投影层。这种设计既保留了通用动作知识,又适配了特定本体的物理约束。
为防止专用操控知识污染通用视觉语言理解能力,模型还引入了“软知识隔离”(Soft Knowledge Insulation)机制。该机制在Action Expert与VLM主干之间设置信息瓶颈,确保高层任务规划不受底层动作细节干扰,从而维持模型在未知指令下的强泛化性。
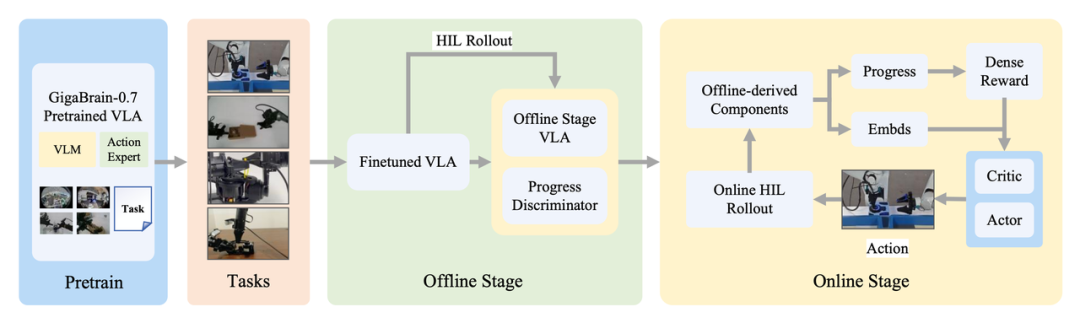
在经验强化层面,GigaBrain-0.7构建了三级学习管线。首先是监督微调,利用少量专家数据建立基础能力;其次是离线强化,通过真机Rollout数据与人类标注构建稠密奖励信号,使模型具备错误恢复与进度评估能力;最后是在线持续强化,针对高精度任务(如插拔精密接头),通过人类在环实时修正动作轨迹,直至达到100%稳定成功率。这种渐进式学习策略大幅降低了对初始专家数据的依赖,提升了数据利用效率。
数据基建:五层金字塔支撑Scaling Laws
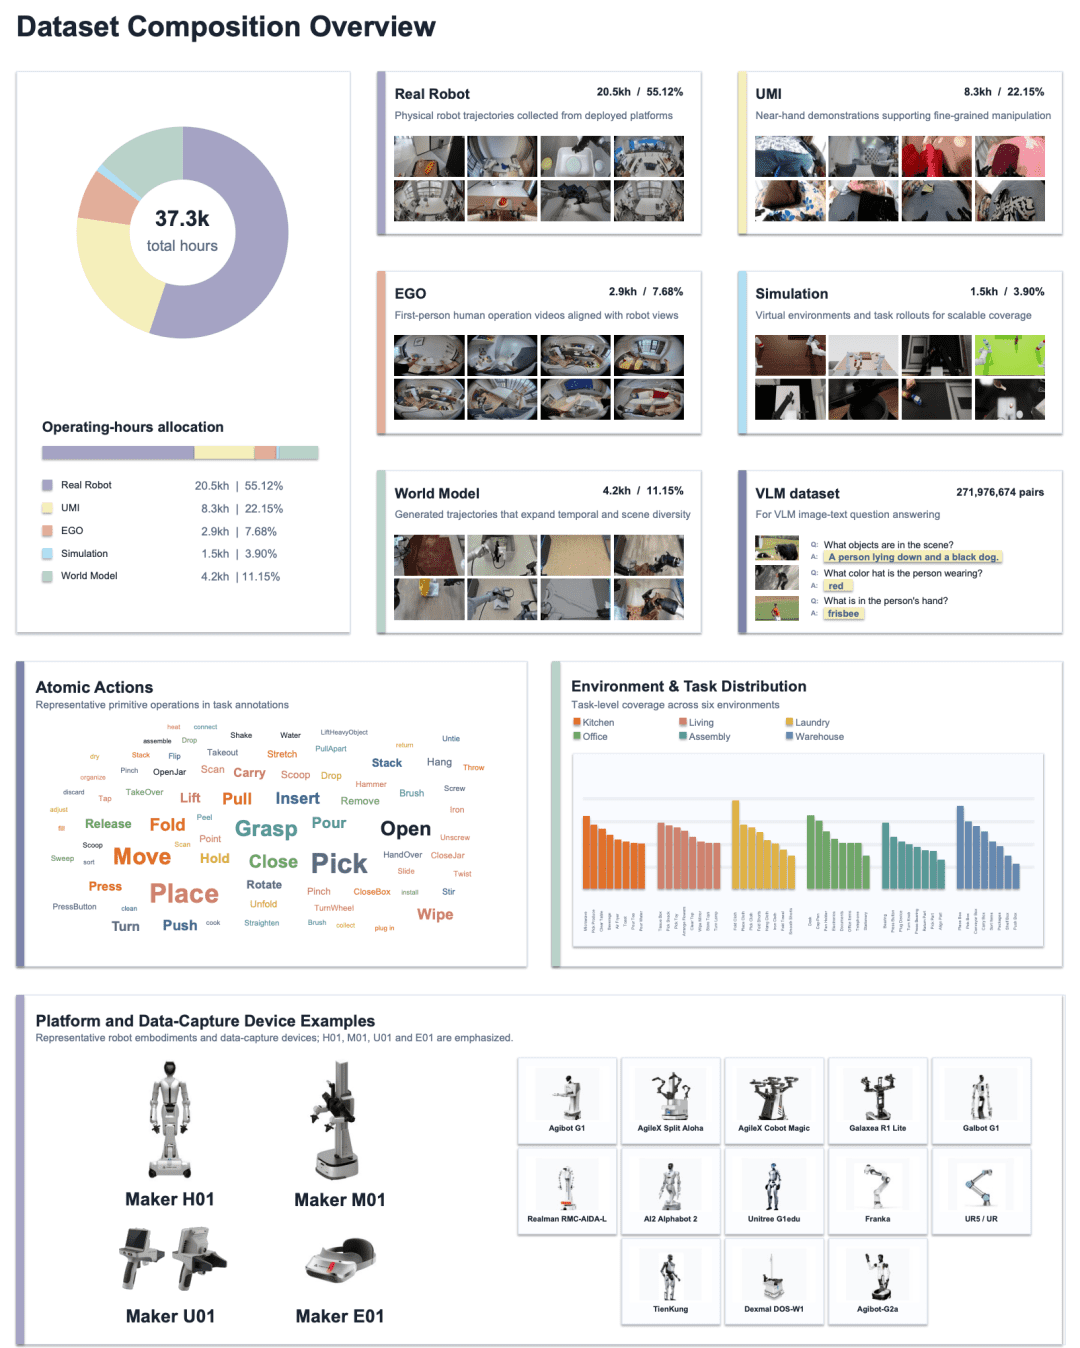
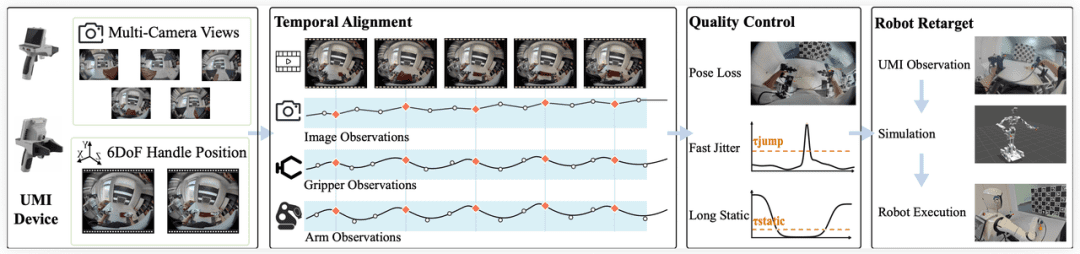
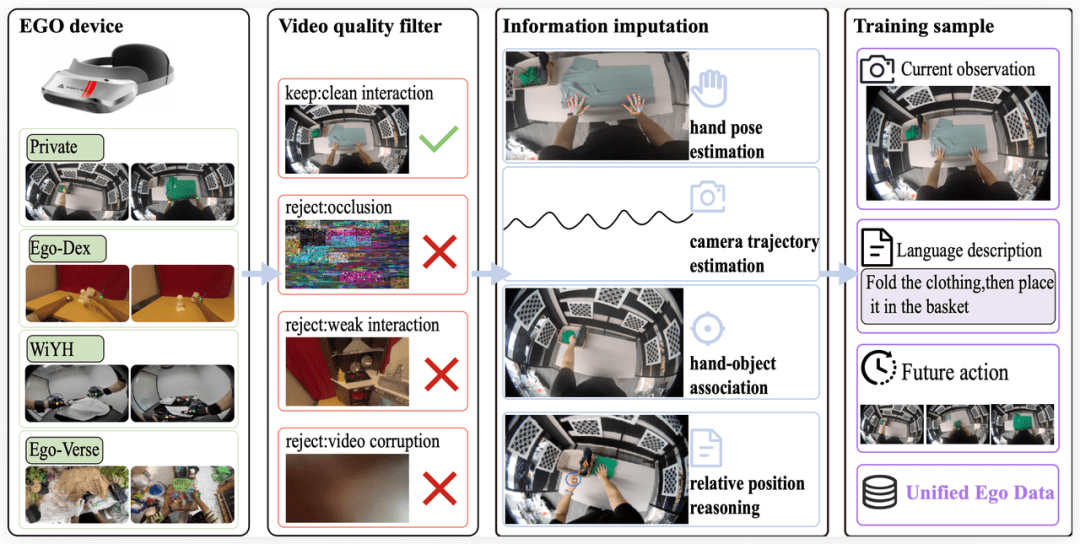
算法创新的背后是庞大的数据工程。极佳视界构建的五层数据金字塔为GigaBrain-0.7提供了坚实基础。底层是近3亿对“图像-语言”数据,用于强化空间理解与交互预测;第二层是11200小时高质量真人示教数据,通过自研UMI(手柄)与EGO(头戴)设备采集,确保与Maker H01传感器完全同构;第三层是超5000小时生成与仿真数据,覆盖大量长尾危险场景;第四层是20500小时真机操作数据,来自自研机器人及部分开源平台;顶层则是闭环反馈的经验数据,用于持续优化策略。
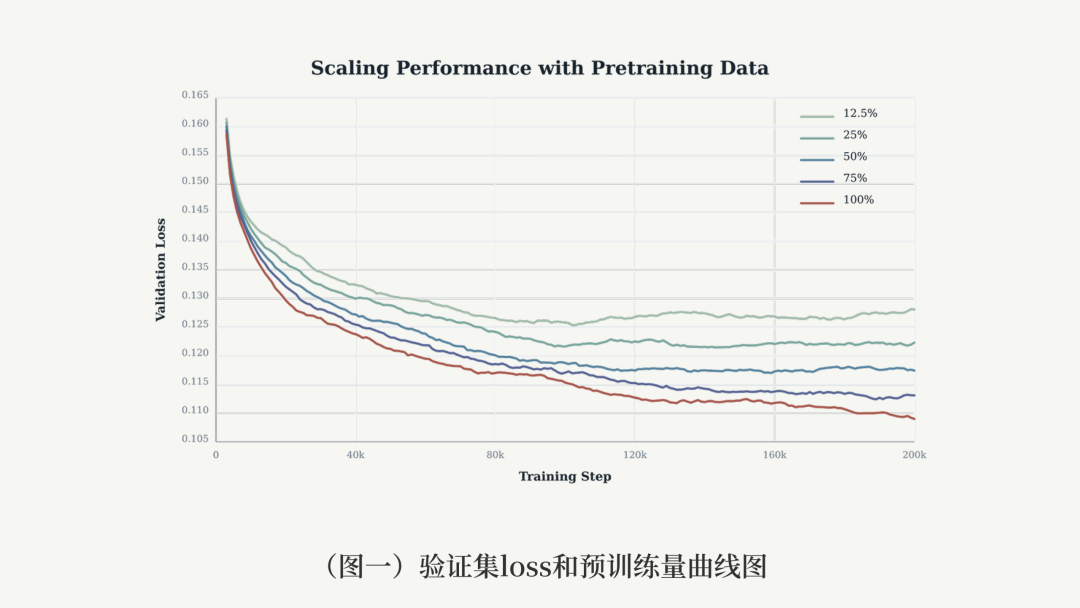
尤为关键的是数据一致性。由于UMI/EGO硬件与真机本体同构,仅需300条示教数据即可让Maker H01在新任务中实现自主操作,数据效率远超行业平均水平。这种“采集-训练-部署”闭环的设计,使得数据规模与模型性能呈现明显的正相关趋势。
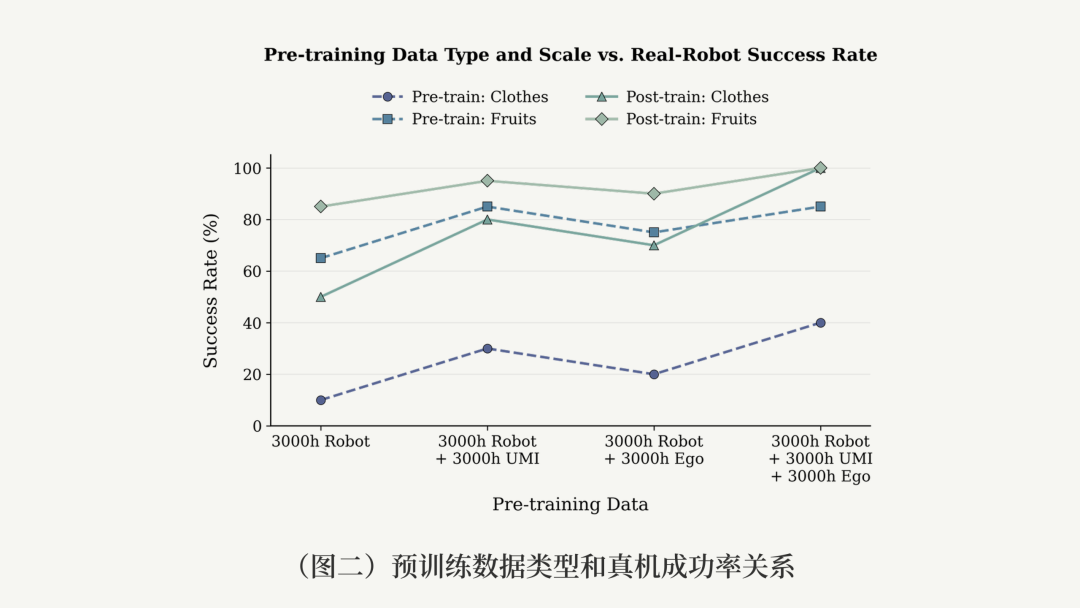
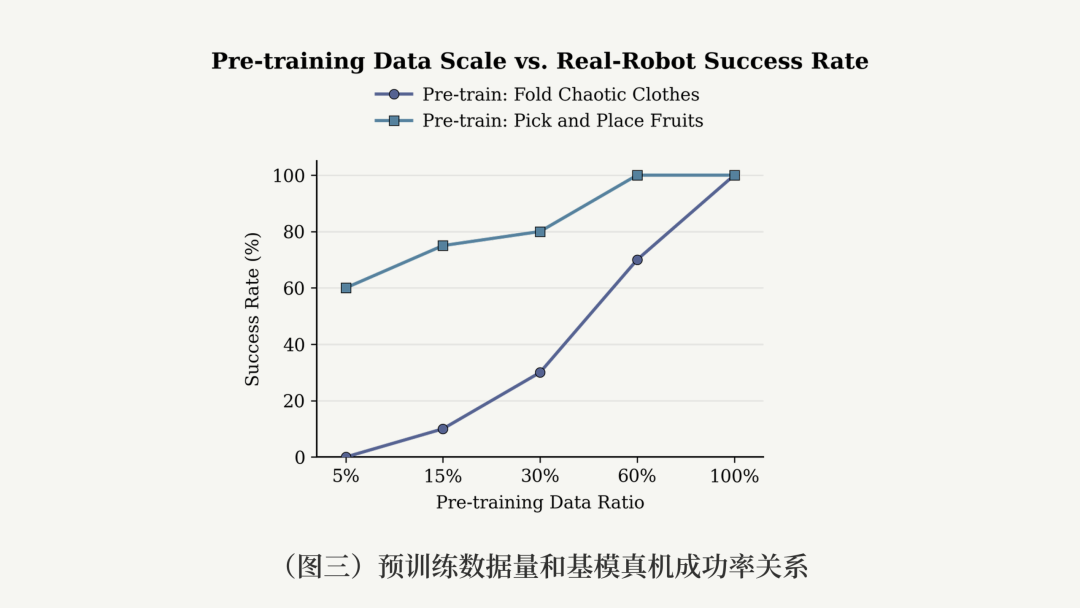
极佳视界通过多组实验验证了具身智能的Scaling Laws。结果显示:随着预训练数据量增加,模型在域外任务上的预测误差持续下降,过拟合现象逐渐消失;引入UMI/EGO数据后,真机成功率显著提升;全量数据预训练的基模无需单任务微调,即可在24项任务中实现高成功率。这些发现有力支持了“具身智能可Scaling”的核心假设。
真机验证:从断档领先到一镜到底
理论优势最终需经真机检验。在RoboColiseum平台上,GigaBrain-0.7在操作精度、任务规划、环境适应、多步推理四个维度均排名第一,证明其仿真表现与真实世界高度一致。而在自研Maker H01人形机器人上的测试更显震撼:面对包含物品分类、精细抓取、工具使用、动态避障等环节的复合任务,模型实现了超20分钟、10余个子任务无缝衔接的一镜到底演示,全程无干预、无重试。
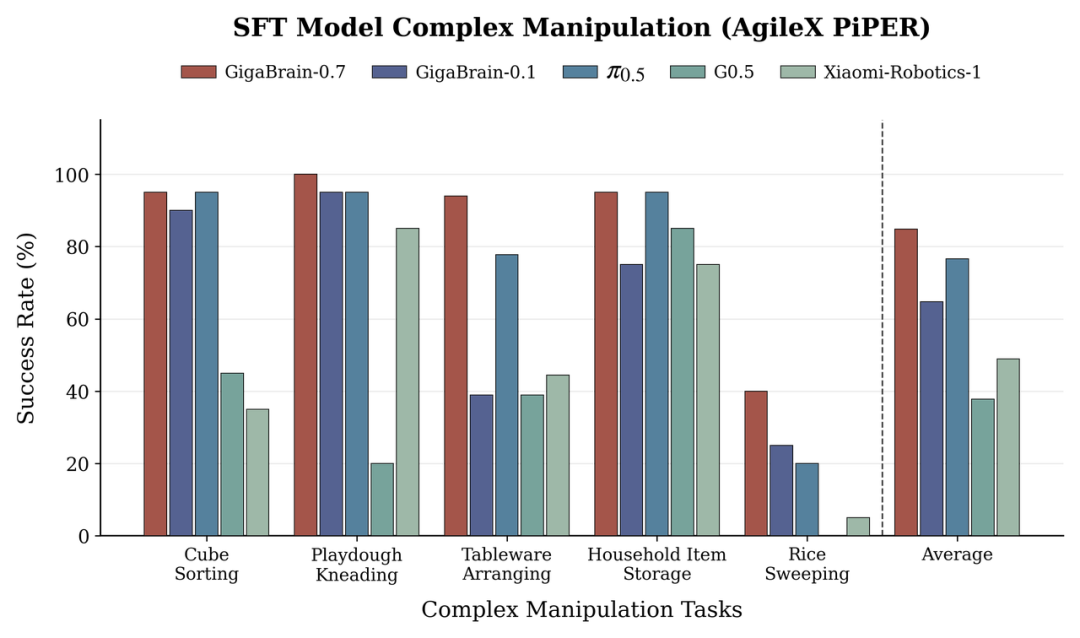
横向对比显示,即使在AgileX PiPER等非原生平台上,GigaBrain-0.7的后训练版本仍全面领先国际主流模型。其语言跟随能力可准确解析“把红色积木放到蓝色盒子左边,但不要碰到绿色杯子”这类复杂指令;复杂操作能力则体现在能稳定完成拧瓶盖、叠毛巾、插USB等精细动作。这种跨平台、跨任务的泛化性,正是具身基模的核心价值所在。
极佳视界已宣布将在近期开源GigaBrain-0.7的模型与代码。这一举措有望推动整个具身智能社区加速发展,正如当年LLaMA之于大语言模型。当世界模型不再只是离线预测工具,而是成为机器人实时决策的“预演引擎”;当数据与算法形成可扩展的正向循环,具身智能或许正站在爆发的临界点上。GigaBrain-0.7所验证的双金字塔范式,或将成为通往物理AGI的关键路径之一。