编码代理记忆革命:MemoraX如何让AI告别重复劳动
在过去的一年中,编码代理技术经历了前所未有的发展。Claude Code、Codex等先进系统已经能够深入理解代码库、精确定位Bug、进行跨文件修改、运行测试,甚至独立完成复杂的开发任务。这些系统表现得越来越像真正的工程师,具备了参与实际项目的能力。然而,当开发者尝试将这些技术应用于长期开发时,一个根本性问题开始显现:尽管编码代理在编写代码方面变得越来越熟练,但在项目认知方面却始终存在断层,仿佛每次都是初次接触同一个项目。
这种现象的具体表现令人深思。当开发者与Codex完成权限系统的改造后,经过几轮协作,编码代理已经掌握了项目采用当前权限架构的原因、哪些历史代码不能轻易修改、此前因兼容性问题被放弃的方案,以及修改数据库时必须确保旧版本平滑升级等关键信息。这些知识并非简单阅读代码就能获得,而是通过实际开发过程积累的宝贵项目经验。
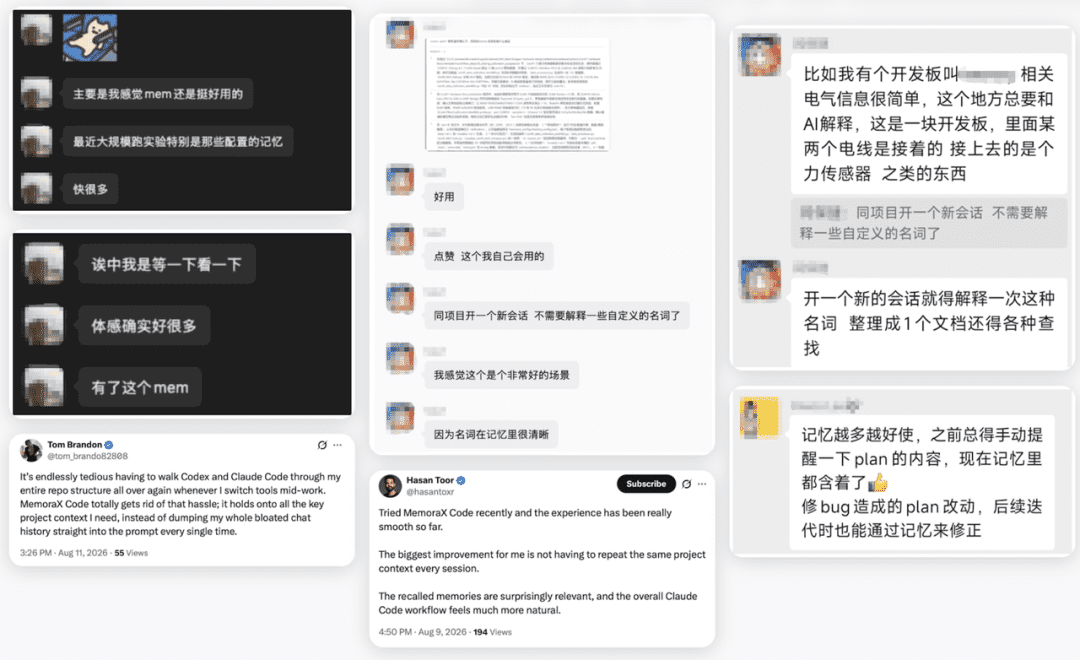
然而,当第二天重新开始时,情况发生了变化。重新开启对话后,编码代理可能会重新扫描相同的代码,昨天已经解释过的背景需要再次说明,之前失败的方案可能被重新提出,刚刚排查完毕的问题也可能重新调查。这种情况在对话时间较长、早期信息被压缩时尤为明显,从Codex切换到Claude Code时同样如此。
因此,我们面临着一个悖论:拥有越来越聪明的编码代理,却不得不反复进行相同的工作——让它们重新认识同一个项目。当编码代理从一次性编程工具转变为长期协作者时,它们需要的不仅仅是更大的上下文窗口,更需要一种持续积累的能力,即知道什么值得保留,也知道何时应该重新回忆。
MemoraX Code正是为解决这一问题而设计的创新解决方案。其核心理念在于让编码代理真正拥有长期记忆,这种变化的体现不仅仅是增加一个简单的"Memory"按钮,而是许多原本需要重复解释的事情开始消失。
当开发者与编码代理完成一个任务并在过程中形成项目经验后,第二天重新开启全新对话时,无需复制昨天的聊天记录,也无需再次解释完整的项目背景。当新任务涉及相关模块时,过去积累的经验会重新进入当前工作流,并继续影响编码代理的判断。这种连续性意味着新对话中项目经验不会归零,开发者可以基于已有的认知基础继续推进工作。
更为重要的是,这种记忆能力不局限于特定的编码代理。开发者可以在Codex中完成一个任务,然后切换到Claude Code处理另一个问题,此前形成的项目认知仍然可以继续发挥作用。即使始终使用同一个编码代理,长时间任务中的对话也会不可避免地被整理和压缩,这是compaction在真实系统中的常态。
被压缩的内容中往往混合着两类信息:一类是无关紧要的细节,如中间的无效尝试、调试输出或重复解释;另一类则是关键经验,例如"修改该模块必须兼容旧版本数据库"这样的约束条件,可能只出现过一次,却在后续重构中起决定性作用。传统的compaction解决的是"如何不丢上下文"的问题,但并不能保证"哪些经验应该被保留"。
MemoraX Code试图弥补这一不足:让被压缩进历史中的关键信息在后续任务中仍能被识别、提取,并在合适时机重新进入上下文。长期记忆的目标并非永久保存每一句对话,而是从持续发生的开发过程中,筛选出那些未来仍然值得被想起的重要信息。
真正的问题在于,编码代理本身已经能够保存历史对话,也能处理越来越多的信息,为什么还需要独立的记忆系统?答案在于,真正的挑战不是保存更多历史,而是判断什么值得记住、什么已经过时,以及何时应该重新回想。
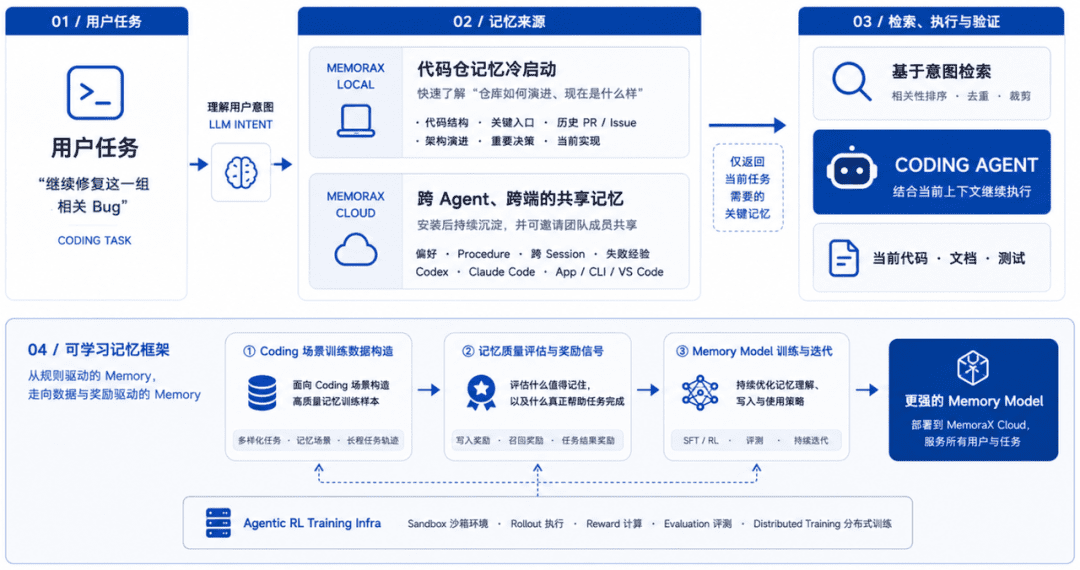
MemoraX Code为此构建了本地代码仓库记忆与云端长期记忆的双重架构。本地代码仓库记忆帮助编码代理快速理解当前代码结构、关键入口和历史演进;云端长期记忆则持续承载跨任务、跨对话、跨编码代理的项目经验和开发者习惯。当新任务到来时,系统不会将全部历史信息塞给模型,而是只检索当前真正相关的信息。
这一系统的设计目标是让记忆从规则驱动走向数据与奖励驱动。传统记忆系统高度依赖人工规则,工程师通过提示词和预设策略规定什么应该写入、如何整理、何时召回。MemoraX Code希望将这些判断转化为可通过训练持续提升的能力。
围绕编码场景,系统构造了专门的记忆训练任务和长程开发轨迹,并建立了针对记忆的评估与奖励机制。系统不仅判断信息是否被记录下来,还会进一步学习它是否在后续任务中帮助编码代理做出更好的决策。基于这些训练信号,记忆模型可以持续学习什么值得写入、什么应该更新、哪些经验应该被提炼,以及在什么任务中应该重新出现。
支撑这一过程的是一套完整的训练和测试基础设施,包括运行环境、任务执行、反馈评分、效果评估和分布式训练等能力。在架构设计上,这套训练体系与用户的私有记忆数据相隔离。可学习的记忆能力通过专门构造的训练与评测体系不断演进,再以更强的模型能力服务于线上系统。
MemoraX Code在近期备受关注的AML(Agent Memory Leaderboard)编码赛道上取得了62分的成绩,位列第一,相比业界主流方案Claude Mem解题率提升10%。这一成绩验证了其在编码记忆方面的技术优势。
除了基准测试外,MemoraX Code还支持程序记忆的自动化构建功能。系统能够从历史编码轨迹中自动识别具有复用价值的解决过程,将一次任务中零散的分析、执行和验证步骤进一步提炼成结构化的工程经验,并最终以技能的形式沉淀下来,供后续类似任务直接使用。
在一项实验中,MemoraX Code从123个历史任务片段中自动提炼出15条工程经验,进一步归纳为4类程序记忆。这里留存的不再是"上一次发生了什么",而是进一步提炼出"面对这一类工程问题,过去哪些分析方式、执行步骤和验证方法被证明是有效的"。
这种转变标志着记忆从"记录历史"走向"从历史中学习"。真正的验证发生在将这些自动提炼出的程序记忆应用到新的复杂开发任务中。在一项持续约3小时的复杂开发任务中,编码代理仍然需要自己理解需求和代码、修改实现、运行测试,并处理过程中不断出现的新问题。唯一的区别是可以使用过去开发中已经沉淀下来的工程经验。
实验结果显示,综合得分从11.71提升至70.30,关键检查项通过数从2/13提升至10/13。这意味着程序记忆带来的不仅是"更快想起一些历史信息",过去已经验证过的工程经验开始真正参与新的问题求解。
值得注意的是,这种提升并非通过增加模型调用来实现。按照实验所使用模型的API单价计算,没有程序记忆时,总调用成本约为31.48美元;使用后下降至24.37美元,降低约22.6%。这是因为没有历史经验时,编码代理需要重新理解问题、尝试方案、发现问题,再不断调整路径。许多模型调用实际上消耗在了重新摸索过去已经探索过的事情上。
程序记忆给编码代理的不是现成答案,而是过去开发过程中已经验证过的问题解决方法和路径。编码代理仍然需要完成当前任务的理解、推理和执行,但不必每次都从零开始探索。
内存不仅仅是记录历史,它开始将历史转化为未来可以复用的经验。当然,记忆并非召回得越多越好。一次前端样式修改不应突然出现几周前的数据库迁移经验,已经失效的项目决策也不应继续干扰当前任务。在内部测试中,MemoraX Code 85.5%的记忆触发行为与用户判断一致,81.2%的记忆内容获得了正向反馈。
目前,MemoraX Code已经完成对Codex、Claude Code、Deepseek Harness、OpenCode四个主流编码代理的支持,其他平台也在继续适配中。安装后,开发者还可以在平台中查看和管理自己的记忆,包括修改和删除操作。
今天的编码代理竞争,大量注意力仍然集中在单次任务的表现上:谁写代码更快,谁修复Bug更强,谁能完成更复杂的软件工程任务。但真实项目并非一次性的。同一个代码仓库会被反复打开,同一类问题会再次出现,开发者也可能在不同编码代理之间不断切换。
当编码代理真正进入长期开发后,拉开差距的或许不再只是第一次能走多远,还有第十次是否仍然需要从零开始。模型能力决定一次能走多远,记忆决定下一次从哪里开始。MemoraX Code正在解决这一根本性问题,为编码代理技术的发展开辟了新的方向。