VideoCoCo技术突破:代码驱动的物理一致性视频生成新范式
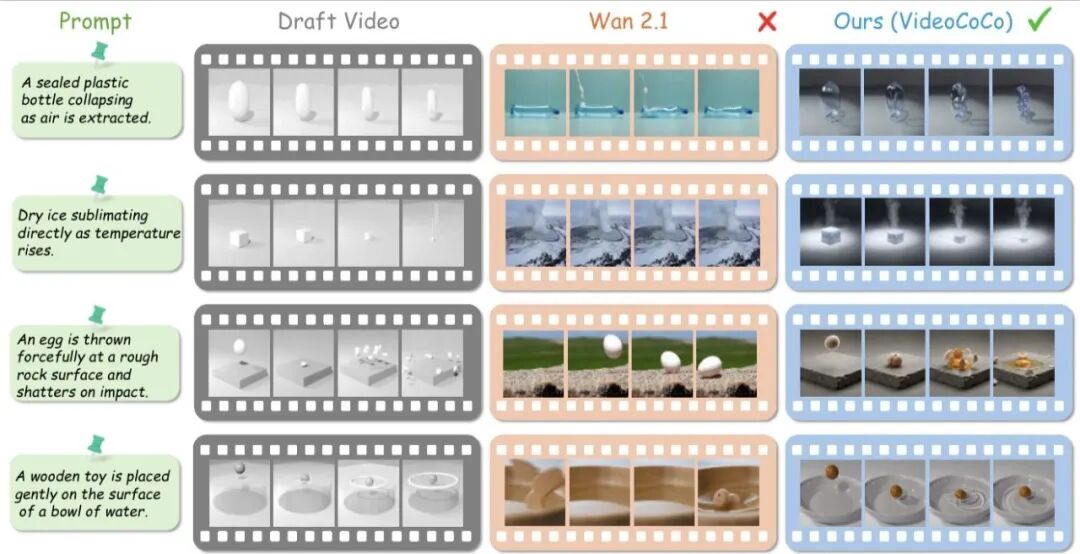
近年来,文生视频技术取得了显著进展,但在物理一致性方面仍面临重大挑战。当黄油落进热锅后迟迟不化,密封塑料瓶被抽走空气却纹丝不动,干冰在室温中始终保持原样时,这些看似精致的画面实际上暴露了当前视频生成模型的根本缺陷。香港中文大学与中国科学技术大学的研究团队针对这一问题提出了VideoCoCo技术,为物理一致性视频生成开辟了全新路径。
传统范式的核心局限
现有文生视频模型通常从高度压缩的提示词直接生成画面,这种模式存在根本性缺陷。提示词虽然告诉模型"发生了什么",却很少交代变化的速度、先后次序、物体之间的作用关系,以及过程结束时应当呈现的状态。模型不得不一边补全这些隐含信息,一边合成视频,这就造成了所谓的"因果不透明性"问题。
人的意图被压缩在短短一句话里,但视频需要展开为完整、连续的时空过程。这种信息密度的巨大差异导致模型在生成过程中容易出现物理不一致的现象。传统的端到端生成方式无法有效处理复杂的物理推理,使得生成的视频虽然在视觉上可能令人印象深刻,但在物理规律上却经不起推敲。
VideoCoCo的技术创新
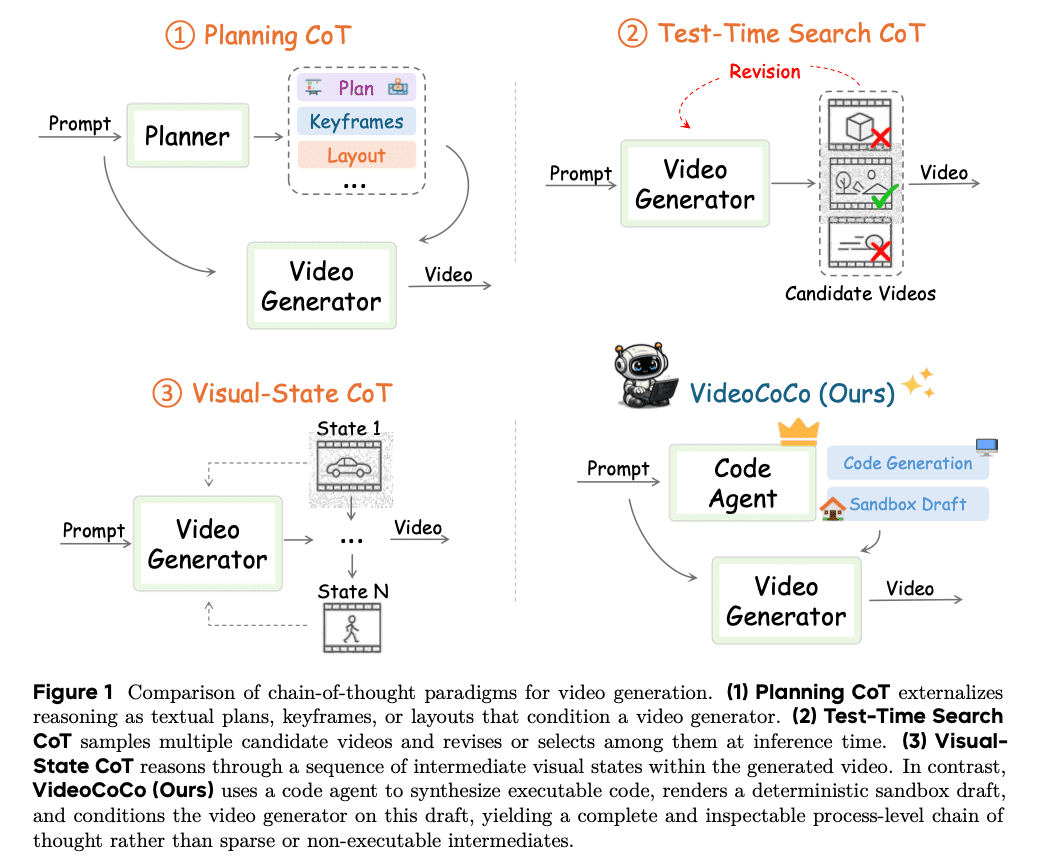
VideoCoCo的核心创新在于引入了代码作为思维链(Code-as-CoT)的概念。与其让生成模型在像素空间里凭经验猜测,不如先用一段真正能够运行的代码,把提示词中省略的物理过程写出来,再据此生成视频。代码在这里不是附加工具,而是一条可执行、可检查的"过程级思维链"。
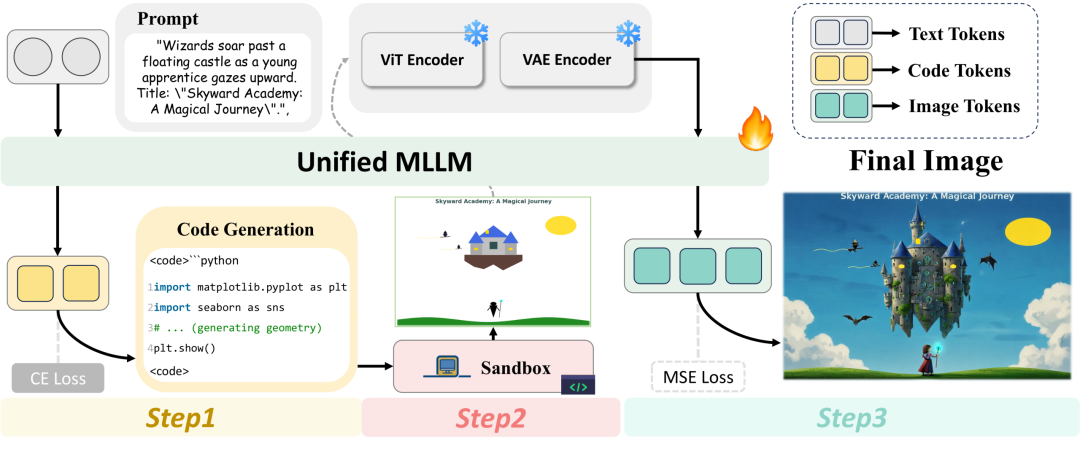
这种设计思路源于团队此前的工作CoCo,该工作在文本到图像生成中证明了代码思维链的有效性。VideoCoCo将这一理念扩展到了视频领域,考虑到视频比图像多出时间维度,代码不仅要描述物体"在哪里",还要描述它"接下来怎么动"。这包括受热后何时开始融化,形状如何摊开,容器在内外压差变化后怎样变形等动态过程。
双引擎协作架构
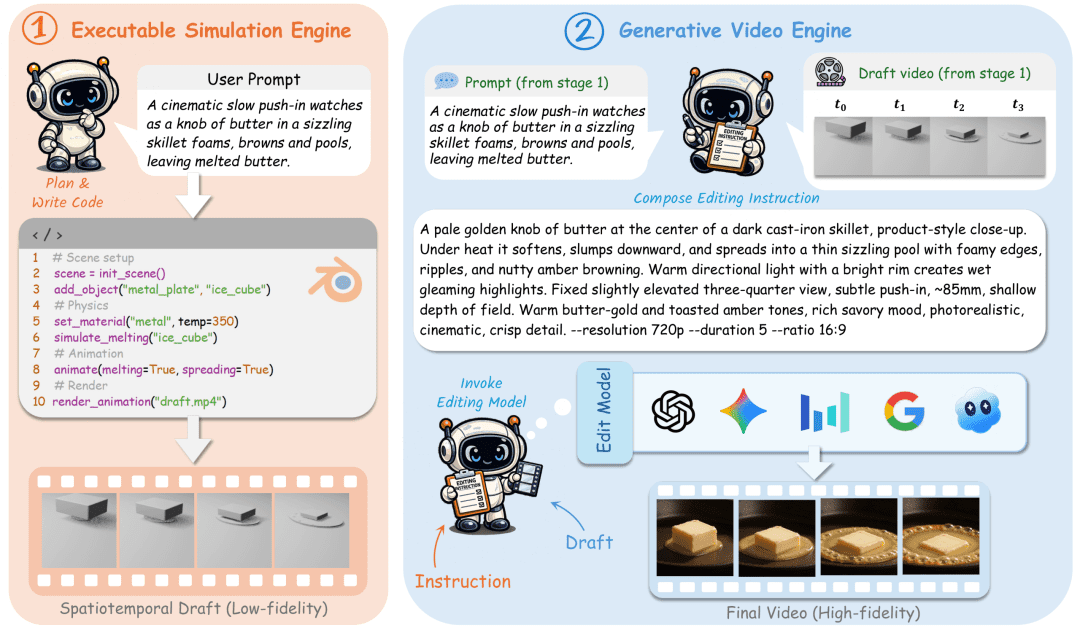
VideoCoCo采用双引擎框架,将过程推理与视觉呈现拆成两个相对独立的环节。Coding agent负责确定事件如何发生,Visual agent则负责把这个过程变成具有真实质感的画面。这种分工避免了让一个模型同时承担物理推演和视觉合成的压力。
以"黄油在滋滋作响的热锅里融化、变褐并逐渐摊开"为例,Coding agent会先生成一段自包含的Blender程序,把锅、黄油、受热、融化和铺展等信息组织成明确的时空变化。程序随后在沙箱中运行,得到一段确定性的白模视频。这个草稿未必好看,却已经把镜头、构图、运动方向和事件节奏固定下来。
白模解决了"怎么动"的问题,接下来才轮到"长什么样"。Coding agent根据原始提示和白模内容整理编辑指令,Visual agent再同时参考白模与指令,将粗糙的仿真画面重绘为更接近真实摄影的视频。最终画面的纹理、光照和细节来自生成模型,而时序结构仍由可执行草稿约束。这种设计确保了代码负责搭骨架,视频模型负责补血肉。
实验验证与性能表现
在干冰升华、密封塑料瓶抽真空塌陷等强物理场景中,基线模型OmniWeaving往往能够生成外观合理的物体,却没有真正完成提示词所要求的变化。加入VideoCoCo后,视频会沿着白模中已经确定的动力学过程演化,真实感与物理一致性不再只能二选一。
量化结果显示了显著改进。在PhyGenBench上,以GPT-4o作为评判模型时,VideoCoCo将OmniWeaving的平均分从0.475提升至0.558,超过开源基线Wan2.2-TI2V-5B的0.544。其中mechanics、optics和material三个类别排名第一,thermal位列第二。在VBench-2.0上,平均分则由52.18%提升至77.88%,增加25.70个百分点,mechanics达到92.31%,thermotics达到72.92%。
消融实验进一步验证了技术的有效性。即使不对编辑器进行微调,只把可执行草稿作为生成条件,平均分也能从0.475提升到0.506。这说明物理一致性的主要增益已经来自草稿本身,而不是额外训练带来的"刷分"效果。
中间表示的创新意义
过去,生成模型常用文本计划、布局、关键帧或搜索轨迹作为中间表示。这些方式各有用处,但文本仍然偏抽象,关键帧又只能覆盖少数时刻,很难完整表达连续变化。可执行代码提供了另一种可能:它不仅描述过程,还能把过程真正跑出来,因此天然具备更高的密度,也更容易审计和修正。
代码作为中间语言的优势在于其精确性和可执行性。相比于模糊的文本描述,代码能够明确表达物理过程的每一个步骤,包括时间序列、空间关系、力的作用等。这种精确性使得生成的视频更加符合物理规律,同时也便于调试和优化。
神经符号融合的新形态
VideoCoCo展示的"推理者—渲染者"协作模式,为神经符号融合提供了更具体的实现形态。编码智能体擅长拆解任务、组织逻辑和调用工具,生成模型则擅长处理纹理、光照与复杂视觉细节。前者保证过程可解释,后者保证画面足够丰富。
这种结合方式使得视频生成不再只是从一句话直接跃迁到像素,而是在中间多出一个可以观察、干预和复用的过程层。用户可以通过修改代码来调整物理过程,而不必重新训练整个生成模型。这种模块化的设计提高了系统的灵活性和可控性。
技术局限与发展方向
尽管VideoCoCo展现了巨大潜力,但这条路线也有现实边界。Blender程序能够表达的物理过程范围有限,Coding agent写出稳定脚本的能力还需要进一步提升,白模与最终画面之间的对齐质量也会影响结果。
当前的物理仿真引擎在处理复杂材料属性、流体动力学、电磁现象等方面仍有局限。此外,代码生成的准确性和稳定性直接影响最终视频质量,这要求Coding agent具备强大的推理和编程能力。
应用前景与影响
相比在黑箱里反复抽卡,一个可执行的中间层至少让错误有迹可循,也让人工修改和自动纠偏有了明确抓手。对于强调因果、可控和可验证的视频任务,这种基于代码思维链的方法比单纯增加模型规模更值得关注。
在影视制作、科学可视化、教育演示等领域,物理一致的视频生成具有重要价值。VideoCoCo为这些应用提供了更可靠的技术基础,有助于提高生成内容的专业性和可信度。
技术发展趋势
VideoCoCo代表了视频生成技术向更结构化、可解释方向发展的重要趋势。随着物理仿真技术的进步和大语言模型能力的提升,基于代码思维链的生成方法有望在更多领域得到应用。
未来的发展可能包括更丰富的物理过程建模、更智能的代码生成算法、以及更高效的神经符号融合机制。这些进步将进一步推动视频生成技术向实用化方向发展。
行业影响与启示
VideoCoCo的成功表明,将符号推理与神经网络相结合是解决复杂生成任务的有效途径。这种方法不仅提高了生成质量,还增强了系统的可解释性和可控性。
对于整个AI生成领域而言,VideoCoCo提供了一个重要的技术范例,展示了如何通过引入结构化的中间表示来解决生成任务中的复杂推理问题。这种思路有望在其他模态的生成任务中得到借鉴和应用。
总的来说,VideoCoCo技术为视频生成领域带来了重要突破,通过代码驱动的物理一致性生成方法,有效解决了传统方法在物理规律遵守方面的不足。这种创新不仅提升了视频质量,也为AI生成技术的未来发展指明了新的方向。