AI影像进化论:从生成到精准编辑的五大技术突破
过去两年,AI生成图片、视频的能力不断刷新人们的认知。今天,生成一张图片、一段视频,已经变得很容易。但真正困难的,是另一件事情:让AI理解并按照创作者的真实意图完成创作。比如,修改一行文字同时保留字体排版,消除冗余元素不留破绽,自由变换发型服饰保持人物一致,调整视频局部内容不影响整体连续性,让模特试穿试戴准确保留材质纹理。这些需求背后,是对AI视觉理解、空间建模、时序一致性、美学表达等多维度能力的综合考验。
作为AI影像领域的长期玩家,美图影像研究院(MT Lab)围绕高频创作场景的真实痛点,持续展开研究。2026年以来,共有11篇论文被ICLR、CVPR、ICML、ECCV、ACM MM等国际顶会接收,覆盖视频编辑、人像编辑、智能交互、视觉理解等方向。更重要的是,这些研究成果不断通过产品落地,转化为服务真实创作场景的AI影像能力。
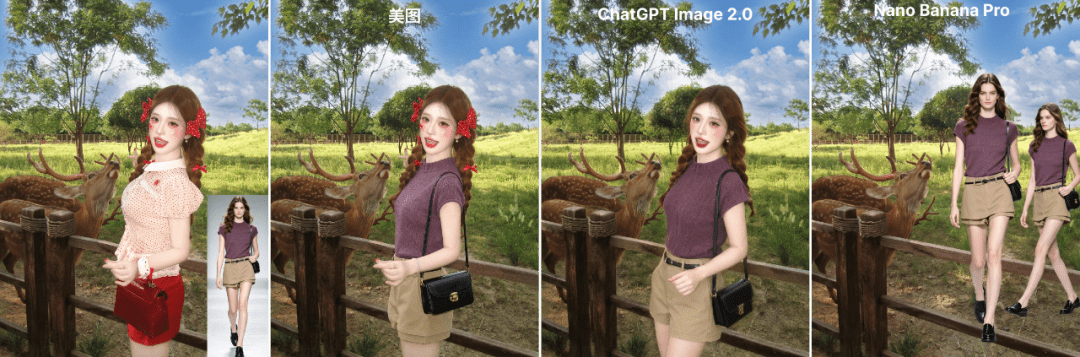
视频编辑:从“能生成”到“能创作”
在专业创作中,生成只是起点,人们往往需要多次调整才能接近理想效果。因此,无论是视频中的背景、光线、人物身材、妆造,还是图片中的文字、服饰配饰,模型都需要同时兼顾一致性、真实性与可控性。
参考帧引导的视频编辑框架MiVE
在ICML 2026上,美图影像研究院提出了参考帧引导视频编辑统一框架MiVE,核心由多层级视觉-语言上下文提取、参考帧感知潜空间编码和统一自注意力主干三大部分组成。MiVE旨在以多尺度VLM条件与统一多模态融合,解决当前视频编辑在指令理解与空间精度上的结构性短板。
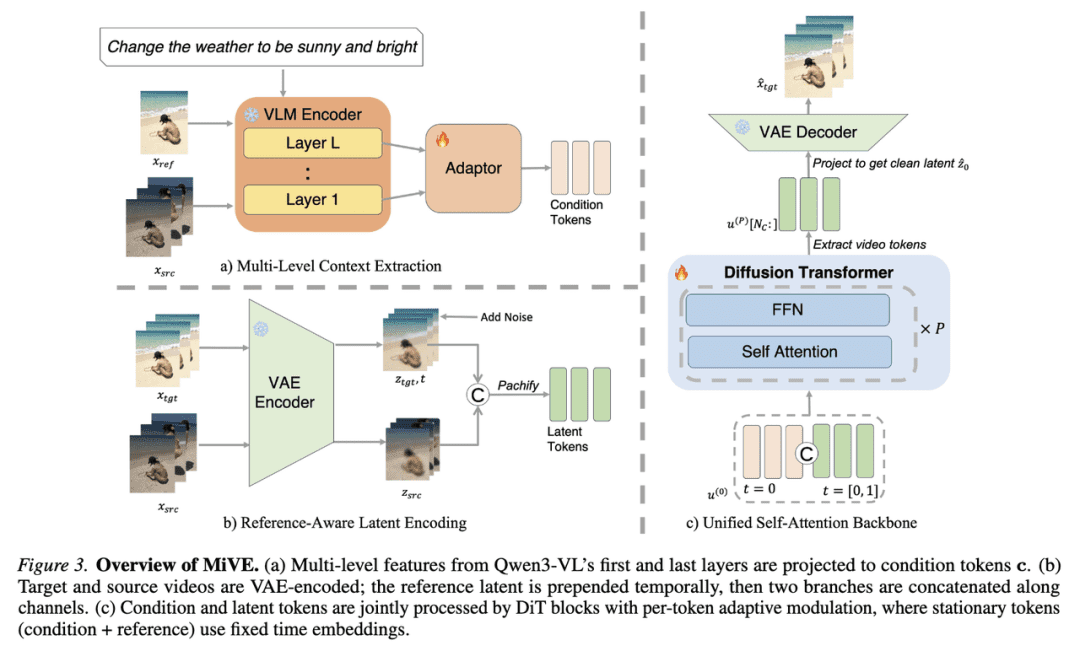
MiVE在大幅度运动、复杂遮挡、跨帧风格一致性等高难度场景下,能够保持原视频运动结构,并将参考帧的编辑信息自然扩展至整个视频;在身份特征、细节锐度、色彩一致性保持及新增遮挡区域外观恢复上,MiVE也表现出更强的稳定性与更高的精细度。
结合MiVE“改一帧即改全片”的V2V编辑工作流,目前已经实现包括改变发型、变换服装、妆容造型、重新打光、更换背景、天气变换、局部优化等在内的视频编辑能力。在细腻发丝的处理、服饰的贴合度、材质光影层面都拥有良好表现力,能够精准还原人物、发丝、衣服材质、光线等细节。
例如在视频打光场景中,相比主流模型,MiVE在人物与环境一致性维度均有较为明显的优势,据悉该能力即将上线美图秀秀APP与Wink APP的“氛围光”功能。
一致特征传输的重打光方案CFT
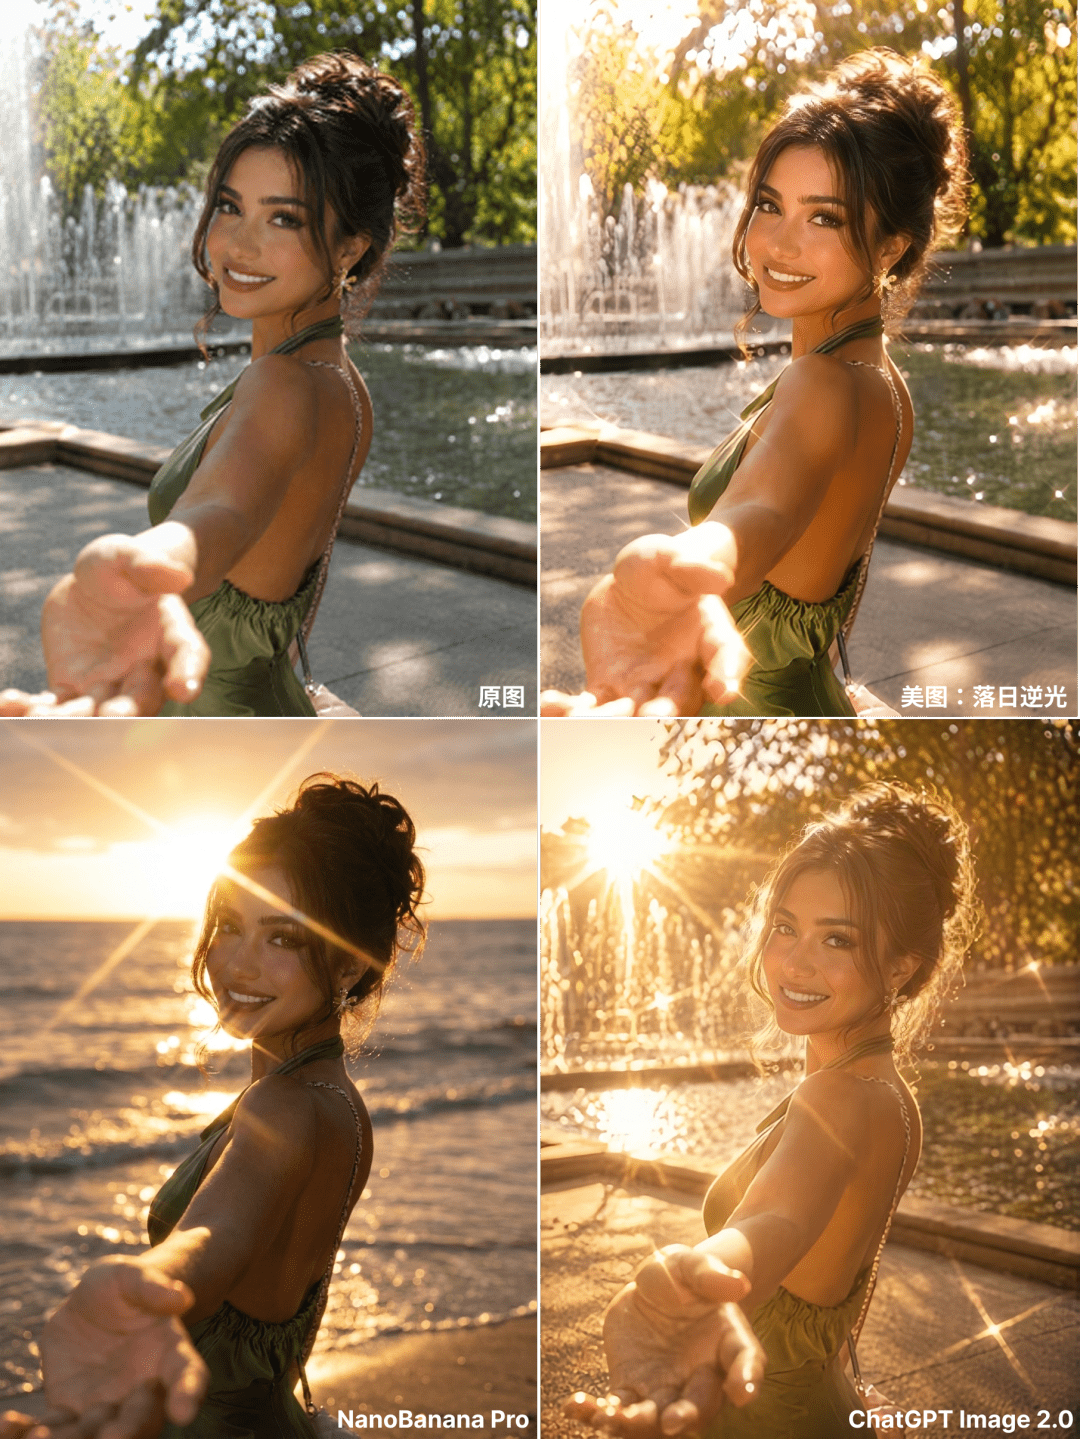
对光影变化的控制能力同样延伸到了静态图片创作场景。在ECCV 2026中,美图影像研究院提出了一致特征传输重打光新方案CFT。由于目前的AI重打光方案容易出现光照不稳定、阴影方向错乱,甚至把脸“修成另一个人”的问题,因此换光效作为常见的视频编辑需求,实现难度却很高。
CFT通过将人像重打光表述为“光照一致的特征传输问题”,在Rectified Flow框架上显式学习源图与目标图分布之间的光照变换,并结合大规模人像重打光数据集,实现在复杂光照场景下,人物身份、姿态、背景的超强一致性。
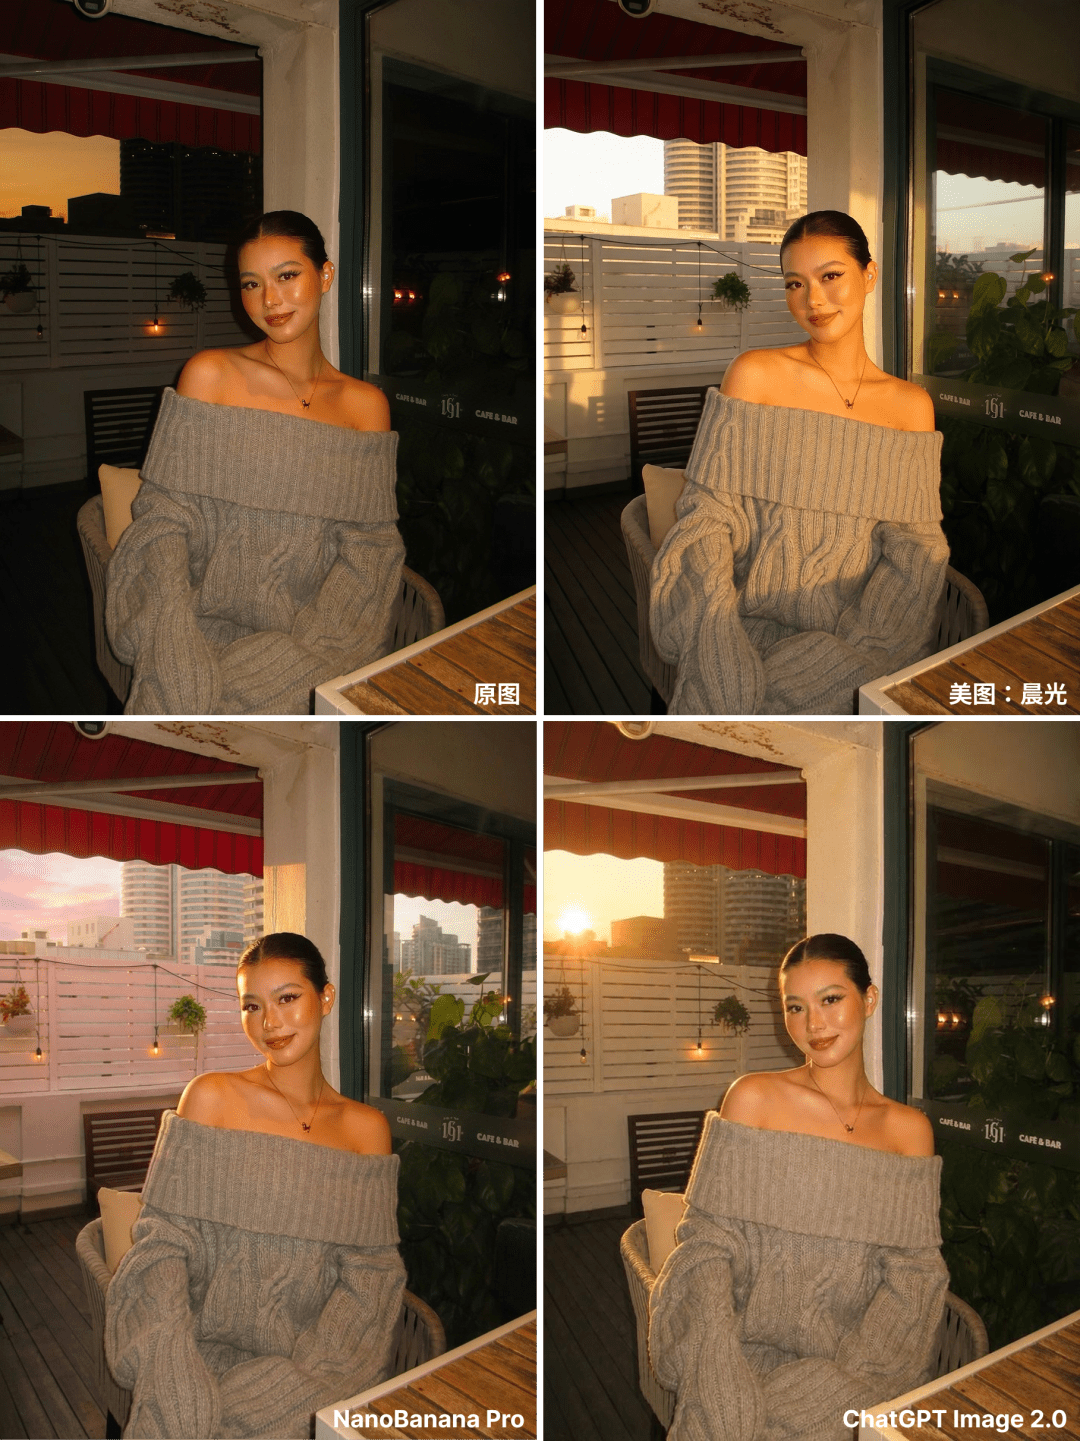
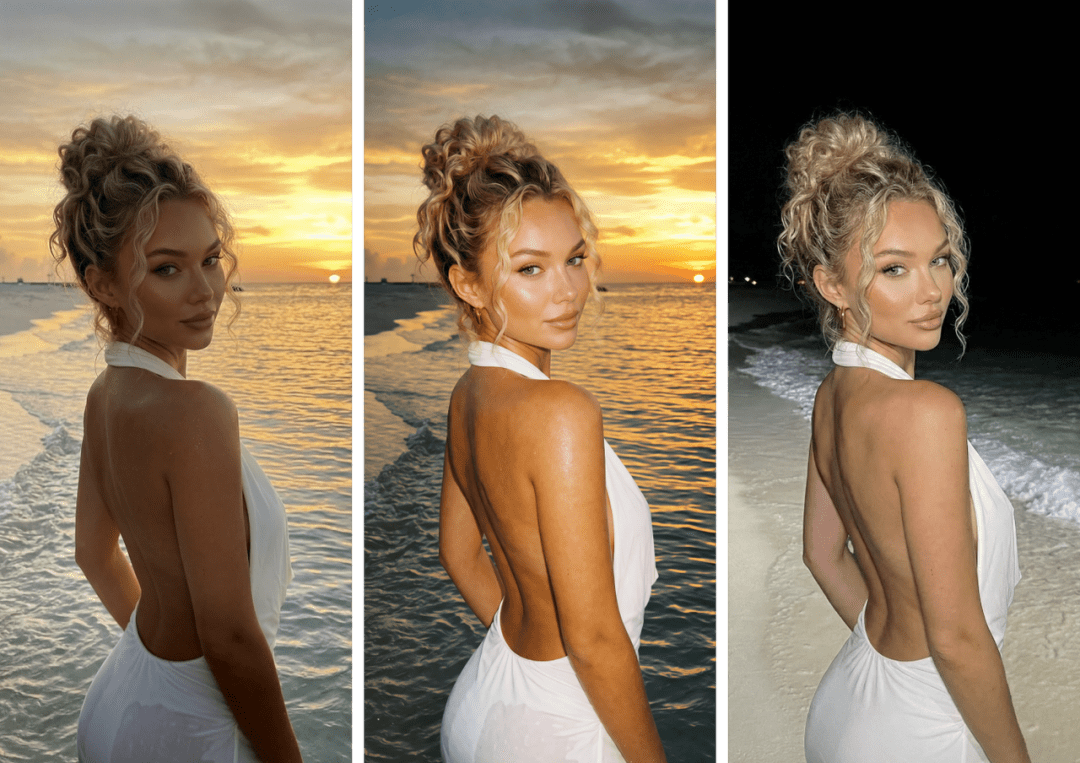
CFT对光线的方向、角度、强弱具备更强的可控性,可以实现各种不同类型的打光效果。对比主流模型,CFT在光照效果上有更佳的稳定性和合理性,即使是在复杂的场景下,也表现出高一致性的打光效果。例如在晨光场景中,CFT能准确区别晨光与夕阳光,呈现更好的整体氛围感和光线真实性。
结合CFT方案,你不需要输入冗长的提示词,就可以玩转各种不同的光线效果。全新的“图片打光”功能已经上线美图主打人像修图Agent与“学我修图”的全新AI产品Picchi,海外可以通过AirBrush与BeautyPlus进行使用。自去年推出“AI闪光灯”全球爆火后,美图影像研究院目前已经研发超过50种不同的打光效果,帮助“手残党”拯救废片。
图像编辑:消除与替换的精细化
图像编辑除了修改、增加内容,还有另一项至关重要的能力——消除。无论是日常拍摄还是专业创作,乱入的路人、被遮挡的背景、五花八门的杂物都很常见,“AI消除”的关键是既要精准消除目标,又要合理补全原本被遮挡的区域,在动态的视频场景中,还必须保证连续帧之间的稳定性。
基于随机桥模型的视频目标移除框架BridgeRemoval
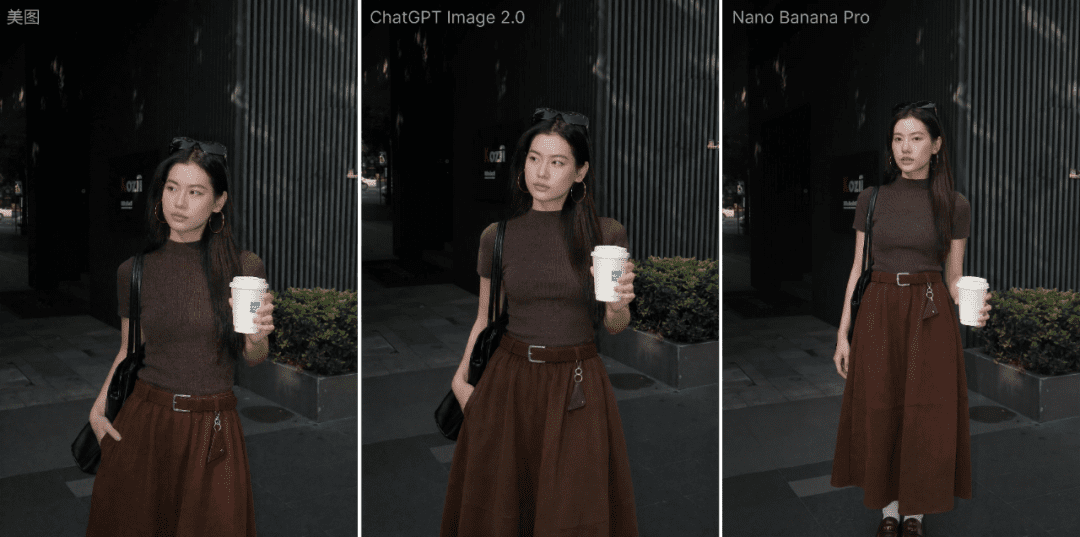
对此,美图影像研究院在ICML 2026上提出了基于随机桥模型的新框架BridgeRemoval,首次将“视频目标移除”定义为“视频到视频的翻译任务”,通过构建基于随机桥(VP-SDE Bridge)的直接生成路径,在背景保真度与生成灵活性之间取得更好的平衡,显著提升了视频目标移除的精准度及时序一致性,实现了从AI图像消除向AI视频消除的拓展。
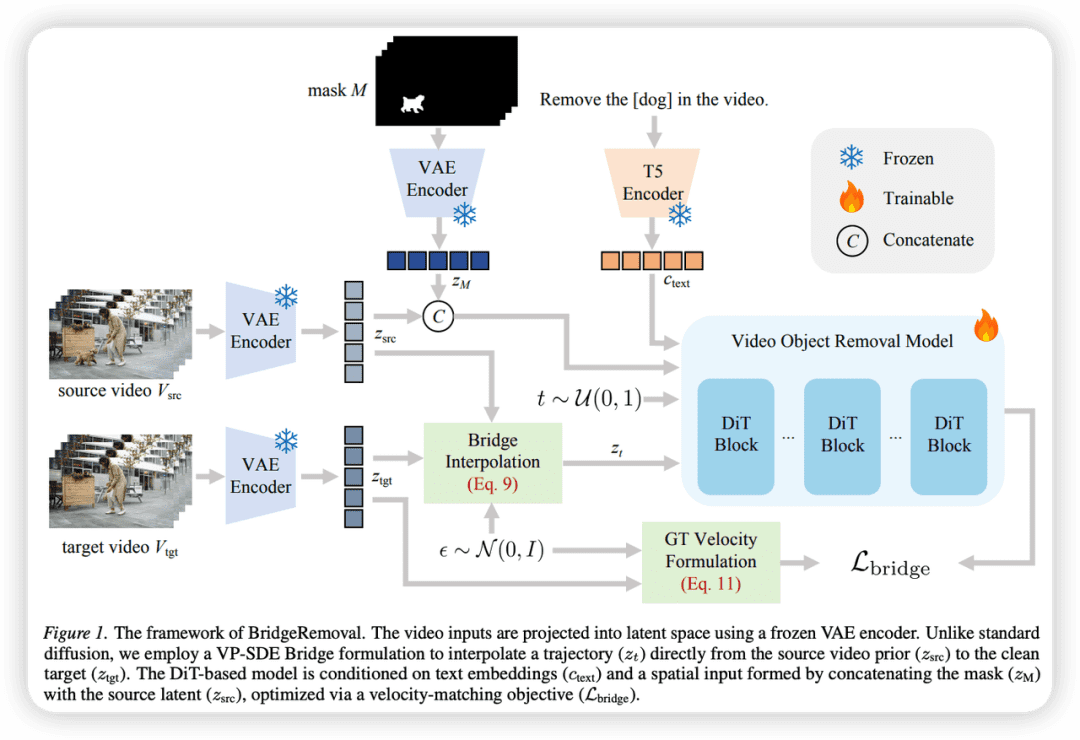
不同于标准扩散模型从随机高斯噪声起步,BridgeRemoval采用基于方差保持随机微分方程(VP-SDE)的桥模型,能够选择性地只对被遮罩区域进行变换,并实现对背景内容中未被遮挡区域最大程度的保真。
结合BridgeRemoval在目标移除、背景保真度、时序一致性的显著优势,Wink APP推出了“视频身材美型保护”功能,解决了平常瘦脸、瘦身等视频美型任务中,容易出现的栏杆变弯、背景形变等尴尬问题。基于BridgeRemoval的优势,也为视频消除能力带来了显著提升,相比主流模型的整体性能,缩短了约80%的处理时长,且区别于10秒的视频处理限制,BridgeRemoval可以支持无限时长的视频消除。
尤其在文字场景,BridgeRemoval对各类型文字均表现出极佳的消除效果,即使是特殊的发光字幕也能实现无痕消除。目前该能力即将上线开拍APP“智能全消”功能,能够自动识别与消除视频文字,支持最长5分钟视频输入,实现画面无损效果,相较主流模型最长30秒视频输入及Token消耗模式,使用成本更低。
基于Self-Prompting的图像文本编辑方法
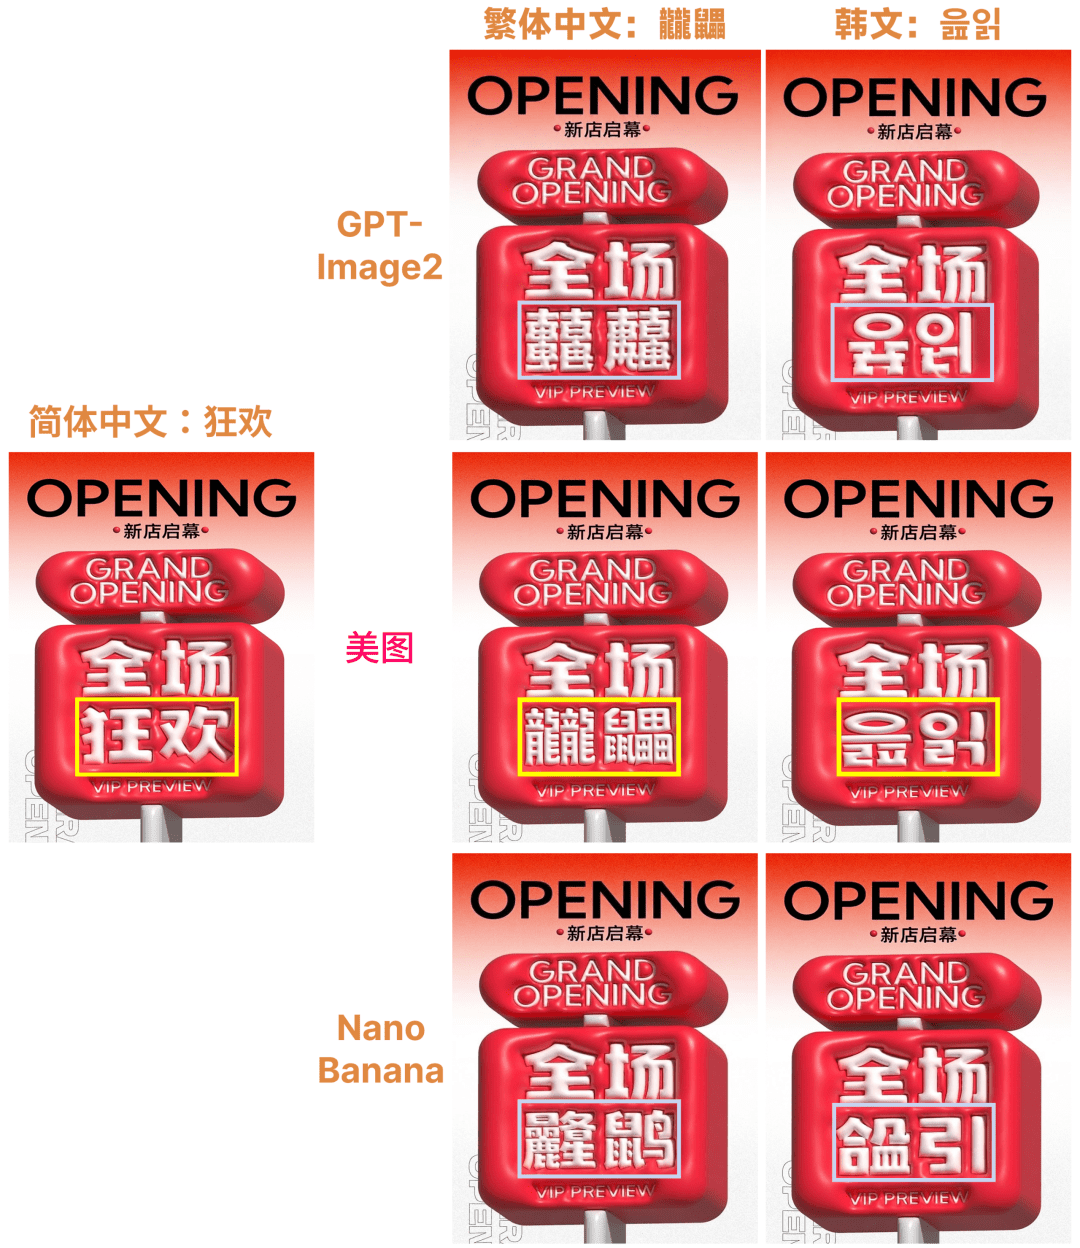
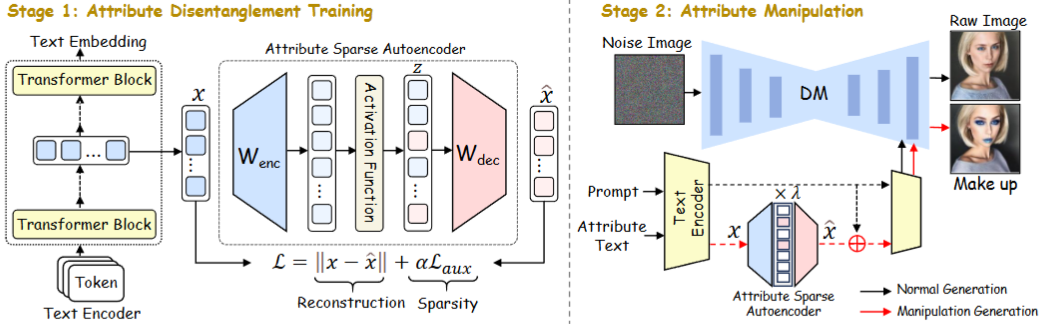
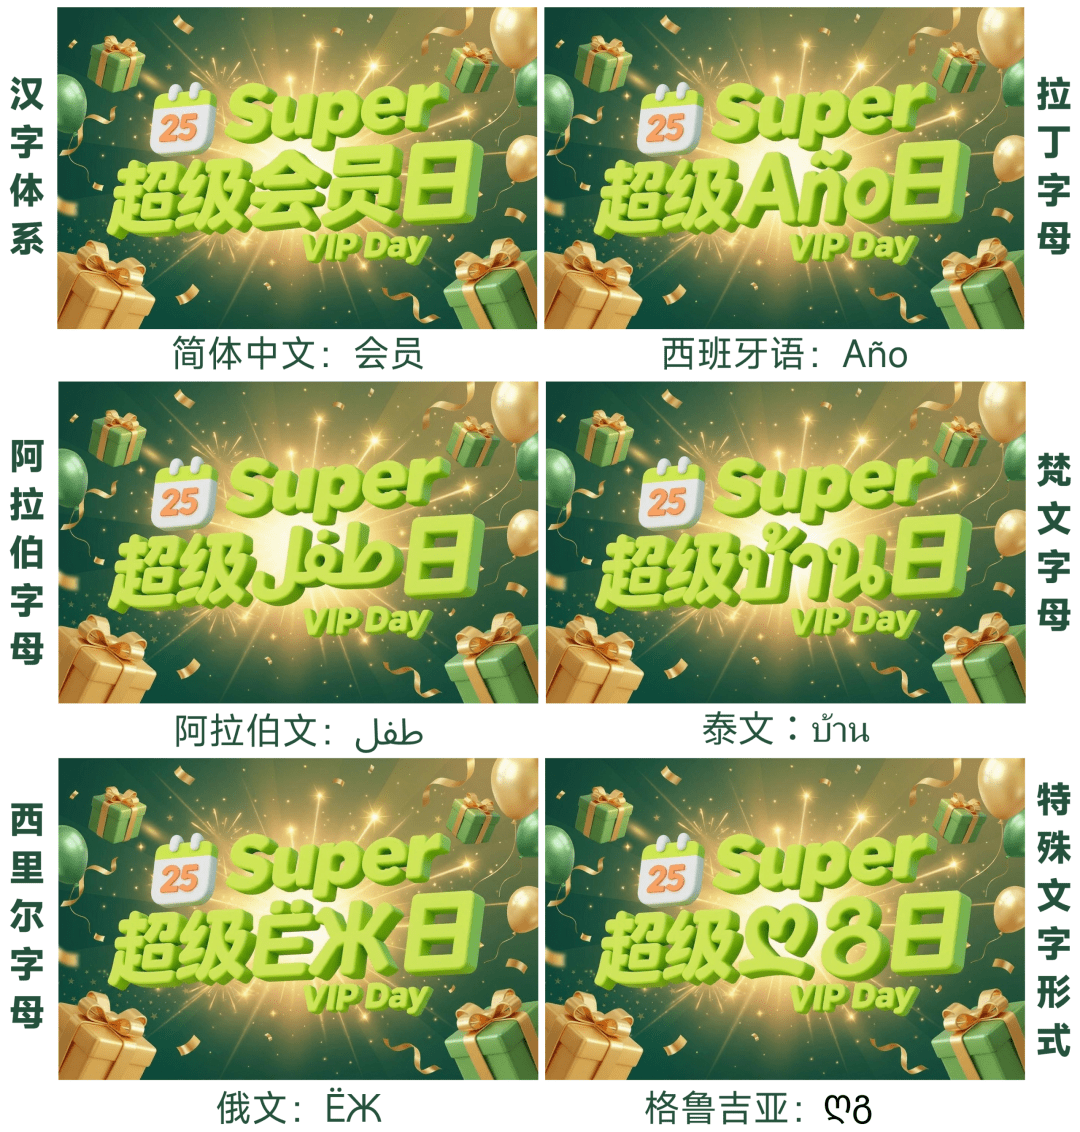
对于图像中的文字,消除以后往往还需要替换成新的内容,这要求模型不仅要生成准确的目标字符,还不能破坏原有字体、排版、颜色与背景纹理。针对字符准确性与视觉风格难以兼顾的问题,美图影像研究院在ICML 2026提出了基于Self-Prompting的图像文本编辑方法,实现多语种的“无痕改字”。
区别于依赖图像修补和依赖OCR或固定字表的建模方式,该方法通过直接从输入图像中提取风格信息,并结合目标文本生成高保真的字形提示,将两者与原图进行统一建模,无需额外引入专门的风格或字形编码器,就能实现端到端的编辑。
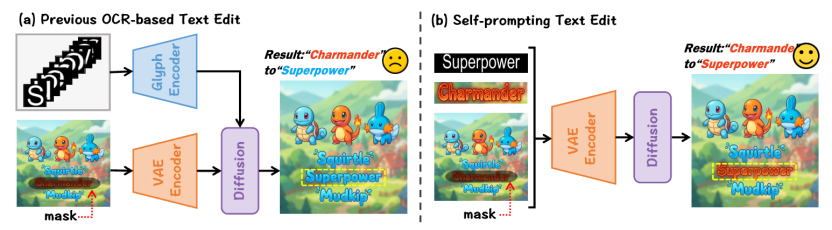
借助多模态扩散Transformer的上下文学习能力,该方法能够在保持原有字体风格、颜色和纹理的同时,实现跨语言、跨场景的高质量文本替换,为多语言场景文本编辑提供了一种统一且可扩展的解决方案,也为真实复杂环境中的风格一致性编辑奠定了重要基础。
相较主流模型,美图影像研究院的无痕改字能力从编辑准确性到风格一致性,都实现了最优表现。尤其在繁体中文、泰语、日语甚至是特殊符号等复杂文字场景中,也展现了极强的稳定性。目前该能力已通过“无痕改字”上线美图秀秀PC端,覆盖汉字、拉丁字母、阿拉伯字母、梵文、西里尔字母在内的全球五大主流文字书写形式,即使是非文字形式的特殊符号也能完成改写。
人像编辑:从试衣到发丝的动态真实感
回到美图最为擅长的人像领域,造型作为人像的关键一环,难点在于需要同时理解材质、纹理、光照以及人与场景之间的关系。
面向原生2K多服饰试衣的新框架WearWow
在ECCV 2026上,美图影像研究院提出了面向原生2K多服饰试衣的新框架WearWow。2K分辨率是目前电商图片用于展示服饰鞋帽细节及质感的标配,但多件服饰鞋帽共同输入时,Virtual Try-On的试衣方案容易导致显存消耗与耗时均显著增加,且试穿效果不佳。
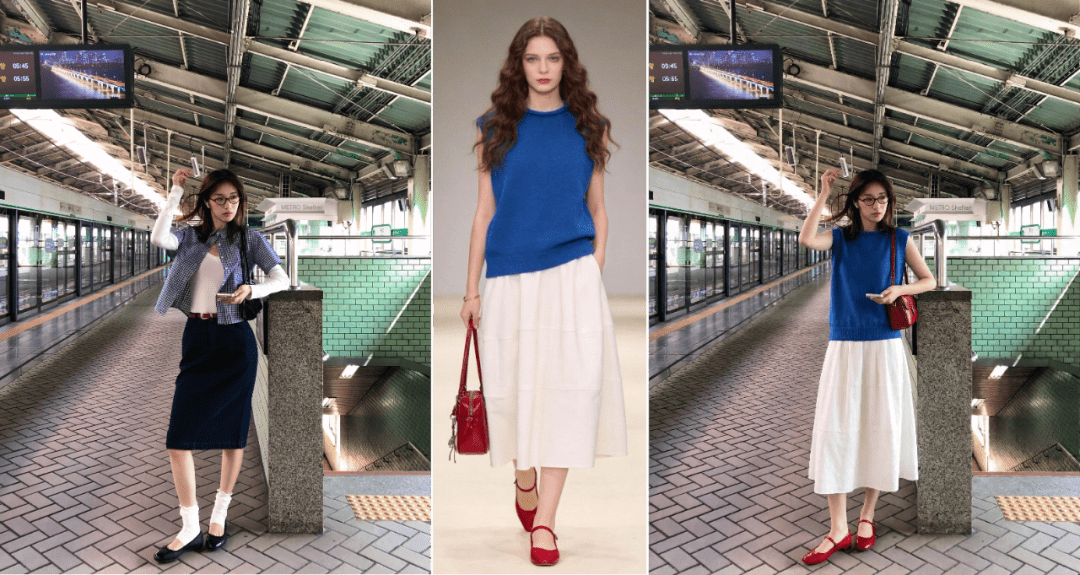
而扩散模型在高分辨率下易出现纹理退化现象,羊毛、牛仔、针织等特殊材质会有明显的“塑料感”,虽然这些方案基本都已经能够“穿对衣服”,但距离真正商用还有较大的差距。
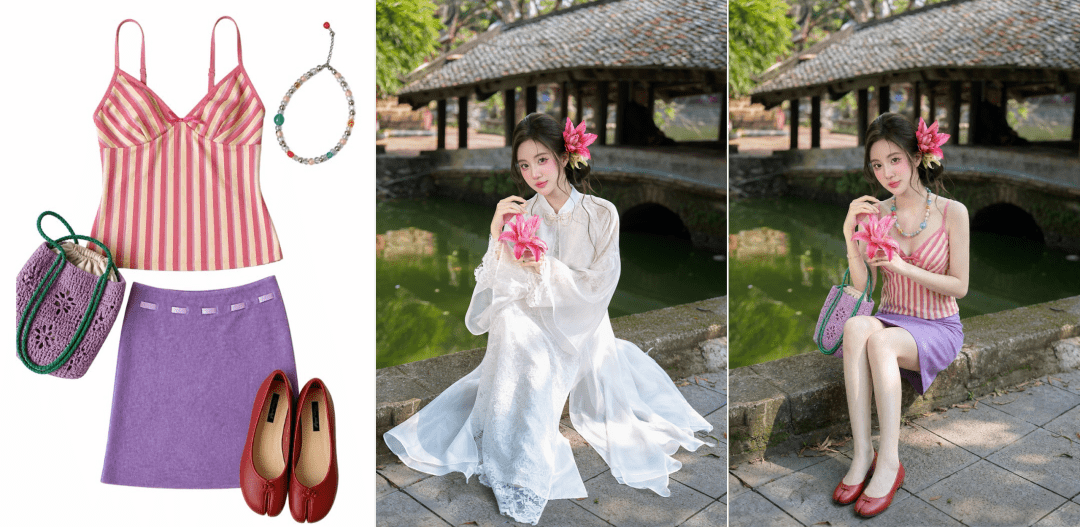
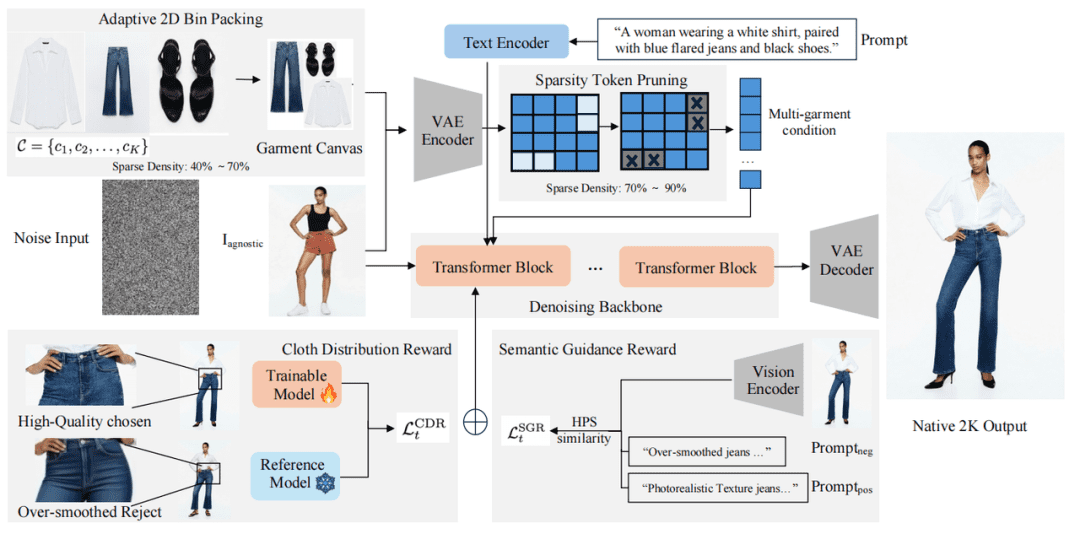
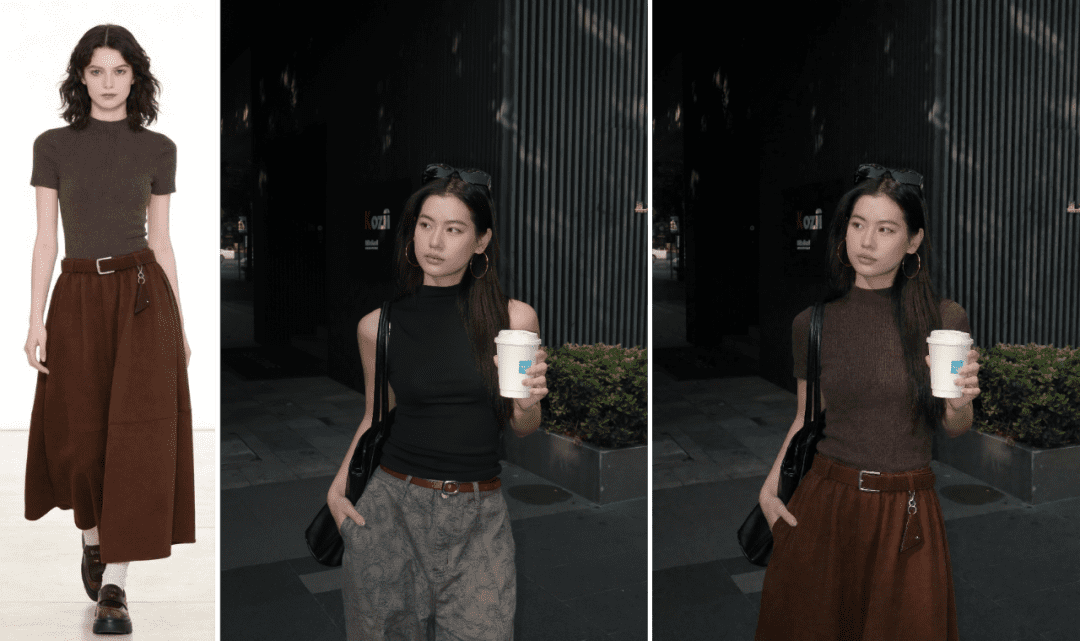
对此,WearWow采用Adaptive 2D Token Packing(ATP)解决了计算效率问题,实现端到端的多服饰生成,再利用Multi-dimensional Try-on Reward(MTR)进一步调整模型生成方向。基于对穿戴关系的精准理解,WearWow将试衣方案从“替换服装”升级为“真实穿戴”,即使是在2K高分辨率下,依旧能够保持羊毛、棉麻、粗针织等等服饰材质的真实质感。
在多件服饰、鞋帽等不同单品组合输入条件下,模特身着汉服、礼服等结构复杂的服饰,WearWow也能够避免层叠关系混乱与穿戴错乱,提升复杂试装场景下的真实感与稳定性。面对大面积遮挡、特殊姿态等复杂场景,WearWow能够实现自然贴合的服装生成,真实还原服饰材质、纹理与质感。
对比主流的通用模型,WearWow结合了智能场景识别能力,即使穿戴目标中存在干扰元素,比如穿戴图中包含鞋子,但模特是半身场景,WearWow的试穿效果也不会错误改变人物姿态。凭借AI试衣的玩法功能火遍全球之后,AI试衣的能力也在进一步向商用场景扩展,目前该能力已经上线美颜相机APP的“AI换装”功能和美图设计室“服饰穿戴”“换模特”与“AI试衣”功能。
动态毛发渲染框架ControlHair
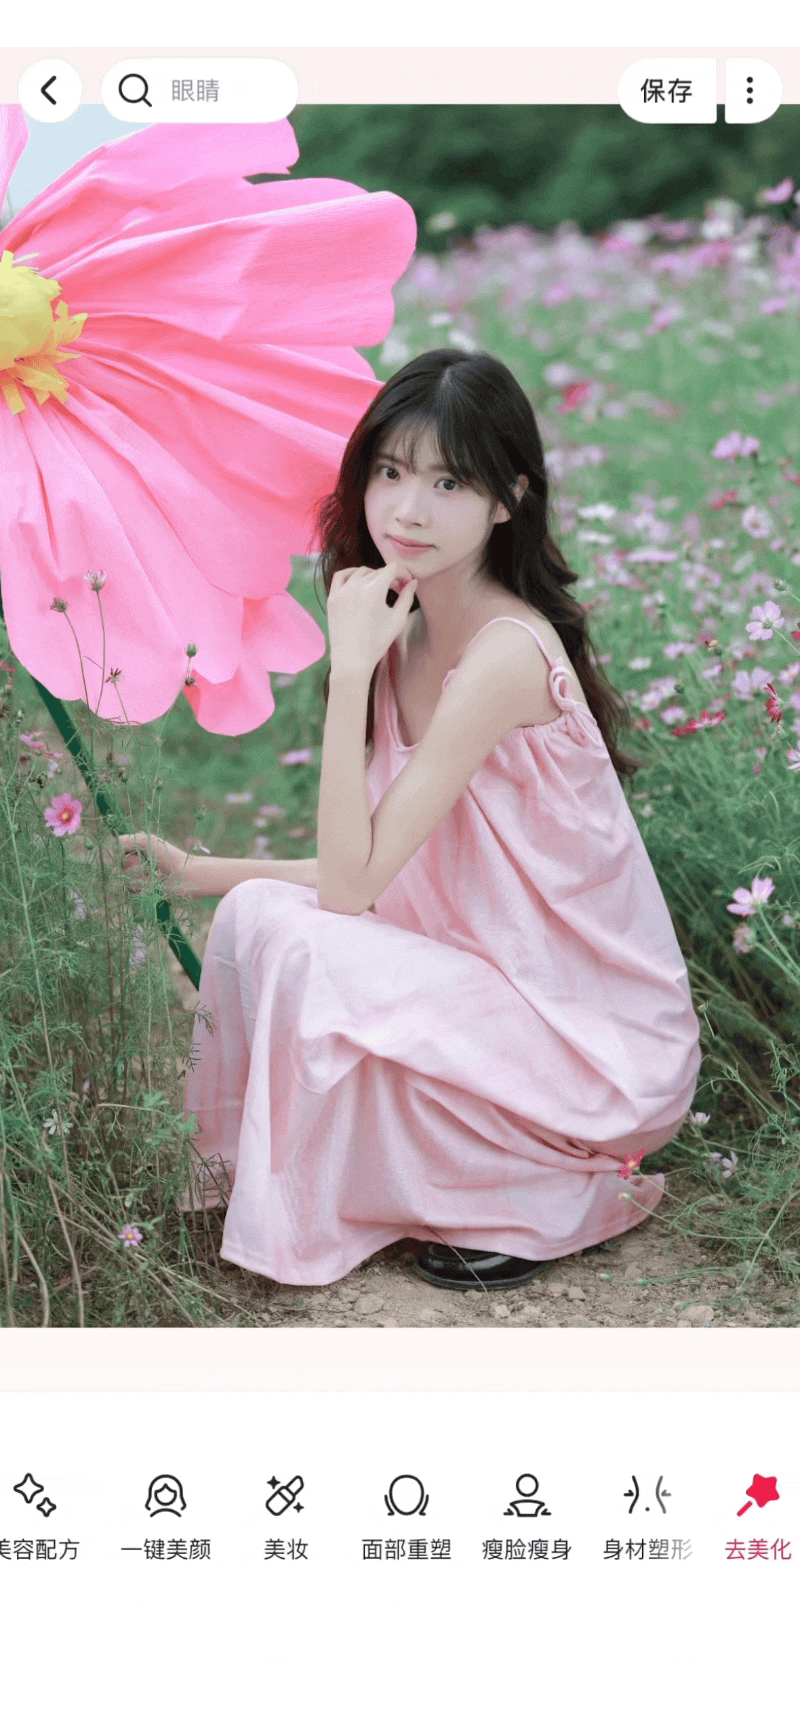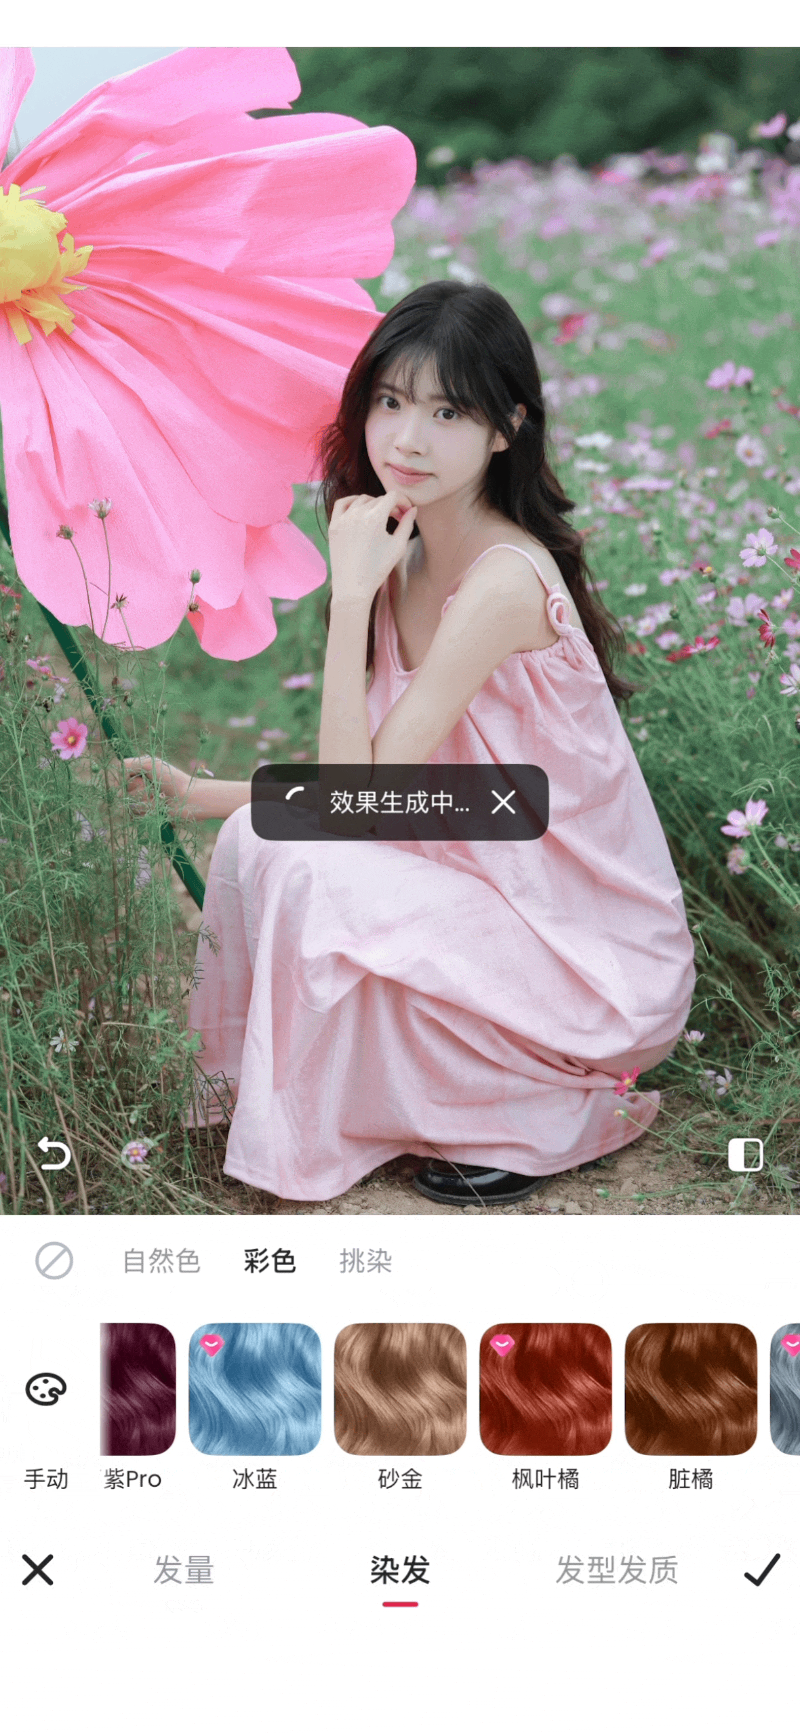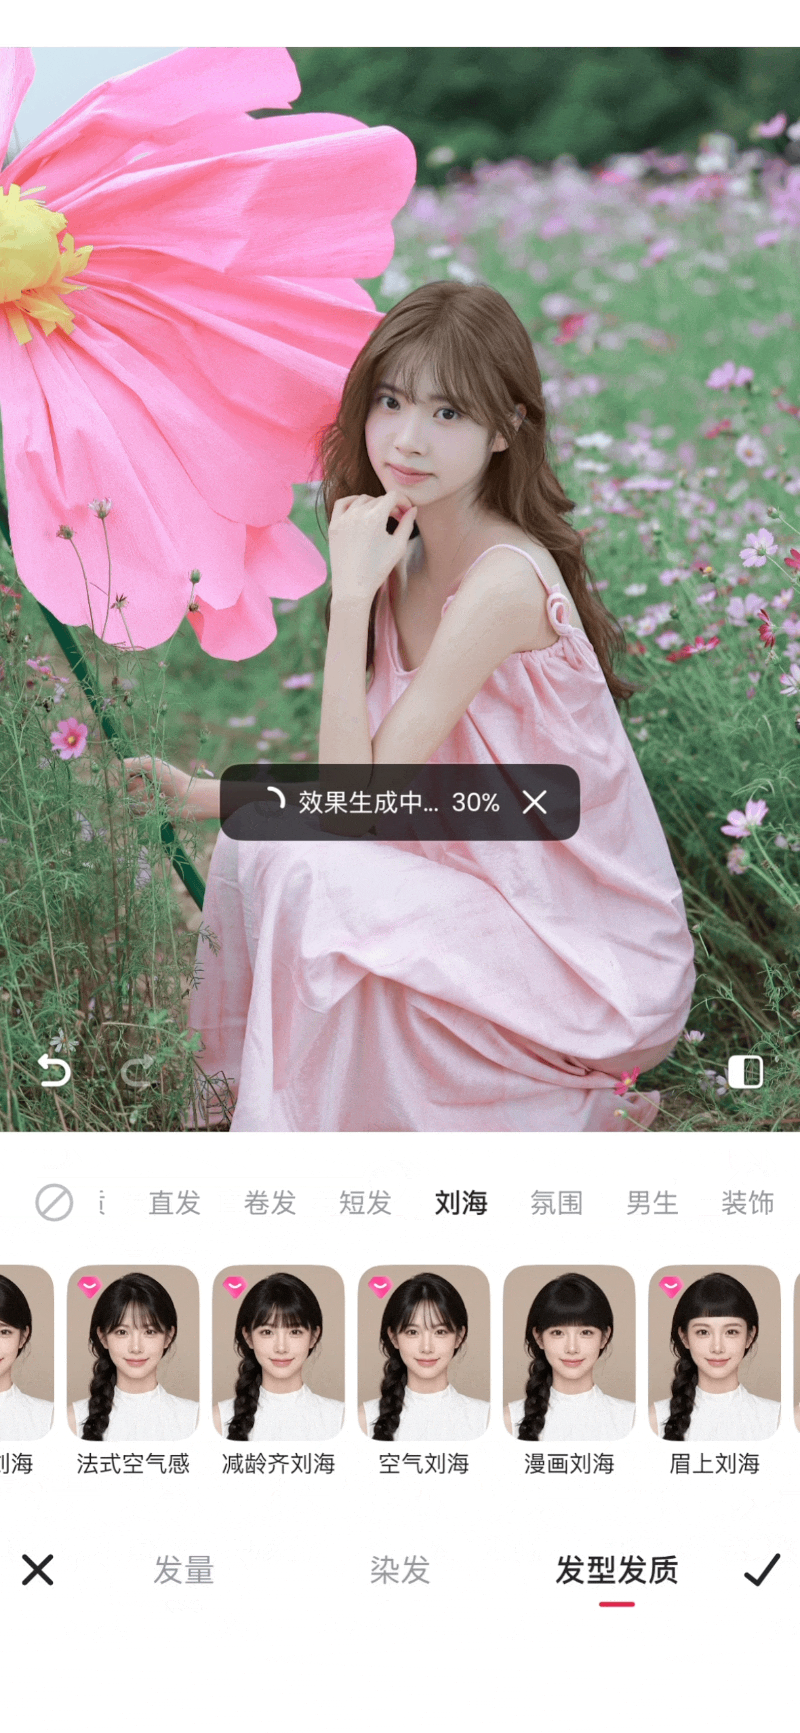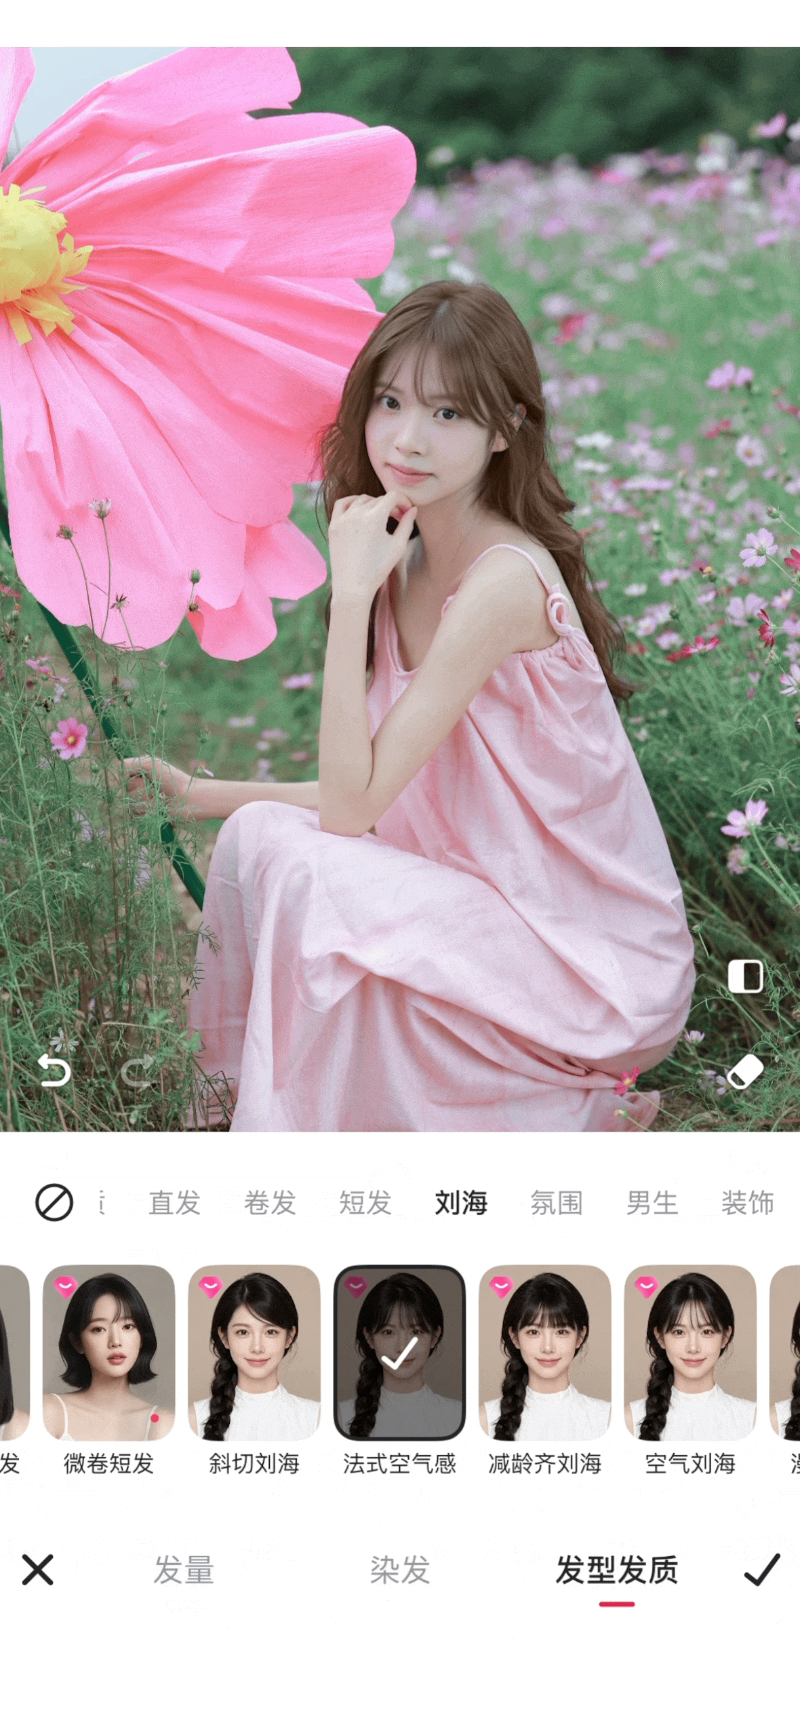
在动态人像中,头发、衣物等柔性材质的运动往往会对画面的可信度造成较大影响。由于头发高自由度、细长结构、自碰撞和复杂光照交互的特性,导致它在视频生成中难以显式控制。但在现有的视频生成技术路线中,文本驱动很难让发丝按照具体的风向和力度描述摆动;姿态驱动中的骨骼信号则不包含发丝信息,头发只能依赖模型先验“自行发挥”。
对此,美图影像研究院在ECCV 2026上提出动态毛发渲染框架ControlHair,将物理模拟器与视频扩散模型进行级联,通过将物理仿真与画面生成解耦,实现了可控、真实的动态发丝渲染,让发丝效果从“看起来在动”变成“按照物理规律运动”。
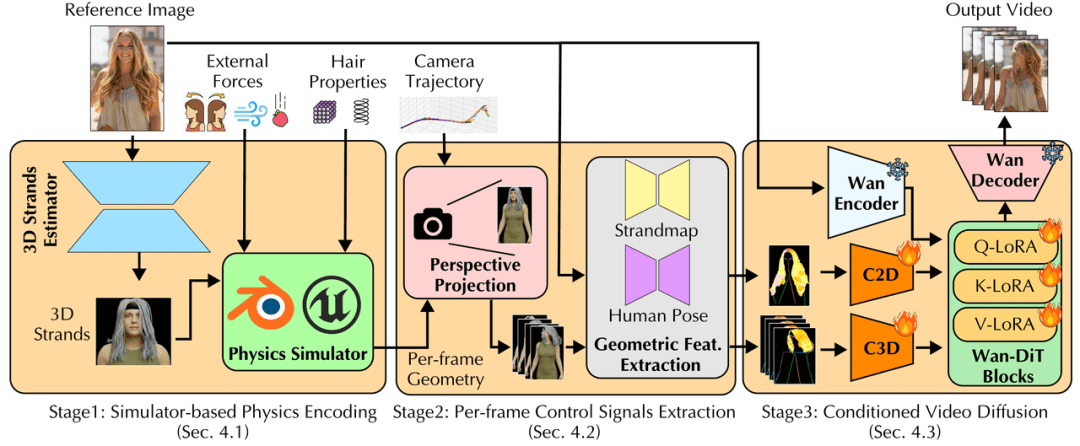
与此同时,围绕在发丝结构、材质与视觉表现方向上的长期积累,美图影像研究院持续将其转化为美发场景中的产品能力,目前已上线“发丝飞扬”“飘逸发光”等多款氛围感美发功能。头发作为同时关联材质纹理、光照关系、运动规律、几何结构的复杂编辑任务,是考验AI精细化能力的一块“试金石”,仅2026年上半年,美图影像研究院研发上线超过50款发型功能,覆盖高颅顶、补发等发量调整,以及染发、换发型、发质优化等不同需求。
理解与控制:让AI更懂创作意图
如果说模型的编辑能力决定了AI能够处理哪些任务,那么模型的理解与控制能力,则影响AI能否按照创作者的意图完成。很多时候我们只是“改了一点点”,但模型却需要先完成一次复杂的理解,“知道改哪里”“知道什么不能改”“知道画面真正表达什么”,有时候比生成本身更加困难。
基于双向语义流的条件分割方法FlowSeg
在ICML 2026上,美图影像研究院针对“分割对了却选错了”的语义对齐失效问题,提出了基于双向语义流的条件分割方法FlowSeg。基于LLM的条件分割根据自然语言描述,目前已经能够精准地“抠”出目标区域,但主流的“提议-选择”框架全程几乎由视觉特征主导,语言条件只在最后一步才“介入”打分,因此正确的Mask往往已经被生成出来了,却没有被选中。这就导致模型在执行任务时很容易选错对象,尤其是针对指定对象的局部编辑。
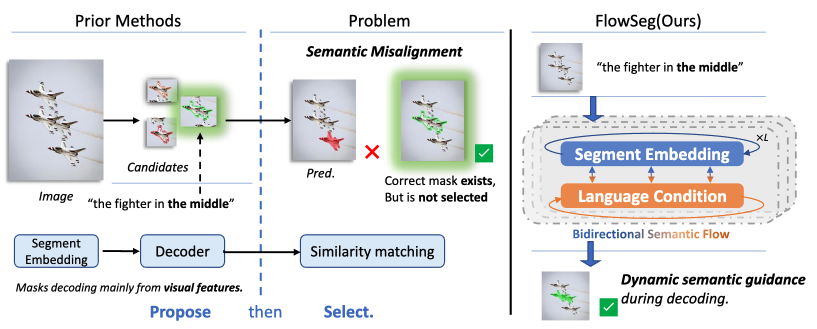
FlowSeg重新定义了“语言”在LLM条件分割中的角色,在每一解码层用语言条件引导查询特征的更新,使得生成过程中Mask始终与语言描述保持一致,同时不断吸收来自解码器的视觉证据,并随着Mask的逐渐清晰进行动态更新。FlowSeg让“语言”深入参与到mask生成的每一步动态过程中,并与视觉在解码过程中共同演化,形成真正的双向交互闭环,即使面向极度复杂的场景,FlowSeg也能精准对齐画面对象与语言指令,准确判断编辑目标。
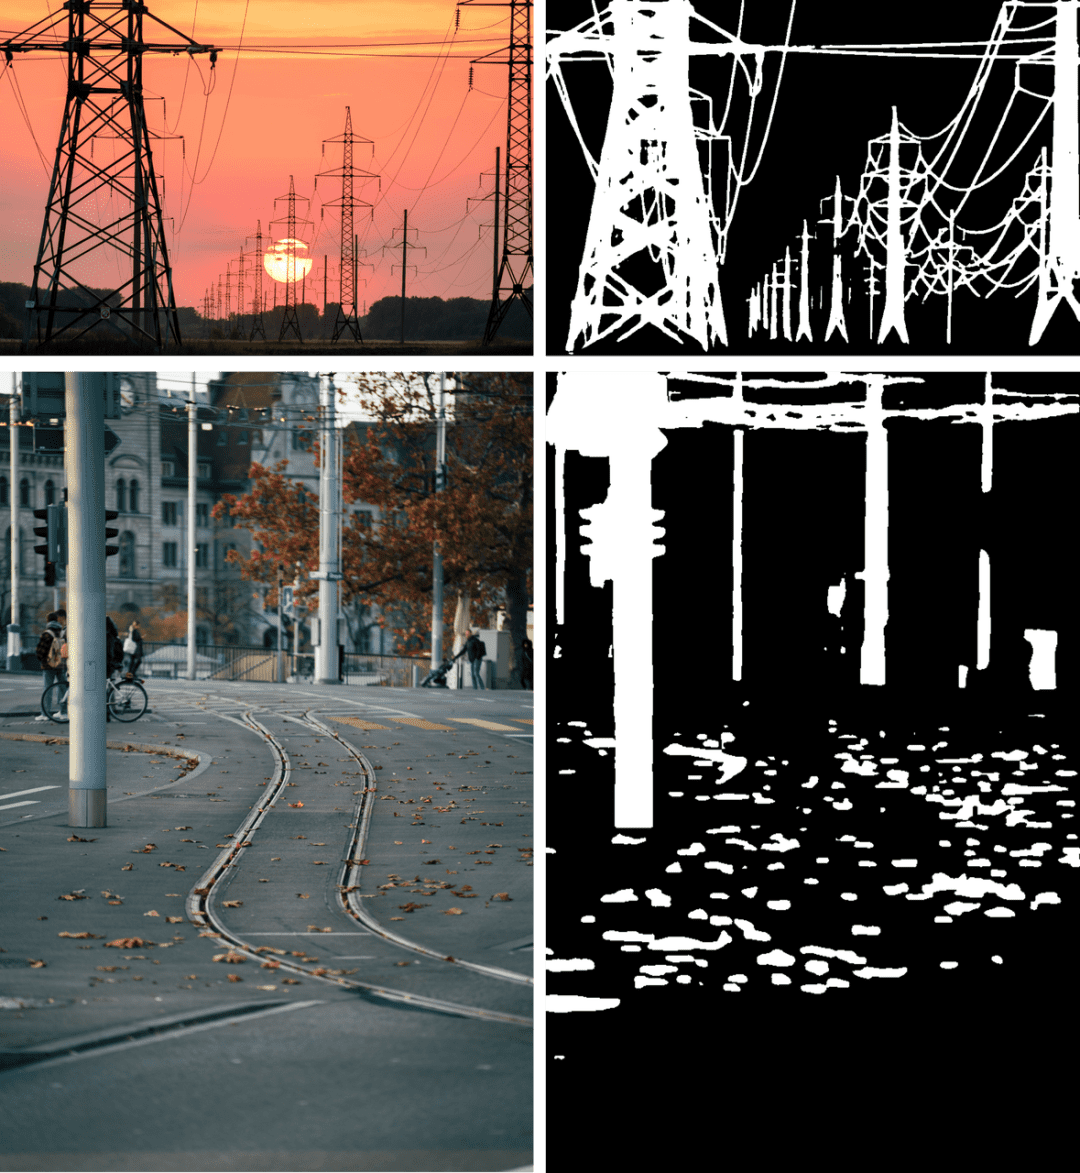
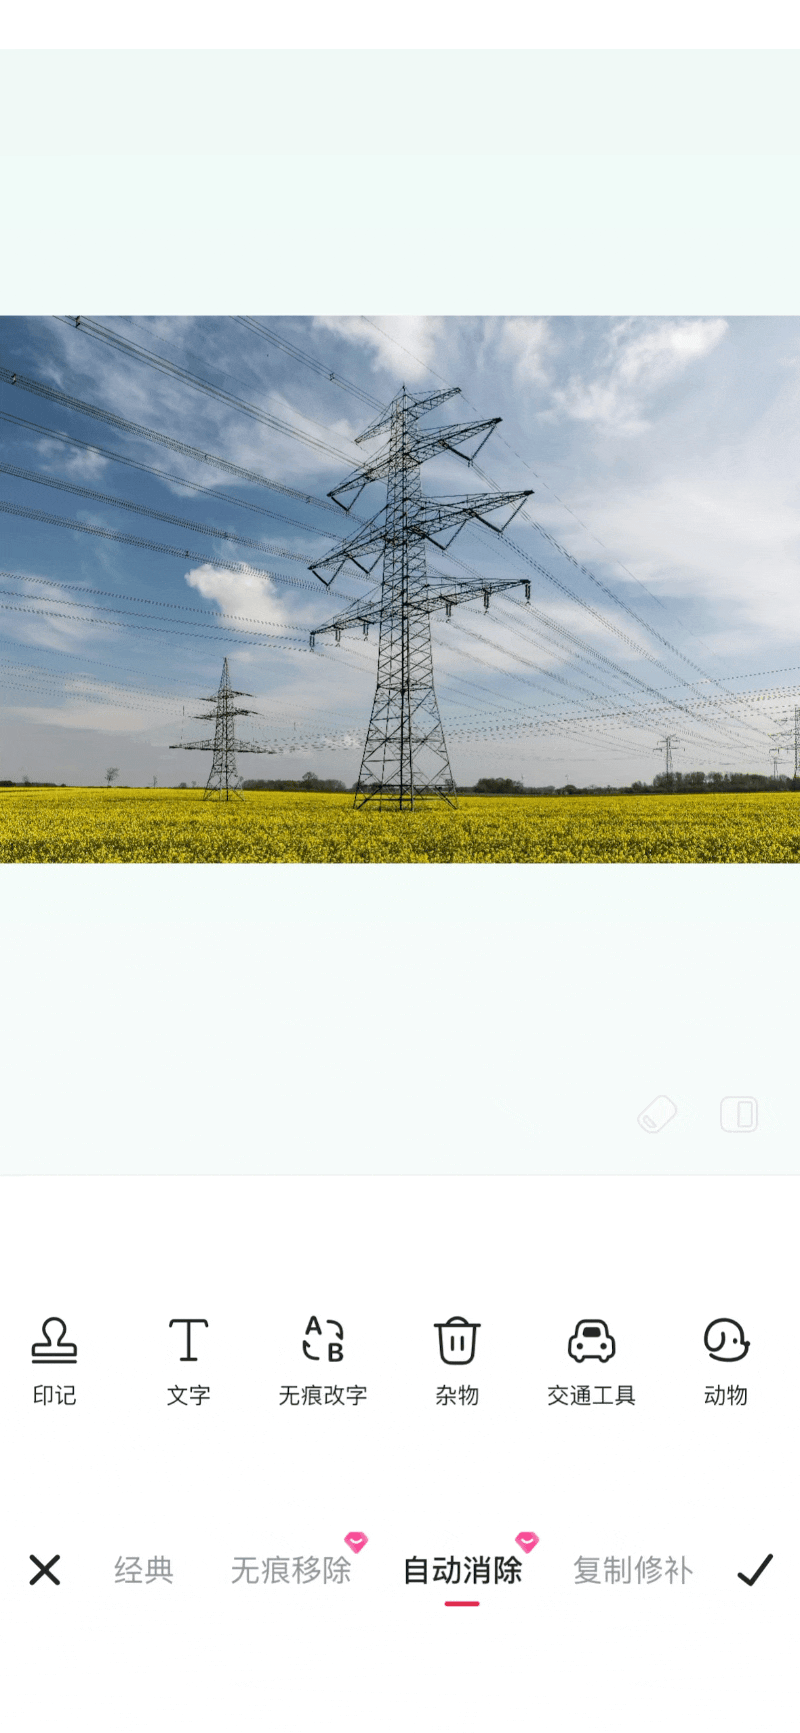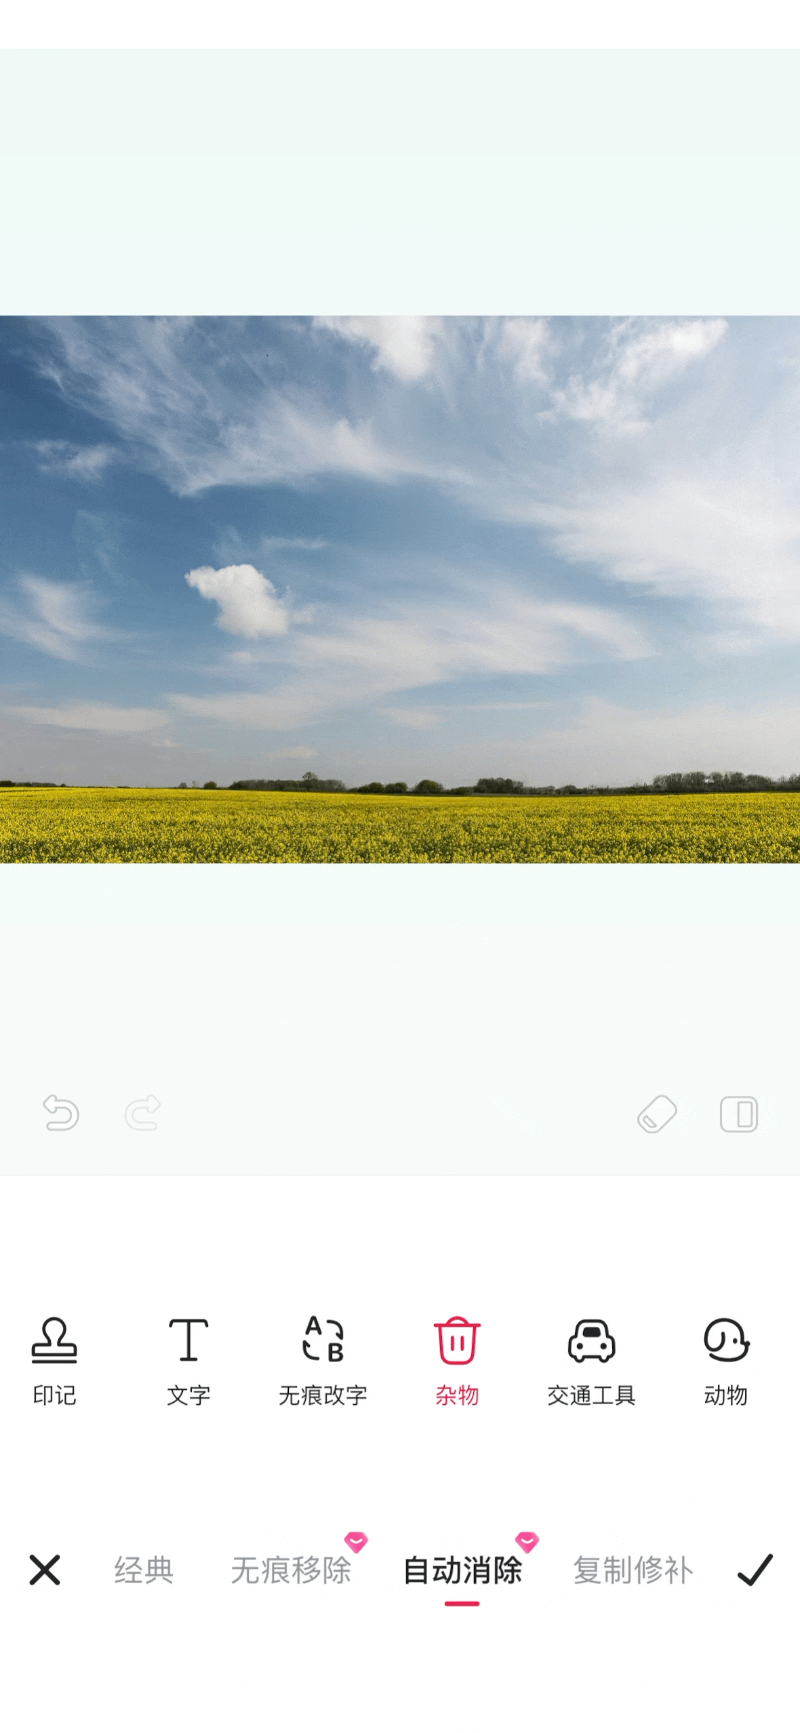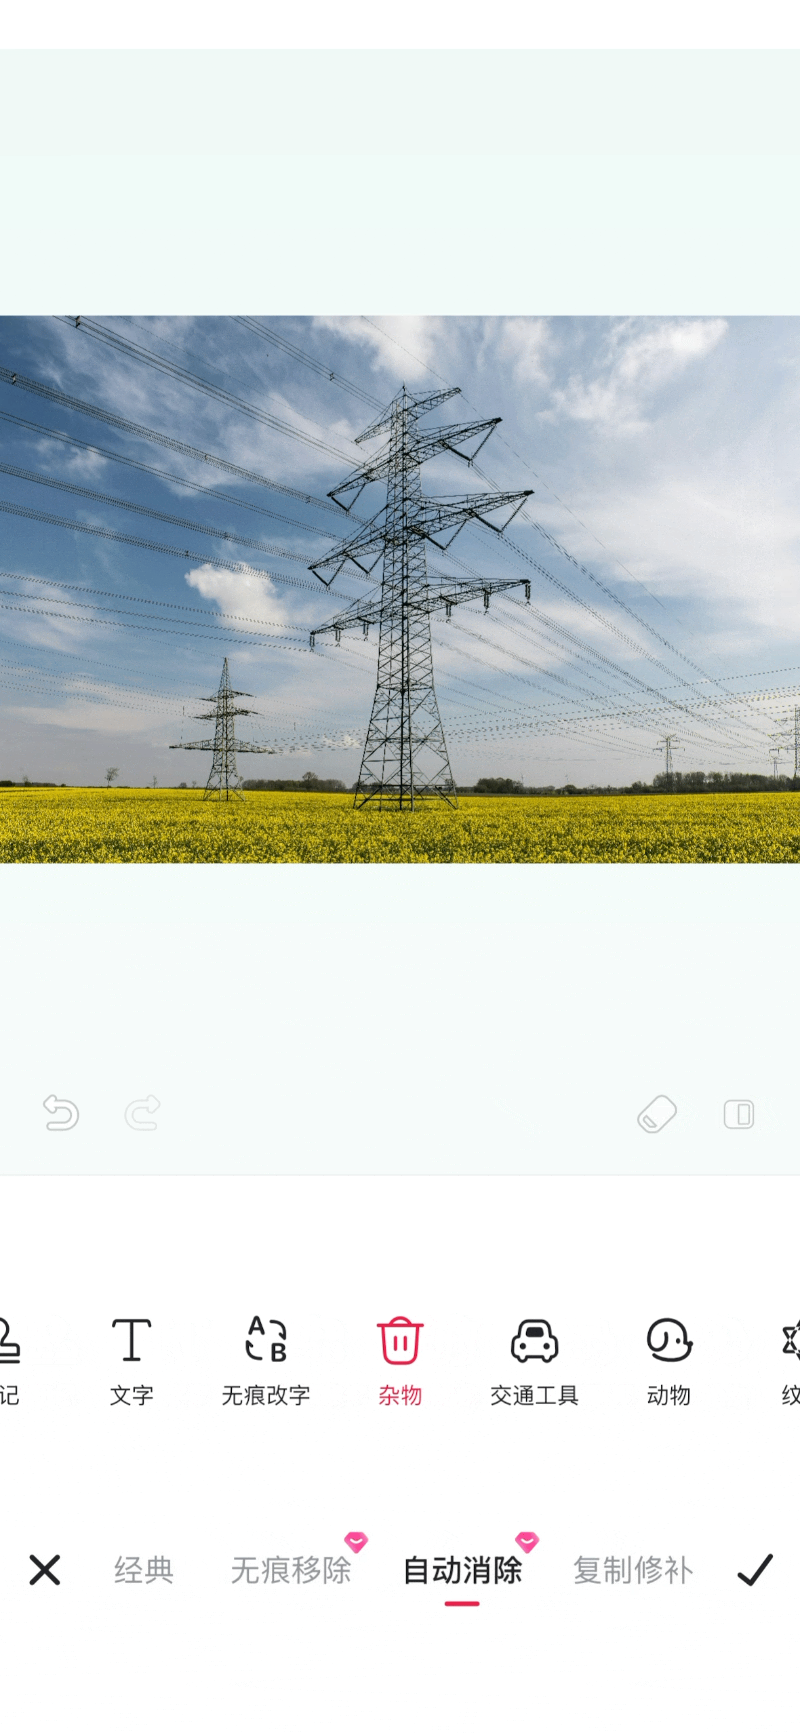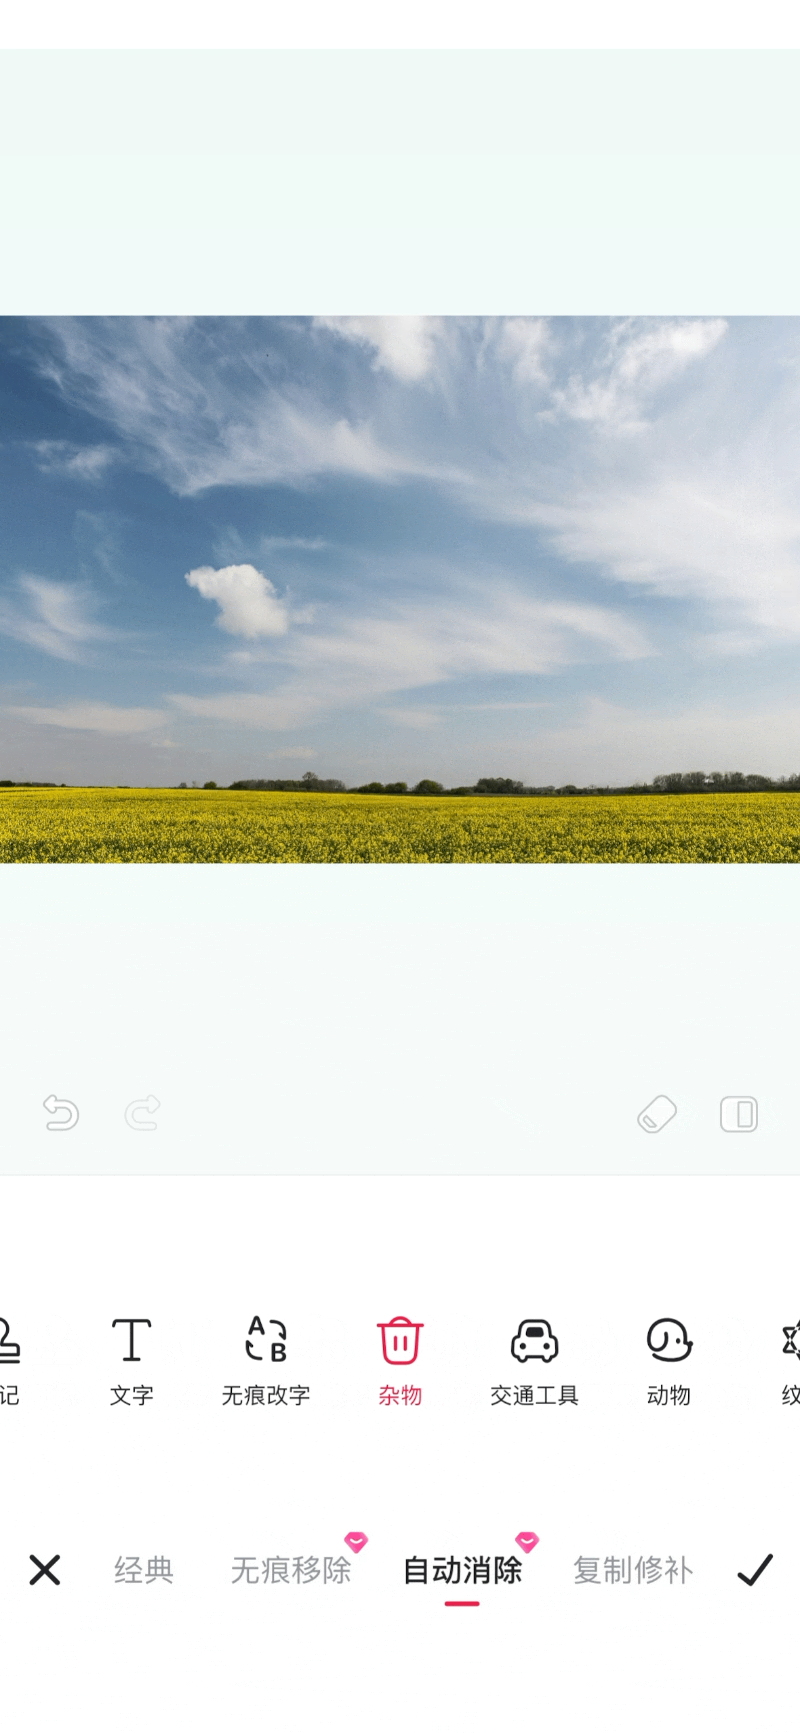
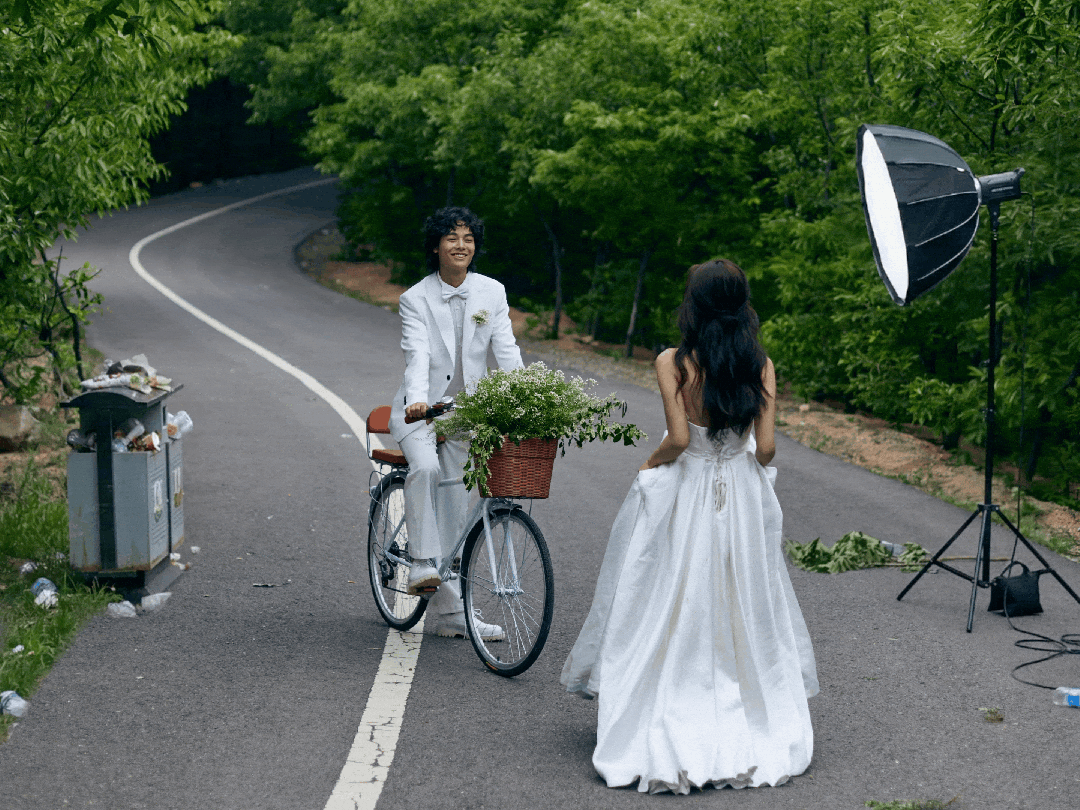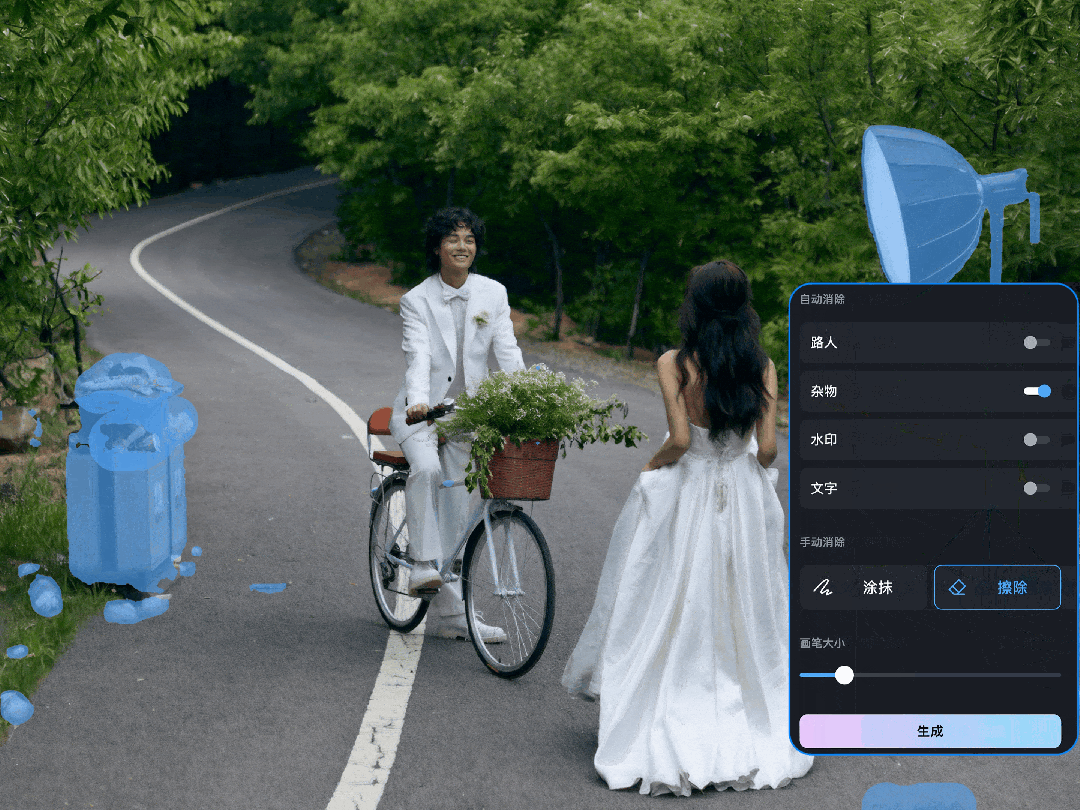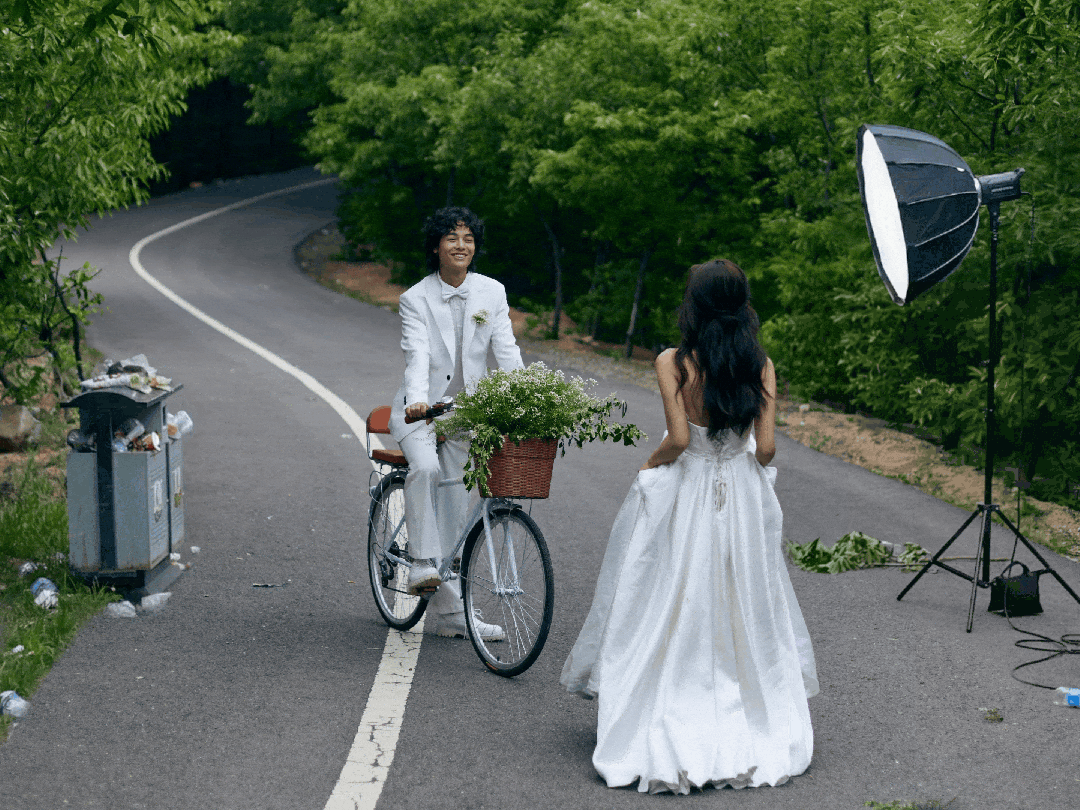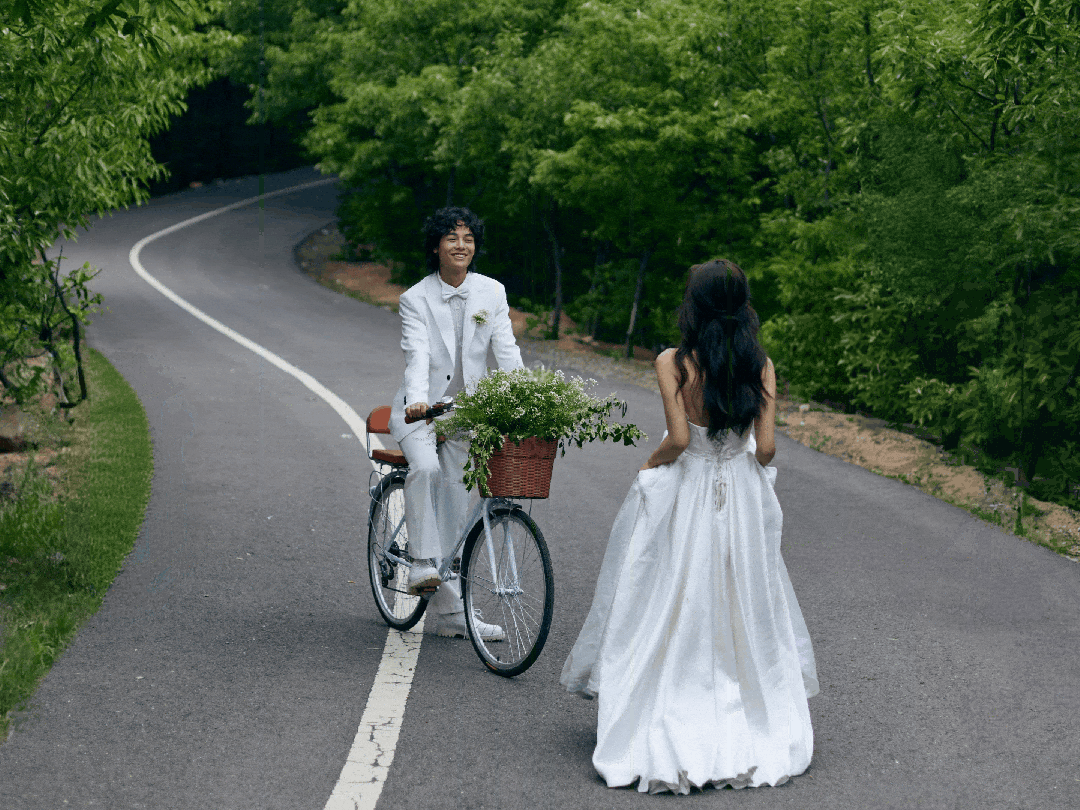
结合AI图像消除能力与FlowSeg在复杂场景下对丰富类别物品的语义对齐与分割,美图云修、美图秀秀APP上线“杂物消除”功能。不需要手动选择,AI就可以智能识别并消除包括电线杆、路牌、告示、应急出口、落叶、垃圾等等物品在内的所有杂物,并实现“无痕消除”。
基于DiT的3D位置编码框架PE-Field
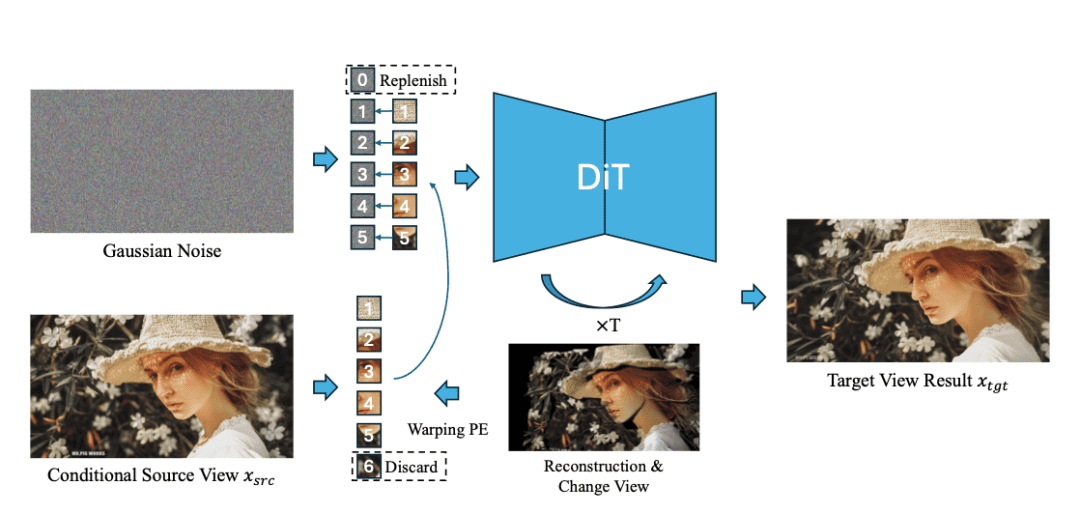
局部编辑任务中,精准选中目标是一类问题;在视角变换、物体旋转等空间编辑任务中,处理好更复杂的空间变化,则是另一类问题。在ICLR 2026上,美图影像研究院提出了基于DiT的3D位置编码框架PE-Field,基于对DiT中画面空间结构很大程度上由位置编码组织这一发现,将传统的2D位置编码扩展为带有深度信息的3D位置编码场,并通过多层级位置编码将空间控制从Patch进一步细化到更小的局部区域。
这使得模型在单图新视角生成、物体旋转、空间位置调整与目标移除等任务中,能够更准确地处理视角变化、遮挡关系和空间结构,该方向的进一步拓展,也为多视角视觉素材生产和空间可控编辑提供了坚实的技术基础。
自然语言镜头运动理解基准ACaM
进入视频场景,影响视觉表达的还有一项很关键能力——镜头语言。比如在画面中逐渐被放大的人物,可能是来自于主体向镜头靠近、相机推近或者是镜头焦距发生变化,但它们所传递的空间感、叙事重点和情绪完全不同。随着AI视频迈向MV、短剧、影视等更专业的创作场景,只是生成“会动的画面”还远远不够,模型还需要真正地理解镜头语言。
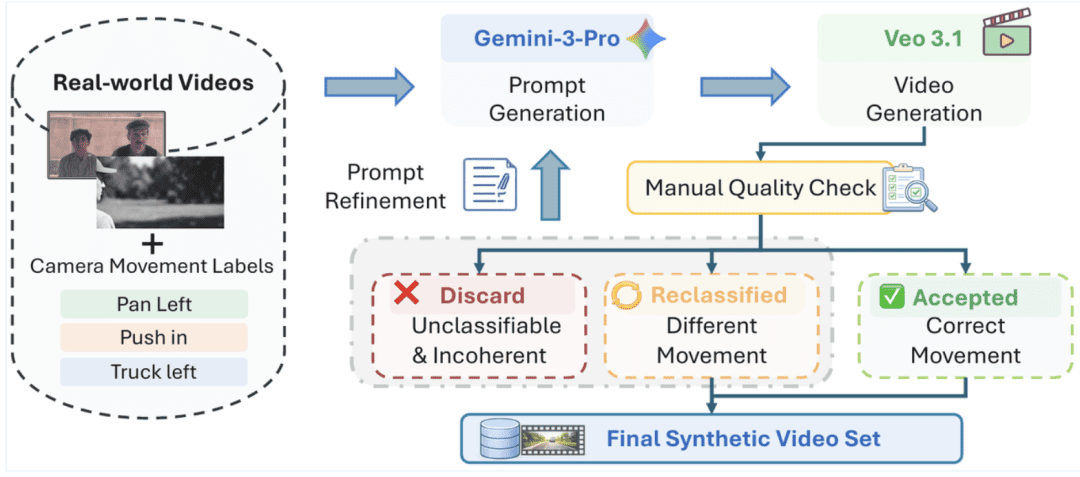
在过去,运镜理解往往被当作视频理解中的附属问题,美图影像研究院在ECCV 2026上首次将“自然语言镜头运动理解”确立为独立研究问题,系统梳理了视觉语言模型(VLM)在自然语言镜头运动理解上的五大失效模式,并构建了首个同时覆盖17类运镜、涵盖真实与合成视频的评测基准ACaM(Atomic Camera Movement)。在此基础上,美图影像研究院通过重采样和针对性数据增强,整理出2.7万条类别更均衡的训练数据对VLM进行微调,验证了其对模型运镜理解能力的显著提升。
ACaM为视频模型“学习运镜”和“判断运镜正确性”建立了数据与评测基础,可以看到,从编辑目标的语义对齐、画面的空间组织,到局部动态与专业镜头语言,美图影像研究院正在持续从真实创作场景挖掘用户痛点,并通过数据构建、方法研究和评测体系,持续推动模型能力提升。
交互方式:从文本到多模态协同
当模型理解、控制、生成的能力持续变强,单一的交互方式已经难以适配所有创作任务,很多时候复杂的需求甚至难以用文字清晰说明。比如在许多创作场景中,会包含具体的位置、方向、形状与变化幅度,但纯文字指令很难清晰地描述这些精细的变化、且难以定位空间位置,容易产生空间歧义;而纯草图输入易造成编辑意图直指向不明确。
协同式图像编辑框架SI-Edit
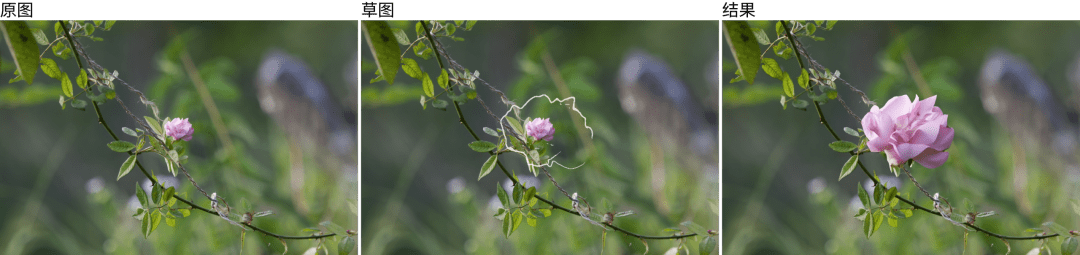
对此,美图影像研究院在ACM MM 2026上,提出了协同式图像编辑框架SI-Edit,将文本指令的语义信息与草图的空间结构约束协同融合,有效缓解了单一模态引导中的语义歧义和空间歧义,用户既可以通过语言说明“想怎么改”,也可以直接用笔画表达“在哪里改、向哪里延伸、最终形成什么形态”,实现了像素级的局部图像编辑。
为了让语言和草图真正协同工作,SI-Edit引入了可学习的任务触发词,使模型主动建立文本动作与草图信号之间的联系;同时采用共享位置编码策略,让草图笔画与原图中的对应位置建立明确映射,减少局部形变中的空间漂移,还构建了约6500组“源图—目标图—草图—指令”四元组数据,为拉伸、弯曲、缩放与姿态调整等精细局部编辑提供训练基础。
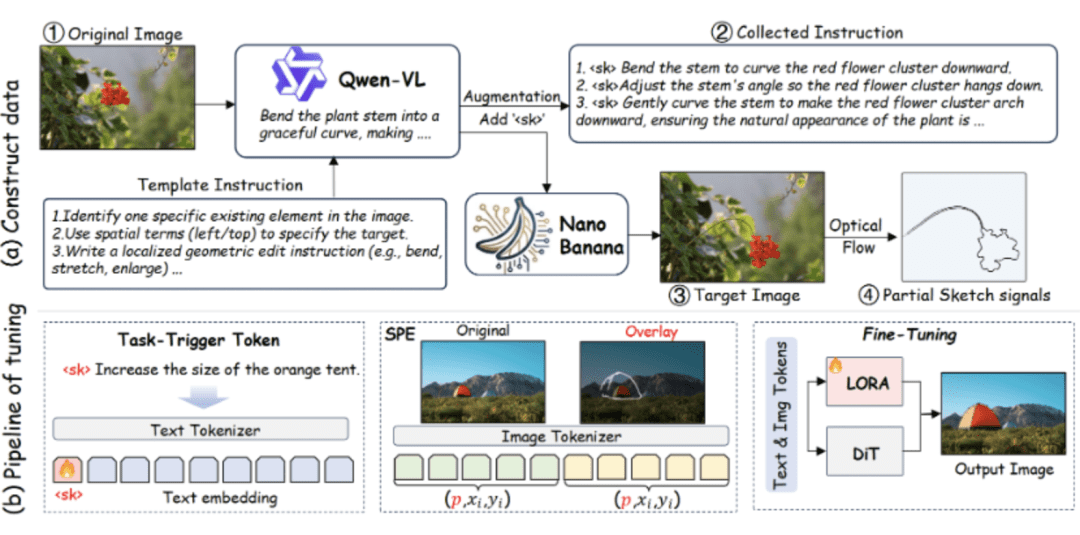
通过SI-Edit,可以将花朵任意放大缩小,将树枝向指定角度弯曲,将火焰按照想要的形状燃烧,让编辑过程更加自由,编辑结果更加精准。
随着生成能力进化为更通用的基础能力,AI影像真正的较量也开始深入真实创作场景,美图影像研究院将前沿研究、专业数据、模型评测、工程落地环环紧扣,为美图形成真正可落地的产品力,而长期深耕AI影像的价值,也在这些细节中显现——在持续抬高模型能力上限的同时,让AI产品真正从“可用”走向“爱用”。