WCM:让机器人Critic学会预测未来,强化学习性能飙升97.9%
在机器人操作领域,强化学习(RL)正逐渐成为提升策略性能的关键手段。然而,一个常被忽视的瓶颈在于批评家模型(Critic)的设计——它负责评估当前状态的价值,却往往只依赖单帧图像,忽略了机器人控制固有的部分可观测性。这就像让一名裁判仅凭比赛截图判断运动员是否正在完成关键动作,而非通过回放理解动态过程。近期,OpenMOSS团队开源的World Critic Model(WCM)直击这一痛点,通过引入世界预测,让Critic在打分的同时预测未来状态,从而更准确地指导策略更新。实验结果显示,WCM在多个基准上取得了显著提升,甚至让一个初始成功率仅0.78%的模型跃升至98.7%。本文将深入解析WCM的核心思想、技术细节、实验结果及其开源资源,探讨它如何为机器人强化学习带来新的可能性。
一、Critic的局限:单帧观测下的价值误判
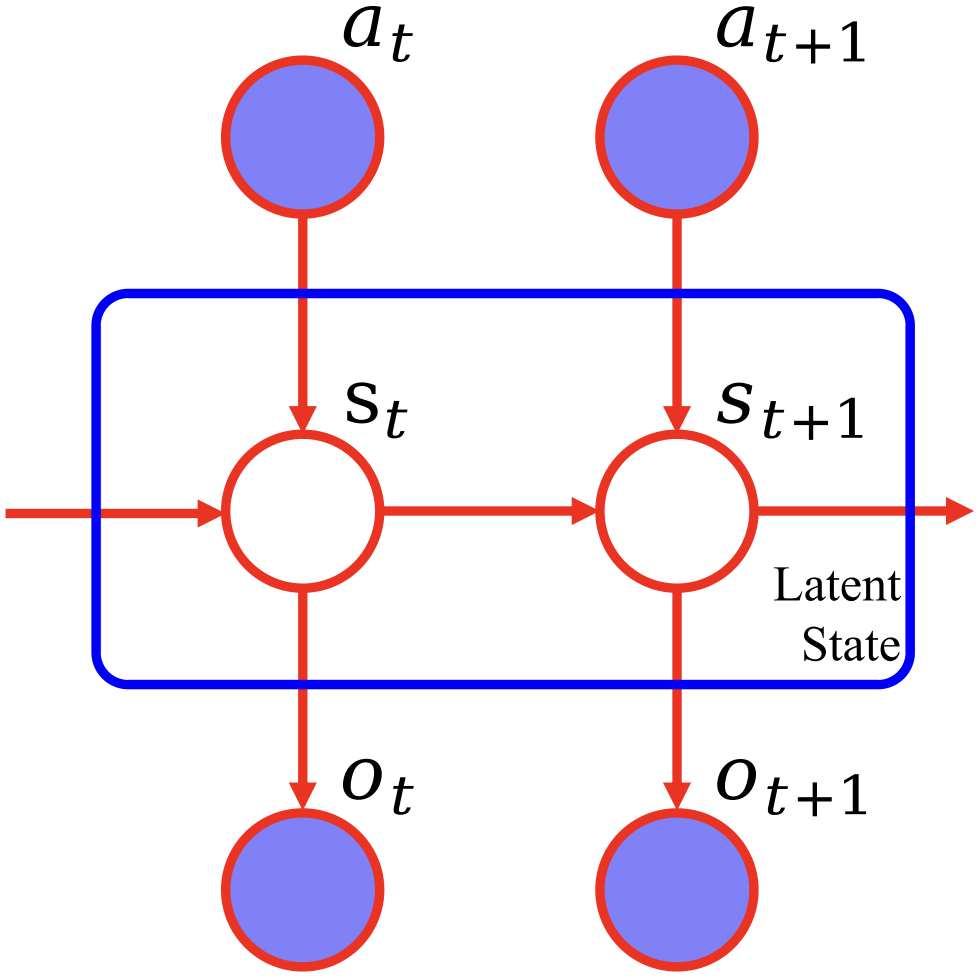
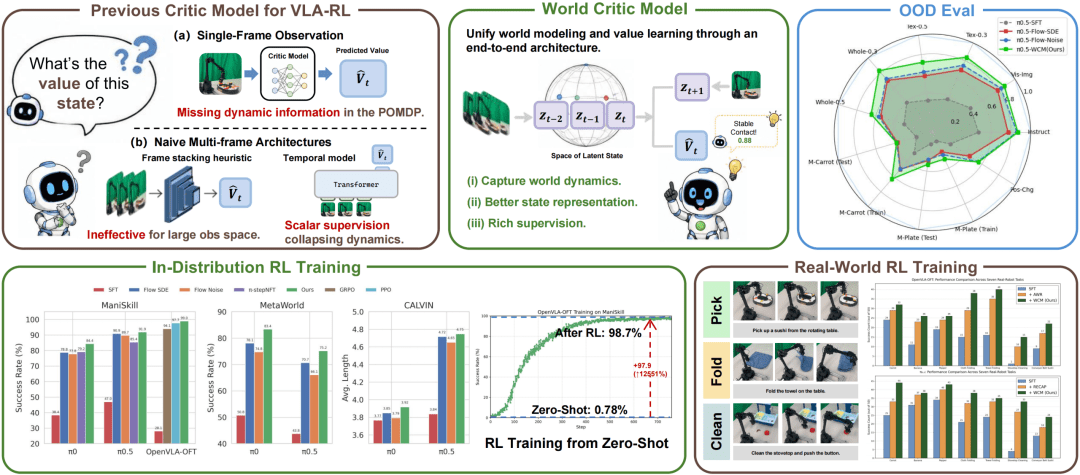
在Actor-Critic框架中,Critic负责估计状态的价值,为策略更新提供优势信号。如果Critic的判断失真,策略就可能被误导至错误方向。然而,机器人操作通常建模为部分可观测马尔可夫决策过程(POMDP),单帧图像无法提供足够的动态信息。例如,机械臂接近桌面可能代表正在施力清洁,也可能代表即将碰撞;夹爪的接触可能稳定,也可能滑移。这些状态在像素上相似,但价值截然不同。传统Critic仅依赖单帧VLM特征,容易学习到危险的伪相关,如将“末端靠近桌面”一概视为高价值,导致机械臂反复顶住台面。
二、多帧输入并非万能:缺乏动态理解
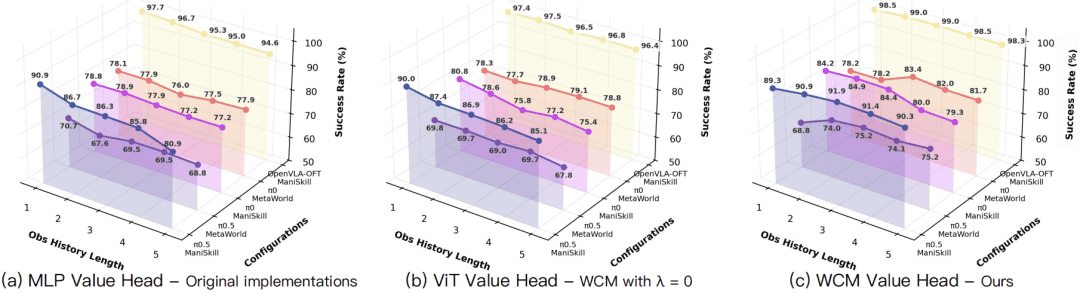
既然单帧不足,直观的解决方案是堆叠多帧图像或引入时序模型。然而,论文发现,仅仅增加历史输入并不足以解决问题。关键在于缺乏迫使模型理解历史变化的监督信号。传统Critic的目标是回归一个标量回报,对于高维图像序列,这种监督过于稀疏。即使输入包含多帧,模型也可能将其视为静态特征,而非学习物体运动、接触变化等动态信息。实验显示,直接增加历史观测可能导致性能下降;即使使用具备时序建模能力的Transformer,若不加入世界预测目标,仍难以利用历史信息。只有加入未来状态预测后,多帧历史才稳定转化为更好的价值估计。这揭示了一个重要观点:“有记忆”不等于“理解动态”,只有可预测的历史表征才更接近机器人真正需要的状态。
三、WCM的核心设计:价值与预测的统一
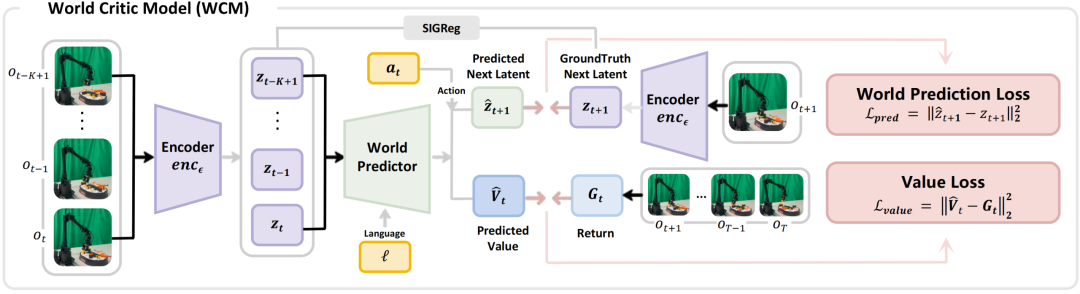
WCM基于轻量级LeJEPA风格架构,由四个关键部分组成:观测编码器、世界预测器、价值头和动态预测头。其工作流程分为四步:
- 编码连续历史:接收最近K帧观测,每帧独立编码为潜在表示,编码器可为ViT或VLM Backbone。
- 注入语言条件:任务指令通过语言编码与适配模块注入历史表征,使价值定义与任务目标对齐。
- 因果时序聚合:语言条件化的多帧特征经因果Transformer World Predictor处理,形成当前历史状态表示,同时支持价值估计和状态预测。
- 双头联合学习:Value Head输出状态价值,World Head接收动作条件预测下一潜在状态。总损失由价值回归损失、世界预测损失和特征空间正则损失(SIGReg)组成。
关键设计在于价值估计保持action-free,而状态转移预测是action-conditioned,避免混淆“状态有多好”和“执行动作后会发生什么”,同时共享表征得到改善。WCM并非生成像素的视频世界模型,而是预测任务相关的下一潜在状态,目标明确且高效。
四、兼容多种RL算法:模块化集成
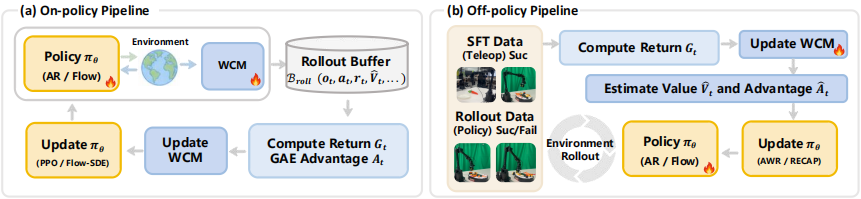
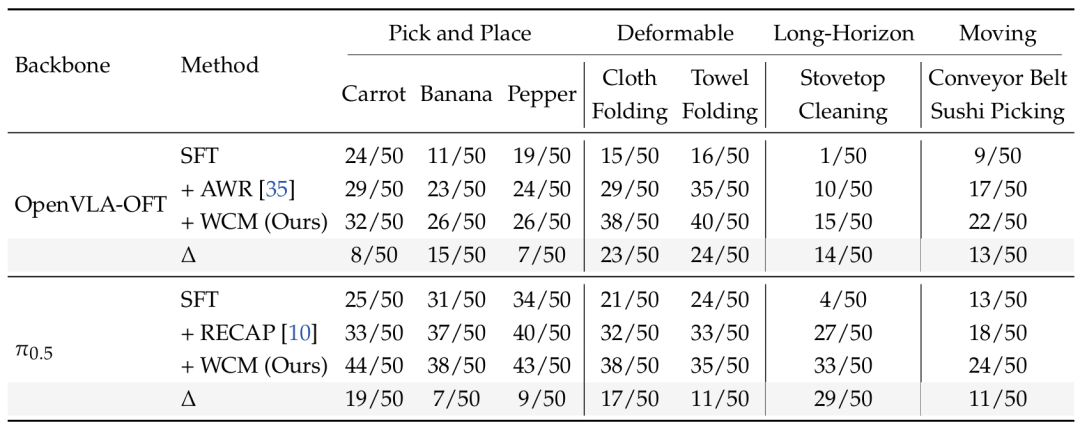
WCM不重新发明RL算法,而是作为Critic接入现有流程。在同策略(On-policy)学习中,自回归VLA可接入PPO,Flow Matching VLA可接入Flow-SDE,WCM提供价值估计用于计算Return和GAE Advantage。在异策略(Off-policy)学习中,OpenVLA-OFT可结合AWR,π₀.₅可结合RECAP,SFT数据、成功和失败Rollout统一放入缓冲区,持续更新Critic与Policy。这种模块化设计使WCM成为对Critic表征学习方式的升级,而非特定算法上的技巧。
五、实验结果:性能与泛化的双重突破
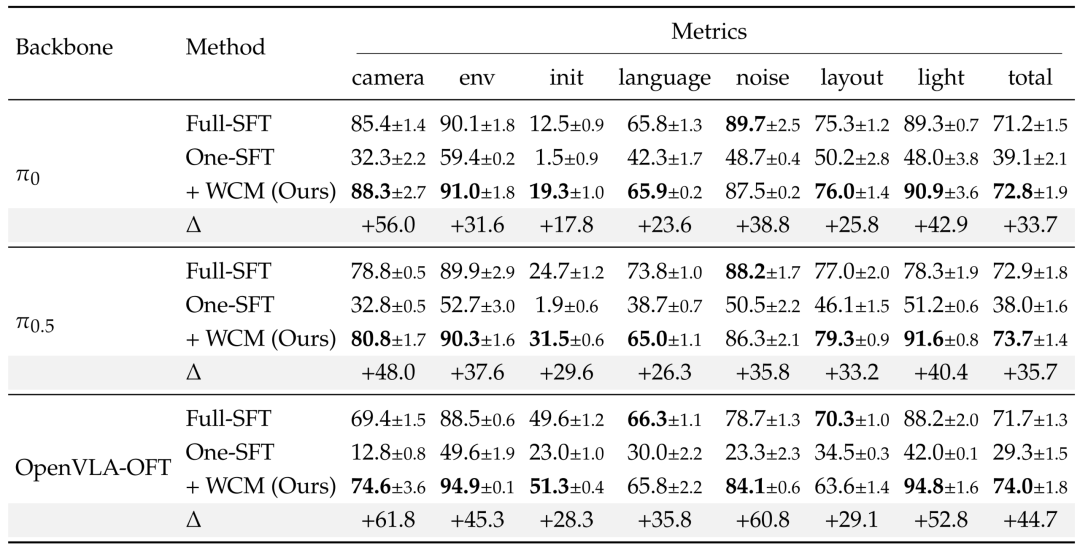
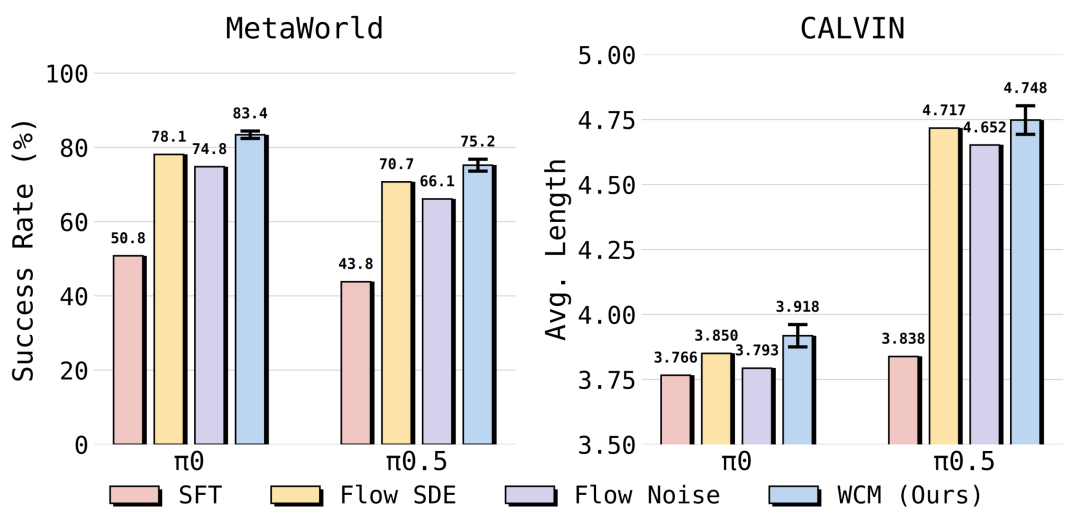
在RL4VLA设置的ManiSkill任务上,WCM在分布内(IND)和分布外(OOD)均取得SOTA结果。零样本设定下,WCM将初始成功率0.78%的模型提升至98.7%,提升97.9个百分点,验证了卓越的泛化能力。在LIBERO-Plus基准上,基于One-SFT(每任务1条示范)的WCM仅需约250步RL微调,即可超越Full-SFT(每任务50条示范)的基线,表明当Critic能准确理解动态时,失败数据也能成为宝贵的学习信号。在MetaWorld和CALVIN上,WCM同样提升了持续接触和长程操作的表现。
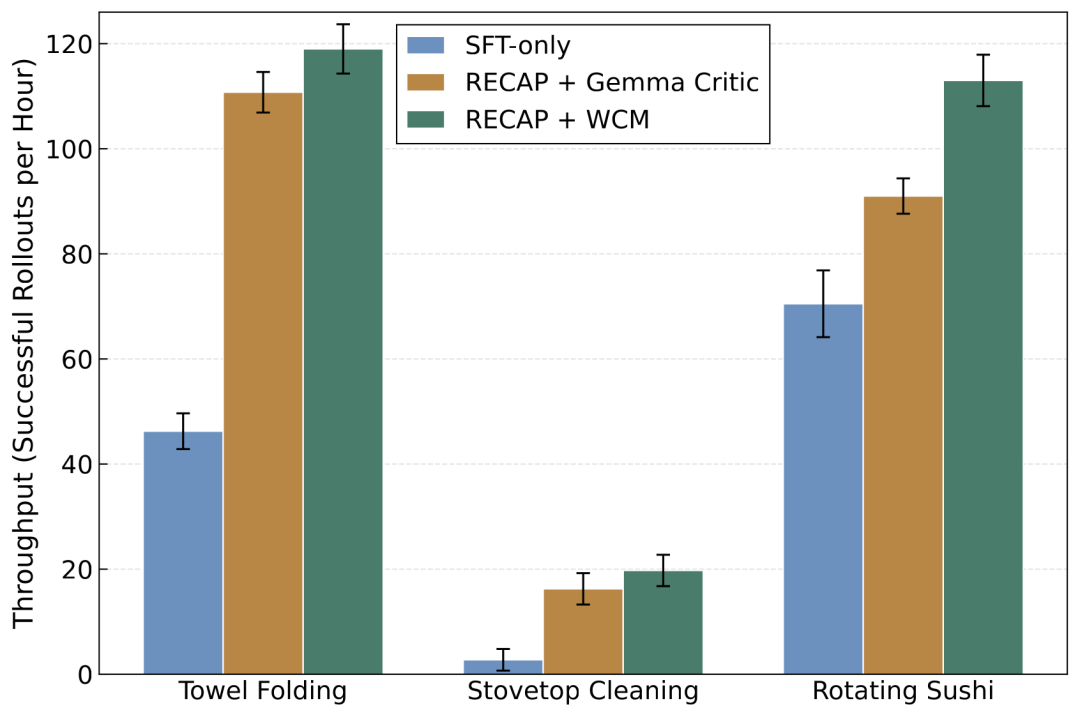
真机实验中,团队在WidowX-250S上测试了7个任务,包括抓取放置、叠衣服、灶台整理和动态抓取旋转寿司。每任务采集100条遥操作轨迹,进行8轮RL更新,每轮收集50条Rollout。结果显示,WCM相比VLM Critic取得了更好的性能,且训练出的Policy动作更连贯,停顿和无效小动作更少,单位时间吞吐量更高。WCM的可训练参数约107.2M,在数百到数千条轨迹的数据规模下,可在半小时内完成快速迭代。
六、价值曲线可视化:直观理解动态评价
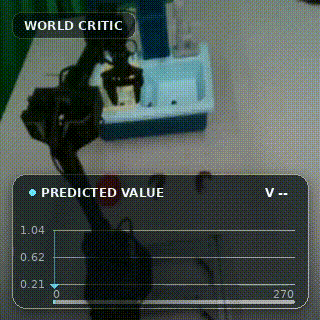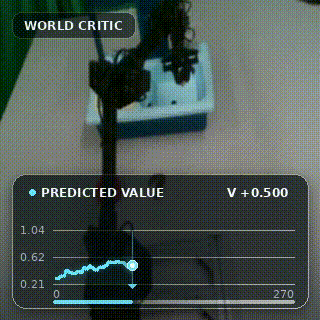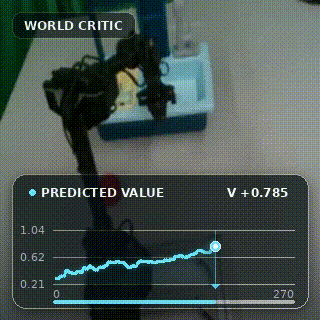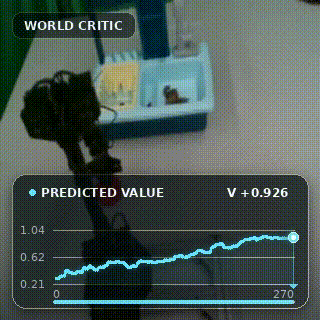
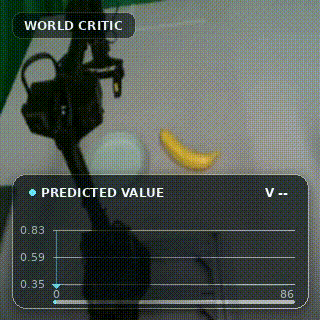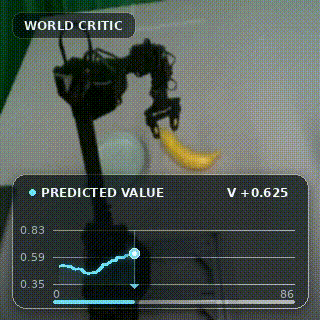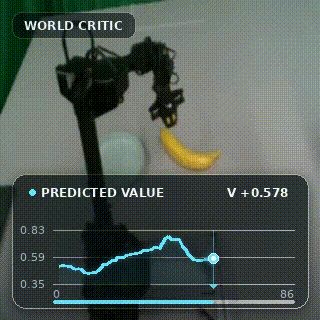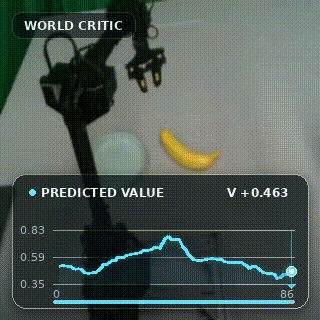
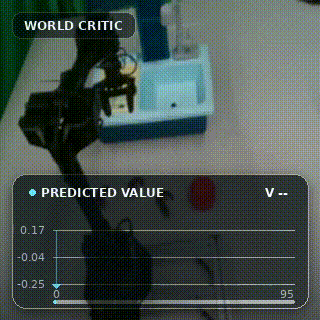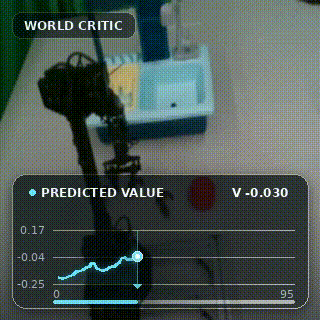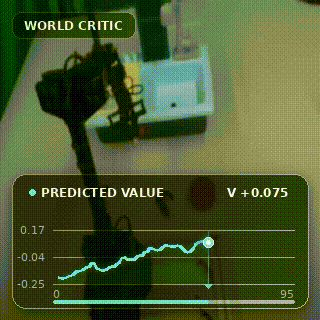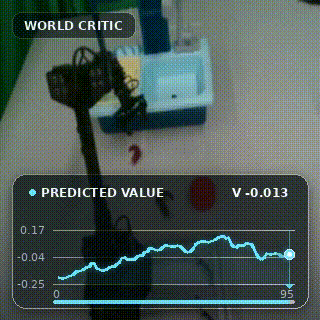
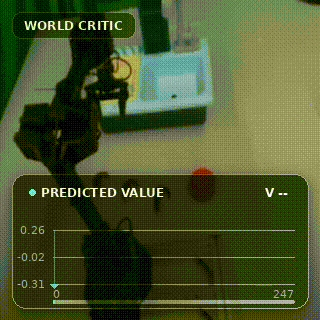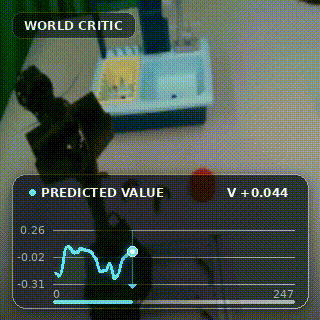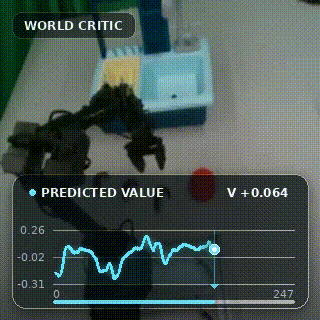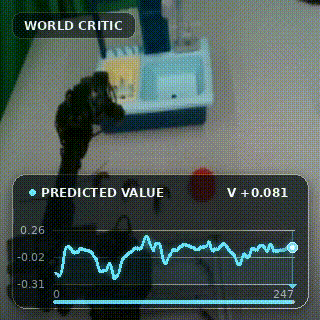
WCM仓库提供了价值曲线视频生成工具,将模型预测的价值叠加到真实轨迹上,直观展示其对动作进展的评价。对于成功轨迹,价值随任务推进整体上升;对于失败轨迹,从失败时刻起价值快速下降;对于无效轨迹,随机运动没有形成稳定趋势。这表明WCM学到的并非简单的终点分类器,而是能够反映过程变化的连续评价信号,对暂停、滑移、碰撞等事件敏感。
七、开源资源与未来展望
WCM的代码、数据、权重全部开源,提供了数据处理脚本、训练配置、模型权重以及价值曲线可视化工具,适合作为新的可复现基线。对于研究VLA、机器人强化学习、Critic Model或真机后训练的开发者,WCM提供了一个强大的工具。当机器人不再只看“这一帧”,它才更有可能理解自己正在走向哪里。未来,WCM有望在更复杂的任务和更广泛的应用中发挥潜力,推动机器人学习迈向新的高度。