Agentic RL训练提速3倍:Libra如何让GPU资源动态流动
从“回答问题”到“完成任务”:Agentic RL带来的新挑战
大语言模型的能力边界正在从被动应答转向主动行动。在Agentic RL后训练中,模型不再只是生成文本,而是会调用搜索、代码执行等外部工具,根据环境反馈继续推理。这种交互式训练让模型拥有了更强的行动能力,但也让训练系统面临一种比普通RLHF更不稳定的工作负载:同一批请求可能产生长度相差数十倍的轨迹,少量超长轨迹拖慢整个rollout;与此同时,训练和rollout对GPU的需求还会随着策略演化不断变化。
传统RL后训练通常包含轨迹生成、轨迹评估和策略更新三个步骤。评估阶段相对轻量,系统效率主要取决于rollout能多快产生轨迹,以及training能多快吸收这些轨迹并更新策略。在传统推理中,请求长度通常与输入提示具有较强相关性,但在Agentic RL中,轨迹长度会被运行时事件改变。例如,搜索工具可能返回大段内容,代码执行可能失败并触发多轮修复,模型也可能根据环境反馈扩展后续推理。因此,轨迹最终长度在生成前很难可靠预测。
研究团队在R2E-Gym上观察到,最长的10%轨迹占据了超过50%的rollout时间。更重要的是,这种分布并不稳定:随着策略在训练中逐渐改变,模型的工具使用方式和推理长度也会发生漂移。这种漂移会放大rollout与training的结构性差异。实验显示,当序列长度从1K增长到32K token时,rollout延迟增长了95倍,而训练时间仅增长3.9倍。原因在于rollout需要自回归解码,对序列长度和KV cache更敏感;训练则可以通过batching摊薄长度变化带来的影响。
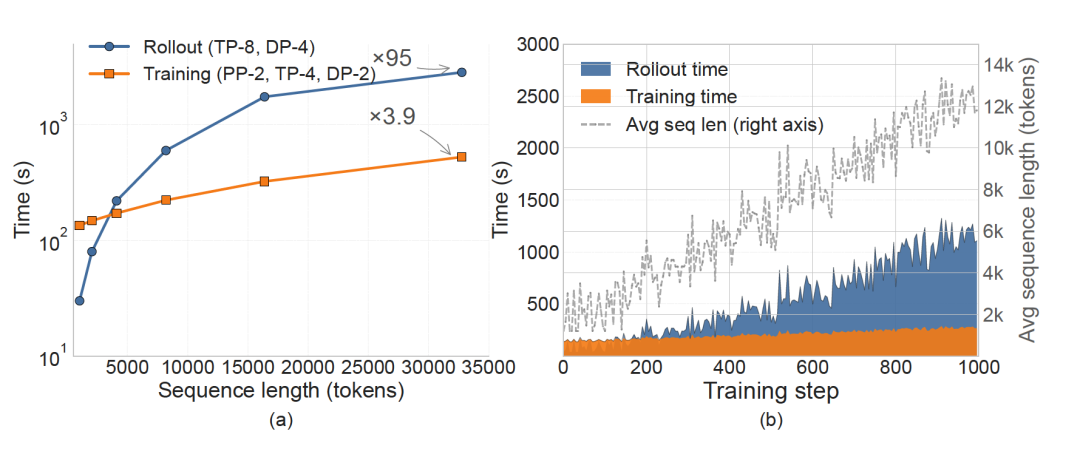
这意味着,一个在训练初期合理的静态GPU切分,可能在数百步之后变得严重失衡。如果rollout变慢,训练GPU会等待新数据;如果训练变慢,rollout产生的轨迹又会在队列中积压。端到端迭代时间实际上由二者中更慢的一方决定:T_iter = max(T_rollout, T_train)。因此,问题不能只靠“继续优化rollout”解决,而需要从全局视角动态寻找训练与rollout的平衡点。
Libra系统:将训练与rollout视为耦合系统
针对上述问题,来自香港中文大学和香港恒生大学的研究团队提出了Libra,一个面向Agentic RL Post-Training的资源管理系统。Libra不再把rollout视作固定瓶颈,而是将训练与rollout作为一个耦合系统统一优化,并通过异构推理集群、因果感知调度和弹性资源切换,让有限GPU资源随着实时工作负载动态流动。
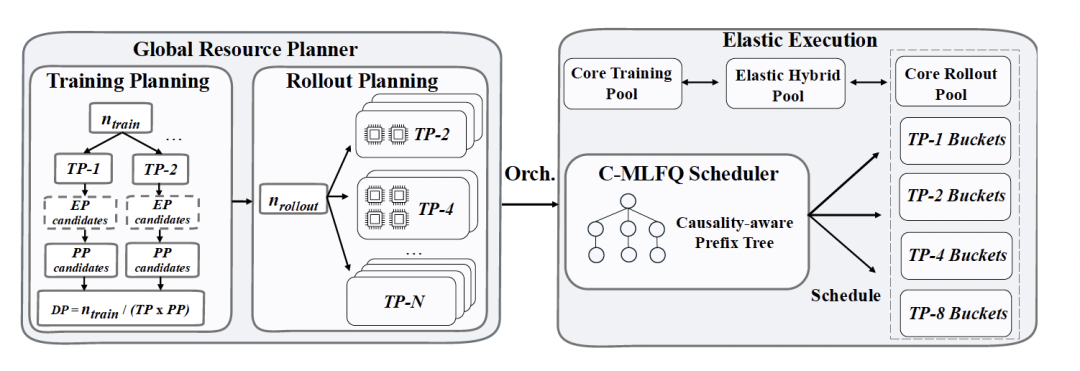
Libra的核心设计包括三个部分:全局资源规划器(Global Resource Planner)、弹性混合池(Elastic Hybrid Pool)和因果感知调度器(C-MLFQ)。这些组件协同工作,使得系统能够在训练过程中动态调整资源配置,以应对轨迹分布的变化。
全局资源规划器:动态寻找训练与rollout的平衡点
全局资源规划器是Libra的第一项核心设计。在固定GPU预算下,它联合搜索:多少GPU分配给训练,多少分配给rollout;训练侧采用怎样的TP、PP、DP,以及MoE模型的EP组合;rollout侧应当部署多少个TP-1、TP-2、TP-4或TP-8推理实例;当前配置的训练时间、rollout时间和最终迭代makespan。
训练侧使用拓扑感知的决策树枚举可行并行策略,并根据显存、通信开销和pipeline bubble等约束提前剪枝。rollout侧则把请求按历史长度排序,用动态规划寻找异构TP实例和请求区间之间的最优分配。底层Cost Evaluator同时建模两侧的执行时间,让规划器能够比较不同全局配置。
规划并不是只在启动时运行一次。Libra会周期性读取最新轨迹统计,重新求解资源配置;只有当预计收益超过重配置成本时,才真正触发资源移动。这样既能追踪workload drift,也能避免频繁切换带来的抖动。
弹性混合池:不重建核心通信组也能移动算力
“算出新配置”并不等于“能够低成本执行新配置”。传统分布式训练中,加入或移除训练worker往往意味着重建通信组并重新分发状态,频繁操作代价过高。Libra将资源划分为三个池:Core Training Pool(保持固定的训练拓扑)、Core Rollout Pool(承担稳定的异构轨迹生成)和Elastic Hybrid Pool(根据瓶颈在rollout与training模式间切换)。
其关键原则是保持核心训练拓扑不变。Hybrid worker以完整的数据并行副本形式加入,不改变核心TP/PP结构。系统进一步把副本内部的NCCL通信与副本之间的梯度交换解耦,成员变化只发生在独立的跨副本通信域。当rollout worker重新加入训练时,它会异步获取最新模型和优化器快照。恢复期间,核心训练仍然继续推进;加入中的worker通过侧通道发送零梯度占位,使核心All-Reduce与“该worker尚未加入”时在数学上保持等价。状态对齐后,它再从下一步开始贡献真实梯度。
C-MLFQ:不预测最终长度,而在工具返回时做因果路由
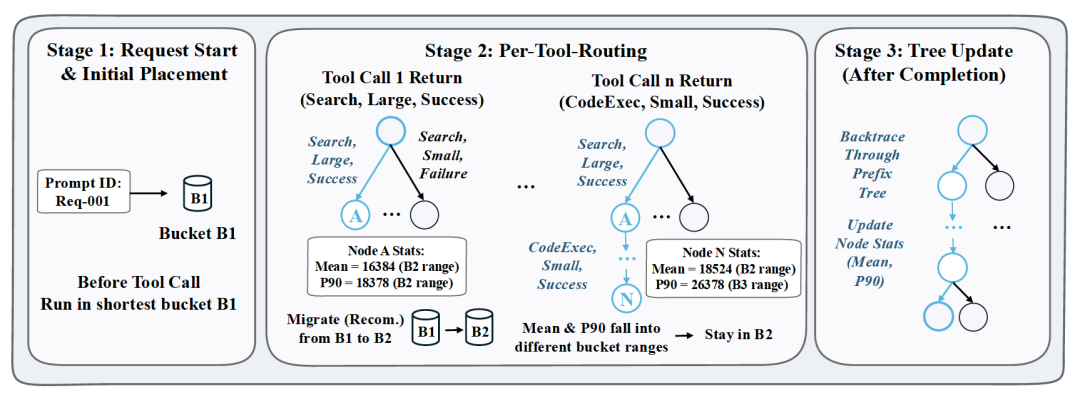
Libra的第二项核心设计是C-MLFQ(Causality-Driven Multi-Level Feedback Queue)。传统长度预测方法试图在请求开始时猜测最终长度,但Agentic RL的关键变化往往发生在中途。Libra的观察是:工具返回大小、成功或失败状态并非普通相关特征,而是后续轨迹扩展的直接因果信号。例如,大payload会立刻增加上下文,工具失败则可能触发重试、诊断和代码修改。
C-MLFQ用历史轨迹建立一棵因果感知前缀树。树节点由prompt ID和此前所有工具返回状态的有序序列确定,并保存从当前节点到轨迹结束的剩余长度分布。运行时流程分为三步:请求开始时先进入适合短序列的小TP bucket;每次工具返回后,根据工具类型、payload大小和执行状态查询前缀树;只有当剩余长度的均值与P90指向同一bucket时才迁移,否则继续留在当前bucket;轨迹结束后再离线更新树。
这种设计避免了额外模型推理,也不需要随着策略变化反复训练长度预测器。相比传统MLFQ等到长度越界后逐级迁移,C-MLFQ可以在工具返回后更早做出一次性决策。在Search-R1上,C-MLFQ的单次路由准确率达到91.1%,明显高于基于embedding的长度预测方法(65.2%)和传统MLFQ(44.8%);与此同时,其迁移token比例只有8.2%,系统吞吐达到2700 token/s。
端到端实验:48张A800上的性能表现
团队在6个节点、共48张NVIDIA A800-SXM4-80GB GPU上进行实验。节点内使用NVLink/NVSwitch,节点间使用支持GPUDirect RDMA的200 Gb/s RoCE网络。实验采用GRPO,最大模型长度为40960 token,每个prompt采样16条轨迹。
工作负载覆盖三个差异明显的Agentic RL场景:Search-R1(模型需要多轮生成搜索查询并利用外部知识)、R2E-Gym(软件工程Agent操作真实代码仓库并调用Bash、Python等工具)和DAPO-Math-17K(包含17K道竞赛级数学问题)。对比方法包括verl-Colocated、verl-Static-Uniform、verl-Greedy-Heuristic,以及基于初始workload选出最优静态配置的AReaL-Static-Optimal。
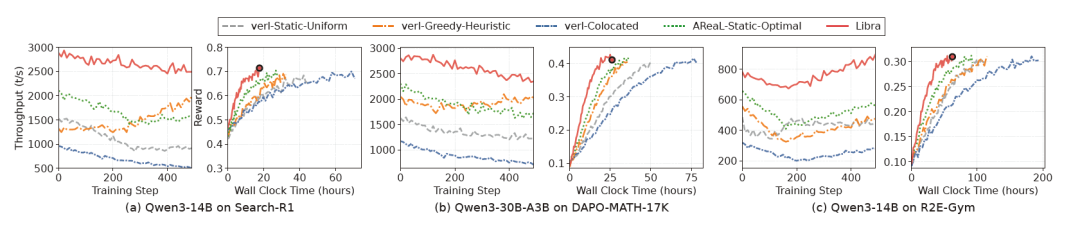
在Search-R1上,Libra的平均吞吐约为2700 token/s,相比AReaL-Static-Optimal提升约63%,相比verl-Greedy-Heuristic提升80%,相比verl-Colocated提升300%。在DAPO-Math-17K和R2E-Gym上,Libra同样保持最高吞吐。由于各方法训练同一模型并执行相同步数,它们最终达到的奖励相近,区别主要是wall-clock time。Libra在Search-R1、DAPO-Math-17K和R2E-Gym上分别用17.9、26.7和63.2小时完成训练,达到目标奖励的速度最高提升2.5倍。
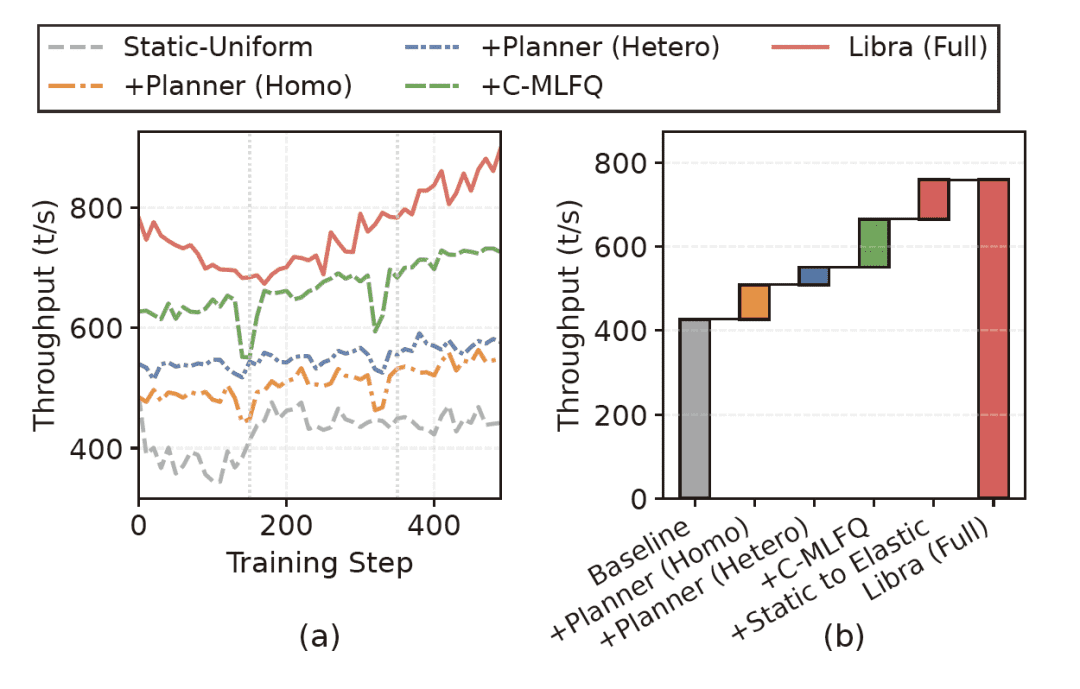
消融实验进一步说明了各模块的作用。在R2E-Gym上,Static-Uniform基线吞吐为423 token/s;加入同构资源规划后提高到510 token/s,异构TP再带来41 token/s,C-MLFQ增加115 token/s,最终弹性执行继续增加97 token/s,使完整Libra达到763 token/s,总体提升约80.4%。
系统实现与开源
Libra包含约1.3万行Python和C++/CUDA代码,核心RL训练循环基于verl,生成侧使用vLLM,训练侧使用Megatron-LM。开源仓库提供了Slurm与非Slurm Quick Start、数据准备、配置参考、可观测性说明及实验脚本。
Libra的核心观点是:在Agentic RL中,rollout并不是永恒不变的系统瓶颈。随着策略和轨迹分布演化,真正的瓶颈会在训练与rollout之间移动。只有同时解决跨阶段资源分配、阶段内部异构执行以及低成本资源切换,系统才能在长期训练过程中持续接近最优状态。
作者与团队
作者团队由陈凯文、谭昕、李敬宗和徐宏组成,来自香港中文大学与香港恒生大学,长期从事AI基础设施、机器学习系统、资源调度、大模型推理、分布式训练及计算机网络研究。第一作者陈凯文为香港中文大学博士生,团队成员成果发表于SIGCOMM、ASPLOS、NSDI、ICML等国际会议。