持续学习大模型:2025年五大技术路线深度解析
持续学习:大模型的下一个战场
2025年,人工智能领域最炙手可热的概念之一,非“持续学习”莫属。从Andrej Karpathy在播客中直言当前大模型“没有持续学习”,到各大研究机构和创业公司纷纷押注这一方向,持续学习正从学术圈的边缘议题,迅速演变为产业界竞相布局的战略高地。
所谓持续学习,指的是模型在完成初始训练并部署之后,仍能像人类一样,从新任务、新数据、新交互中不断吸收知识,同时保持对旧有技能的熟练掌握。这听起来理所当然,但实现起来却异常艰难,其核心障碍便是“灾难性遗忘”——神经网络在习得新知识时,往往会覆盖掉承载旧知识的参数,导致模型在旧任务上的性能急剧下降。
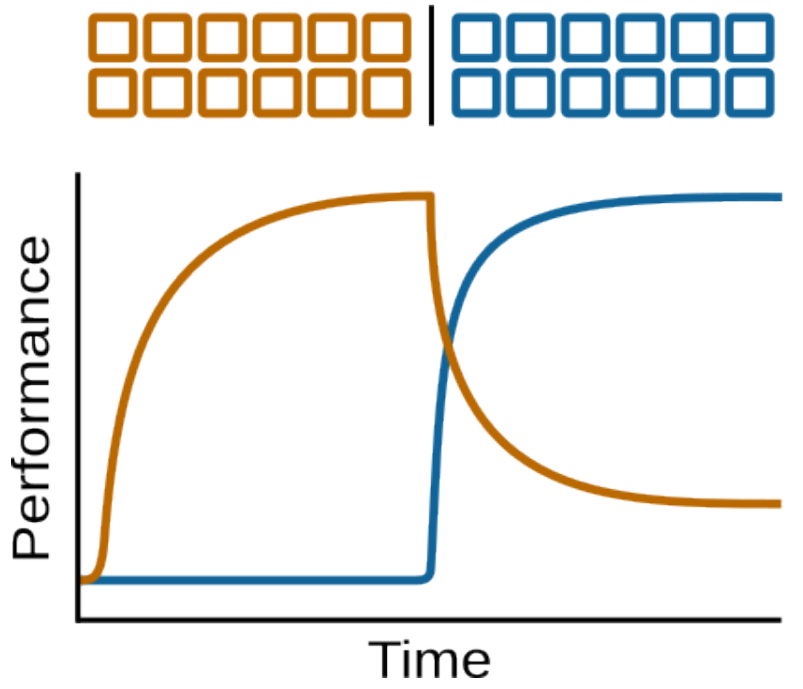
这一挑战在大型语言模型(LLM)身上表现得尤为突出。TRACE基准测试表明,对已对齐的模型进行连续微调,不仅会遗忘旧任务,还会损害模型的通用能力和指令跟随能力。换句话说,教会模型一件新事,可能让它整体“变笨”。
面对这一难题,学术界和产业界在2025年分化出了多条截然不同的技术路线。它们的分歧点,归根结底在于两个问题:是否修改模型权重?新知识存储在哪里?本文将逐一剖析这些路线,揭示它们各自的赌注与瓶颈。
路线一:外挂记忆——把知识放在模型之外
最直接、也最快落地的思路,是彻底回避权重修改,将新知识存储在模型外部的数据库中,需要时再检索回上下文。这条路线从检索增强生成(RAG)演化而来,如今已发展为一个专门领域:智能体记忆(Agent Memory)。
代表性工作MemGPT(其公司现已更名Letta)将LLM的上下文管理类比为操作系统的内存管理,区分出有限的“工作上下文”和更大的“外部存储”,让模型像操作系统调度内存一样,自主决定哪些信息调入上下文,哪些写回归档。
沿着这一思路,多个系统各具特色:Mem0主打生产级、可规模化的长期记忆存取;Zep在检索之上加入时序知识图谱,以处理跨会话的时间推理;A-MEM借鉴卡片盒笔记法,为每条记忆打上结构化标签并自动关联相关旧条目,使检索更贴合上下文。
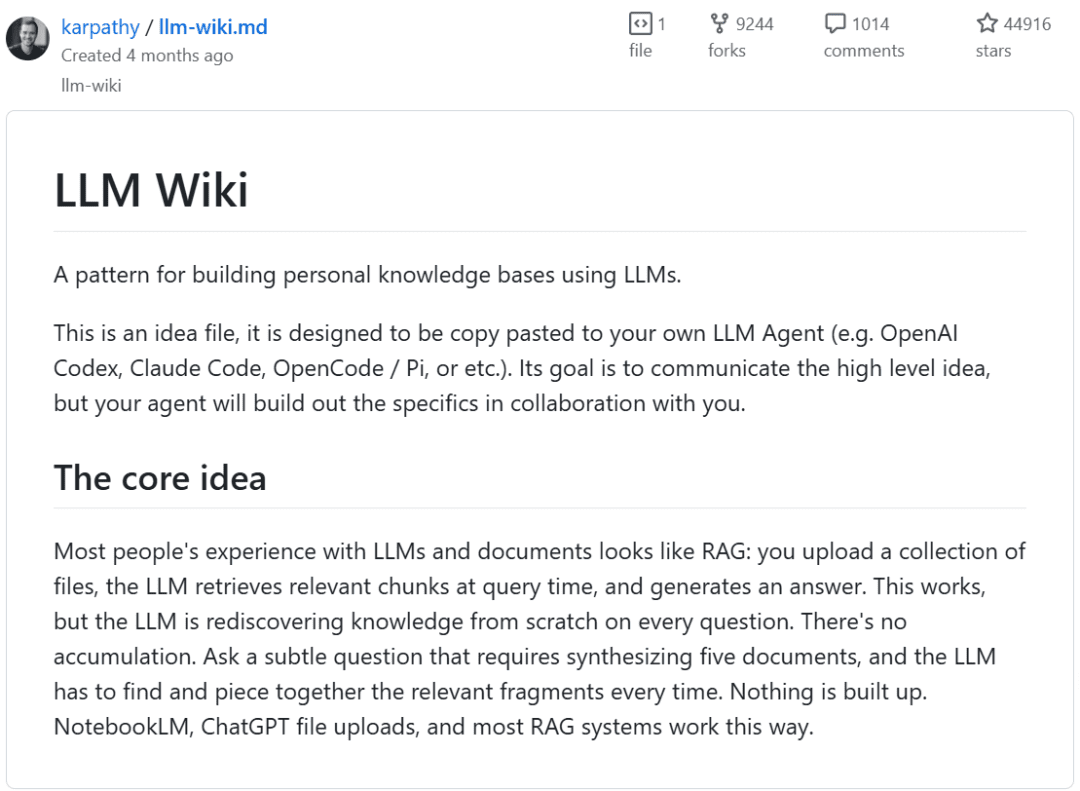
Karpathy本人也押注这一方向。他反复强调,未来需要的不是“更大的硬盘”式记忆,而是一个精简的“认知内核”(他估计一两B参数就够)外加一套会自我复利增长的结构化外部记忆。基于此,他在GitHub上发布了“LLM Wiki”模式:智能体主动将资料编纂成持续更新、互相链接的知识库,之后再去查询它。该文档已收获近4.5万star。
Letta则将此上升为“token空间里的持续学习”命题。他们指出,当前默认的“先追加、再摘要”做法存在两个问题:追加将所有表征工作推到推理时,每次前向传播都要重新处理原始日志;摘要则是有损且突兀的,重要细节可能毫无预警地消失。Letta的赌注是,未来在token空间中学到的记忆,会比模型权重本身更有价值。
外挂记忆的优势在于安全、可控、可解释,改错了随时能删。但其短板同样明显:它并未真正将知识“内化”进模型,每次都要依赖检索和上下文这道窄门,一旦记忆库膨胀,检索精度和成本都会成为瓶颈。
路线二:上下文工程——让上下文自我进化
从外挂记忆再进一步,是一类更精巧的思路:不改权重,但让模型输入的上下文本身持续进化。这被称为上下文工程(Context Engineering)。
2025年10月,斯坦福、SambaNova和UC伯克利提出的ACE(Agentic Context Engineering)是其中的代表。它把上下文当作一本会不断成长的“攻略手册”,通过三个分工角色来维护:Generator负责生成推理轨迹,Reflector从成功和失败中提炼具体经验,Curator将这些经验整理成结构化的增量更新,合并进手册。
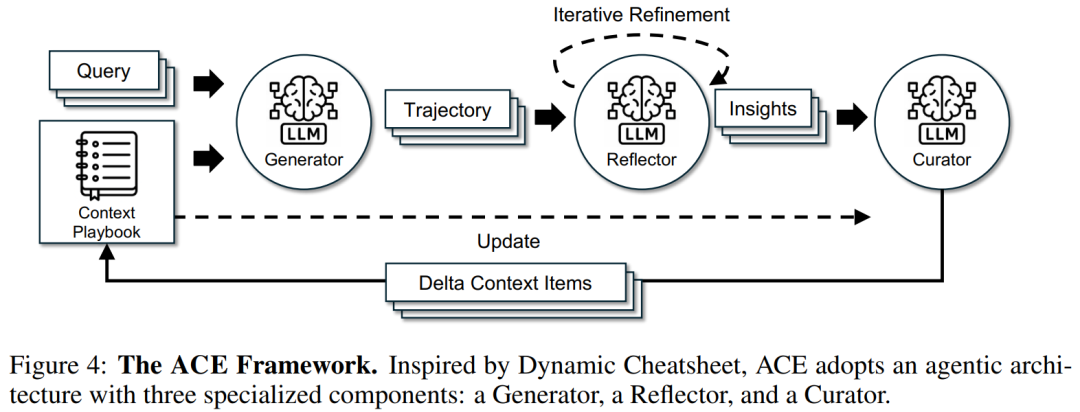
ACE旨在解决同类方法的两个通病:一是“简洁偏好”,即让LLM反复重写上下文时,它倾向于压缩、丢掉领域细节;二是“上下文坍缩”,即反复重写会导致细节逐渐流失。ACE采用增量式的小改动(delta updates)而非整段重写来规避这两点。据论文数据,ACE在智能体任务上相比基线提升10.6%,金融推理上提升8.6%,同时将适配延迟降低约86.9%;在AppWorld榜单上,用较小的开源模型DeepSeek-V3.1配上ACE,平均分能追平基于GPT-4.1的生产级智能体IBM CUGA。
值得注意的是,ACE强调它能在没有标注监督的情况下工作,它依靠执行过程中天然产生的反馈信号(如代码跑通还是报错)来指导反思和整理。这让它和“智能体从自己的经验中学习”这一更大的叙事接上了头。
路线三:持续后训练——改权重,但要改得聪明
外挂记忆和上下文工程回避了改权重的风险,但也回避了真正的知识内化。另一派研究者认为,长期来看,有些知识和技能终究得写进参数里才够用。这就是持续后训练(Continual Post-training),主要分为持续指令微调、持续偏好对齐等阶段。
Thinking Machines的John Schulman给出过一个分层的看法:他将学习类比为心理学中的运动学习、情景记忆和程序性记忆,认为上下文学习会继续处理好短程的学习任务,而参数微调(包括LoRA这类方法)会叠在上面,尤其适合那些需要较大容量、要真正吸收知识的任务——时间跨度一长,上下文学习不够用时,参数微调就赢了。
这条路线最大的敌人依然是灾难性遗忘,而近期一个有意思的解法来自Thinking Machines的Tinker。Tinker是他们2025年10月发布的第一款产品,一个基于LoRA的微调API,将分布式训练的复杂度抽象掉,只暴露forward_backward、optim_step这类底层原语,让研究者专注于数据和算法。
在持续学习上,他们主推一套叫自蒸馏微调(SDFT)的配方:核心洞察是,普通的监督微调是“离策略”的,模型被迫去模仿一些它自己根本不会生成的token,于是每学一个新技能都会侵蚀旧能力;SDFT让模型充当自己的老师,从示范中学新技能而不忘旧的。一家叫Trajectory的创业公司已经把Tinker当作其持续学习平台的核心基础设施。
顺带一提,Tinker用LoRA而非全量微调,还有个务实的好处:多个微调任务可以共享同一个算力池,成本被摊薄。这也解释了为什么“持续学习即服务”正在成为一门生意:把频繁的模型更新变成一个可以按需调用的API,正是产业界当下的尝试方向。
路线四:持续预训练——回到最底层
如果说后训练是在模型的“表层”动刀,那么持续预训练(Continual Pre-training, CPT)就是回到最底层,用新的语料继续预训练模型,让它适应新的领域、新的语言或随时间漂移的知识分布。相比将新旧数据混在一起从头重训一遍,CPT建立在已有模型的基础上,算力上要划算得多。
它的典型用武之地有三种:知识随时间漂移、跨语言扩展、跨领域适配。但代价同样明确:多项实证研究反复表明,持续预训练计算成本高昂,且容易引发对已学知识的灾难性遗忘。也因此,学界一直在找“免重放、免任务标注”的持续预训练方法,试图在LLM规模上做到不遗忘。
对绝大多数公司而言,从头重新预训练一个前沿模型的成本高到不现实,这正是Karpathy那句“大模型不适合频繁重训”的由来。所以严格意义上的“重新预训练”更多是前沿实验室内部的选项,而持续预训练则是一个更可行的折中。
路线五:自我修改——重新定义学习
前面四个方向,多少还是在“外挂 vs 改权重”的二元框架里打转。而最近一年冒出的一批新工作,试图跳出这个框架,重新定义“学习”本身。
一条思路是让模型自己生成训练数据、自己决定怎么更新自己。MIT的SEAL(Self-Adapting Language Models)就是典型。给定一个新输入,模型会生成一段“自我编辑”(self-edit);这是一段自然语言指令,说明了该怎么重构信息、用什么超参数去更新权重,甚至调用什么工具来做数据增强;然后模型据此微调自己,形成持久的权重更新。而“怎样的自我编辑才有效”这件事,由一个外层强化学习循环来训练,奖励信号就是更新后模型在下游任务上的表现。
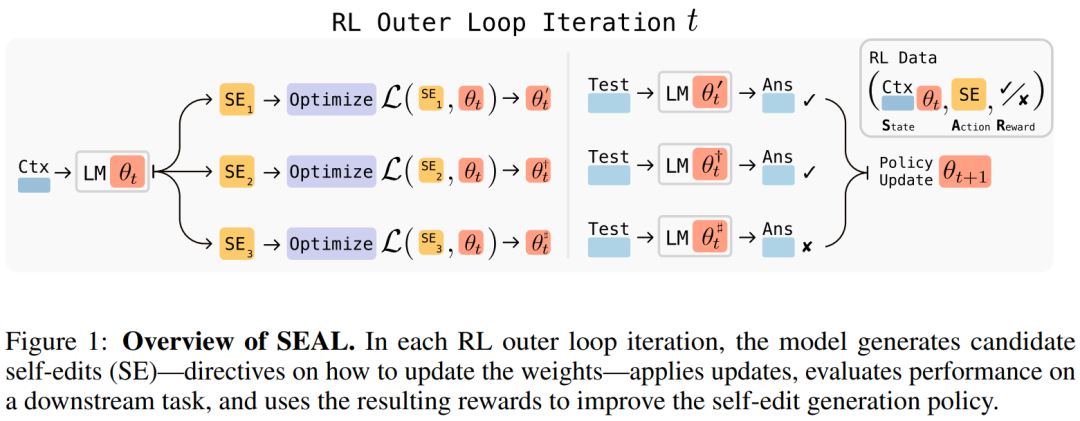
NeurIPS 2025版本进一步证明了这套自适应能力会随模型规模变大而增强,并借助强化学习缓解了遗忘。它的作者展望的是一种能在推理中途自己判断“要不要现在学一下”的模型,把一次性的思维链蒸馏成永久的能力。
另一条更激进的思路来自Google的嵌套学习(Nested Learning),发表于NeurIPS 2025。它的核心是把一个模型重新理解成一组彼此嵌套、多层次、各自带着不同“上下文流”和不同更新频率的优化问题——架构和优化算法在这个视角下被统一成了同一件事的不同层级。
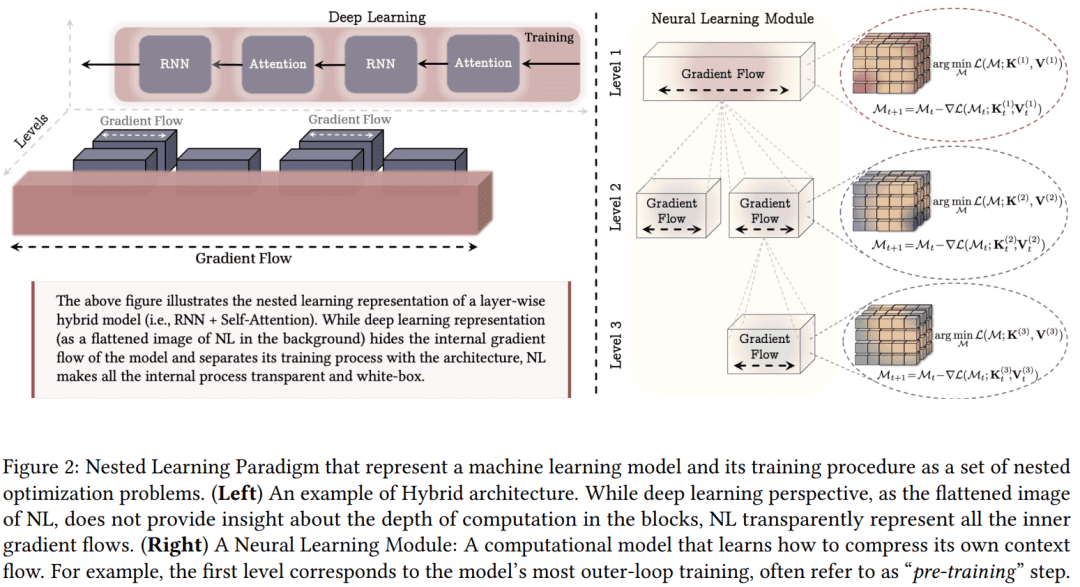
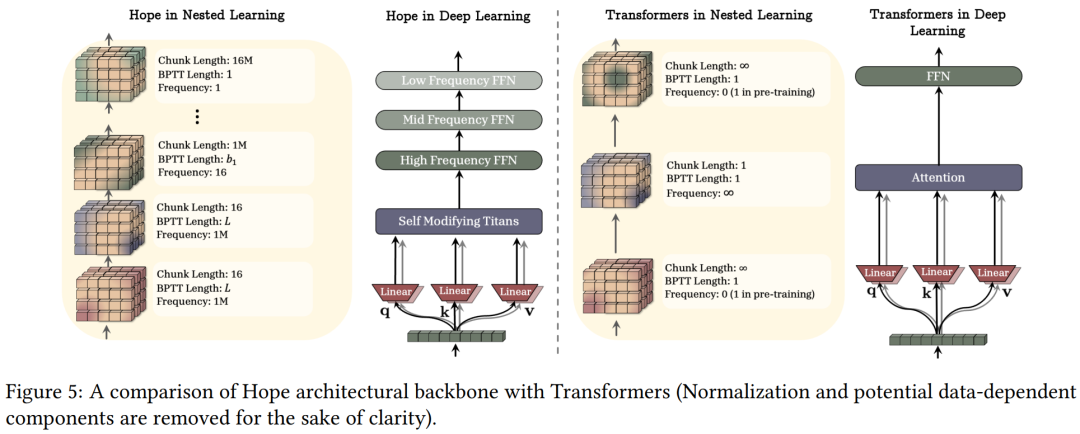
作为概念验证,他们做了一个叫Hope的自我修改架构,它在Titans长期记忆架构基础上做了两点扩展:无上限的嵌套学习层级,以及一套“连续记忆系统”(CMS)。简单来说,不再只是短期/长期记忆的二分,而是一整个跨时间尺度更新的记忆模块谱系。
实验里Hope在语言建模、长上下文推理和持续学习任务上都优于标准Transformer和现代循环模型。有意思的是,还有后续工作给这类架构引入了“睡眠”阶段——像人类在睡眠中巩固记忆那样,让模型在活跃会话之间抽出算力,把有用的抽象蒸馏进更持久的参数记忆。
再往上抽象,是David Silver和Richard Sutton提出的“经验时代”(Era of Experience)叙事。他们的判断是:在数学、代码、科学这些关键领域,从人类数据里能榨取的知识正在逼近上限,要继续往前,得让AI从自己与环境交互产生的经验中持续学习,形成一个自我供给数据的闭环。他们把2024年DeepMind的AlphaProof(通过“与形式化证明系统的持续交互”拿到IMO奖牌)视作这个时代的开端。这条叙事把持续学习和强化学习、智能体自主探索绑到了一起,也埋下了一个尚未解决的问题:谁来设计那些把原始信号变成有用指引的奖励函数。
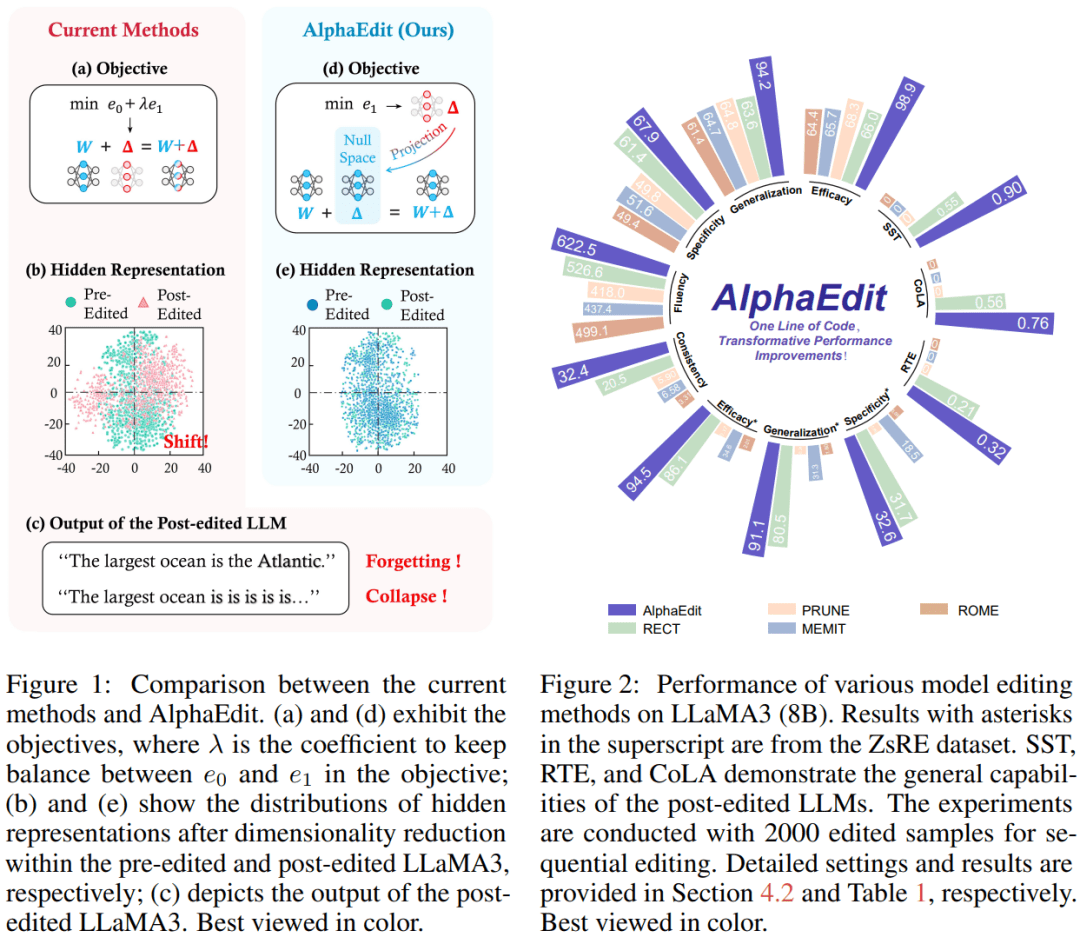
此外还有一个容易和持续学习混淆、但目标不同的邻近方向:知识编辑(Knowledge Editing)。以ROME、MEMIT为代表,它通过定位并修改存储特定事实的MLP层,做到精准的单条或批量事实更新,而无需全量重训。但它和持续学习的目标其实不一样——知识编辑追求的是精确覆盖某个事实,在连续、终身编辑的场景下,反复的参数改动会互相干扰、逐渐累积“毒性”导致模型坍缩,这也催生了WISE、AlphaEdit等一批专门应对序列化编辑的方法。
各路线对比与未来展望
把这几个方向摊在一起看,会发现它们其实是沿着一根“知识存在哪里”的轴线排开的。
最外侧是外挂记忆和上下文工程,知识完全存在模型之外的token空间里,安全可控但没有真正内化;中间是持续后训练和持续预训练,知识被写进权重,能力上限更高但要直面灾难性遗忘;最里侧、也最前沿的,是让模型自我修改、自我进化的那批新思路,试图让“学习”这个动作本身变成模型能力的一部分。
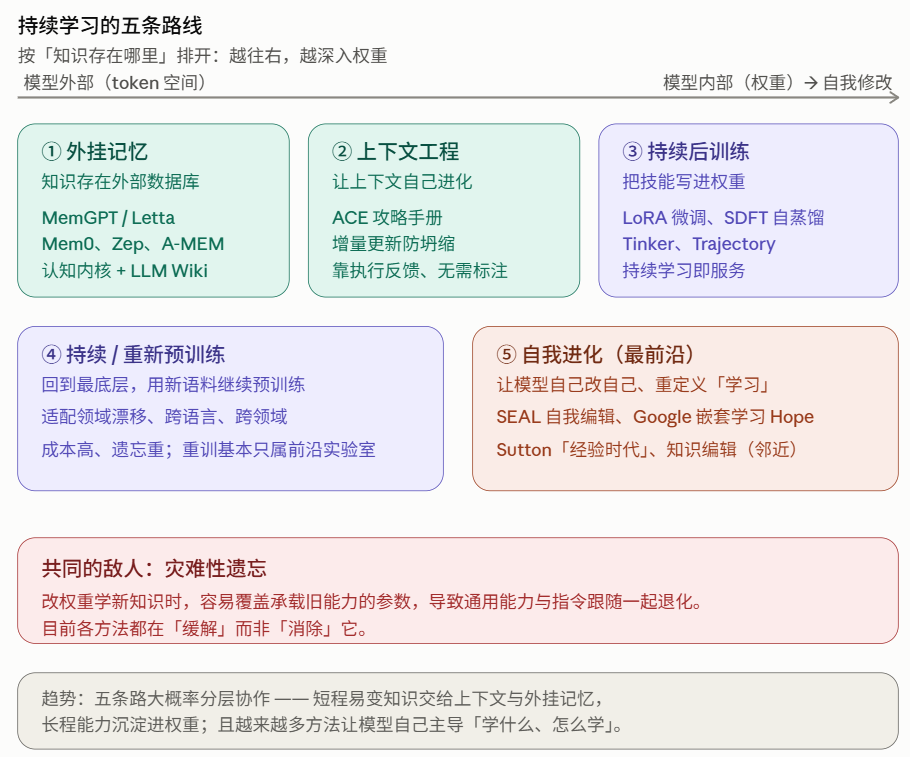
一个务实的观察是:这些方向大概率不是互斥的,而是会分层协作。Schulman的分层学习观、Karpathy的“认知内核+外部记忆”构想,本质上都在说同一件事:短程、易变的知识交给上下文和外挂记忆,长程、需要沉淀的能力交给参数微调,各司其职。ACE能在无监督下靠执行反馈进化、SEAL用强化学习去优化自我编辑,则都在暗示一个共同的趋势:未来的持续学习,很可能是让模型自己来主导“学什么、怎么学”。
那么回到Karpathy那个“还要十年”的判断,持续学习到底解决了没有?答案恐怕是——还没有,但已经不再是一片空白。灾难性遗忘这个核心障碍至今没有被彻底攻克,SDFT、嵌套学习这些方法都还是在“缓解”而非“消除”它。纯靠更好的上下文管理加微调能不能解决持续学习,还是需要全新的想法?这个更根本的问题连Schulman自己都坦承尚无定论。
可以确定的是,2025到2026这段时间,持续学习从一个被反复念叨的“缺失能力”,变成了一个真正岔出多条路线、且开始有创业公司下场做产品的活跃战场。哪条路能率先把“AI同事”从原型变成现实,值得接着盯下去。