TBSM:三体散射实现一步生成,图像生成效率的颠覆性突破
从多步到一步:生成模型的效率革命
在生成式AI的快速发展中,扩散模型(Diffusion Models)凭借其卓越的生成质量,已成为图像、视频和音频生成的主流范式。然而,其迭代式去噪过程需要多次前向推理,导致推理成本高昂,严重制约了实时应用和边缘部署。为了突破这一瓶颈,研究者们探索了多种加速策略,如减少采样步数、使用蒸馏技术等,但往往以牺牲生成质量或增加训练复杂度为代价。
近期,一项名为“三体散射生成建模”(Three-Body Scattering for Generative Modeling, TBSM)的研究,为一步生成提供了全新的解决方案。该方法受物理学中三体散射现象的启发,通过在线训练一个轻量级Tracker网络,学习从当前生成分布到真实分布的转移场,从而引导生成器在单次前向中直接输出高质量样本。TBSM在ImageNet-256上取得了FID 1.63的惊人成绩,并成功应用于20B参数文生图模型,展示了其强大的泛化能力和实用价值。
现有加速方法的局限
在TBSM之前,研究者们已提出多种加速生成模型采样的方法,但各有其结构性取舍。
自回归模型(Autoregressive Models)虽然扩展性强,但需要按顺序解码,难以并行化,推理时间随序列长度线性增长。扩散模型和流匹配(Flow Matching)沿噪声-数据路径反复调用网络,虽然生成质量高,但采样步数通常需要数十甚至上百步。
生成对抗网络(GAN)天然支持单次前向推理,但其训练依赖同步优化的判别器,极小极大优化过程敏感,容易发生模式崩溃和不收敛。
一致性模型(Consistency Models)和分布匹配蒸馏(Distribution Matching Distillation, DMD)通过蒸馏教师模型或引入辅助估计器来压缩采样步数,但通常需要复杂的噪声-时间监督、一致性约束或额外的教师网络,且扩展到大规模模型时稳定性难以保证。
Drifting Models等分布动力学方法绕开传统蒸馏,但监督信号来自批级分布场或统计量,需要同一条件下提供多张真实样本,不适用于“一条描述配一张图”的文生图数据。
TBSM并非要否定这些方法,而是提出一种更直接的思路:训练一个小模型,直接告诉每个生成样本“该往哪里走”。
TBSM核心思想:Fake-to-Real转移场
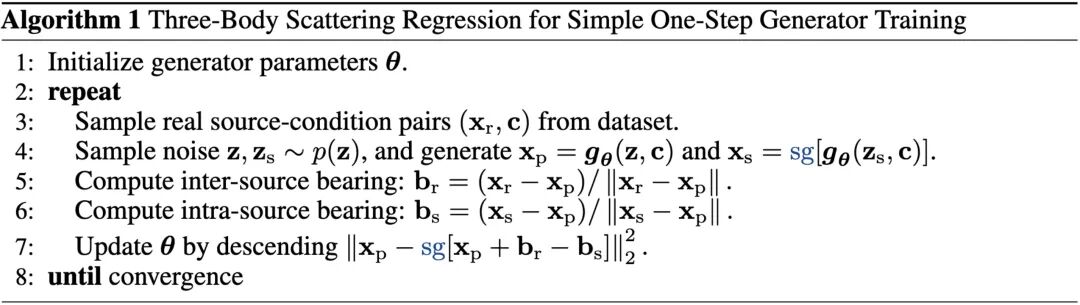
TBSM的核心是学习一个从当前生成分布到真实分布的转移场(Fake-to-Real Transfer Field)。具体而言,它在线训练一个轻量级Tracker网络,该网络对每个生成样本独立地给出一个移动方向,生成器只需回归样本沿该方向移动后的位置。
这个转移场并非由教师模型提供,而是通过一个“三体散射事件”当场计算得出。在给定生成条件(如提示词)时,从噪声分布中独立抽取两个生成样本,并从一个真实样本配对。这三个样本构成一个“三体”系统:真实样本指出数据分布所在的方向,一个生成样本(投射体)保留梯度,另一个生成样本(生成源)停止梯度。瞬时散射方向定义为:
[ \mathbf{d} = \frac{\mathbf{x}{real} - \mathbf{x}{proj}}{|\mathbf{x}{real} - \mathbf{x}{proj}|} - \frac{\mathbf{x}{gen} - \mathbf{x}{proj}}{|\mathbf{x}{gen} - \mathbf{x}{proj}|} ]
其中第一项是朝真实源的单位方向,第二项带负号,使投射体远离另一生成样本。这两项分别对应能量距离中的真实-生成吸引与生成-生成自交互。
在独立采样条件下,瞬时散射方向的条件期望就是总体转移场在给定位置处的方向。这种设计使得每个样本只需与一个真实样本和一个生成样本交互,而非批内全配对,因此计算效率高,且方向范数不超过2,上界不随图像维度增长,天然适配“一条描述配一张图”的数据。
算法细节:从瞬时散射到跟踪散射
TBSM的训练过程分为两个层次:瞬时散射(Instant Scattering)和跟踪散射(Tracked Scattering)。
瞬时散射不使用Tracker,直接将生成样本移动后的位置冻结为回归目标。虽然其期望梯度与能量距离梯度一致,但单个即时方向是带噪估计,方差较大。
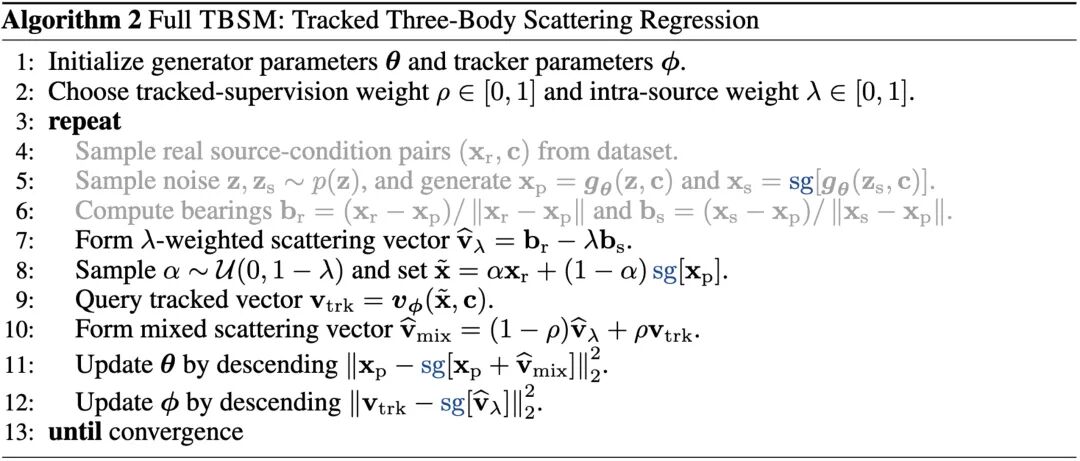
跟踪散射则使用Tracker学习更稳定的方向场。Tracker以生成样本的位置和条件为输入,输出预测的移动方向。训练时,将瞬时散射方向作为在线标签,Tracker通过回归学习其条件均值。生成器和Tracker均使用普通回归更新,不进行极小极大对抗训练。
完整TBSM使用两个权重参数 (\rho) 和 (\lambda) 混合即时方向与Tracker输出。(\rho) 控制Tracker的权重,(\lambda) 控制生成源自交互的权重和Tracker的查询区间。在 (\rho=1) 时,Tracker在投射体位置查询,对应精确能量距离场;若 (\rho<1),查询点进入生成-真实样本之间的连线,学到的是实践中的代理场。ImageNet最佳结果采用 (\rho=0.5),因此不能视为 (\rho=1) 理论的直接验证。
与现有方法的联系
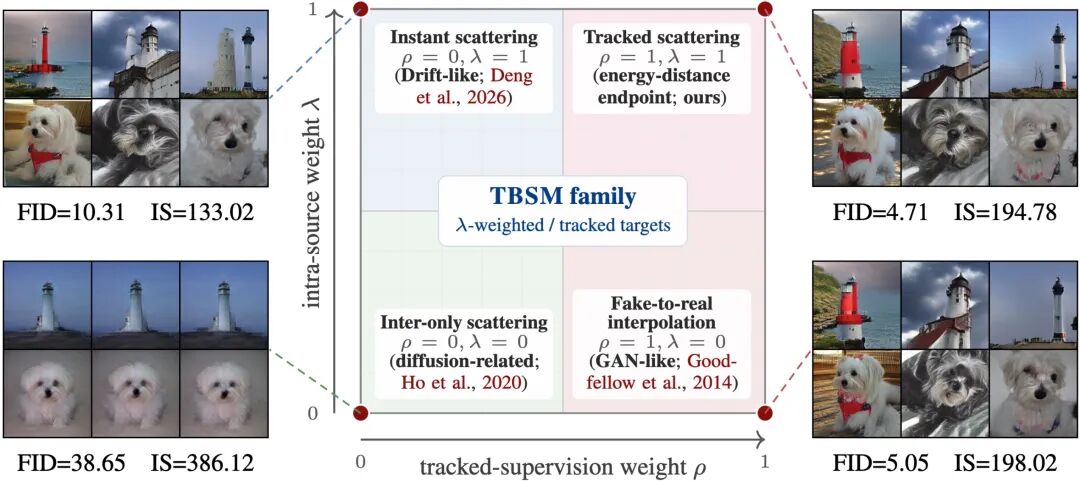
TBSM的设计图将四个角点对应到不同方法:
- (\rho=0, \lambda=0):瞬时能量距离散射,类似Drifting Models。
- (\rho=1, \lambda=1):完整跟踪散射,即TBSM。
- (\rho=0, \lambda=1):仅真实吸引,类似扩散相关方法。
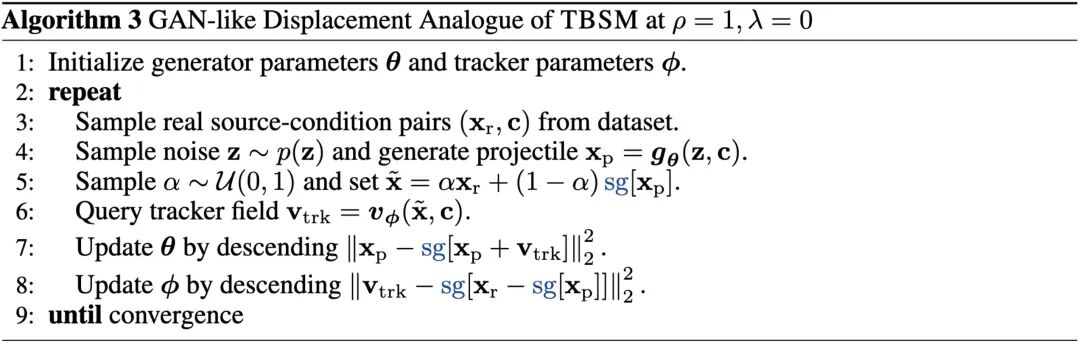
- (\rho=1, \lambda=0):Tracker仅学习Fake-to-Real插值,类似GAN。
实验表明,(\rho=1, \lambda=0) 时FID为10.31,而 (\rho=0, \lambda=1) 时FID为38.65,说明Tracker汇总方向有助于提升性能。有趣的是,(\lambda=0)(即完全没有生成-生成自交互)时也得到很好的性能,这揭示了TBSM与GAN-like learned field的紧密联系。
算法3:直观的位移类比
为了更直观地理解TBSM,论文提出了算法3,它是 (\lambda=0) 状态下的简化展示。算法3让Tracker学习完整位移而非单位方向,大量生成-真实样本对提供局部位移,Tracker将这些观测汇总成一个从当前生成分布通向真实分布的Flow Matching转移场。生成器沿这个场更新后,新的生成分布又会产生下一轮转移场,形成迭代循环。
从风格迁移的视角看,可以将Fake和Real理解为两种不同的“风格”,Tracker学习二者之间的转移,再指导生成器产生新的Fake,如此循环。这提供了一种直观的理解视角。
高维图像应用:表征空间散射
像素欧氏距离未必对应图像语义距离,因此TBSM将散射搬到冻结的图像表征空间。真实图像、生成投射体和生成源经过冻结编码器后计算方向与损失,梯度只沿投射体分支回到生成器,源特征保持停止梯度。多个表征空间分别形成损失后再聚合。
对于像素生成器,输出可直接进入表征网络;对于潜空间生成器,则先通过冻结解码器还原图像。训练结束后,Tracker和额外表征分支都可移除,只保留生成器及潜空间模型原有的解码器。
实验结果:ImageNet与文生图
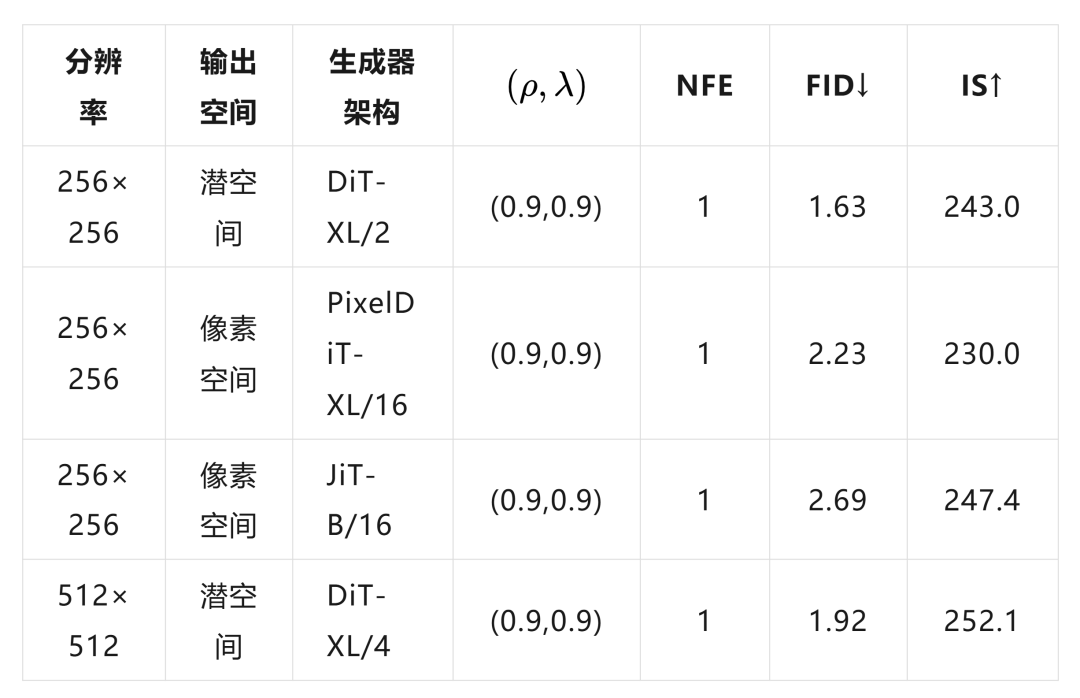
TBSM在ImageNet-256和ImageNet-512上进行了验证。下表展示了不同模型的FID和IS(越低越好/越高越好):
| 模型 | 训练方法 | NFE | FID | IS |
|---|---|---|---|---|
| DiT-XL/4 | 多步采样 | 1 | 398.20 | - |
| DiT-XL/4 | TBSM | 1 | 1.92 | - |
| PixelDiT-XL/16 | TBSM | 1 | 2.23 | - |
| 潜空间DiT-XL/16 | TBSM | 1 | 1.63 | - |
所有ImageNet指标均由50,000张生成图像计算,并使用训练集参考统计量。TBSM的训练和推理均不使用CFG(Classifier-Free Guidance)。
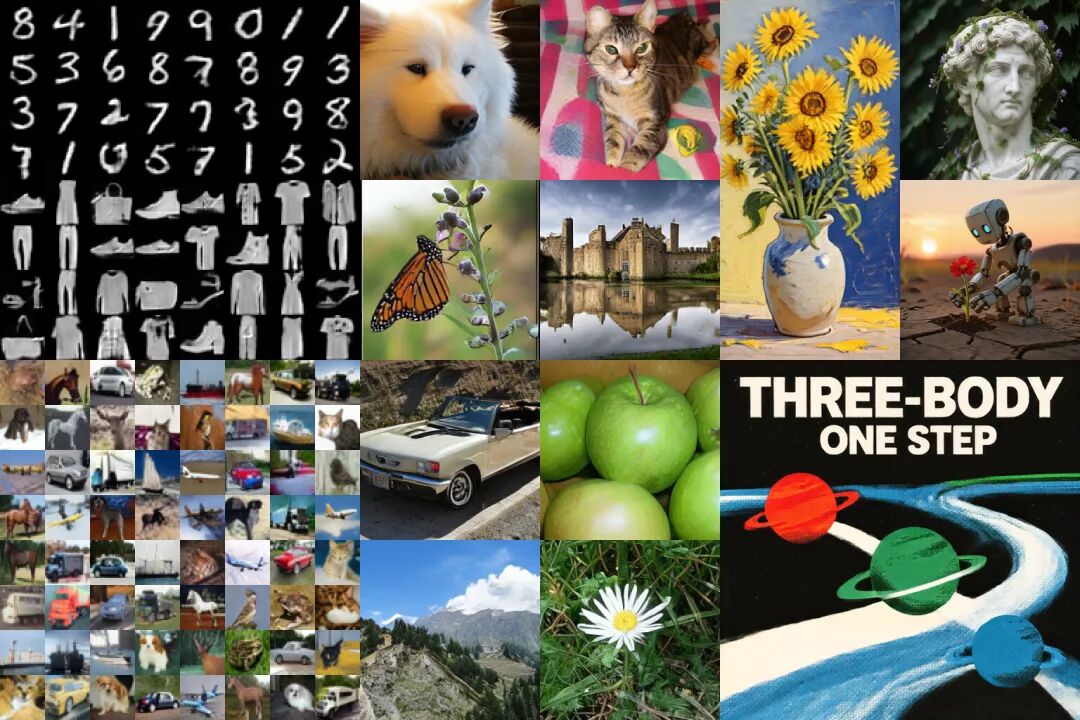
在文生图实验中,TBSM从预训练的20B参数Qwen-Image初始化,随后只用TBSM更新生成器和Tracker。在 (\lambda=0)、无CFG、NFE=1下生成 (1024 \times 1024) 图像,定性结果展示了高质量的生成效果。
讨论与展望
TBSM提供了一种无需在线教师的样本级分布匹配接口,可把成熟生成模型后训练为一步生成器。ImageNet主实验使用且仅使用扩散或Flow Matching权重初始化,但进入TBSM阶段后不再查询教师。论文尚未验证ImageNet规模的随机初始化,但复用成熟的扩散生态本身也是一条实用、轻量的路线。
未来工作可探索从训练 (\rho=0.5) 逐步过渡到 (\rho=1),或根据瞬时方向的噪声动态调节 (\rho)。此外,TBSM有望扩展到视频生成、世界模型等更复杂的生成任务。
结语
TBSM的核心是从能量距离得到“真实吸引—生成自交互”的局部方向,再让Tracker学习其条件均值。训练完成后,辅助网络退出,生成器只需一次前向。它展示了把分布距离转化为高维生成器可直接学习的样本级运动监督的一条路径。
项目状态:目前已开放MNIST最小实现和ImageNet-1K训练、评测代码;后续还计划发布Qwen-Image-20B文生图模型的权重和训练代码。
作者介绍:本文第一作者是西湖大学与浙江大学联合培养的三年级博士生孙鹏,研究兴趣是简单有效的生成式AI的训练与推理加速框架。未来希望能在世界模型和视频生成上继续找到合适的合作者/Mentor并做出更多有影响力的工作。