QQWorld:分位数匹配如何破解世界模型潜空间重尾难题?
从 LeWM 到 QQWorld:一场针对潜空间重尾的精准手术
2026 年,Yann LeCun 等人提出的 LeWorldModel(LeWM)为世界模型的发展注入了新的活力。它采用联合嵌入预测架构(JEPA),直接从原始像素中学习环境动力学,并通过高斯分布正则来抑制表示坍塌,使得端到端世界模型的训练变得更加稳定。然而,西安交通大学的研究团队在深入分析后发现,即便施加了高斯正则,LeWM 学习到的潜变量分布仍可能呈现出明显的重尾现象——少量潜变量会远离主体分布,形成极端表示。这一发现直接挑战了现有正则化方法的有效性,并催生了一种名为 QQWorld 的创新解决方案。
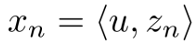
重尾现象:潜空间中的“隐形杀手”
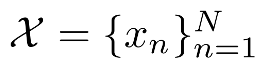
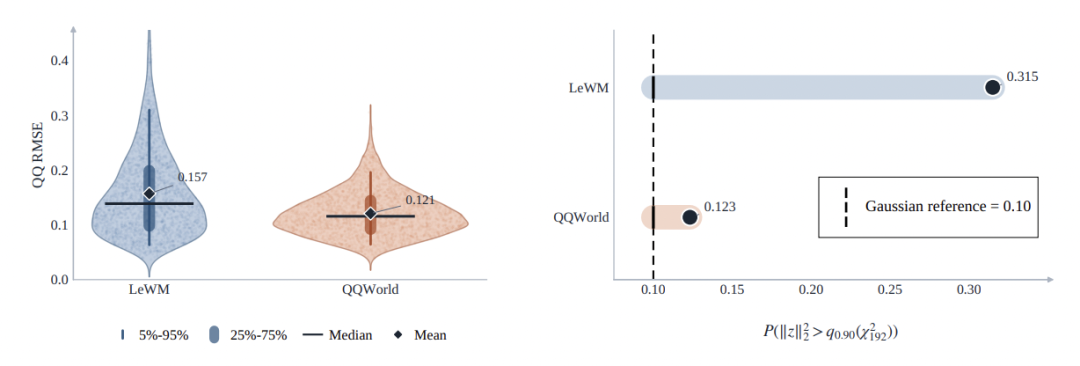
在 LeWM 的训练过程中,潜变量被期望遵循标准高斯分布,以确保模型能够捕捉到环境中的关键特征。然而,实际训练中,部分潜变量会偏离主体分布,落入数据稀疏的尾部区域。这些重尾样本不仅难以被后续的动力学预测模块有效利用,还可能误导规划过程,导致整体性能下降。研究团队通过实验观察到,LeWM 的潜变量分布中,径向尾部概率高达 0.315,而标准高斯分布的理论值仅为 0.10。这意味着,有相当比例的潜变量处于极端位置,严重偏离了理想状态。
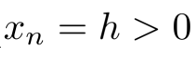
EP 正则的“尾部盲区”:为何梯度会消失?
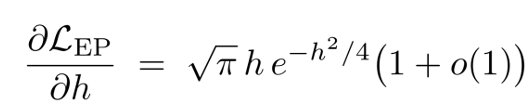
LeWM 采用 Epps–Pulley(EP)正态性目标来约束潜变量分布。EP 目标可以理解为经验分布与标准高斯分布之间的最大均值差异(MMD),并使用高斯核来衡量。然而,问题恰恰出在高斯核的有限作用范围上。
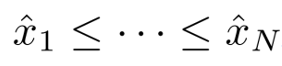
假设一个投影样本已经进入尾部,而其余样本仍位于主体区域。随着样本与主体分布的距离增大,高斯核的梯度会迅速衰减。具体来说,将该样本拉回主体区域的梯度与核带宽 h 有关,当 h 较大时,梯度趋近于零。这意味着,一旦样本进入较远的尾部,EP 正则几乎无法再为其提供有效的回拉信号。EP 能够判断整体分布是否偏离高斯,却难以持续纠正那些已经“走远”的极端样本。这种“尾部盲区”使得重尾现象在训练过程中难以被有效抑制。
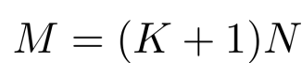
QQWorld:直接匹配高斯分位点
针对 EP 正则的不足,西安交大团队提出了 QQWorld,其核心思想是使用分位数-分位数匹配(quantile-quantile matching)替代原有的 EP 正则。这种方法不再通过核函数间接衡量分布差异,而是对潜变量的随机投影进行排序,让每个样本直接向其次序对应的标准高斯分位点移动。
具体而言,对于一个随机投影方向,模型首先对投影样本集合进行排序,得到次序统计量。然后,根据样本次序计算相应的标准高斯目标分位点。QQWorld 最小化排序样本与对应高斯分位点之间的平方距离。这样,每个投影样本都有一个由其次序决定的目标位置。样本偏离对应高斯分位点越远,获得的纠偏信号就越强,从而能够更有效地抑制潜变量分布中的重尾。
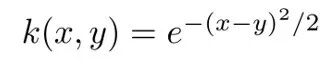
论文还证明了 QQ 损失与 EP 差异之间的单向控制关系:当 QQ 损失趋近于零时,EP 差异也会趋近于零;反之,EP 差异却无法控制 QQ 损失。这进一步说明了 QQ 正则化的有效性。
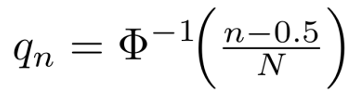
Cross-Batch QQ:小批次也能稳定排序
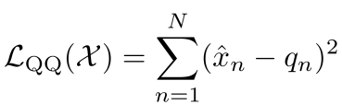
QQ matching 依赖批次内的样本次序,批次越大,经验分位点的估计越稳定,但显存成本也随之上升。为了缓解这一矛盾,论文提出了 Cross-Batch QQ 技术。它使用一个先进先出的队列,保存最近若干次迭代产生的投影特征,再将当前批次与历史批次合并计算次序。
假设当前物理批次大小为 N,队列中保存了 K 个历史批次,则有效排序池扩大为 N*(K+1)。历史特征会从计算图中分离,只参与次序估计,梯度仍然只通过当前批次传播。因此,Cross-Batch QQ 可以在不显著增加反向传播显存的情况下,获得接近大批次训练的分位点估计。
论文进一步从理论上揭示了 Cross-Batch QQ 的 Bias-Variance Tradeoff:适度增加历史样本可以扩大排序池、降低经验分位点估计的方差;但当队列过长时,较早的历史特征可能无法准确反映当前不断变化的潜在分布,从而引入分布陈旧造成的估计偏差。这一分析解释了为何适中的队列长度通常能够取得最佳效果。
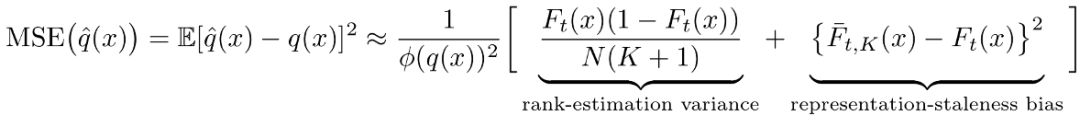
实验验证:性能与效率的双重提升
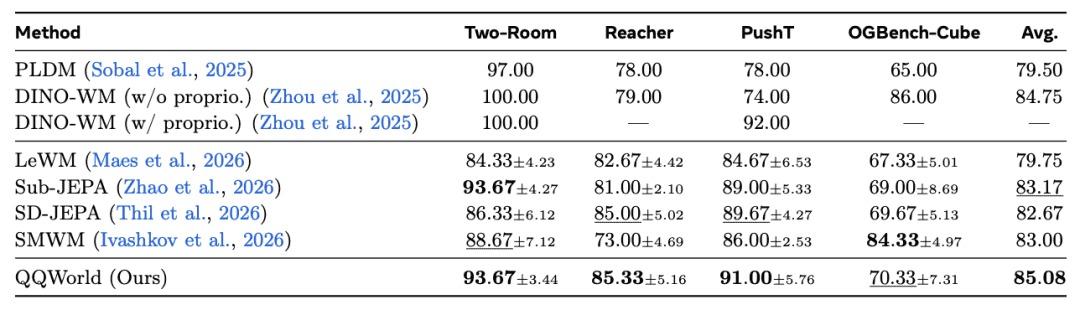
实验沿用统一的离线数据、训练设置和基于 CEM 的目标条件规划协议,在 Two-Room、Reacher、PushT 和 OGBench-Cube 四个环境上进行评测。结果显示,QQWorld 在四个环境中均超过基线,平均规划成功率由 79.75% 提升至 85.08%。
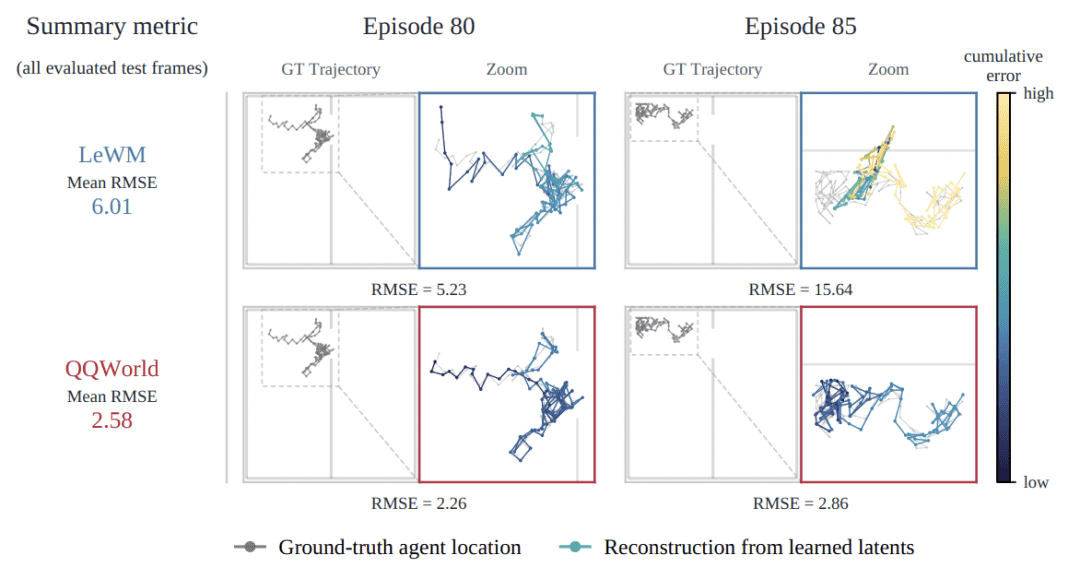
此外,潜变量的分布也明显更加规整。与 LeWM 相比,QQWorld 的平均 QQ RMSE 从 0.157 降至 0.121;径向尾部概率从 0.315 降至 0.123,更接近标准高斯对应的 0.10。进一步地,使用线性探针从潜变量恢复智能体二维轨迹时,QQWorld 的测试集平均 RMSE 为 2.58,而 LeWM 基线为 6.01。这说明 QQWorld 不仅让潜变量在统计意义上“更像高斯”,也让其中的物理状态结构更加稳定、易于读取。
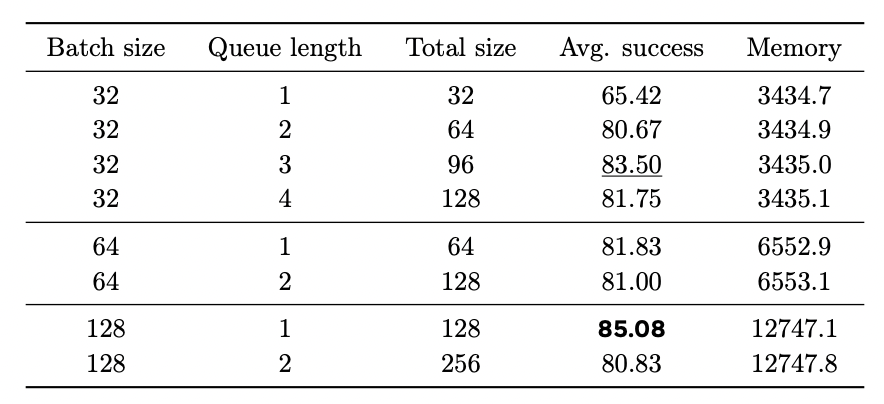
在显存消融实验中,当物理批次大小为 N=32,且只使用当前批次计算次序时,模型的平均成功率为 65.42%。加入 1 个历史批次后,成功率提升至 80.67%;加入 2 个历史批次后,进一步达到 83.50%,但 GPU 显存占用约为 3435 MB。相比之下,标准 QQWorld 在 N=128 时取得 85.08% 的平均成功率,显存占用约为 12747 MB。也就是说,使用 N=32 和两个历史批次,可以用 4 倍更小的物理批次和约低 73% 的显存,取得只低 1.58 个百分点的成功率,同时仍然显著超过 LeWM 基线。
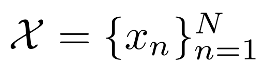
深层意义:从“判断分布”到“修正梯度”
这项工作的核心启示并不只是一种改进的分布正则方法。一个统计量能够判断两种分布不同,并不意味着它天然适合作为神经网络的训练目标。对于潜空间世界模型而言,真正重要的是:当异常值和重尾已经出现时,正则项能否继续提供足够强、方向明确的纠偏梯度。
EP 更擅长衡量整体分布差异,但有限带宽的高斯核对极端样本的惩罚会逐渐饱和;QQ matching 则将“分布接近”转化为逐样本的目标运输,让偏离越远的样本获得越强的回拉力。这可能意味着,世界模型潜空间正则需要从“判断分布是否正确”,进一步走向“有效的修正梯度”。
作者与单位
论文第一作者为西安交通大学硕士生喻周顺,通讯作者为西安交通大学数学与统计学院许翔宇教授和胡晓玉教授。许翔宇教授的研究方向涵盖世界模型、三维视觉与具身智能。
结语
QQWorld 通过分位数匹配机制,成功解决了 LeWorldModel 潜空间中的重尾问题,不仅提升了规划性能,还为大规模世界模型的高效训练提供了新思路。这一方法的核心在于,它不再仅仅衡量分布差异,而是直接为每个样本提供明确的修正方向,从而在尾部区域保持有效的梯度信号。未来,这一思路有望在更多领域得到应用,推动世界模型向更高效、更稳健的方向发展。