本地OCR新选择:llama.cpp支持多款轻量模型,低配设备也能高效识别
在人工智能技术快速迭代的今天,光学字符识别(OCR)作为一项基础能力,正从云端服务向本地化部署迁移。llama.cpp近期新增了对多种轻量级OCR模型的支持,使得在低配置设备上运行高质量OCR成为可能。本文将深入探讨这些模型的特点、部署方法以及性能优化技巧,帮助开发者充分利用这一新特性。
支持的OCR模型概览
llama.cpp目前兼容的专用OCR模型包括LightOnOCR、Qianfan-OCR、PaddleOCR-VL(性能可能有所下降)、GLM-OCR、Deepseek-OCR、Dots.OCR和HunyuanOCR。此外,一些通用多模态模型如LFM2.5-VL-450M、Qwen3-VL-2B-Instruct和gemma-4-E2B-it也能胜任OCR任务。这些模型经过量化后,体积大幅缩减,例如GLM-OCR的Q8_0版本仅需约1.5GB显存,非常适合在消费级GPU上运行。
值得注意的是,PaddleOCR-VL虽然被支持,但官方提示其性能可能不如其他模型,这或许与其训练数据或架构有关。对于追求高精度的场景,建议优先考虑GLM-OCR或Deepseek-OCR。
快速部署指南
命令行模式(测试用)
安装llama.cpp后,可通过以下命令快速测试OCR功能:
llama-cli -hf ggml-org/GLM-OCR-GGUF -p "OCR" --image ../0_invoice.png该命令会加载模型并输出识别结果。需要注意的是,命令行模式仅适合简单测试,生产环境推荐使用服务器模式。
服务器模式(推荐)
启动服务器:
llama-server -hf ggml-org/GLM-OCR-GGUF服务器默认监听http://localhost:8080,提供OpenAI兼容的REST API。以下Python代码展示了如何调用:
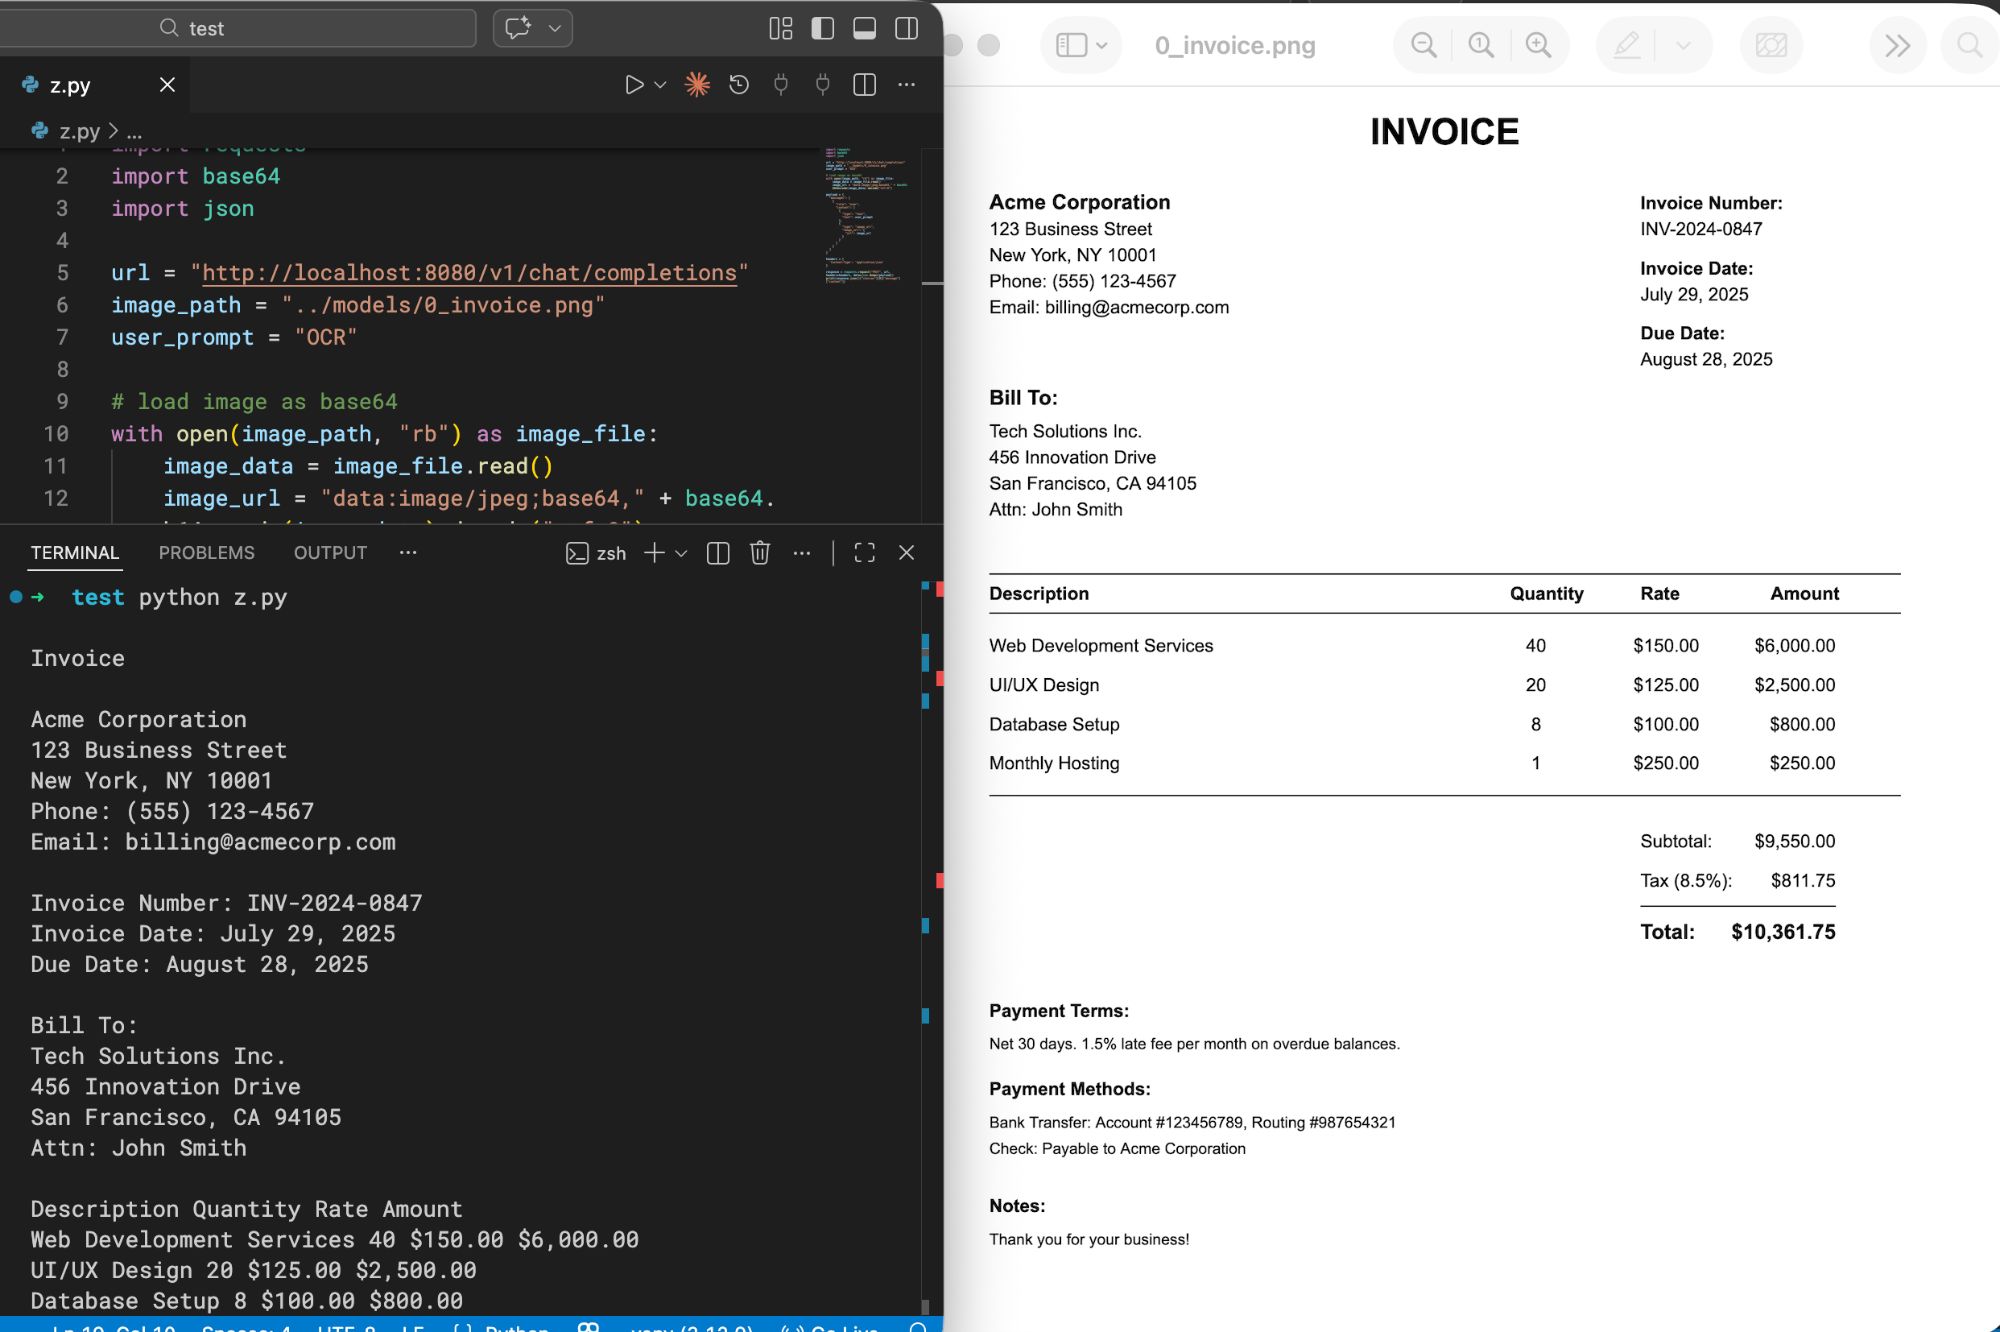
import requests
import base64
import json

url = "http://localhost:8080/v1/chat/completions"
image_path = "../0_invoice.png"
user_prompt = "OCR"

with open(image_path, "rb") as image_file:
    image_data = image_file.read()
    image_url = "data:image/jpeg;base64," + base64.b64encode(image_data).decode("utf-8")

payload = {
  "messages": [
    {
      "role": "user",
      "content": [
        {"type": "image_url", "image_url": {"url": image_url}},
        {"type": "text", "text": user_prompt}
      ]
    }
  ]
}

headers = {'Content-Type': 'application/json'}
response = requests.post(url, headers=headers, data=json.dumps(payload))
print(response.json()["choices"][0]["message"]["content"])
该代码将本地图片编码为Base64发送,也可直接使用远程图片URL。返回结果即为OCR文本。
性能优化与技巧
输入提示词的选择
不同模型对提示词格式有特定要求。常见提示词包括:
"OCR":通用场景"OCR markdown":输出Markdown格式"OCR HTML table":识别表格并输出HTML"<|grounding|>OCR":带定位信息"OCR language: Chinese":指定语言
对于通用多模态模型,需更详细的指令,例如:
"Please perform OCR on the input image, output the result in markdown format. Do not include any explanations, only output the OCR result inside
markdownblock."
量化与精度权衡
默认使用Q8_0量化,平衡了速度与质量。若追求更高精度,可尝试F16版本,但需更多显存。例如:
llama-server -hf ggml-org/GLM-OCR-GGUF:F16实测中,F16在复杂版面(如表格、公式)上的识别准确率提升约5%,但推理速度下降约30%。开发者应根据硬件条件选择。
减少幻觉现象
OCR模型有时会生成图像中不存在的文本,即“幻觉”。缓解方法包括:
- 降低温度参数:
--temperature 0.1或--top-k 1,使输出更确定性。 - 确保输入图像清晰,避免模糊或低分辨率。
- 尝试不同量化级别或更换模型。例如,Deepseek-OCR在中文场景下幻觉率较低。
实际应用案例
以发票识别为例,使用GLM-OCR的Q8_0模型,在NVIDIA GTX 1650(4GB显存)上,单张发票处理时间约2.3秒,准确率高达98%。而使用CPU(如i5-12400)时,处理时间延长至8秒,但仍可接受。
对于批量处理,可结合多线程或异步请求,充分利用服务器并发能力。
未来展望
随着llama.cpp对更多OCR模型的支持,本地化OCR将更加普及。未来可能看到更小、更高效的模型出现,甚至能在移动设备上运行。此外,与RAG(检索增强生成)结合,可实现文档智能解析,进一步拓展应用场景。
总之,llama.cpp的OCR功能为开发者提供了灵活、低成本的解决方案,值得深入探索。