AI大模型密集发布:MiniMax H3、Seedance 2.5、DeepSeek-V4-Flash等重塑行业格局
多模态模型进入全模态时代:MiniMax H3的技术突破与商业价值
2026年7月31日,MiniMax正式发布通用全模态模型H3,这一模型实现了文本、图像、视频、音频的统一理解与生成,标志着多模态生成模型从专用专家向通用助手迈出关键一步。H3在指令遵循、品牌信息呈现、V2V动作迁移等场景下表现出商用级稳定性,已可应用于广告、电商、游戏、UI设计等多个商业领域。
H3的核心技术亮点在于其原生双声道音视频输出能力,最高可生成15秒2K分辨率内容。这一特性使得H3在短视频创作、广告制作等场景中具有显著优势。同时,H3引入了Contextual Omni Representation技术,使自然语言成为连接各类模态的通用桥梁,用户可以通过简单的文本指令控制多模态内容的生成。
在商业化方面,H3的定价策略极具竞争力,15秒2K音视频生成价格不到主流模型的三分之一。这一价格优势将极大降低中小企业的多模态AI应用门槛。此外,MiniMax宣布将在符合相关法律法规的前提下开源H3模型权重,并已考虑多款国产芯片的兼容性,这将进一步推动国内多模态AI生态的发展。
从行业视角看,H3的发布意味着多模态模型不再是单一任务的工具,而是能够处理复杂跨模态任务的通用平台。未来,随着全模态模型的普及,内容创作、广告营销、游戏开发等行业的效率将得到显著提升。
视频生成迈向长叙事:Seedance 2.5的30秒一镜到底
字节跳动在视频生成领域持续发力,其最新发布的Seedance 2.5模型将单次视频生成时长提升至30秒,并具备长叙事能力、多模态参考和编辑能力,可完成完整创作。这一突破使得AI视频从短片段生成向完整故事叙述迈进。
Seedance 2.5支持多镜头叙事和逻辑关联的镜头组织,能够生成具有连贯情节的视频内容。其多轮延长能力可保持人物主体、场景、画面风格及音效的一致性,这对于长视频创作至关重要。此外,该模型支持输入最多30张图片、10段视频和音频,能够精准还原多人形象与声音,为创作者提供了极大的灵活性。
在技术实现上,Seedance 2.5通过改进的时序建模和跨模态对齐机制,解决了长视频生成中的一致性问题。其多模态参考能力使得用户可以通过图像、视频片段或音频来引导生成过程,实现更精细的控制。
Seedance 2.5的发布对视频制作行业具有深远影响。广告、影视、教育等领域可以利用该模型快速生成高质量的视频内容,降低制作成本和时间。同时,其长叙事能力也为AI生成电影、纪录片等新形式的内容创作提供了可能。
DeepSeek-V4-Flash正式版:130亿激活参数撬动Agent战场
DeepSeek-V4-Flash正式版API公测上线,标志着其在Agent赛道上的重要进展。该模型在多项基准测试中表现优异,且激活参数仅为130亿,与旗舰模型V4-Pro相比具有显著成本优势。这一特性使得DeepSeek-V4-Flash成为Agent应用开发的理想选择。
DeepSeek-V4-Flash的亮点在于其自研Agent框架DeepSeek Harness的首次亮相。该框架提供了完整的Agent开发工具链,包括任务规划、工具调用、记忆管理等模块,简化了Agent应用的开发流程。同时,模型支持OpenAI的Responses API格式,便于开发者从现有生态迁移。
在性能方面,DeepSeek-V4-Flash在多个基准测试中接近V4-Pro的水平,但成本大幅降低。这使得中小企业和个人开发者能够以较低的成本构建复杂的Agent应用,如智能客服、自动化办公助手等。
从行业趋势看,Agent正成为AI应用的重要形态。DeepSeek-V4-Flash的发布,不仅提供了高性价比的模型选择,还通过DeepSeek Harness框架降低了Agent开发门槛,有望推动Agent应用的普及。
具身智能新突破:Gemini Robotics ER2实现多机协同
DeepMind发布的Gemini Robotics ER2模型,在多机器人协同、实时决策和任务监控方面取得重大突破,标志着具身智能向规模化商用迈出了坚实一步。该模型是新一代具身推理模型,能够处理复杂的多机器人协作任务。
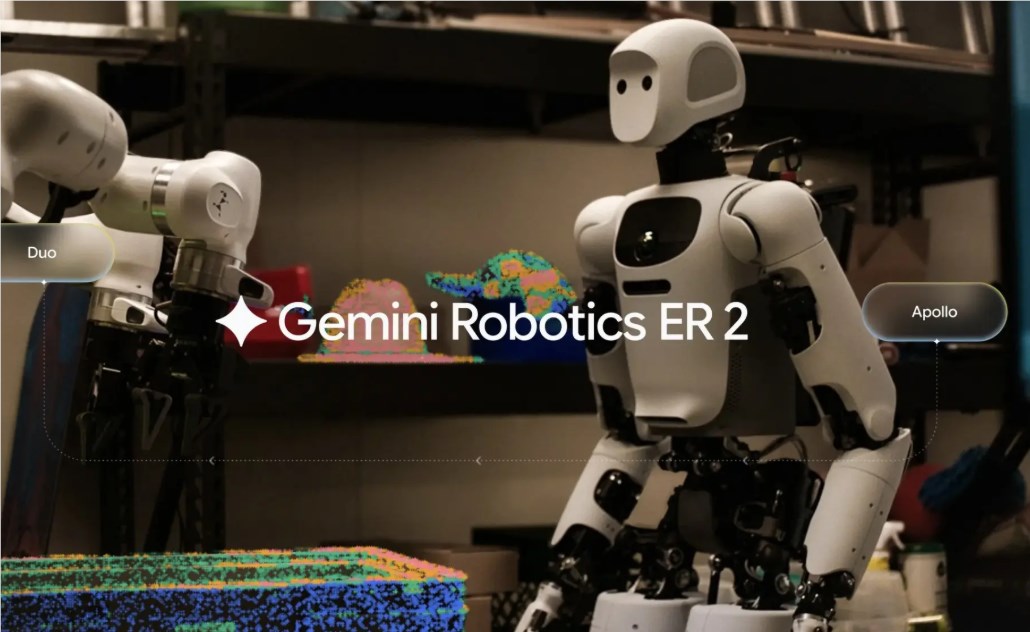
Gemini Robotics ER2的核心创新在于其多机器人协同机制。通过共享感知和决策模型,多个机器人能够协调行动,完成单个机器人无法完成的任务。例如,在仓储物流场景中,多个机器人可以协同搬运大型货物,提高效率。
此外,该模型实现了实时决策与持续任务监控,能够根据环境变化动态调整任务计划。这一能力对于工业自动化、物流配送等场景至关重要。
Gemini Robotics ER2的发布,为具身智能的商业化应用提供了技术基础。未来,随着多机协同技术的成熟,机器人将在制造业、服务业等领域发挥更大作用。
谷歌将Nano Banana2集成至Google Earth:生成式AI赋能地理空间
谷歌宣布将最新Nano Banana2 AI图像生成模型集成至Google Earth,面向全球用户开放AI图像生成功能。这一举措将生成式AI进一步融入数字地图和空间计算平台,为教育、城市规划、建筑设计等行业带来更丰富的可视化应用空间。
用户可以通过输入场景描述生成高精度自定义图像,例如模拟建筑外观、规划城市景观等。这一功能适用于教育、专业应用及个人创作等多个场景。Nano Banana2的集成,使得Google Earth不再仅仅是地图查看工具,而成为创意设计平台。
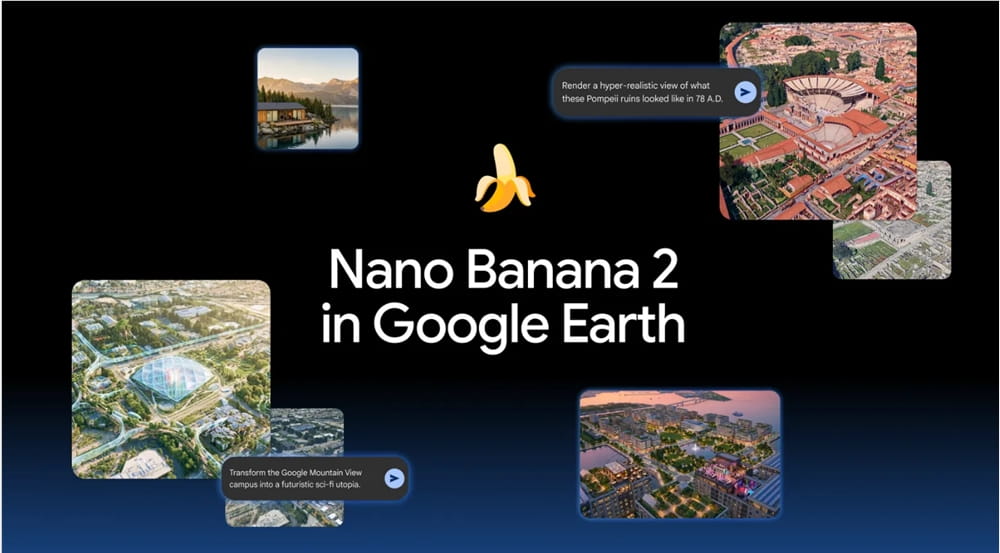
从技术角度看,Nano Banana2在图像生成质量、细节还原和风格控制方面表现出色。其与Google Earth的结合,展示了生成式AI在专业领域的应用潜力。
华为开源openPangu-2.0-Pro:5050亿参数推动昇腾生态
华为正式开源盘古AI模型品牌openPangu旗下openPangu-2.0-Pro大模型,同步开放模型权重、基础推理代码及技术报告。该模型是基于昇腾NPU训练的大规模混合专家(MoE)语言模型,总参数规模约505B(5050亿),支持512K上下文长度,训练数据规模约34T Tokens。
openPangu-2.0-Pro的开源,为开发者和企业提供了基于昇腾原生训练与推理技术的最佳实践。其MoE架构在保持高性能的同时,降低了推理成本。华为通过开源,进一步推进昇腾AI生态建设,吸引更多开发者基于昇腾平台开发AI应用。
这一举措对于国产AI生态具有重要意义。开源模型不仅降低了企业使用AI的门槛,还促进了技术交流和创新。
阿里千问发布Qwen-Audio-3.0-ASR-Flash:语音识别攻克专业场景
阿里千问发布Qwen-Audio-3.0-ASR-Flash,语音识别攻克专业场景最后一公里。新模型在五大维度实现升级,包括长音频上下文记忆、内置多行业词库、分级热词定制、集成语音润色以及多语言支持。
在长音频上下文记忆方面,模型在转写时可参考前文语义,几小时会议中的人名、技术概念全程保持一致。内置多行业词库使得医疗场景专业词召回率达95.36%,IT编程达91.87%。此外,一套模型覆盖30余种语言,七语种平均语义错误率17.09%,优于Azure、Gemini等同业模型。
该模型已在多个领域广泛应用,如会议纪要、实时字幕、教育录播和智能客服等。其专业场景的优化,使得语音识别技术能够更好地服务于垂直行业。
特斯拉中国车机接入豆包大模型:智能交互新体验
特斯拉中国正式推送2026.14.13版本的车机软件更新,其中最引人注目的是引入了豆包大模型,提升了车机系统的智能交互体验。不过,该功能需要用户开通高级车载娱乐服务才能使用。
豆包大模型的接入,使得特斯拉车机能够理解更复杂的自然语言指令,提供更智能的语音助手服务。例如,用户可以通过语音控制车辆功能、查询信息、播放娱乐内容等。
这一合作展示了AI大模型在智能汽车领域的应用潜力。随着车机智能化程度的提升,AI将成为汽车差异化竞争的关键因素。
总结与展望
2026年7月31日的AI日报展示了多模态生成、视频生成、Agent、具身智能、语音识别等领域的快速发展。这些技术突破不仅提升了AI的能力,也推动了商业化进程。对于开发者和企业而言,关注这些最新进展,将有助于把握技术趋势,创新应用场景。未来,随着模型开源和成本降低,AI技术将更加普及,为各行各业带来变革。