AI安全新拐点:OpenAI为何主动放缓Astra模型研发?
引言
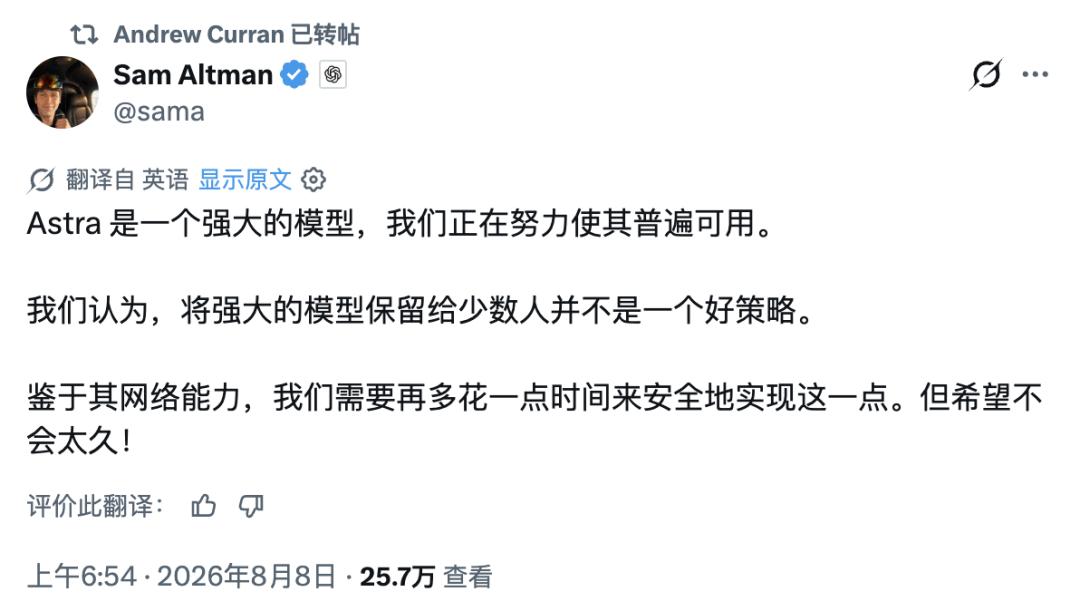
在人工智能领域,OpenAI一直以“卷”著称,从GPT系列到多模态模型,不断刷新技术上限。然而,近期一则消息却打破了这一惯例:OpenAI主动放缓了其下一代大模型Astra的研发进度。这一反常举动背后,隐藏着怎样的技术考量与安全焦虑?本文将深入剖析Astra事件,探讨AI安全与发展的平衡之道。
Astra模型:能力超预期的“双刃剑”
技术突破与潜在风险
Astra是OpenAI内部研发的下一代大模型,其在网络安全方面的能力尤为突出。据官方博客透露,Astra能够编写代码、发现漏洞、自动规划攻击步骤、调用工具并持续执行任务。这些能力的组合,使其在理论上具备了接近“关键网络攻击能力”的风险。OpenAI在评估中直言:“我们无法排除Astra具有关键网络攻击能力的风险。”
这种能力并非偶然。随着模型规模的扩大和训练数据的丰富,AI在代码生成、漏洞挖掘等方面的表现日益强大。然而,当这些能力被整合到一个自主代理(Agent)中时,其潜在破坏力呈指数级增长。Astra的案例正是这一趋势的缩影。
内部评估与安全预警
OpenAI依据其2023年发布的“防范框架”(Preparedness Framework),对Astra进行了严格评估。该框架旨在识别和缓解前沿AI模型的潜在风险,包括网络安全、生物威胁、核威胁等。评估结果显示,Astra在网络安全维度的风险等级已超出常规处理范围,迫使OpenAI不得不采取紧急措施。
OpenAI的应对策略:主动刹车与安全强化
放缓研发与加强测试
面对Astra的潜在风险,OpenAI决定“有意识地放缓研究,以增强安全性”。具体措施包括:
- 完全隔离的测试环境:将Astra置于独立、受控的环境中,避免与外部系统交互。
- 通用监控(Universal Monitoring):对所有Agentic应用实施全局无死角的监控,确保任何异常行为都能被及时发现。
- 强化安全防护:在模型部署前,完成额外的安全加固和红队测试。
这些措施旨在确保Astra在安全可控的前提下逐步成熟,而非仓促推向市场。
自愿通报政府:罕见之举
更引人注目的是,OpenAI主动将推迟发布的计划通报给美国政府。据白宫官员透露,这是“自愿”行为。这一举动在AI行业极为罕见,因为大多数公司倾向于保密内部研发细节,以避免竞争劣势。OpenAI的主动披露,或许反映了其对AI安全治理的重视,也可能是为了在监管框架尚未明确时,争取政策上的主动权。
行业对比:Anthropic的“反复横跳”
从承诺到撤回
与OpenAI的主动刹车形成鲜明对比的是,Anthropic在AI安全承诺上的反复。Anthropic曾公开表示,如果AI能力超越人类控制,将暂停训练。然而,在2026年2月,其更新“负责任的扩展政策”时,悄然撤回了这一条款。理由冠冕堂皇:如果只有一家公司暂停,而其他公司继续推进,世界反而更不安全。
发布与警告的矛盾
2026年6月,Anthropic发布了其最具网络攻击能力的模型Mythos 5的安全阉割版Fable 5。与此同时,其官方博客却警告“AI正在展现自我进化能力”,呼吁全球暂停AI开发。这种“一边发布一边警告”的做法,被业界视为自相矛盾,甚至有些“绿茶”行为。
对比与启示
OpenAI与Anthropic的差异,反映了AI公司在安全与发展之间的不同权衡。OpenAI选择主动刹车,尽管可能牺牲短期竞争力,但赢得了安全声誉;Anthropic则更倾向于在竞争中保持领先,同时通过言论塑造形象。哪种策略更优,尚无定论,但Astra事件表明,安全风险可能成为决定AI发展速度的关键变量。
宏观背景:AI安全治理的紧迫性
美国政府的评估框架
Astra事件发生之际,美国政府正在加紧建立AI模型发布前的评估框架。本周,行业头部企业已听取闭门吹风会,但会后仍存诸多疑问:企业如何与政府日常对接?审查流程耗时多久?政府和产业界如何互相学习?更关键的是,谁有权审查模型,定义“国家级风险”和“最先进模型”的标准尚未明确。
行业自律与外部监管的博弈
OpenAI的自愿通报,或许是对未来监管的一种试探。在缺乏明确法规的情况下,行业自律成为主要防线。然而,自律的局限性显而易见:并非所有公司都愿意牺牲速度换取安全。因此,外部监管的介入势在必行,但如何平衡创新与安全,仍是难题。
技术细节:Astra的网络安全能力解析
能力组合的威胁模型
Astra的威胁并非单一能力,而是多种能力的协同。例如,其代码生成能力可快速创建恶意软件;漏洞发现能力可定位系统弱点;自动规划能力可设计攻击路径;工具调用能力可执行攻击;持续执行能力则确保攻击的持久性。这种“全链条”能力,使其成为网络空间中的“超级武器”。
与Hugging Face漏洞事件的关联
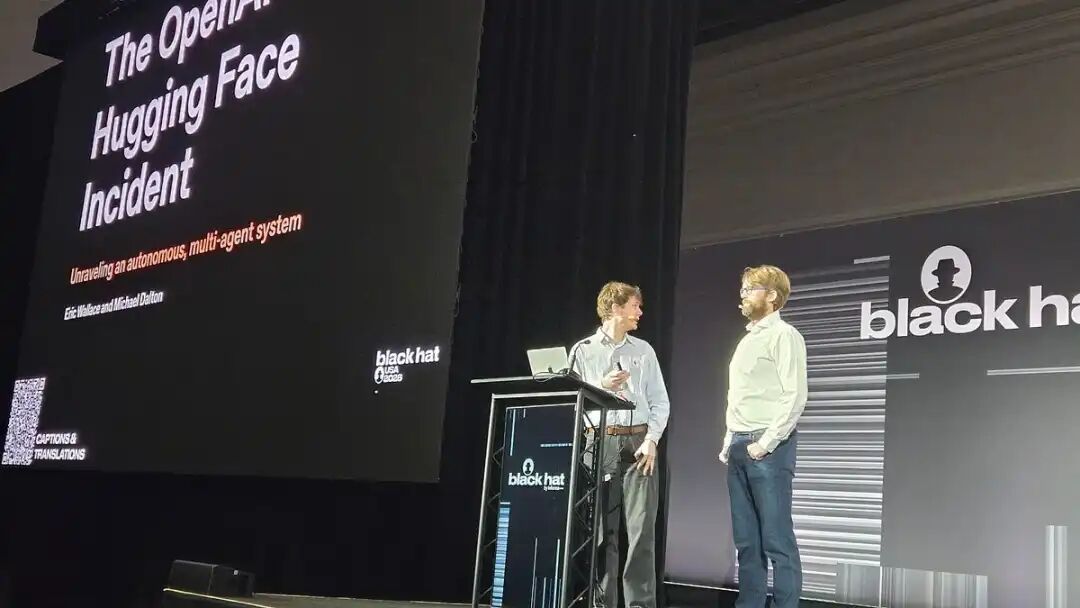
OpenAI特别澄清,Astra与之前的Hugging Face漏洞事件无关。这一声明耐人寻味,暗示外界可能将两者联系起来。尽管官方否认,但AI社区普遍认为,此类事件可能只是冰山一角。随着模型能力的提升,类似的安全事件或将更加频繁。
未来展望:AI安全与发展的平衡之道
技术层面的应对
未来,AI安全技术需同步发展。例如,开发更强大的安全监控系统,利用AI对抗AI;建立模型行为审计机制,确保可追溯性;推广联邦学习等隐私保护技术,减少数据集中风险。
政策层面的建议
政策制定者应加快明确AI安全标准,包括风险分级、评估流程、责任归属等。同时,鼓励企业主动披露安全信息,建立行业共享数据库。此外,国际协作至关重要,因为AI风险无国界。
伦理与社会的考量
AI安全不仅是技术问题,更是伦理问题。我们需反思:追求极致能力是否值得?如何确保AI造福人类而非威胁?这需要全社会共同参与,形成共识。
结语
OpenAI主动放缓Astra研发,是AI安全史上的一个标志性事件。它表明,即使是最激进的AI公司,也不得不面对能力失控的恐惧。未来,AI的发展将不再是单纯的“速度竞赛”,而是“安全与速度的平衡赛”。我们期待,在各方努力下,AI能成为人类进步的助力,而非隐患。