超越闲聊:基于Agora与MCP构建跨设备语音智能随记系统
在人工智能交互领域,语音助手早已不再是新鲜事物,但大多数现有产品仍停留在简单的指令执行或开放式闲聊层面。真正的突破点在于,如何让语音智能体不仅“听懂”人类语言,还能准确理解意图,并通过标准化的协议调用外部工具,最终将结果持久化保存。这种从“感知”到“行动”的闭环能力,才是智能体进入日常生产力场景的关键。近期,通过整合Agora Conversational AI Engine与模型上下文协议(Model Context Protocol, MCP),成功构建了一个具备跨设备同步能力的语音随记系统。这一实践不仅验证了技术栈的可行性,更揭示了构建高可用语音智能体的核心逻辑。
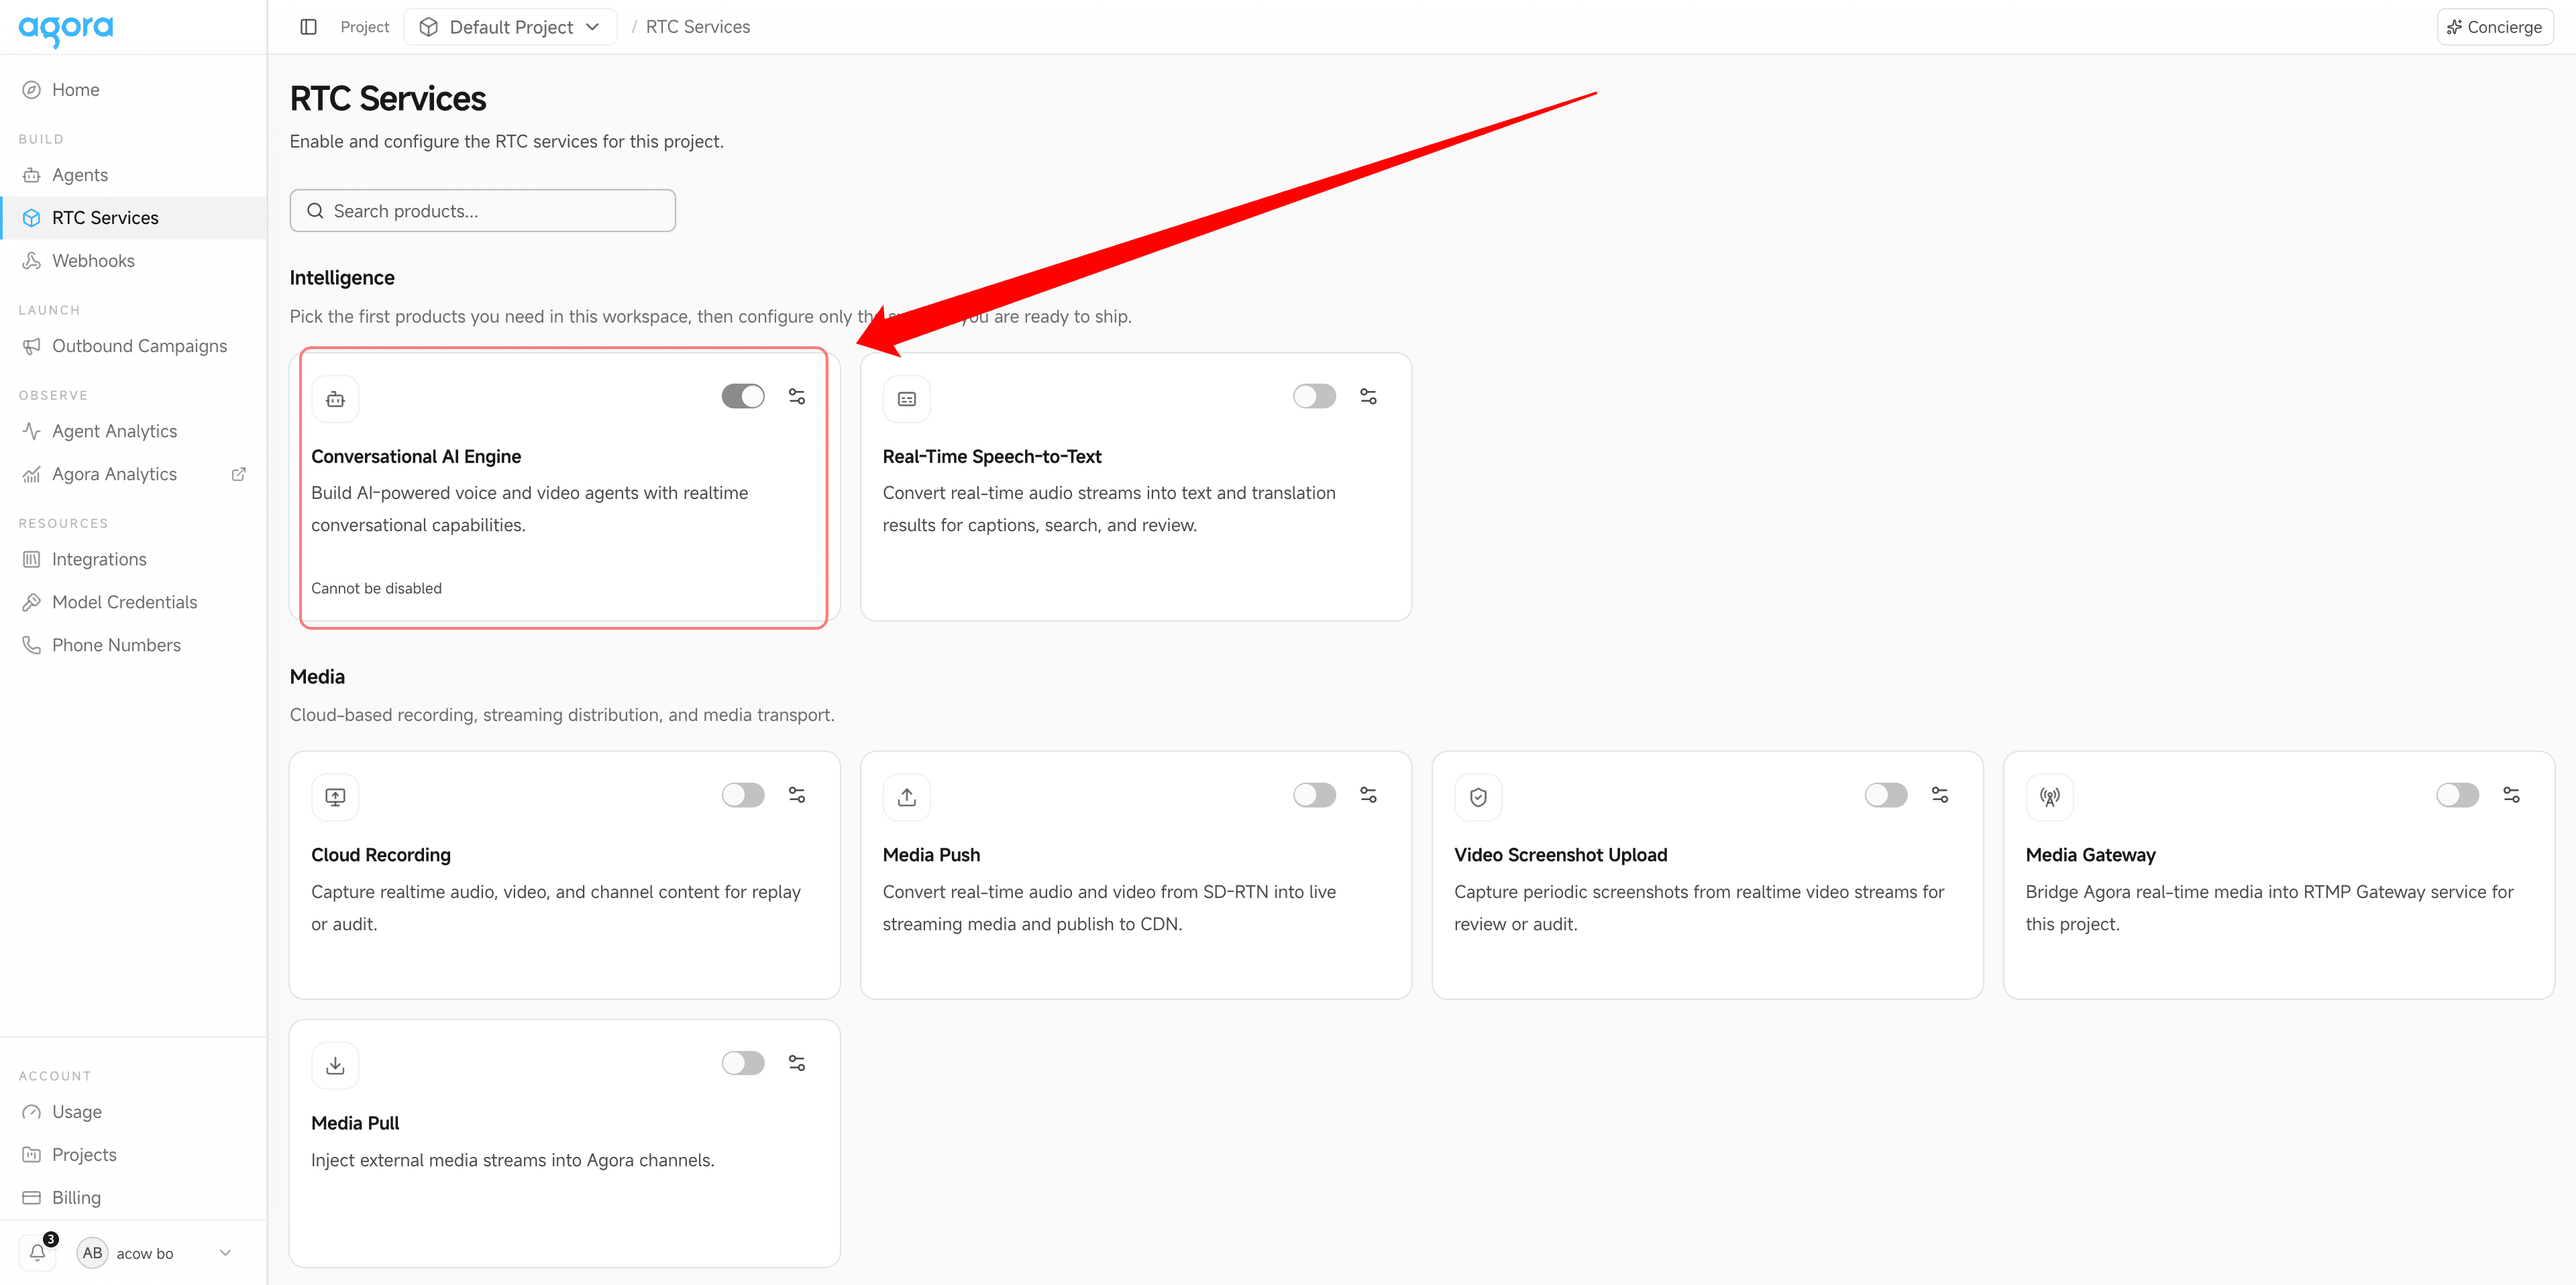
传统语音应用的开发往往面临巨大的工程复杂度。开发者需要分别处理音频采集、实时传输、语音识别(ASR)、大语言模型(LLM)推理、文本转语音(TTS)以及业务逻辑编排。这些组件通常来自不同的供应商,接口标准不一,导致系统集成难度极高,且难以保证低延迟的实时体验。Agora Conversational AI Engine的出现,为解决这一痛点提供了全新的架构思路。它并非仅仅是一个语音识别接口,而是一个完整的智能体运行时环境。该引擎将实时传输、Agent运行时、AI模型层和端上体验划分为四个清晰的层级,使得开发者能够专注于业务逻辑而非底层通信设施的搭建。
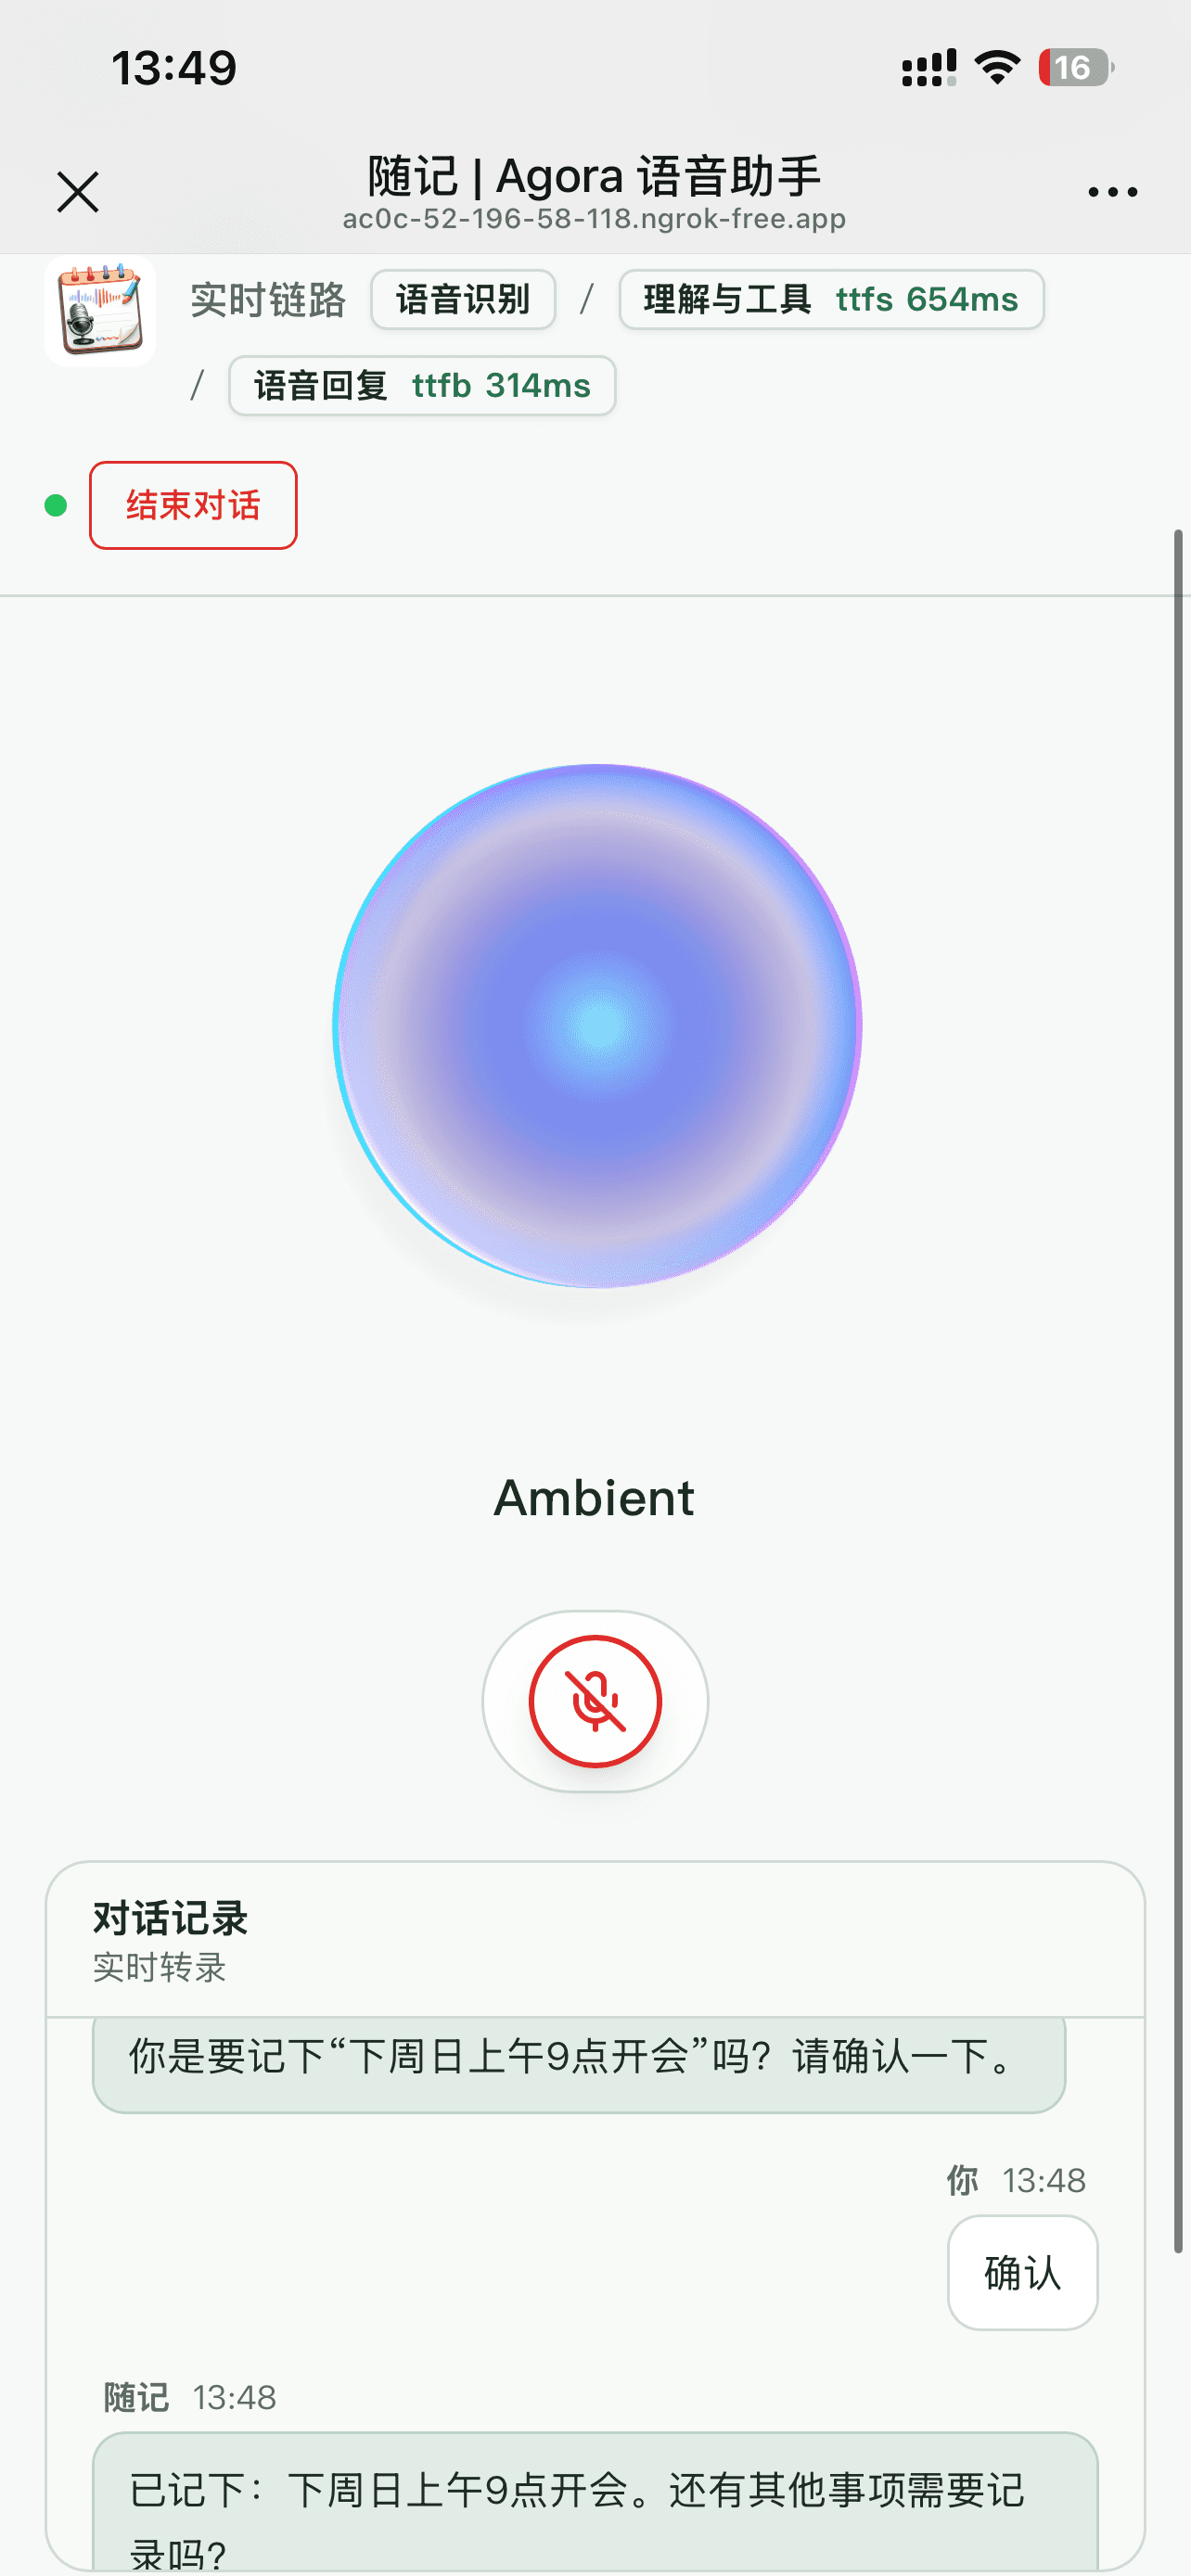
在实时传输层,系统利用成熟的RTC技术确保音频数据在浏览器、移动设备与云端之间的低延迟传输。这意味着用户在任何支持WebRTC的设备上,都能获得一致的音频输入体验。Agent运行时则承担了会话管理的核心职责,包括语音活动检测(VAD)、轮次控制、打断处理以及记忆管理。这一层的设计至关重要,因为它决定了智能体是否具备“对话感”。例如,通过设置合理的静音阈值,系统可以判断用户是否说完一句话,从而触发后续的识别与推理流程,避免过早截断或长时间等待。
AI模型层是智能体的大脑与感官。在本系统中,选择了Deepgram的nova-3模型作为ASR引擎,因其对中文语境的良好支持及较低的延迟表现。LLM部分则接入了托管的OpenAI模型,负责意图理解与工具调度。TTS环节采用MiniMax的中文音色,以确保回复的自然度与情感表达。这种组合并非随意选择,而是基于对响应速度、识别准确率及合成音质的综合权衡。端上体验层则通过Next.js构建的前端界面,实现了在桌面端与移动端的无缝适配,用户无需安装原生应用即可通过浏览器访问服务。
为了实现从“聊天”到“做事”的跨越,引入MCP协议是关键一步。MCP作为一种开放标准,旨在解决大模型与外部数据源及工具之间的连接问题。在传统的实现中,开发者往往需要在代码中硬编码工具调用逻辑,这不仅缺乏灵活性,还增加了维护成本。通过MCP,智能体可以动态发现并调用注册的工具。在本项目中,将原本用于查询时间的示例工具替换为具有实际业务价值的“添加事项”与“读取事项”功能。这两个工具直接对接SQLite数据库,实现了数据的持久化存储。
后端服务基于FastAPI构建,并通过FastMCP库注册了add_note和list_notes两个核心工具。add_note函数接收用户口述的内容,经过清洗与标准化处理后存入数据库;list_notes则负责检索最近保存的事项。值得注意的是,工具的设计必须考虑安全性与健壮性。例如,在写入数据库前,系统会对内容进行长度限制与非空校验,并使用参数化查询防止SQL注入攻击。此外,为了避免一次性返回过多信息导致语音播报冗长,读取操作限制了返回条数为十条。
然而,仅有工具定义是不够的,智能体必须知道何时以及如何调用这些工具。这需要通过精心设计的系统指令(System Prompt)来实现。在配置中,明确告知模型当用户表达“记录”、“添加”等意图时调用add_note,当询问“记了什么”时调用list_notes。更重要的是,针对模糊或不确定的输入,模型被要求先进行复述确认,而非直接执行。这一策略在处理时间、日期等关键信息时尤为重要,能有效避免因识别错误导致的数据污染。
在实际测试中,系统的表现验证了这一架构的有效性。当用户在电脑端说出“记一下,周六下午打篮球”时,系统迅速完成识别、意图判断、工具调用及语音反馈的全过程。尽管ASR将汉字“六”转换为数字“6”,但这并不影响语义的理解与存储。更有趣的是,当用户在移动端输入包含具体时间的复杂指令“下周日上午9点开会”时,智能体并未立即保存,而是主动发起确认请求:“你是要记下‘下周日上午9点开会’吗?请确认一下。”只有在用户给予肯定答复后,数据才被写入数据库。这种交互模式虽然增加了一轮对话,却显著提升了数据的准确性与用户的信任感。
跨设备同步是检验系统架构 robustness 的另一重要指标。由于前端仅负责音视频流的采集与播放,所有的业务逻辑与数据存储均集中在后端,因此不同设备间的状态同步变得自然而然。用户在手机上记录的事项,可以在电脑端通过语音查询即时获取。这背后的原理并非浏览器间的数据同步,而是所有会话共享同一个后端SQLite数据库。这种无状态的前端设计与有状态的后端存储相结合,为多终端协同工作提供了坚实的基础。
为了验证工具调用的真实性,而非前端模拟的假回复,通过ngrok的流量监控工具进行了深入分析。日志显示,Agora云端确实向MCP服务端发起了tools/call请求,参数中包含了正确的工具名称与内容。这一证据链完整地证明了模型的理解结果真正进入了业务函数,并触发了实际的数据写入操作。同时,Agora Analytics提供的会话监控数据进一步佐证了通话的真实性,显示了iPhone与Linux云端Agent在同一频道内的加入与离开时间,确保了整个交互过程的可观测性。
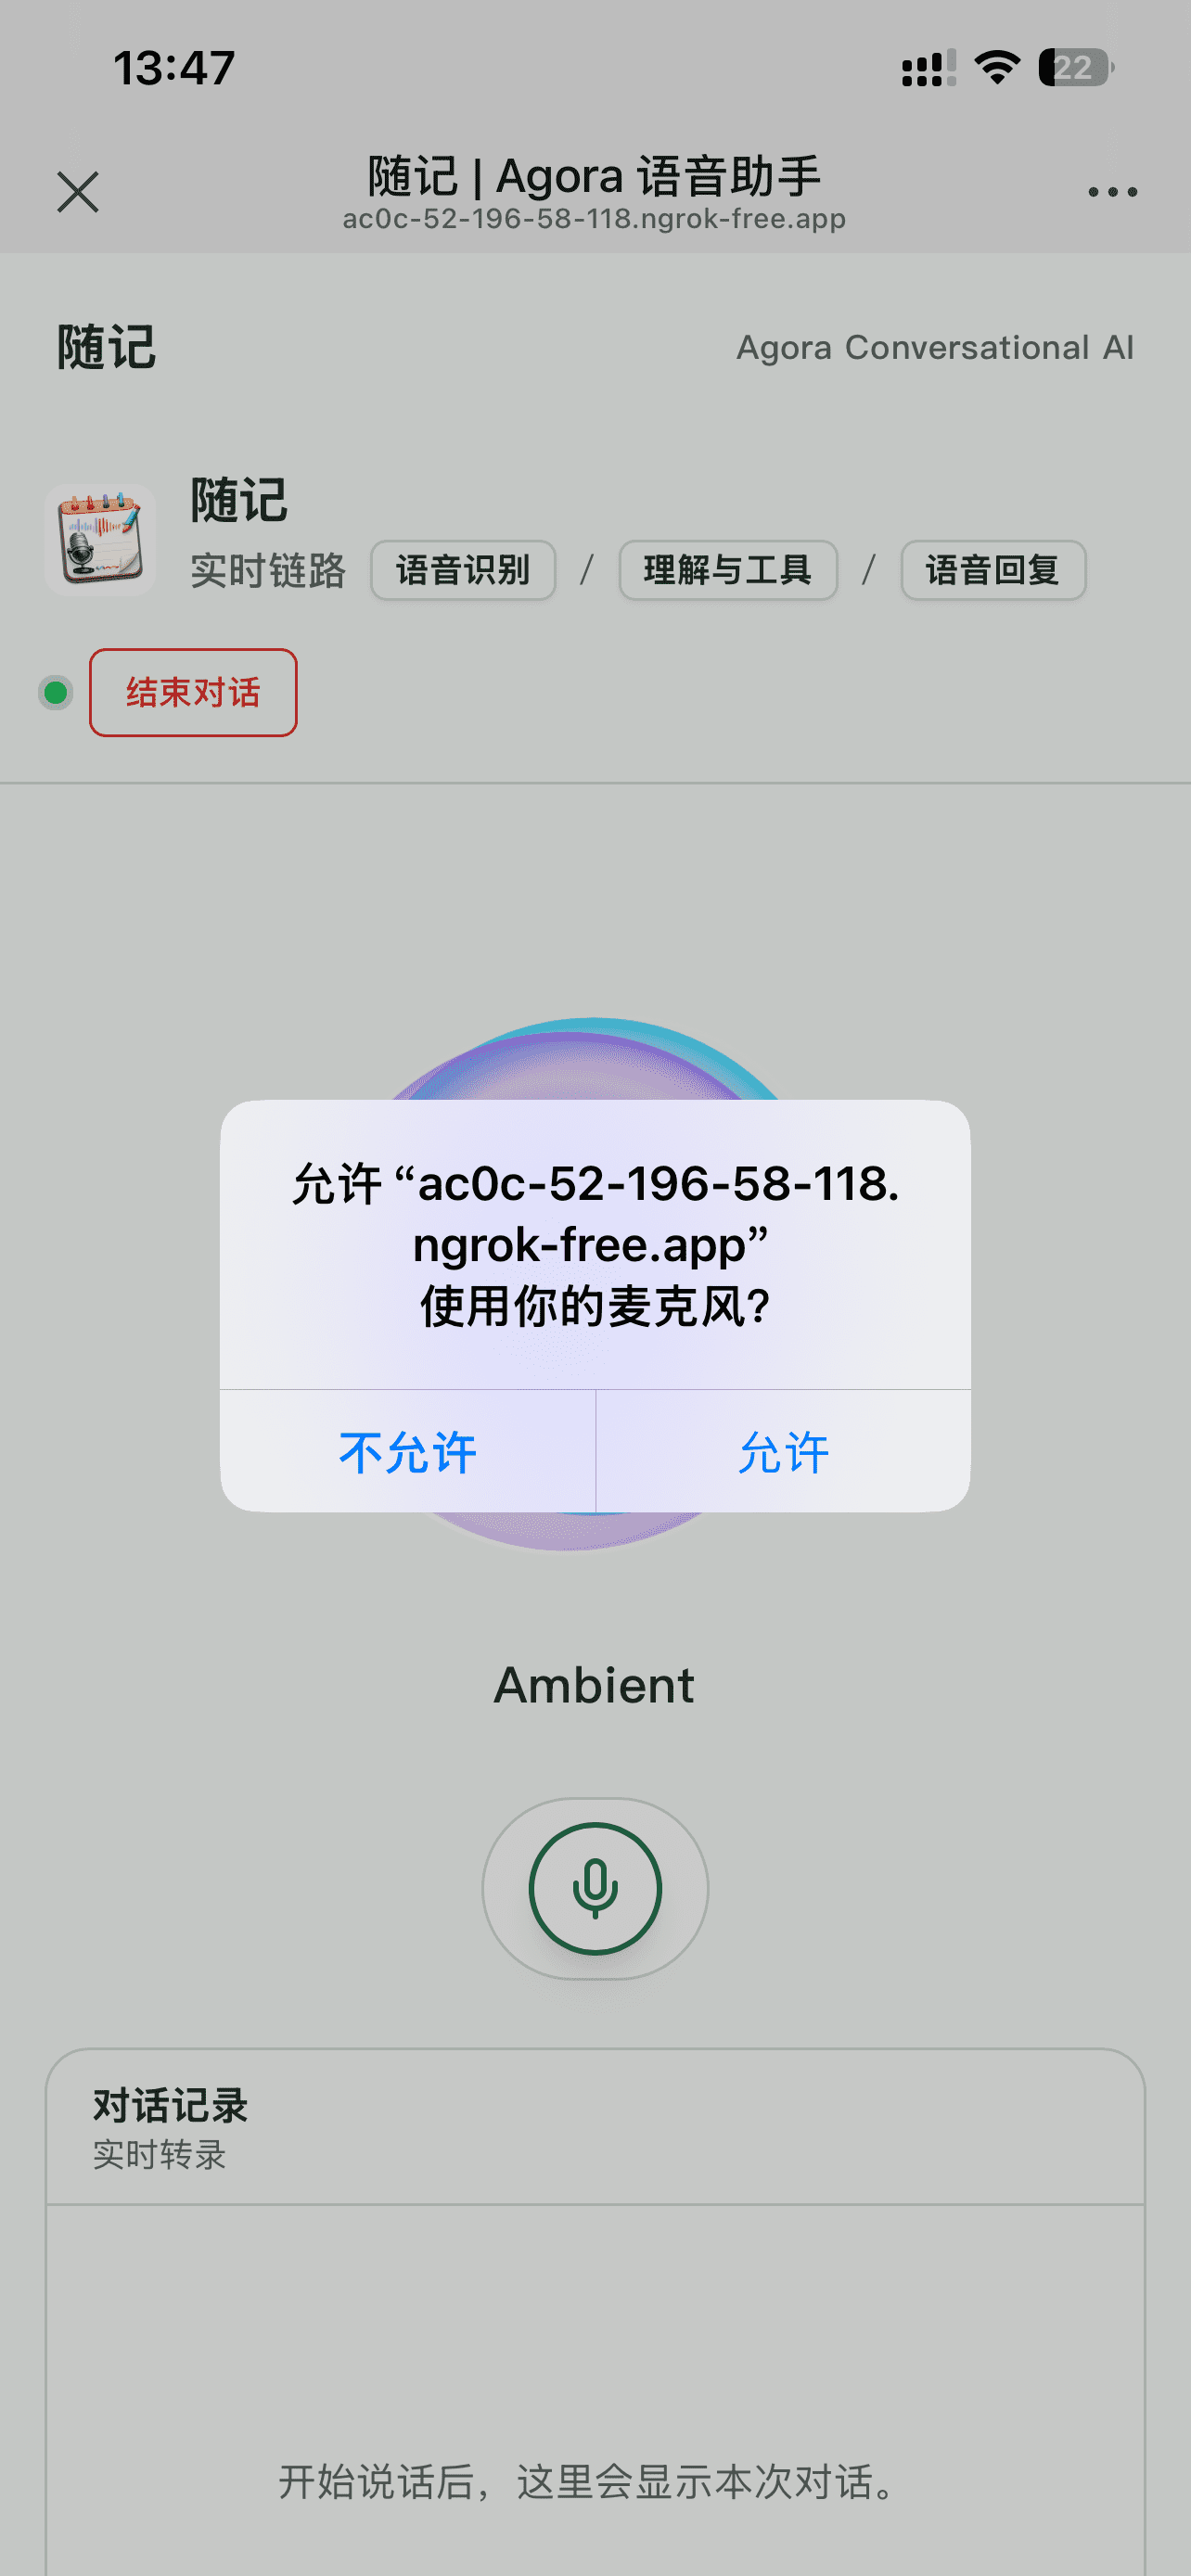
在开发过程中,网络配置是一个容易被忽视但至关重要的环节。由于MCP调用是由Agora云端发起的,因此后端服务必须暴露在公网上,不能仅监听本地localhost。使用ngrok等内网穿透工具生成HTTPS域名,并将其配置为MCP_ENDPOINT,是打通云端与本地服务的关键步骤。此外,前端访问也需要相应的公网地址,以便移动设备能够加载页面并获取麦克风权限。这种双隧道的配置方式,虽然增加了初始设置的复杂度,却保证了开发环境的灵活性与安全性。
从技术演进的角度来看,这一实践展示了语音智能体从单一模态向多模态、从被动响应对主动执行的转变。Agora Conversational AI Engine提供的底层基础设施,极大地降低了实时语音交互的开发门槛,而MCP协议则为智能体赋予了连接现实世界的能力。两者的结合,使得开发者能够快速构建出具备实际生产力的语音应用,而不必深陷于底层通信与模型集成的泥潭中。
当然,当前系统仍存在优化空间。例如,对于更复杂的自然语言理解场景,可能需要引入更强大的向量数据库以支持长期记忆;在嘈杂环境下的抗噪能力也有待进一步提升。此外,随着用户数据量的增加,SQLite可能需要迁移至更分布式的数据库解决方案。但就目前的原型而言,它已经成功地验证了核心假设:语音智能体完全可以成为高效的信息录入与管理工具。
这一探索不仅限于个人随记应用,其架构模式可广泛应用于客服系统、智能家居控制、医疗问诊辅助等多个领域。关键在于,如何将特定的业务逻辑封装为MCP工具,并通过精准的提示词工程引导模型正确调用。随着技术的不断成熟,我们有理由相信,未来的语音交互将更加自然、智能且富有成效,真正成为人类数字生活的得力助手。通过解耦实时通信、智能决策与工具执行,我们正在迈向一个更加开放且互联的智能体生态时代。