DeepSeek涨价30倍仍具性价比?揭秘模型成本背后的缓存与架构博弈
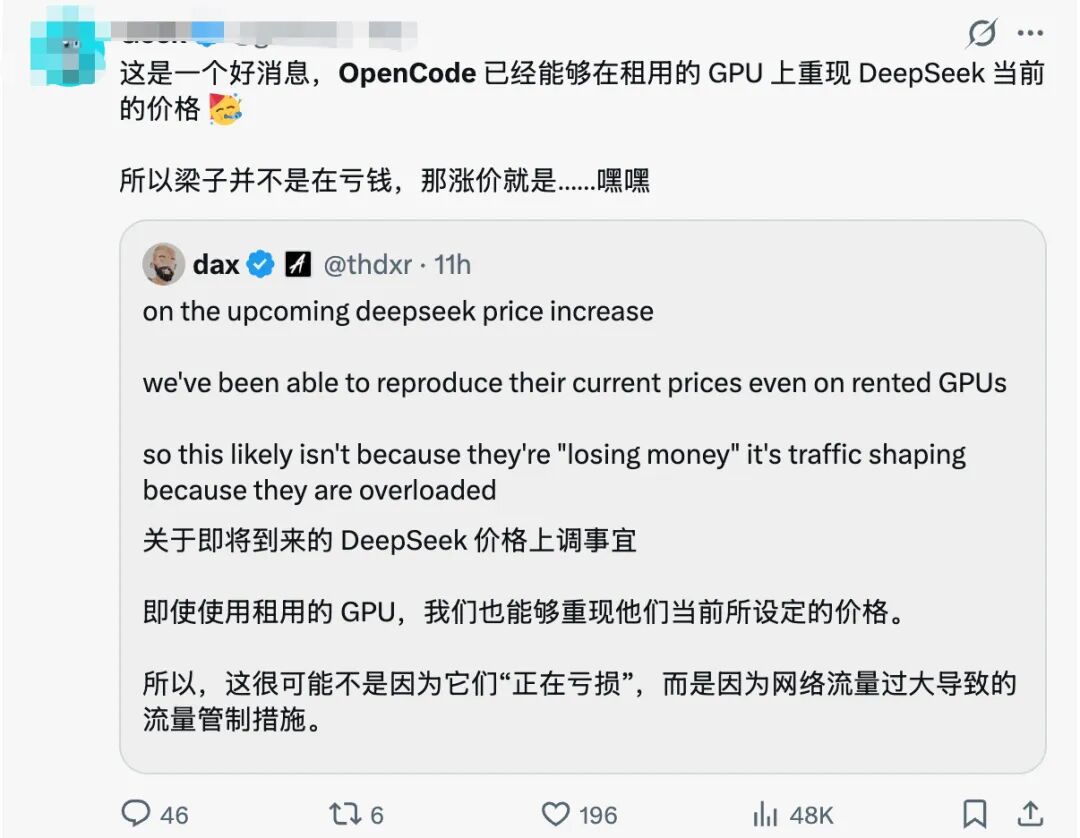
近期,关于DeepSeek即将调整服务价格的传闻在开发者社区引发了剧烈讨论。面对可能高达30倍的价格调整预期,部分第三方平台如OpenCode甚至以更低的价格提供服务,这种反直觉的市场现象背后,并非简单的商业倾销,而是一场围绕底层基础设施、缓存技术与系统架构的深度较量。当“低价”不再仅仅意味着营销手段,而是技术溢价的体现时,我们需要重新审视大模型服务中的成本构成与价值锚点。
价格迷思:第三方平台的“低价”幻觉与真实成本
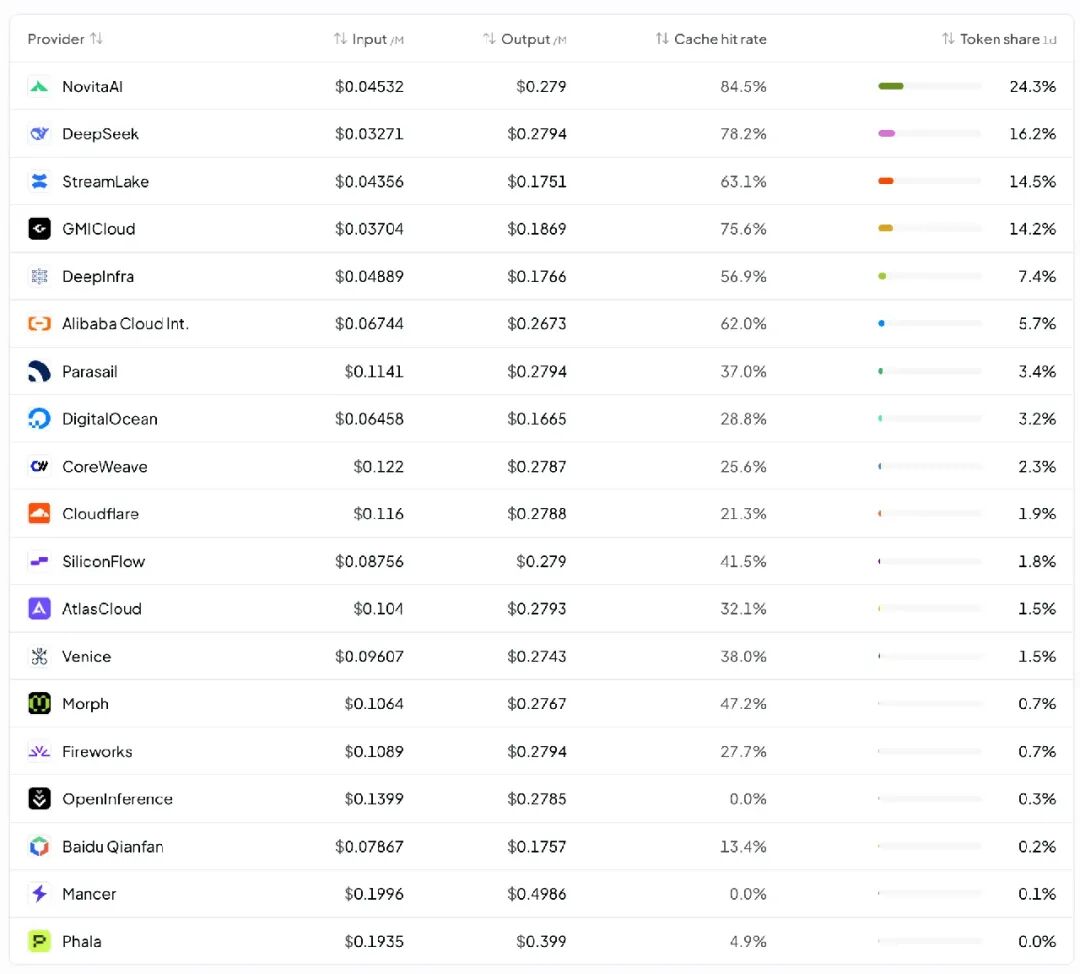
在OpenRouter等聚合平台上,DeepSeek V4 Flash的第三方供应商报价确实低于官方API。例如,DeepInfra给出的输入价格约为0.09美元/百万Token,仅为官方标价0.14美元的64%。这种价差极易给开发者造成“使用第三方更划算”的直观印象。然而,这种对比往往忽略了两个关键变量:模型精度差异与缓存机制的不同。
首先,第三方平台常采用FP4等低精度格式进行推理,而官方API并未完全公开其具体精度策略,这导致直接的价格对比存在基准不一致的问题。其次,也是更为关键的,是缓存命中率的差异。DeepSeek官方文档中明确标示了极低价格的“缓存读取”选项,当缓存命中率极高时,实际输入成本趋近于零。相比之下,部分第三方平台缺乏针对长上下文场景的优化配置,导致缓存频繁失效,从而引发Token消耗量的指数级增长。
以OpenCode Go为例,其采用订阅制模式,宣称10美元月费可兑换高达60美元的模型价值。但在实际开发场景中,一名开发者对包含百余个代码仓库的项目进行了同步测试。结果显示,在短任务中,OpenCode Go的显示消费金额约为官方API的4倍;而在长会话中,这一差距甚至超过10倍。尽管有观点认为订阅制的“内部额度”与真实现金支出不可直接等价比较,但数据揭示了一个核心事实:对于高频、长对话的编程场景,直接调用官方API往往具有更高的成本效益。
技术内核:KV Cache与稀疏注意力构筑的成本护城河
DeepSeek之所以能在高负载下维持相对稳定的服务,并拥有调整价格的空间,其底气来源于底层的架构创新。核心在于其KV Cache(键值缓存)的高效利用与稀疏注意力机制(Sparse Attention)的结合。
根据vLLM团队的架构拆解,V4模型采用了“Token-wise Compression + DeepSeek Sparse Attention (DSA)”技术。这一组合不仅实现了Key/Value的共享,更通过跨Token压缩显著降低了内存占用。在BF16精度下,V4百万Token上下文的KV Cache约为9.62 GiB,而V3.2版本则需要83.9 GiB,缩减幅度高达8.7倍。若进一步结合FP4索引缓存与FP8注意力缓存,实际部署时的显存占用可再降低约50%。这种极致的压缩能力,使得模型能够在有限算力下承载更长的上下文窗口,从而大幅摊薄单Token的计算成本。
此外,DeepSeek在缓存策略上的设计也远超行业平均水平。官方披露的三种缓存前缀落盘机制——包括自动缓存生成、公共前缀检测以及超长输入的固定间隔缓存——有效提升了缓存的复用率。特别是在“公共前缀检测”机制下,系统能主动识别并缓存多次请求中的共同部分,极大提高了实际命中概率。与之形成鲜明对比的是,其他模型如GLM在缓存持久化能力上较弱,长会话中缓存失效频繁,导致实际成本迅速攀升。
工程细节:Harness系统比模型智力更重要?
随着大模型应用的深入,竞争的焦点正从单纯的模型参数规模转向应用层的工程实现,即“Harness”系统。Harness涵盖了消息路由、记忆管理、工具调用优化等模块,是决定模型在实际任务中表现的关键。
测试数据显示,同一款DeepSeek V4 Flash模型,在不同Harness环境下的表现存在显著差异。在Codex环境中,模型能够保持对长程任务的全局理解,记忆连贯性强,不易陷入局部最优解;而在OpenCode环境中,模型更容易关注局部细节,导致在多轮交互中出现逻辑偏离或循环论证。这种差异主要源于Harness对上下文压缩(Compaction)策略的不同处理。Codex配置中明确了长任务下的上下文压缩行为,确保模型在压缩历史后仍能保持对初始目标的理解,而部分第三方平台则缺乏此类精细化控制。
这意味着,未来AI编程工具的竞争壁垒,可能不再仅仅是模型本身的“智力”高低,而是围绕模型构建的Harness体系的成熟度。消息路由的效率、长短期记忆的优化策略、工具调用的灵活性,这些工程层面的细节沉淀,正在成为比模型权重更深层的护城河。开发者在评估工具时,应更多关注其底层架构对上下文管理的优化能力,而非仅看表面的Token报价。
流量调控与服务稳定性的平衡艺术
关于DeepSeek可能通过涨价进行流量调控的猜测,反映了市场对供需平衡的深层焦虑。在当前高智、低价、高稳定性的“不可能三角”中,任何一方的突破都伴随着成本的上升或性能妥协。DeepSeek的高负载状态表明,其基础设施团队在应对海量并发请求时,依然保持了较高的服务水准。
此次价格调整的传闻,也可能是一种主动的供需管理策略。通过价格杠杆调节需求,缓解服务器过载,从而保障核心用户的服务体验。对于第三方平台而言,虽然短期能以低价吸引用户,但若缺乏底层架构的支撑,随着使用深度的增加,其隐性成本将逐渐显现。因此,开发者在选择模型服务时,应建立更全面的评价体系,综合考量缓存效率、上下文管理能力以及长期使用的综合成本,而非仅被表面的低价标签所误导。
结语:走向精细化的大模型应用时代
DeepSeek的价格策略及其背后的技术逻辑,为大模型行业提供了一个重要的观察样本。它表明,随着技术的成熟,大模型服务的竞争正从粗放的价格战转向精细化的效能战。缓存命中率的提升、推理精度的优化、以及Harness系统的完善,将成为降低成本、提升性能的关键路径。
对于开发者而言,理解这些底层技术细节,有助于更合理地选择工具与服务,避免陷入“低价陷阱”。而对于行业而言,这一趋势也预示着,未来的AI应用竞争,将是算力、算法与工程优化全方位的综合较量。只有那些能够持续在架构创新与工程落地上下功夫的企业,才能在激烈的市场竞争中立于不败之地。在这一过程中,透明的技术文档、开放的架构设计以及用户导向的优化策略,将是赢得市场信任的关键要素。