欧洲为何难产OpenAI?资本、算力与生态的三重断裂解析
资本鸿沟:从“银行主导”到“风险溢价”的结构性错位
在全球人工智能大模型竞赛的版图中,欧洲呈现出一种独特的悖论:这里拥有世界顶尖的学术机构、精密的工业制造能力和深厚的工程底蕴,却迟迟未能孵化出具有全球统治力的原生通用大模型公司。当美国凭借OpenAI、Anthropic等巨头在千亿美元融资和超级数据中心建设上高歌猛进时,欧洲才刚刚启动以百亿欧元为单位的公共算力基础设施计划。这种时间差并非偶然,而是源于底层金融生态与风险承受能力的根本性差异。
大模型训练本质上是一场极端的资本消耗战。外界常误以为算法突破或芯片采购即可决胜,但现实是,模型发布仅是入场券。后续持续的推理服务、海量数据清洗、安全测试以及应对指数级增长的用户需求,构成了无底洞般的运营成本。斯坦福大学《2026年AI指数报告》的数据直观地揭示了这一差距:2025年美国在生成式AI领域的私人投资高达1636亿美元,而整个欧洲仅为32亿美元,差距超过50倍。即便算上政府资金,这一数量级的悬殊依然令人咋舌。
这种差距的根源在于欧美金融体系的基因不同。美国拥有成熟的养老金、主权财富基金、私募股权和公开市场,这些资本愿意为遥远的未来提前定价,容忍长期亏损以换取技术垄断的可能。相比之下,欧洲金融体系高度依赖银行信贷。银行偏好拥有固定资产和稳定现金流的传统企业,难以对以人才和算法为核心资产、长期亏损的模型公司提供大额贷款。欧洲投资银行将此定义为“规模化融资缺口”:欧洲不缺早期科研资金,但缺乏支持企业从几百人扩张至千人、从单一产品走向全球市场的大规模风险资本。
此外,美国科技巨头通过云计算业务将模型投入纳入长期资本开支,形成了独特的生态支持。亚马逊、谷歌、Meta和微软自2023年以来在AI基础设施上投入已达1.1万亿美元。这意味着美国模型公司背后有全球最强大的算力供应商和分发渠道作为后盾。而欧洲初创公司必须独自面对融资、购芯、建厂和销售的全链条压力,这种不对称竞争使得欧洲原生大模型公司难以在起跑线上获得同等助力。
算力困境:产业链断裂与能源约束的双重夹击
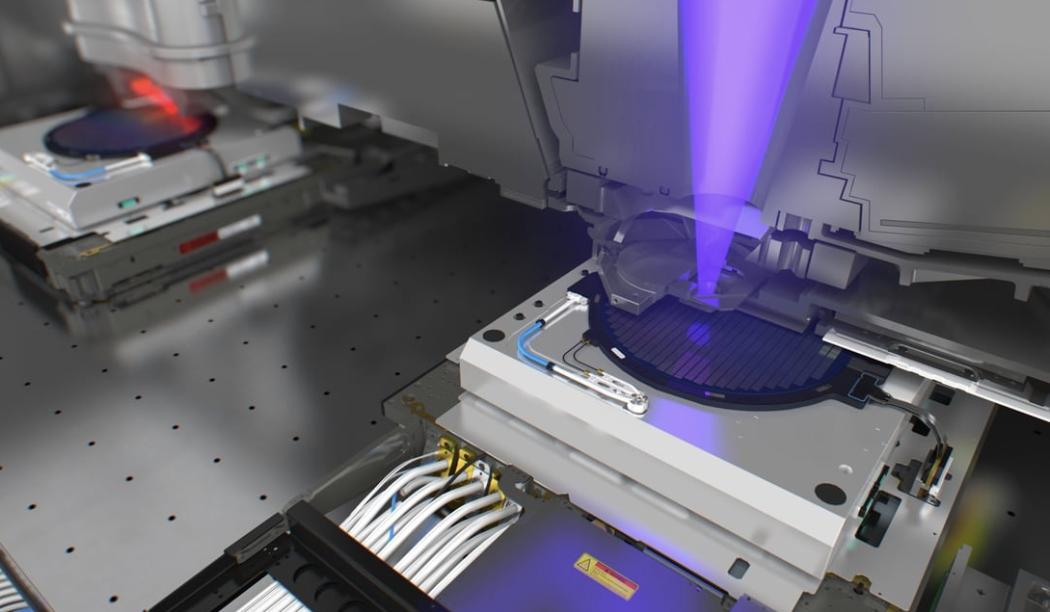
提及欧洲芯片产业,人们往往联想到ASML的光刻机或Arm的处理器架构。然而,这些单点优势无法直接转化为训练前沿大模型所需的完整算力闭环。AI算力是一个复杂的系统工程,涵盖芯片设计、先进制造、先进封装、服务器集成、数据中心部署及云平台调度。欧洲缺乏将上述环节整合为统一计算系统的龙头企业。
在AI芯片供应端,欧洲没有能与英伟达抗衡的供应商;在制造端,缺乏台积电式的尖端代工能力;在云服务端,全球五大云服务商中无一来自欧洲。这种产业链的碎片化导致欧洲大模型团队不得不采用美国设计的GPU,在亚洲制造,再使用美国或中国的云服务。这种跨国界的复杂链路不仅增加了延迟和成本,更使得核心算力资源受制于人。
欧盟近期启动的7座AI超级工厂计划,旨在通过约300亿欧元的投资补齐这一短板。然而,该计划本身也暴露了欧洲算力短缺的严峻现实。据法国《世界报》报道,欧洲现阶段无法自主生产超级工厂所需的前沿AI芯片,首批项目仍将大量依赖英伟达和AMD处理器。更棘手的是能源成本问题。欧洲数据中心的电价普遍达到美国和中国的2至3倍。对于大模型而言,训练成本虽高,但日常推理服务的长期支出更为惊人。每一次用户交互都在消耗算力,电价和芯片价格的微小差异在数亿次调用中被无限放大。
此外,欧洲内部的能源结构差异也为统一算力网络增加了难度。法国拥有核电优势,北欧拥有低碳能源,而德国等工业大国则面临电网扩容和选址难题。统一的AI计划最终需在各国不同的电力政策和审批体系中艰难循环。欧洲需要的不是孤立的数据中心,而是一条能够持续扩张、低成本、高效率的AI计算链路,这在当前的地缘政治和能源格局下显得尤为艰难。
生态错位:工业基因与消费互联网的分野
回顾大模型竞争格局,已从OpenAI一家独大转向科技巨头与明星团队并行的双轨制。美国拥有微软、谷歌、亚马逊和Meta,中国有阿里、腾讯、字节和百度。这些科技巨头不仅拥有充沛的现金流,更关键的是它们掌握了现成的分发体系。模型能力升级后,可无缝嵌入搜索、办公、社交和云服务中,通过用户反馈快速迭代,并利用开发者生态完成商业化。这是一种集资金、算力、产品和分发于一体的复合优势。
欧洲的跨国巨头则呈现出截然不同的形态。SAP、西门子、博世、施耐德电气和达索系统控制着大量企业流程与工业数据,但它们缺乏数十亿普通消费者每天打开的超级入口。欧洲的“BAT”大多长在工厂里,而非消费互联网中。以西门子为例,其推出的Siemens Xcelerator平台试图连接工业硬件、软件和数据,并与英伟达合作打造工业AI操作系统。西门子的战略并非训练通用基础模型,而是利用其积累的工业知识和客户关系,让英伟达提供计算底座,自身专注于垂直领域的商业化。
这种路径差异决定了欧洲难以复制OpenAI的模式。欧洲央行研究显示,欧洲制造业在AI应用方面并不落后,但工业AI部署速度较慢,却拥有更明确的客户、更高的迁移成本和更深的数据壁垒。欧洲的优势在于掌控模型进入工厂后的关键环节,而非在通用大模型上与中美正面竞争。这是一种基于垂直领域的“隐形冠军”路径,而非基于流量和规模的“平台垄断”路径。
案例透视:Mistral的突围与局限
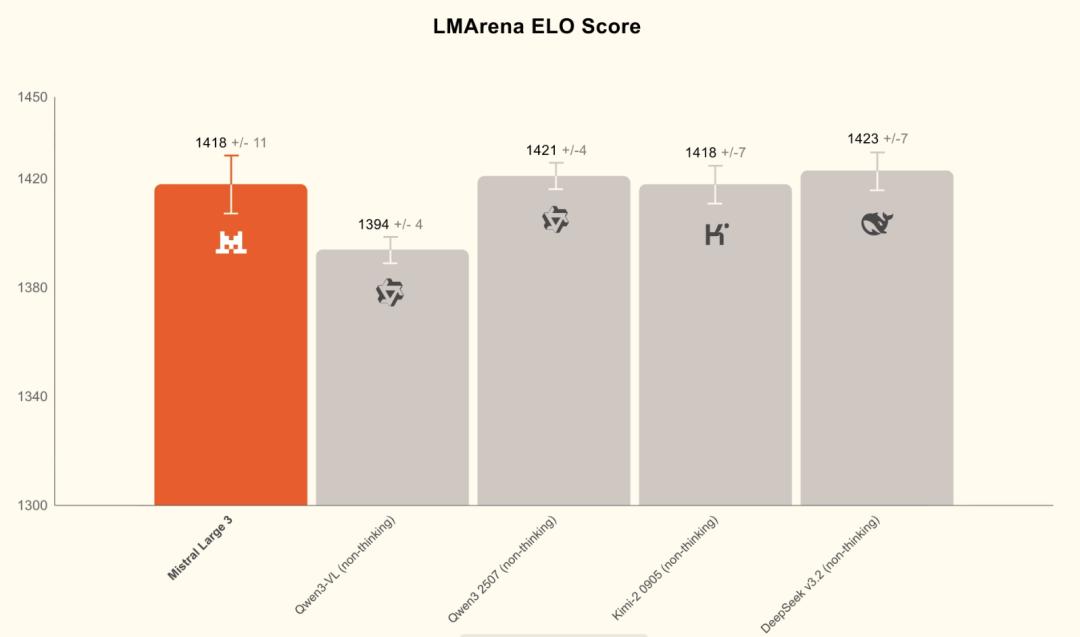
若要在欧洲寻找最接近OpenAI形态的公司,Mistral无疑是最佳样本。这家成立于2023年的法国公司,核心团队来自DeepMind和Meta,其Mistral Large 3模型在开源榜单上名列前茅,并被赋予“主权AI”的战略意义。Mistral早期采取开源策略,以有限资源快速建立影响力,避开了与OpenAI在超大模型上的直接消耗。
然而,Mistral面临的挑战同样严峻。当它进入市场时,ChatGPT已完成全球用户教育,微软、谷歌等巨头已将AI嵌入核心产品。Mistral不仅要训练基础模型,还要开发类似ChatGPT的Le Chat应用,建设本土数据中心,并拓展企业销售体系。据其计划,Mistral在基础设施上投入约40亿欧元,并通过借款支持数据中心建设。这对欧洲初创公司而言已是罕见规模,但与美国头部企业的资本支出相比仍显单薄。
更关键的是分发问题。Mistral模型虽已进入Azure、AWS、GCP等全球云平台,但这意味着客户入口和开发者关系仍掌握在外部平台手中。Mistral希望代表欧洲减少对美国AI的依赖,但扩大商业影响又难以绕过美国云生态。今年7月,Mistral与微软达成数十亿美元协议,正是这种依赖的体现。Le Chat尚未形成ChatGPT式的消费级产品飞轮,Mistral更像是一家模型与企业AI基础设施供应商,而非全球用户服务的大模型厂商。
人才流动与未来路径:从“复制”到“重构”
欧洲人才的流动进一步加剧了这种差距。巴黎、伦敦、苏济世等地是重要的AI人才中心,但美国公司通过更高薪酬、充足算力和成熟退出体系吸收人才。欧洲央行数据显示,2008年至2021年间,近30%的欧洲独角兽迁往海外,绝大多数流向美国。欧洲承担教育、基础研究和早期创业风险,美国生态则获得规模化商业收益。
这并不意味着Mistral的失败,而是揭示了欧洲AI发展的真实逻辑。Mistral被要求同时扮演模型公司、云基建者、软件供应商和技术主权象征,这在欧洲创业环境下几乎是不可能完成的任务。欧洲AI真正需要回答的问题,不是能否再训练出一个高分模型,而是能否让资本、芯片、云、市场和人才收益留在同一套产业系统中。
7座AI超级工厂可以补上算力缺口,但这只是第一步。在闭环形成之前,欧洲很难拥有自己的OpenAI。然而,这并非劣势。欧洲或许无法在通用大模型领域复制美国路径,但完全有可能在制造、能源、汽车、医疗等垂直领域建立主导性的AI平台。未来的竞争格局,可能不是欧洲诞生一个OpenAI,而是欧洲通过西门子、SAP等工业巨头,掌控模型进入实体经济的关键入口,形成一种不同于中美“平台+流量”模式的“工业+数据”新范式。这种路径虽不喧嚣,却可能更具韧性和长期价值。