8B模型颠覆设计流:商汤U1.5如何实现草图到4K海报的精准跃迁
在人工智能内容生成的浪潮中,我们正经历从“随机惊喜”向“精准控制”的深刻转型。过去,许多设计师面对AI绘图工具时,最大的痛点并非生成质量不足,而是不可控性太强。一旦需要修改海报上的一个日期或调整某个图标的位置,往往意味着整个画面的重新生成,原本满意的构图与光影随之崩塌。然而,随着商汤科技最新开源的SenseNova U1.5-Lite-Preview模型的发布,这一困境正在被彻底改写。这款基于8B-MoT轻量化规模的原生统一多模态模型,不仅证明了小参数模型也能具备硬核的生成与编辑能力,更通过其独特的架构设计,为商业设计领域提供了一套可落地、高精度的解决方案。
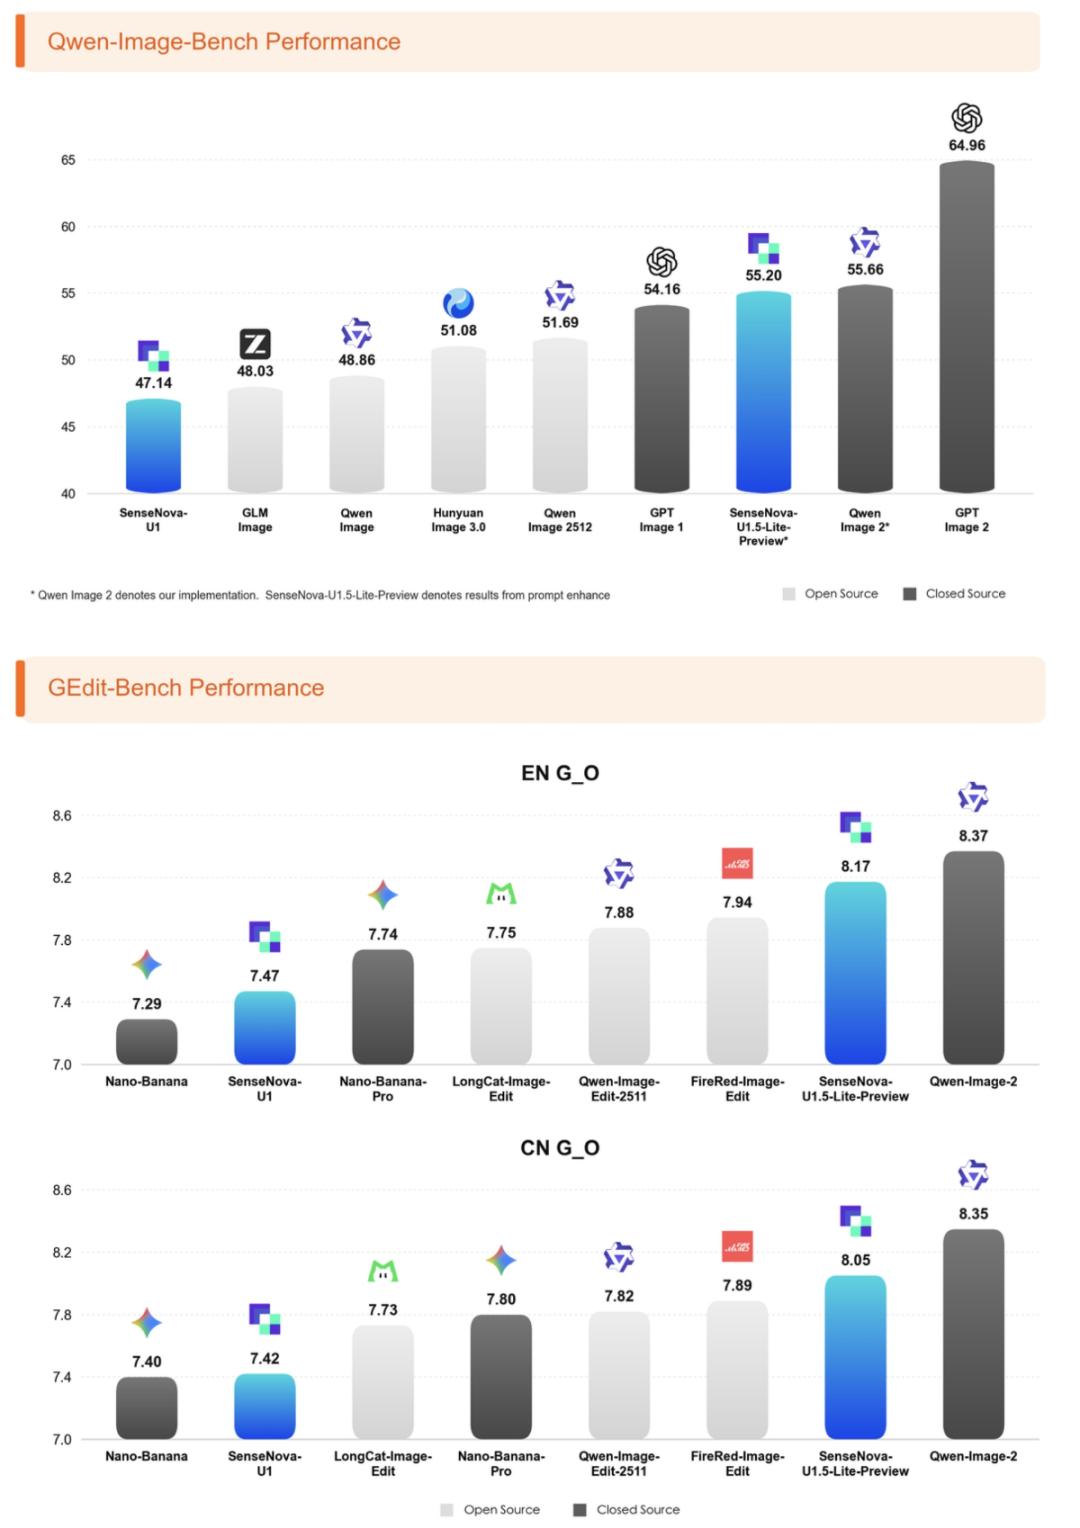
传统多模态模型往往采用拼接式架构,即视觉编码器与大语言模型分别训练后再进行对接,这种模式在处理复杂视觉任务时容易出现信息损耗与指令对齐偏差。SenseNova U1.5-Lite-Preview则摒弃了这种低效模式,采用了商汤自研的NEO-Unify原生统一多模态架构。在这一架构下,模型在单一网络内部实现了多模态信息的统一表征与交互。这意味着,模型不再是简单地“看”图然后“说”话,而是真正具备了视觉推理能力,能够理解图像的空间结构、语义逻辑以及风格特征。评测数据显示,该模型在Qwen-Image-Bench中的成绩从上一代的47.14分大幅跃升至55.20分,而在衡量图像编辑能力的GEdit-Bench测试中,其中英文项得分均超越了许多参数量更大的闭源模型。这一数据背后的意义在于,轻量化模型不再仅仅是大型模型的“简化版”,而是在特定垂直场景下具备更强竞争力的独立个体。
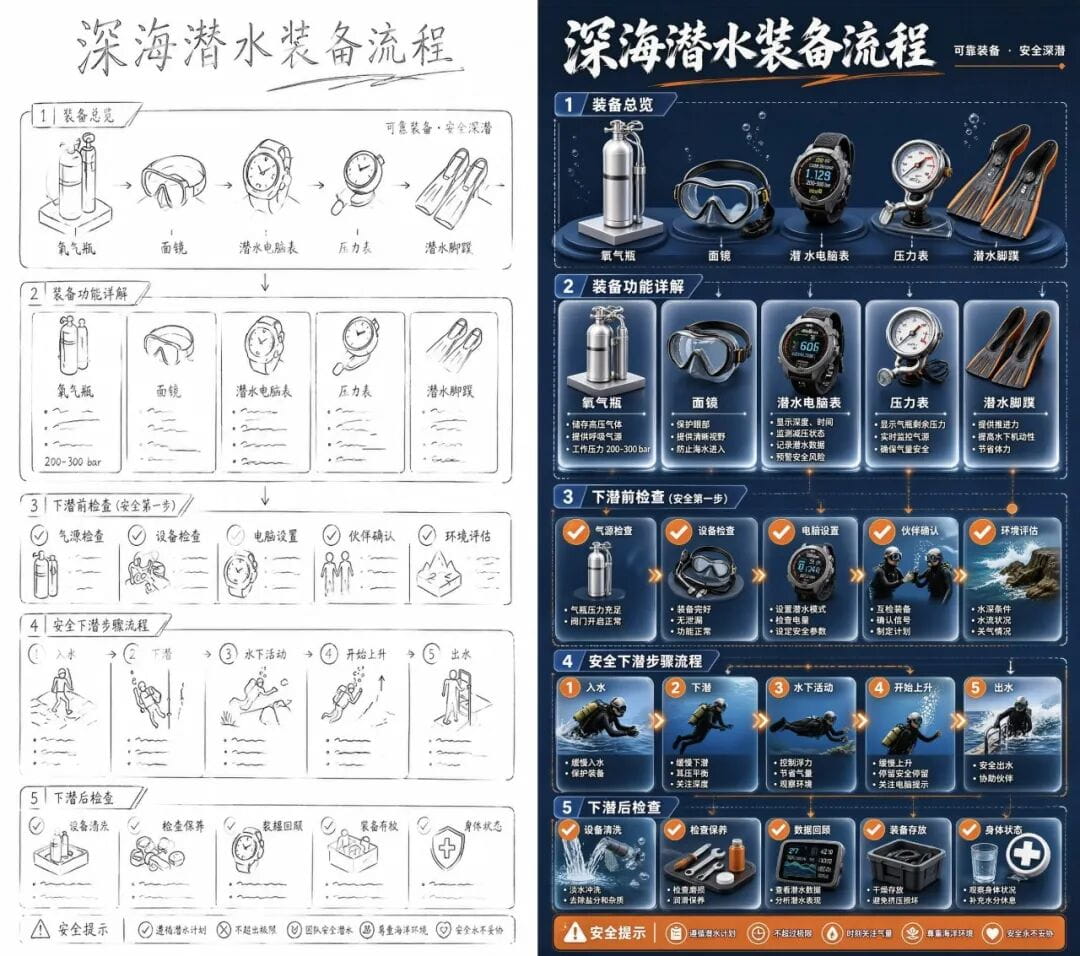
对于商业设计而言,最核心的需求往往不是天马行空的想象,而是对既定结构的严格遵循。以一张手绘草图为例,设计师可能只画出了简单的线条、栏目框架和流程箭头,但要求AI将其转化为符合出版标准的“深海潜水装备流程”高精海报。在这个过程中,AI不仅需要识别出氧气瓶、面镜等具体物体,更要保留“装备总览、功能详解、下潜前检查”等五部分的结构布局,并为不同栏目补充相应的图片、图标和说明文字。SenseNova U1.5-Lite-Preview展现了惊人的结构保持能力,它能够将粗略的构想转化为深蓝科技风的完整设计图,同时确保文字层级清晰、视觉风格统一。这种能力得益于其对长上下文视觉控制的优化,使得模型在面对长篇、多约束的提示词时,能够将详细的要求精准落实到画面的每一个角落,而不是仅仅捕捉几个关键词进行自由发挥。
除了对结构的把控,画质的精细度也是衡量商业可用性的关键指标。SenseNova U1.5-Lite-Preview原生支持4K图像生成,这对细节呈现提出了极高要求。在生成一幅渔民整理渔网的画面时,模型不仅准确还原了渔网交错的线结、船身斑驳的油漆以及机械设备上的锈迹,还完美处理了远处水面倒影、岸边房屋和电塔的空间层次关系。即使在容纳大量细碎物体的情况下,人物、渔网和船舱设备之间依然保持了清晰的边界,整体光影与色彩高度统一。这种高分辨率下的细节一致性,使得生成的图像可以直接用于印刷品或大型展示屏幕,极大地缩短了从数字生成到物理输出的后期处理流程。
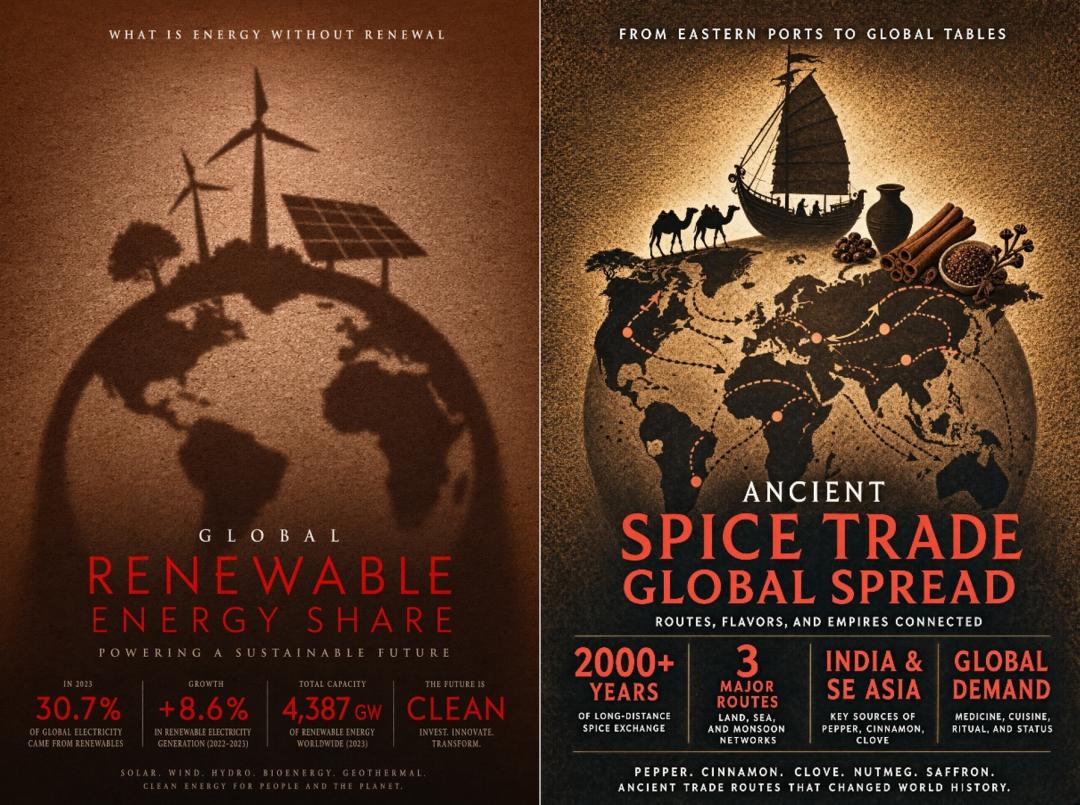
在创意发散阶段,参考图创作是设计师常用的手段。用户往往希望借鉴某张图片的配色、构图或设计语言,但将主题替换为自己的内容。SenseNova U1.5-Lite-Preview在此方面表现出了极高的灵活性。例如,在以可再生能源主题海报为参考生成“古代香料贸易”海报的案例中,模型成功沿用了原图的棕褐色复古质感、红白大字排版和剪影式构图,同时将风机和太阳能板替换为帆船、骆驼和陶罐,并在地球背景中加入了跨区域贸易路线。新海报虽然主题完全改变,但在视觉语言上与参考图保持了高度的呼应。更进一步,模型还能处理多张参考图的组合任务,分别从不同图片中提取人物的外貌、服饰特征,并将其融合到同一场景中,通过光影和色彩的协调,实现多元素的有机统一。这种能力极大地丰富了素材库的利用率,让设计师能够从海量现有资源中快速提取灵感并重组创新。
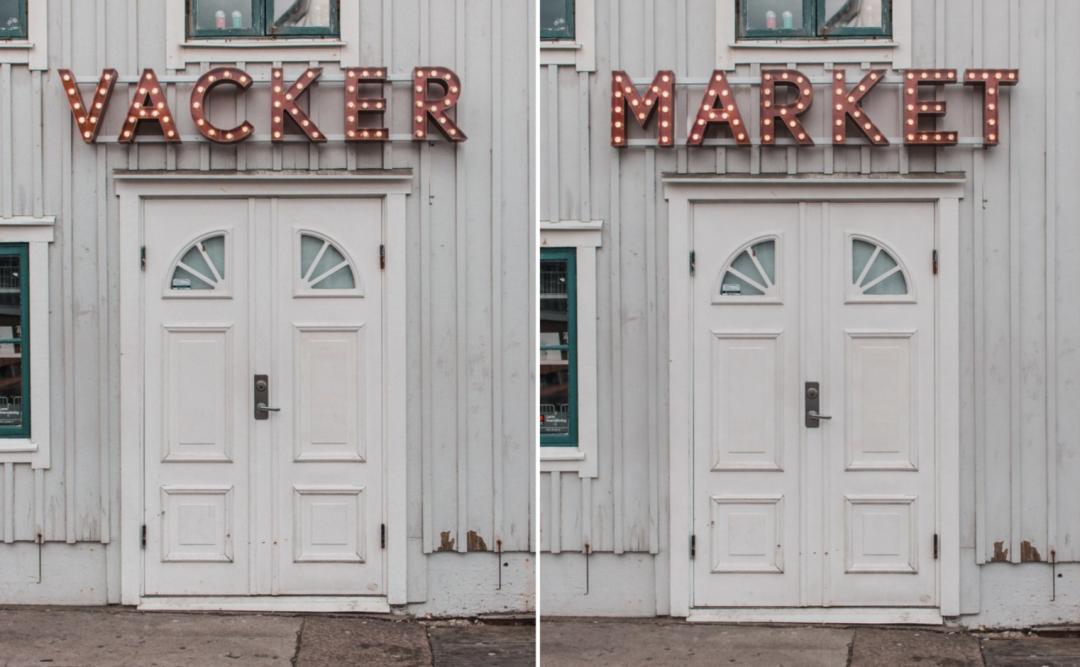
然而,真正让这款模型区别于普通绘图工具的,是其精细化的图像编辑能力。在实际工作流中,大部分时间并非用于从零生成,而是对已有成果的微调。SenseNova U1.5-Lite-Preview能够精准判断“哪里需要改,哪里不能动”。在桥梁加固海报的排版调整案例中,模型将“改造前后”的对比图放大并移至画面中央,同时调整主标题位置,而背景中的铁路桥、原有文字内容及工业风格背景则基本保持不变。这种局部修改而不破坏整体一致性的能力,解决了传统AI绘图“牵一发而动全身”的难题。特别是在文字替换场景中,模型不仅能正确替换字符,还能保留原有字体的立体造型、灯泡排列、金属质感及光照效果,使得新文字看起来仿佛是原始拍摄或设计的一部分,而非后期拙劣的贴图。
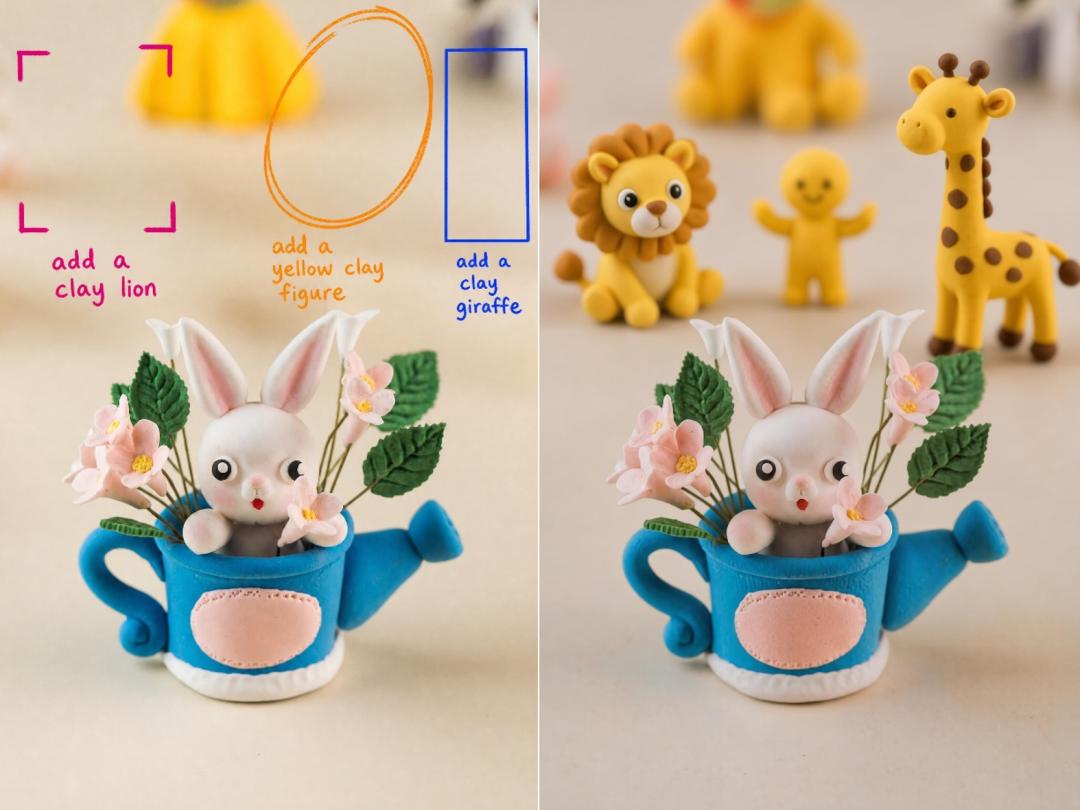
为了进一步降低操作门槛,模型还支持通过圈画标记进行指定区域的编辑。用户只需在图片中圈出目标区域,并通过提示词说明需要添加或删除的内容,模型即可在指定位置生成符合原图质感的新元素。例如,在添加黏土狮子、人偶和长颈鹿的案例中,新增角色不仅在位置上准确无误,其黏土质感、光影方向和景深效果也与原图中的兔子、花朵等元素完美融合。这种多粒度的编辑方式,涵盖了从局部元素、画面文字到指定区域的全面控制,使得图片生成不再是一次性的输出结果,而是一个可迭代、可修正的创作过程。用户可以基于初稿不断调整文案、版式和画面元素,逐步逼近最终的设计预期。
从技术演进的角度来看,SenseNova U1.5-Lite-Preview的出现标志着国产开源多模态模型在商业化落地与可控生成领域取得了重要突破。它证明了在有限的模型规模内,通过架构创新和训练策略优化,完全可以实现生成质量、编辑稳定性和视觉控制力的同步提升。对于广大开发者和设计师而言,这意味着更低的使用成本和更高的创作自由度。虽然Photoshop等传统工具在极端精细的处理上仍有其不可替代性,但在日常的海报调整、素材重组和快速原型设计中,AI已经能够承担绝大部分重复性工作,让人类创作者将精力集中在更具创造性的构思与决策上。
随着正式版模型的即将推出,我们有理由期待其在图像生成和编辑方面的进一步完善。未来的多模态模型竞争,将不再单纯局限于参数规模的军备竞赛,而是转向对垂直场景需求的深度理解与工作流的高效整合。SenseNova U1.5-Lite-Preview所展现出的“看懂、生成、编辑”闭环能力,正是这一趋势的典型代表。它不仅让图片“活”了起来,更让设计变得前所未有的灵活与高效,为AIGC技术在专业领域的深入应用奠定了坚实的基础。