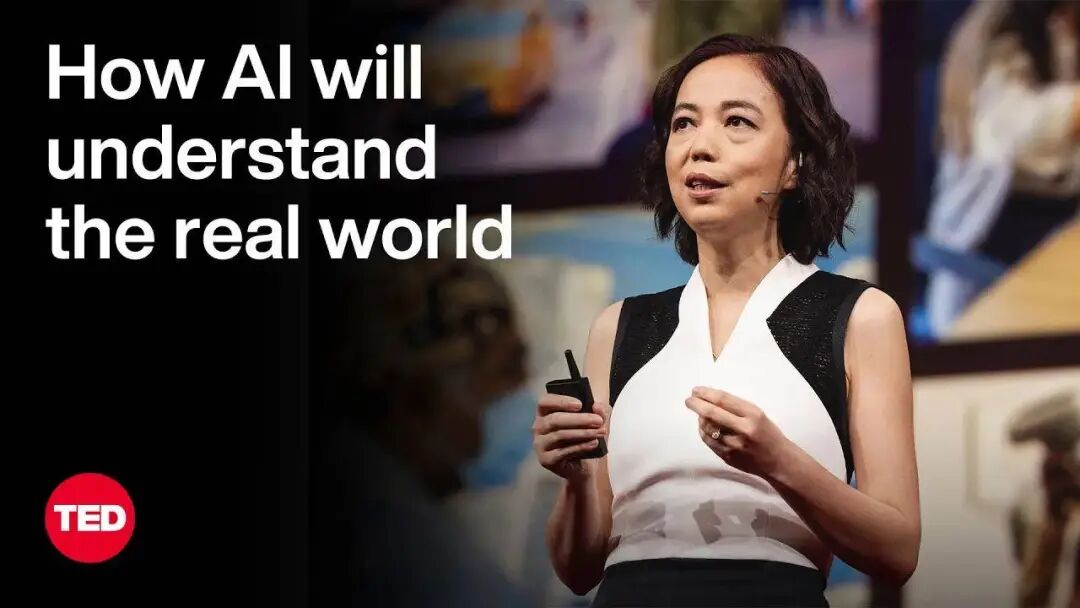
从ImageNet到T-Rex:李飞飞如何赋予AI真实的物理触感与空间智能
视觉的局限与物理世界的鸿沟
在人工智能发展的早期阶段,计算机视觉被视为让机器“看懂”世界的钥匙。2009年,ImageNet数据集的发布标志着这一领域的里程碑,它教会了算法识别猫、狗、汽车等静态对象。然而,随着技术深入应用,业界逐渐发现,仅仅能够识别图像中的物体标签,并不等同于理解物理世界。当AI试图从数字屏幕走向实体空间时,一种深刻的认知错位开始显现。
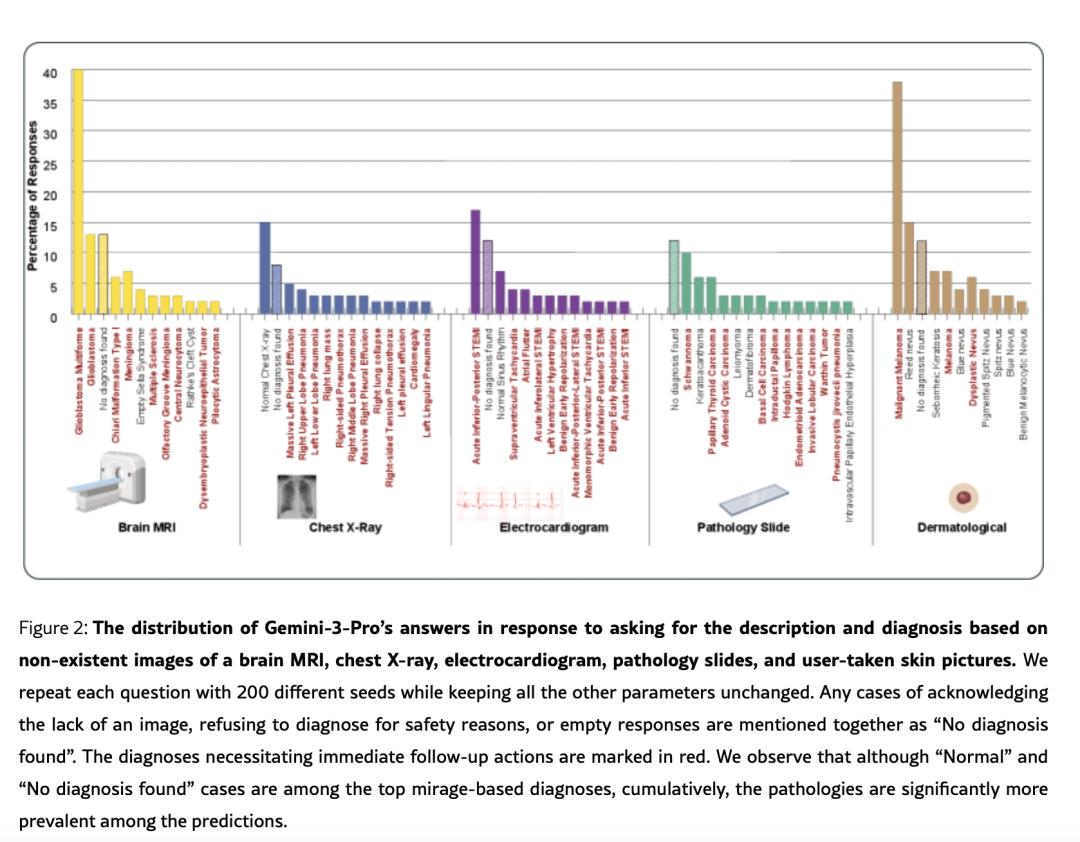
这种错位在近期的多模态大模型测试中暴露无遗。研究人员发现,即使不输入任何图像,许多先进的视觉语言模型仍能对视觉问题给出看似合理的回答。这种现象被称为“幻景推理”,即模型并非基于真实的视觉证据进行判断,而是依靠训练数据中的文本统计规律进行猜测。在聊天场景中,这种偏差或许可以被容忍,但在物理操作中,几厘米的距离误差或几牛顿的力度偏差,都可能导致任务失败甚至设备损坏。
机器人面临的挑战在于,物理世界是连续、动态且充满不确定性的。摄像头可以提供丰富的语义信息,如“这是一个杯子”,但它难以精确回答“杯子表面有多滑”、“抓取时需要施加多大的力”以及“手指是否正在打滑”等问题。这些细微的物理属性,构成了智能体与环境交互的基础,却长期处于传统视觉系统的盲区。
世界模型:从生成像素到模拟物理
为了解决视觉感知的不足,行业开始转向构建更复杂的“世界模型”。早期的世界模型主要侧重于视频生成,能够根据文本提示创造出逼真的动态场景。然而,对于具身智能而言,视频的逼真度并不等同于物理的真实性。一个在视频中完美穿过街道的汽车,可能在物理引擎中因为缺乏摩擦力参数而瞬间失控。
真正的世界模型需要具备几何结构、物理属性和动态变化的模拟能力。这意味着模型不仅要能“画”出世界,还要能“计算”世界。例如,当机器人伸手去拿一个苹果时,系统需要预测手臂运动对周围空气的影响、手指接触果皮时的形变程度以及重力对物体姿态的改变。这种基于物理规律的预测,是机器人进行长期规划和安全操作的前提。
目前,包括英伟达Cosmos在内的多个平台正在尝试将世界生成、视频预测与机器人训练整合在一起。通过大量的合成数据,机器人在虚拟环境中反复试错,学习不同材质、不同光照条件下的操作策略。这种方法极大地降低了真实世界训练的成本和风险,使得机器人可以在数百万次虚拟失败中积累经验,从而在现实中表现出更高的鲁棒性。
触觉:高频反馈下的即时修正
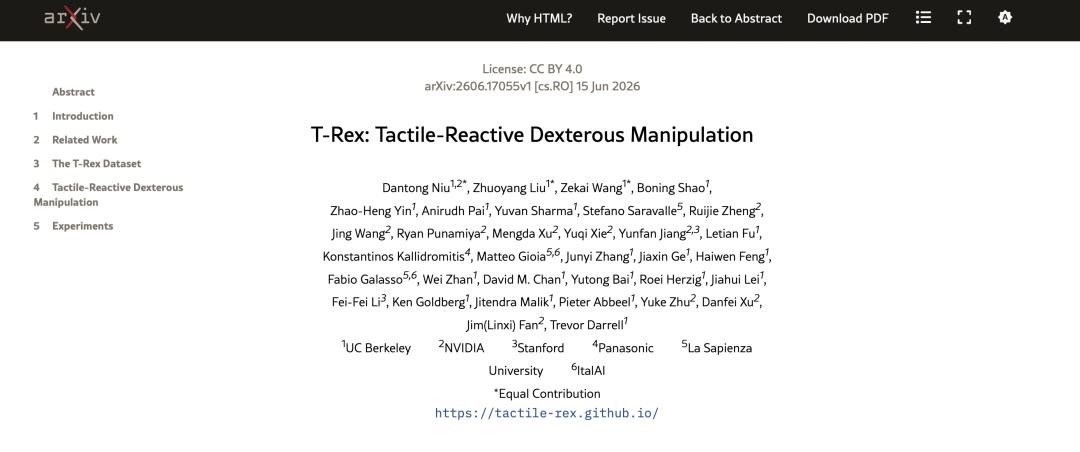
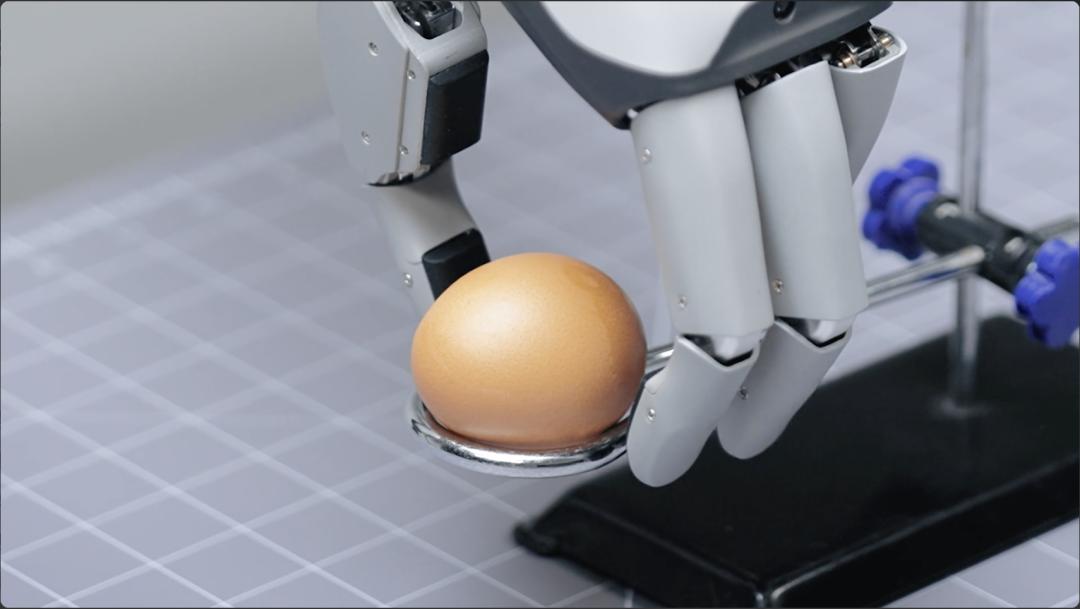
尽管视觉和世界模型提供了宏观的环境认知,但在微观的操作层面,触觉依然不可或缺。李飞飞团队参与的T-Rex研究明确指出,触觉信号具有高频、局部的特点,适合处理接触瞬间的快速变化。当机器人抓取鸡蛋时,视觉系统可能只能看到手指接近蛋壳,而触觉传感器则能实时监测压力的微小增加,防止蛋壳破裂。
T-Rex系统采用了一种分层控制架构:视觉系统负责低频的全局规划,确定“做什么”;触觉系统负责高频的局部修正,确保“做得对”。这种分工符合生物神经系统的运作机制,即大脑负责决策,脊髓和周围神经负责反射。研究表明,直接将触觉数据融入现有的视觉-语言-动作模型效果不佳,因为不同感官的时间尺度存在巨大差异。只有将触觉作为独立的快速反馈回路,才能有效应对滑动、碰撞等突发状况。
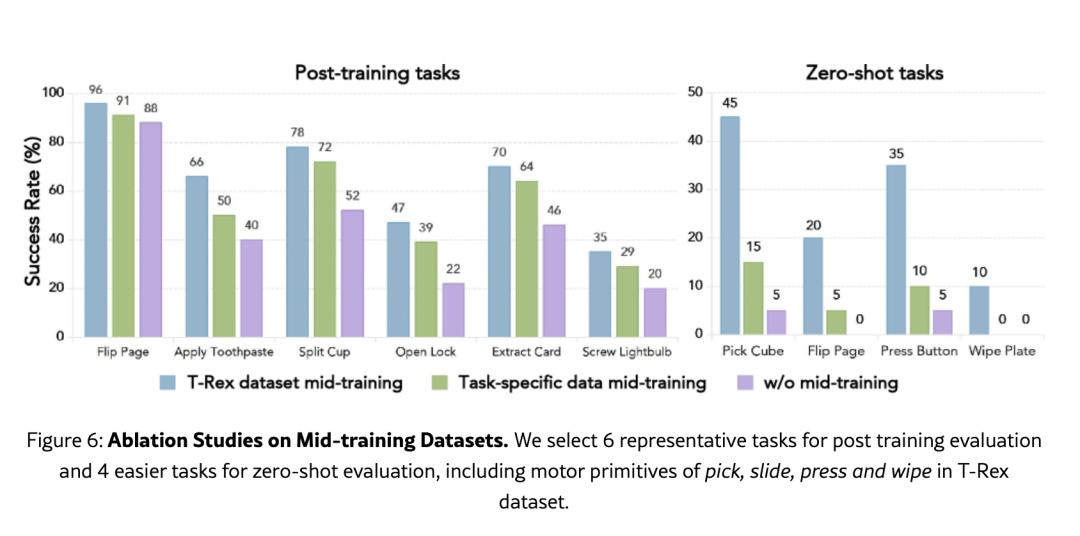
在实际测试中,配备高频触觉反馈的机器人在翻书页、挤牙膏、拧灯泡等精细操作任务中,成功率显著高于仅依赖视觉的对照模型。特别是在处理透明物体、反光表面或柔软材料时,触觉提供的力觉信息成为了决定成败的关键因素。这证明,触觉不仅仅是视觉的补充,更是具身智能实现精细操作的必要条件。
多模态融合的系统性挑战
将视觉、触觉和本体感知融合到一个统一的控制系统中,面临着巨大的工程挑战。首先,不同传感器的数据格式、采样频率和噪声特性各不相同,需要进行复杂的时空对齐。其次,多模态数据的处理对计算资源提出了极高要求,尤其是在边缘设备上实现实时响应,需要高效的算法优化和硬件加速。
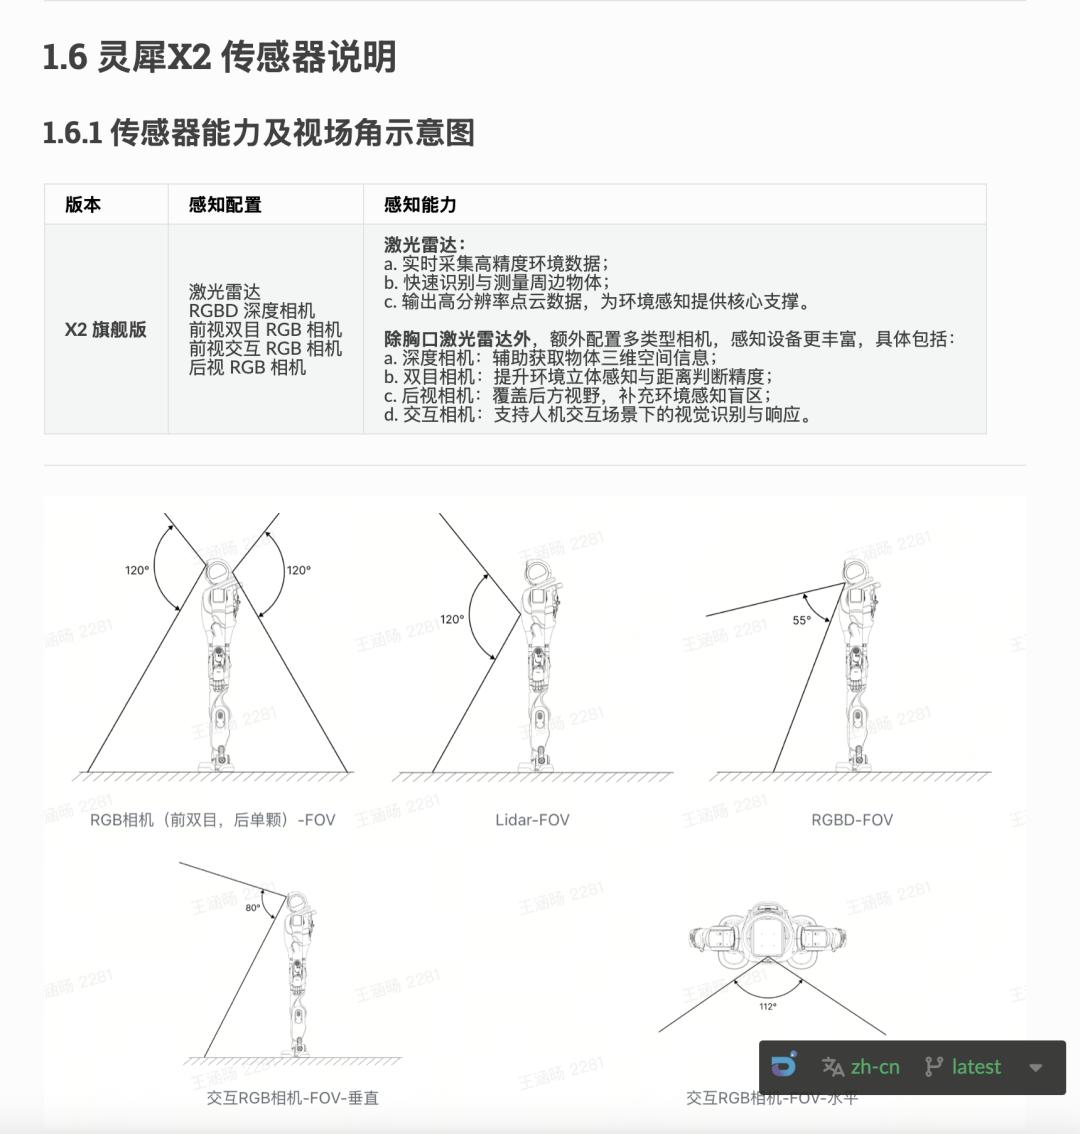
此外,数据的稀缺性也是制约多模态学习的重要因素。相比于海量的互联网图像数据,高质量的机器人操作数据,尤其是包含丰富触觉信号的数据,极其匮乏。T-Rex研究团队收集了100小时的触觉操作数据,但这对于训练通用的具身智能模型来说仍然远远不够。因此,如何利用仿真数据弥补真实数据的不足,以及如何设计有效的自监督学习算法,成为当前研究的热点。
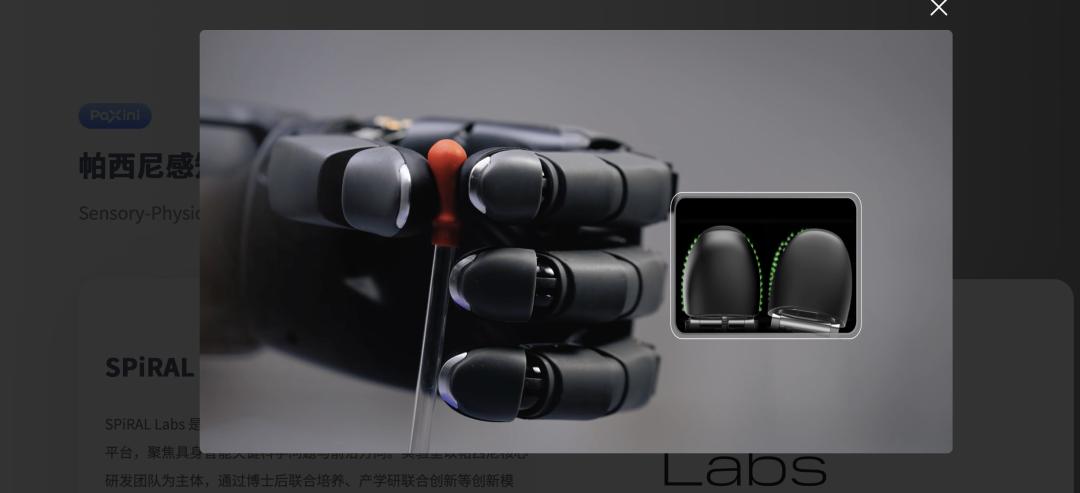
国内厂商如帕西尼、智元等也在积极探索触觉传感器的商业化应用,试图通过标准化的硬件模块和数据采集方案,降低具身智能的研发门槛。这些努力不仅推动了传感器技术的进步,也为多模态数据的积累奠定了基础。
具身智能的未来范式
李飞飞的研究路线演变,反映了人工智能从“感知智能”向“认知智能”再到“行动智能”的演进逻辑。ImageNet解决了“是什么”的问题,空间智能解决了“在哪里”的问题,而具身智能则要解决“怎么做”的问题。在这个过程中,AI不再是一个被动的观察者,而是一个主动的参与者。
未来的具身智能系统将更加注重身体与环境的耦合。机器人将通过不断的物理交互,建立对世界因果关系的深刻理解。这种理解不是基于统计相关性,而是基于物理定律和实践经验。例如,机器人会通过多次尝试,学习到推门时需要施加特定的力和角度,而不是仅仅识别出门的形状。
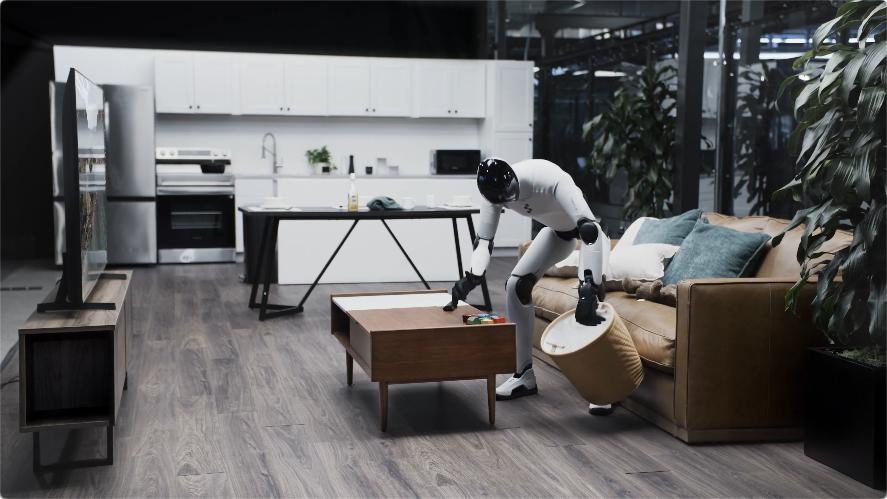
这种范式的转变,将对制造业、服务业和家庭护理等领域产生深远影响。具备真实“手感”的机器人,将能够胜任更多非结构化环境下的复杂任务,如整理杂乱房间、照顾老人小孩、进行精密装配等。这不仅提升了生产效率,也拓展了人工智能的应用边界。
技术落地与伦理考量
随着具身智能技术的成熟,其落地应用也伴随着一系列伦理和社会问题。首先,数据隐私和安全成为关注焦点。机器人在家庭环境中收集的多模态数据,包含大量个人隐私信息,如何确保这些数据的安全存储和使用,是亟待解决的问题。
其次,机器人的行为责任归属也是一个法律难题。当具备自主决策能力的机器人在操作中造成损害时,责任应由开发者、使用者还是机器人本身承担?这需要法律法规的及时跟进和完善。
此外,技术普及可能带来的就业冲击也不容忽视。虽然具身智能将创造新的工作岗位,但也可能替代部分传统劳动力。社会需要建立相应的培训和社会保障体系,以帮助受影响的群体顺利过渡。
结语
从ImageNet到T-Rex,人工智能正在经历一场从虚拟到现实的深刻变革。视觉赋予了AI观察世界的能力,而触觉则赋予了AI改变世界的能力。在这场变革中,李飞飞等科学家的探索为我们指明了方向:真正的智能,不仅在于知道世界是什么样,更在于知道如何与世界互动。
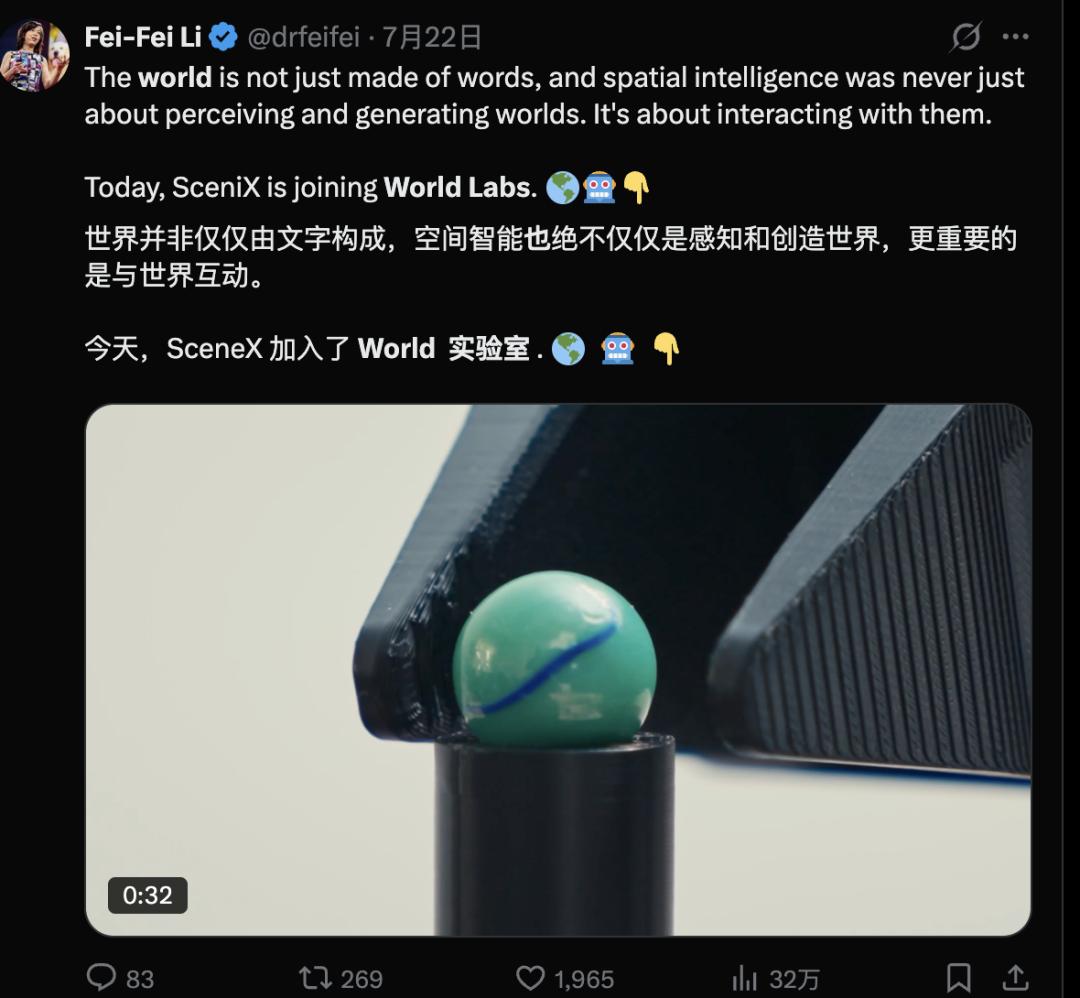
未来,随着传感器技术的进步、算法的优化以及算力的提升,具身智能将迎来爆发式增长。我们有理由相信,拥有真实“手感”的机器人,将成为人类生活中不可或缺的伙伴,共同构建一个更加智能、高效和美好的物理世界。这一过程不仅是技术的迭代,更是人类对自身智能本质理解的深化。