生成模型第三轴:探索式建模如何打破端到端训练瓶颈
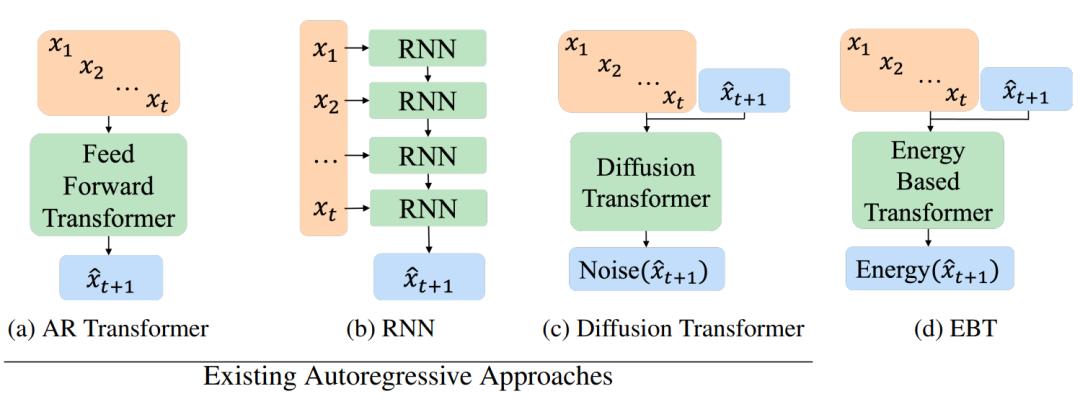
在深度学习的演进历程中,端到端学习始终被视为提升模型性能的黄金法则。自2012年AlexNet颠覆图像识别领域以来,从分类到检测再到分割,几乎所有计算机视觉任务的突破都源于将复杂流程整合为单一的可微分网络,让模型自行学习特征映射。然而,在这一普遍规律之外,生成模型却长期处于一种尴尬的半端到端状态。无论是占据主导地位的自回归模型还是近年来异军突起的扩散模型,它们在训练时仅预测单步目标,而在推理时却需通过数百甚至上千次的迭代采样来构建完整输出。这种训练与推理过程的割裂,不仅导致了著名的“暴露偏差”问题,更使得误差在逐步生成中层层累积,成为制约生成质量进一步提升的核心瓶颈。
近期,来自伊利诺伊大学厄巴纳-香槟分校(UIUC)与哈佛大学的研究团队提出了一种名为“探索式建模”(Explorative Modeling,简称XM)的新范式,试图填补生成模型在端到端训练上的最后一块拼图。这项研究的核心洞察极为朴素却极具颠覆性:生成模型除了参数规模和数据体量这两根传统的扩展轴之外,还存在第三根可被放大的轴——生成表达力。通过引入一个简单的循环机制,XM成功解决了长期困扰生成领域的“模式模糊”难题,并在多个模态上验证了其显著的扩展收益。
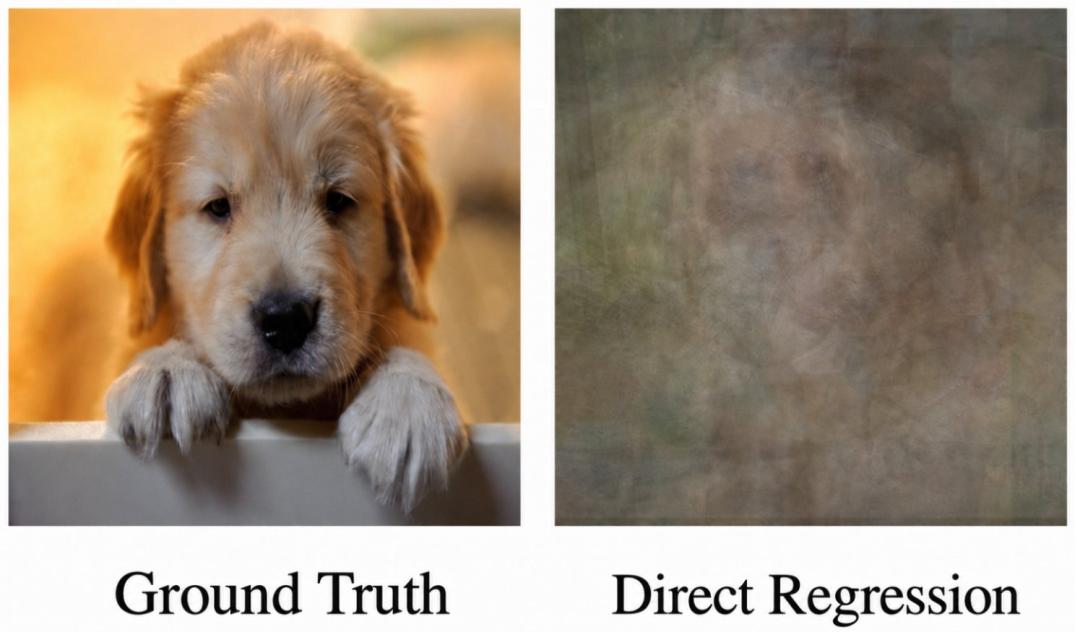
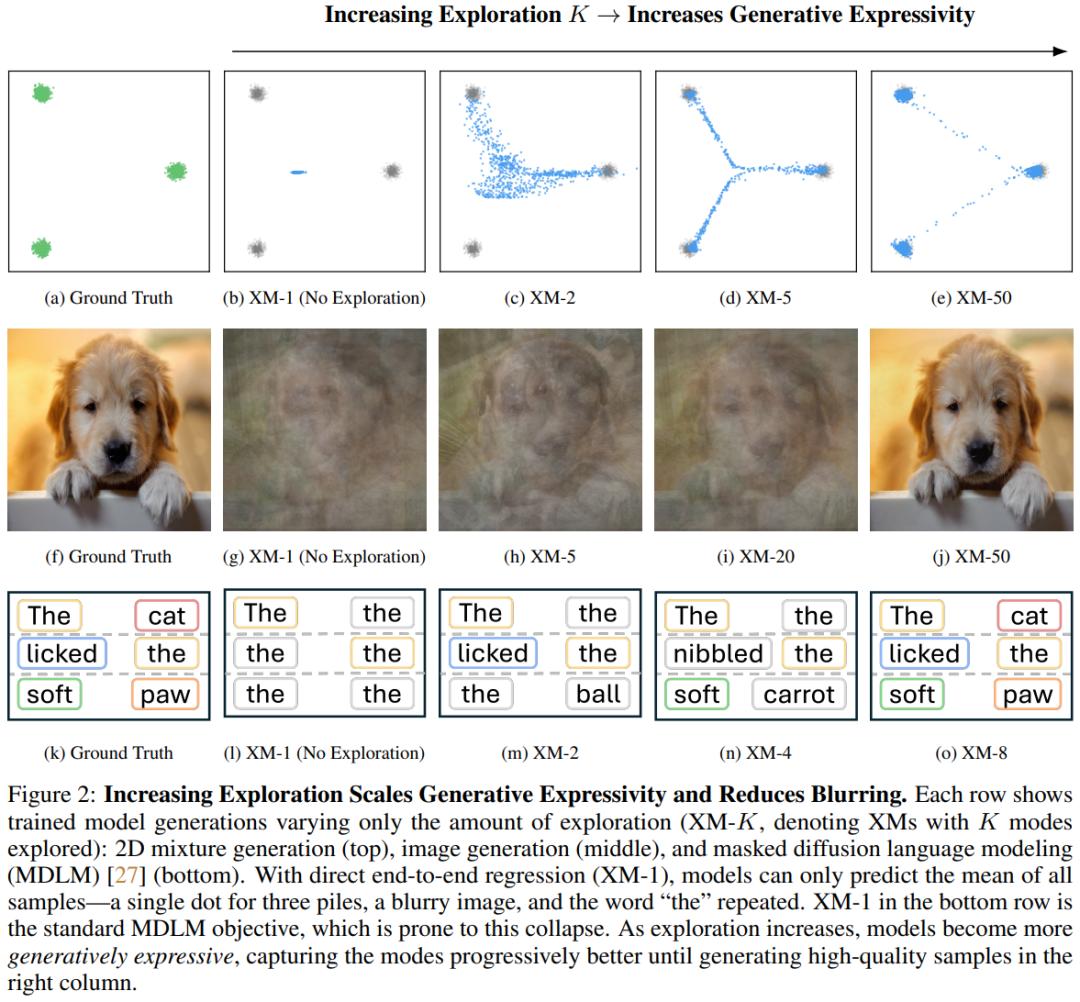
要理解探索式建模的价值,首先必须厘清生成任务与传统监督学习的本质差异。在图像分类等判别式任务中,每个输入通常对应唯一的正确答案,模型只需学习一个确定的映射函数即可。然而,生成任务面对的是一个多模态的数据分布。以“生成一只狗”为例,合法的输出空间包含无穷多种姿态、品种和背景的組合,这些合法解构成了数据分布中的多个独立峰值(Mode)。传统生成模型在训练时广泛采用的重构损失(如均方误差),在面对多模态分布时存在天然的缺陷:当模型试图最小化所有可能目标的平均误差时,其最优解往往落在各个模式之间的空白区域,即所谓的“平均值”。这种数学上的最优解在视觉上表现为模糊的图像或退化的文本,即“模式模糊”现象。
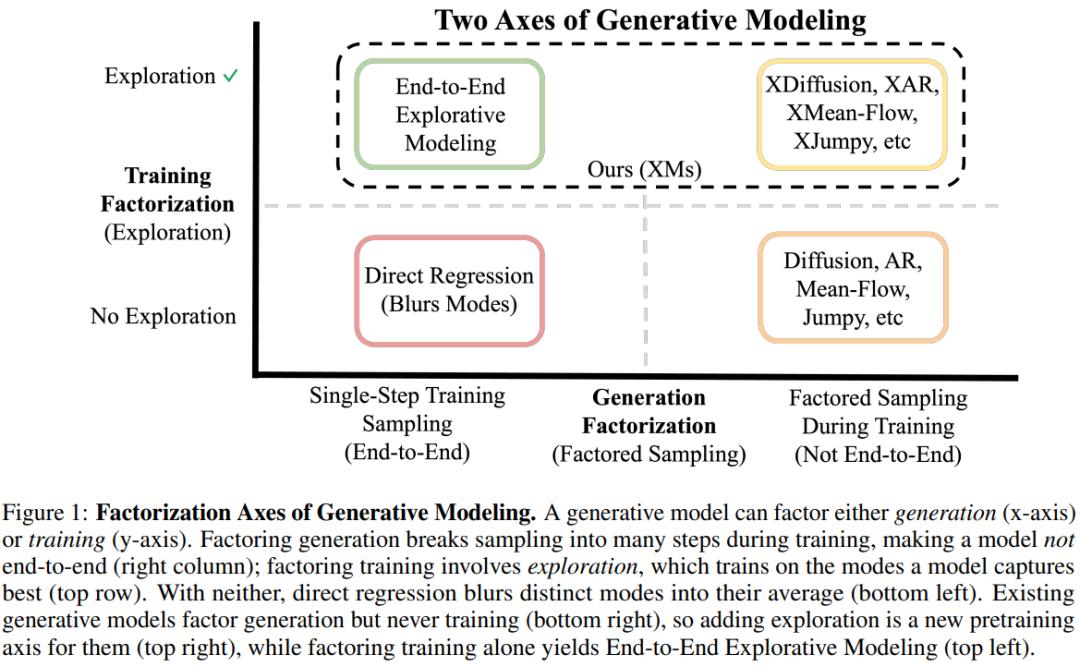
现有的主流生成模型通过拆解生成过程来规避这一问题。自回归模型将生成分解为逐个元素的预测,扩散模型则将去噪过程分解为微小的步骤。每一步的目标分布都被简化为近似单模态,从而避免了重构损失取平均的问题。然而,这种策略的代价是牺牲了端到端的特性,导致推理过程极其缓慢且复杂。探索式建模则提出了一个截然不同的思路:既然拆解生成过程会破坏端到端特性,为何不拆解训练过程?
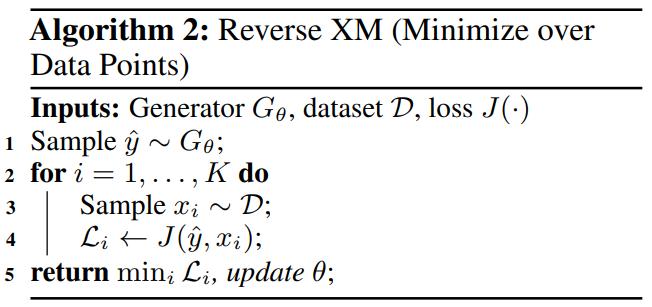
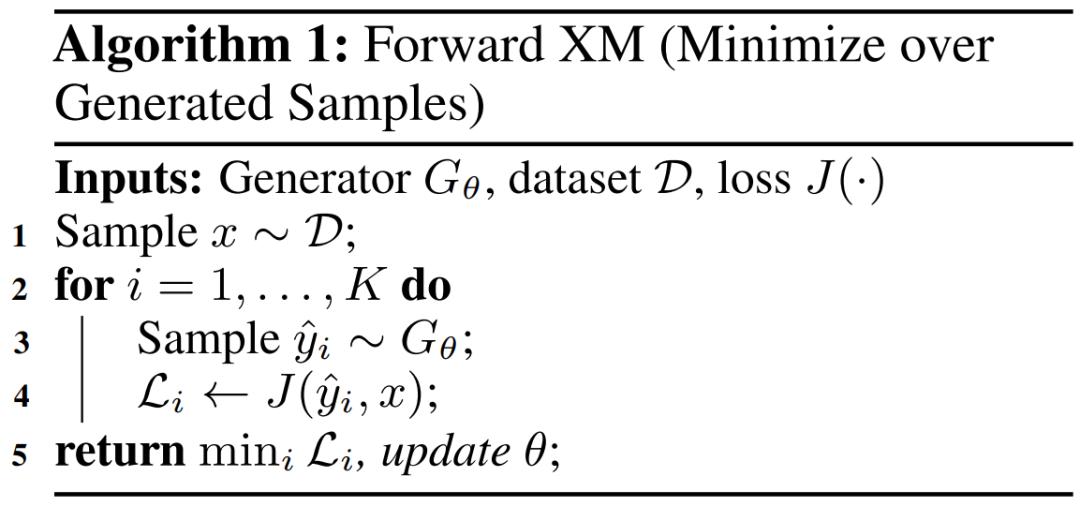
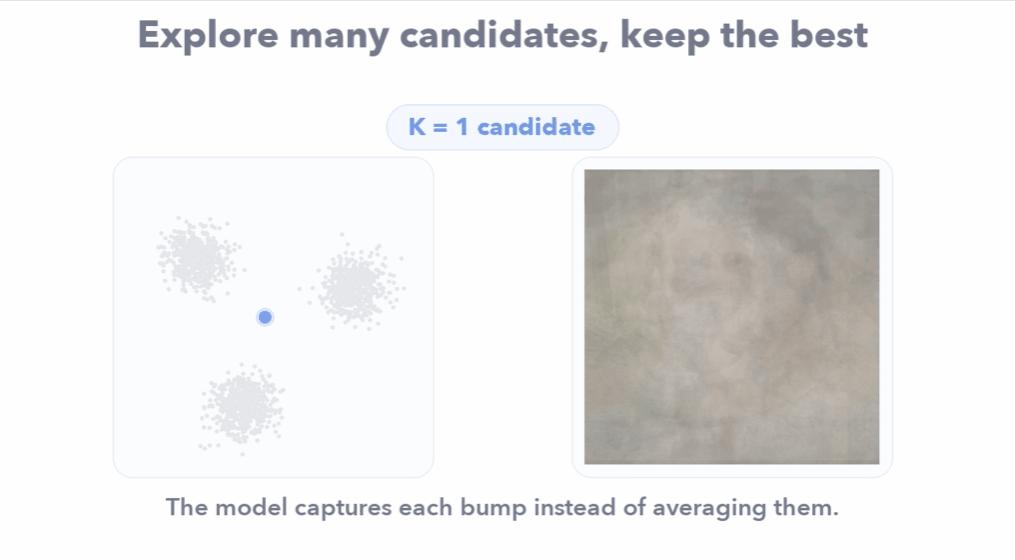
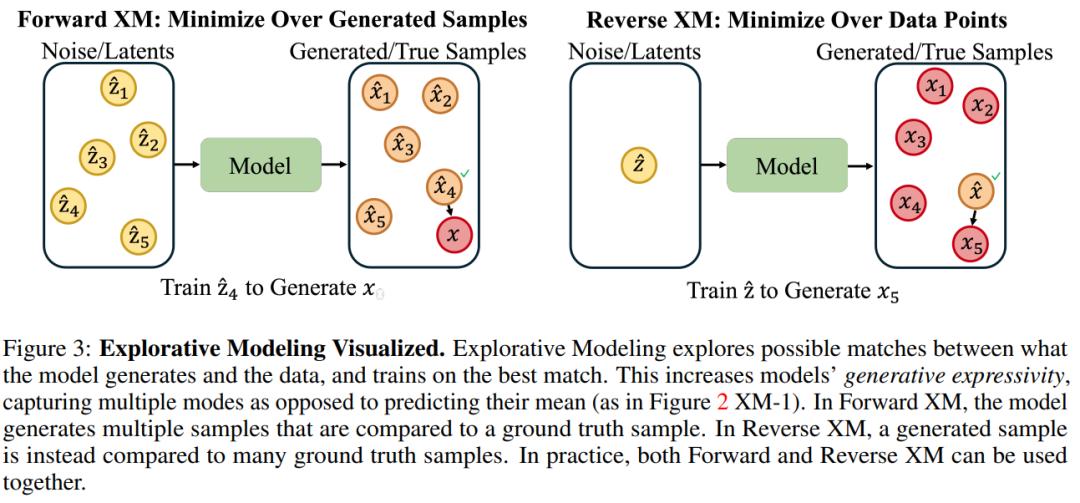
XM的核心机制极其简洁,仅由一个包含3至5行代码的for循环构成。在每个训练步骤中,模型不再只生成一个样本去匹配真实数据,而是基于相同的输入噪声生成K个候选样本。随后,系统计算这K个候选样本与真实目标之间的距离,仅选择距离最近的那个样本进行梯度回传和参数更新。这一机制被称为“Best-of-K”选择策略。从直觉上看,这类似于飞镖游戏:如果只允许投掷一次,最佳策略是瞄准靶心(平均值);但如果允许投掷K次并只计最好的一次成绩,最佳策略则是将投掷点分散覆盖靶盘的不同区域,以最大化命中高分区的概率。
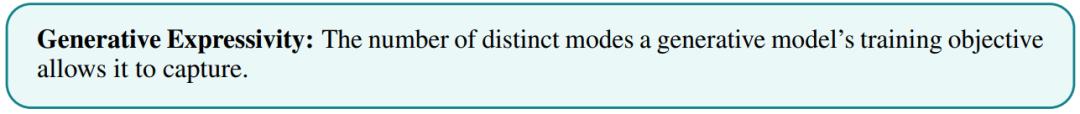
在生成模型的语境下,这种探索机制迫使不同的噪声输入“认领”不同的数据模式,而不是全部拥挤到分布的中心。随着探索次数K的增加,模型能够稳定地捕捉到更多的数据模式,从而显著提升生成表达力。研究指出,生成表达力是由训练目标本身决定的内在属性,单纯增加参数量或数据量无法自动提升这一能力。这也解释了为何当前最先进的生成模型严重依赖“引导”(Guidance)技术。无分类器引导本质上是通过人为干预,将模型预测从模糊的平均值推离,以恢复细节。如果模型自身具备足够的生成表达力,不再产生模糊的平均值,那么引导技术的必要性将大幅降低。
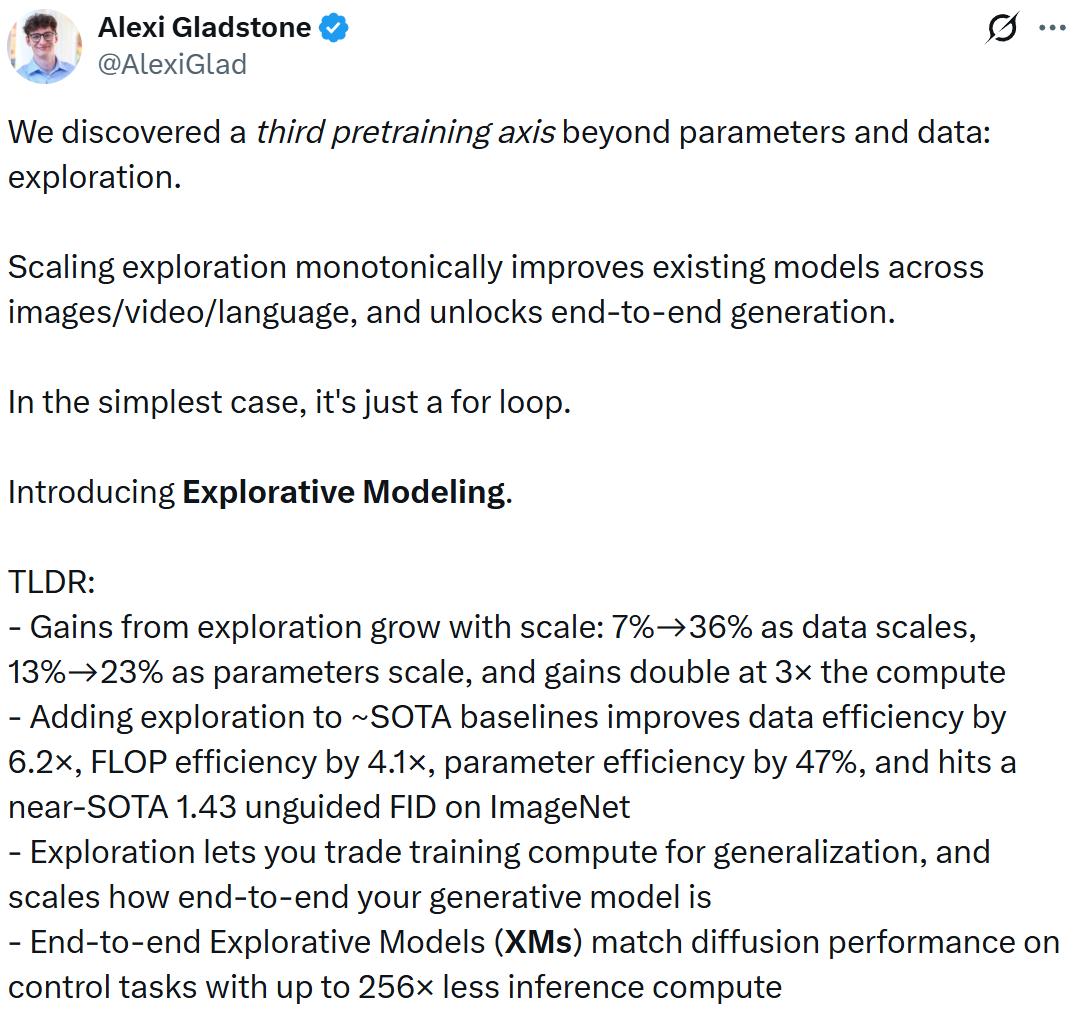
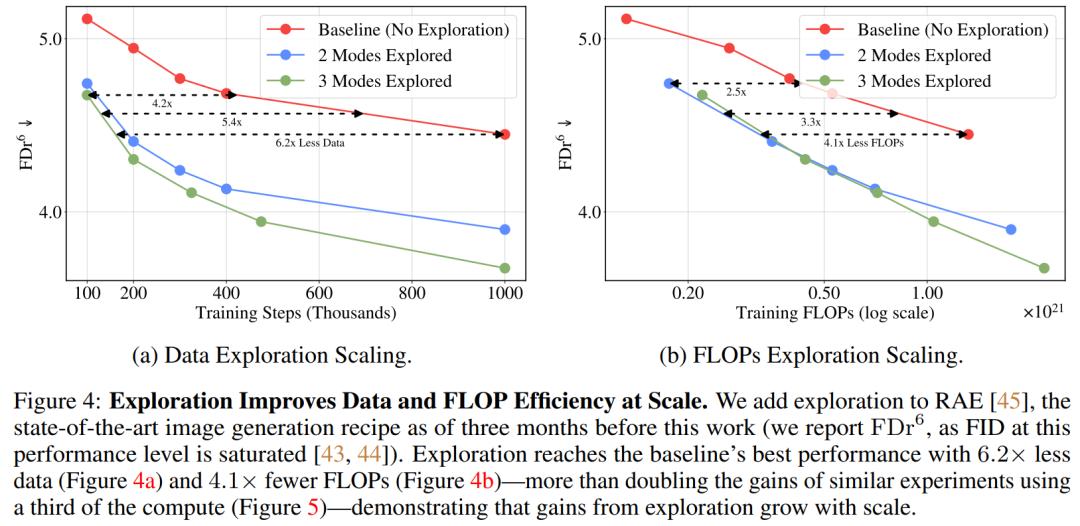
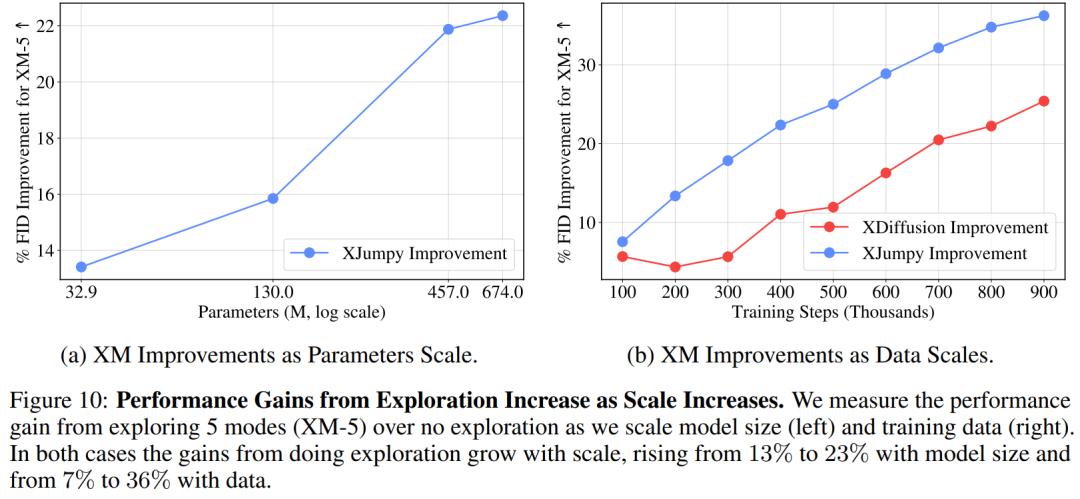
探索式建模不仅在理论上解决了模式模糊问题,更在实际应用中展现了惊人的扩展潜力。研究人员将XM应用于扩散流模型、Jumpy模型以及掩码扩散语言模型,并在图像、视频和语言三种模态上进行了广泛测试。实验结果显示,随着模型规模和数据量的增加,探索带来的性能增益呈现单调上升趋势。具体而言,当数据规模增长时,探索带来的增益从7%提升至36%;当模型参数量增大时,增益从13%提升至23%。更令人瞩目的是,在算力增加三倍的情况下,效率增益直接翻倍。
从效率维度来看,探索式建模实现了多维度的突破。其FLOP效率提升了4.1倍,样本效率提升了6.2倍,参数效率提升了47%。在ImageNet图像生成任务中,结合XM的大型模型在无引导条件下达到了1.43的FID分数,逼近业界最高水平。值得注意的是,一个探索5个模式的Large模型,其表现甚至超越了一个参数量多出47%但未采用探索机制的XLarge模型。这一现象表明,在参数和数据不再是主要限制因素的大规模训练场景下,生成表达力已成为新的瓶颈,而探索正是突破这一瓶颈的关键钥匙。
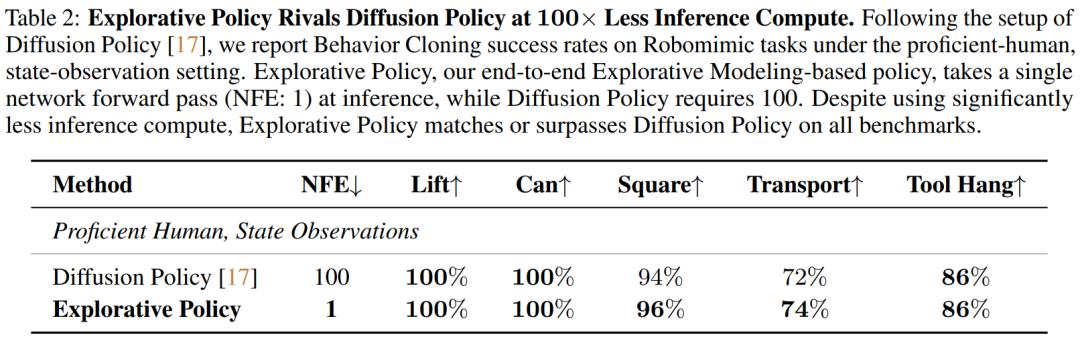
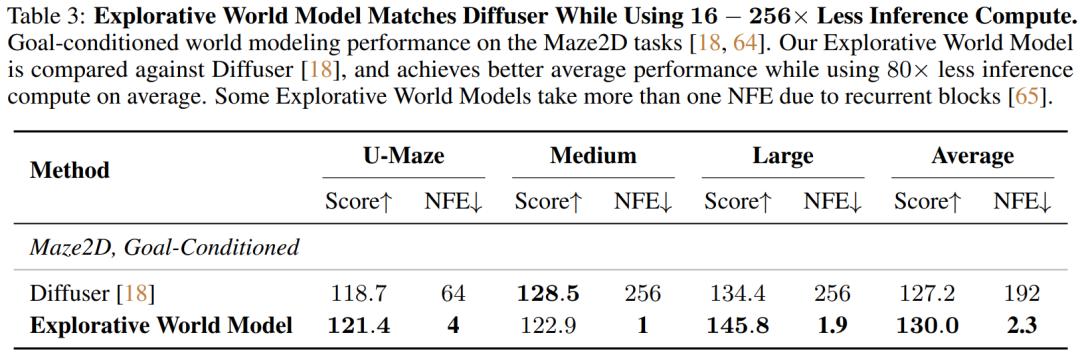
探索式建模的终极意义在于实现了真正的端到端生成。当将探索机制推向极致,模型可以在训练阶段完成所有的多模态搜索,从而在推理阶段仅需一次前向传播即可生成高质量样本。在机器人控制任务的行为克隆实验中,基于XM的策略网络仅用一次前向就追平甚至超越了需要100次前向的扩散策略。在目标导向的世界建模任务中,XM所需的推理算力比Diffuser少了16至256倍,同时保持了更优的平均表现。这种将计算负载从推理阶段转移至训练阶段的范式转换,为实时生成和高频交互应用开辟了新的可能性。
尽管探索式建模前景广阔,但其局限性也不容忽视。目前,自回归语言模型仍是该技术应用的最难点,纯端到端的前向XM在处理极度多模态分布(如高分辨率图像)时,训练成本依然高昂。此外,Best-of-K策略本身并非全新概念,前人已有类似尝试,但XM的贡献在于从理论层面阐明了这一简单循环背后的生成表达力机制,并将其确立为独立的扩展轴。研究团队坦言,当前的实验结果可能只是更大规模下收益的下限,随着基础模型训练算力的进一步指数级增长,探索式建模的潜力有望得到更充分的释放。
综上所述,探索式建模为生成模型的发展提供了全新的视角。它打破了长期以来依赖参数和数据堆砌的路径依赖,揭示了训练策略本身作为扩展轴的巨大潜力。通过一个简单的循环机制,XM不仅解决了困扰学界多年的模式模糊问题,更实现了推理效率的数量级提升。在未来,随着对生成表达力理解的深入和优化算法的改进,我们有理由相信,端到端生成将成为主流,而探索式建模将是通往这一愿景的重要桥梁。这一范式的转变,标志着生成模型从“逐步构建”向“整体感知”的深刻进化,为人工智能内容创作带来了更具确定性和高效性的技术底座。