ICLR限投20篇引争议:AI时代学术评审的公平与效率博弈
学术洪峰下的紧急刹车:从19525篇投稿看ICLR的困境
顶级人工智能会议ICLR近期公布的一项新规,在学术界激起了千层浪。规定明确指出,在ICLR 2027中,任何单一作者名下的投稿数量上限被严格锁定在20篇。这一数字并非随意设定,而是基于对过往数据的严峻审视。若作者在全文截止日前未将超额论文移除,会议方将采取随机拒绝机制,强制使每位作者回归限额之内。这一看似强硬的手段,实则是面对学术投稿爆炸式增长时的无奈之举。
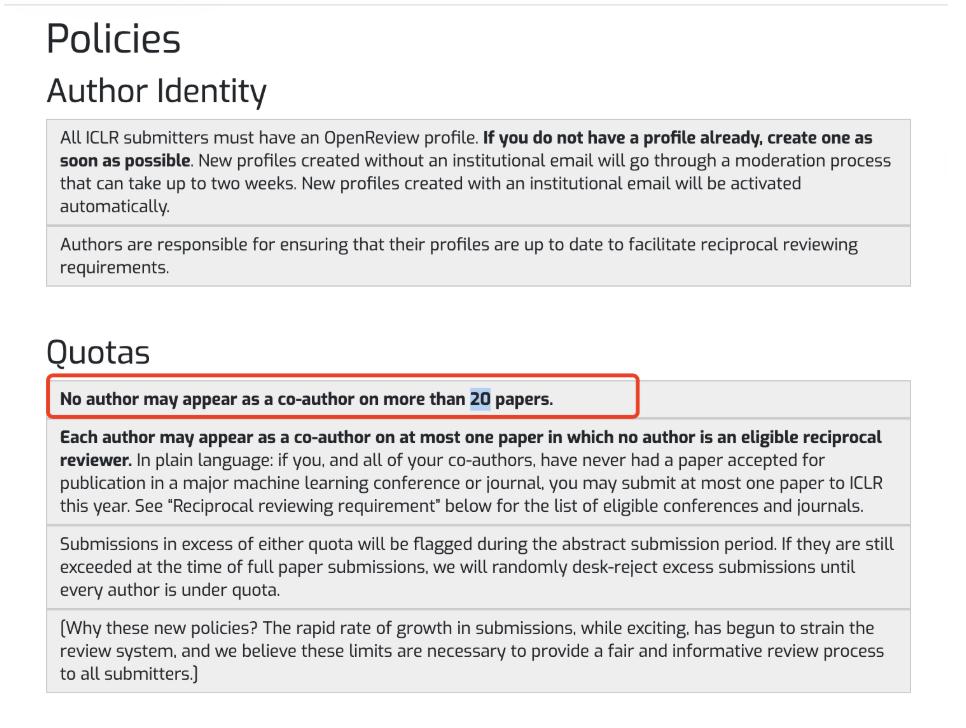
回顾ICLR 2026的数据,我们不难理解会议组织方的焦虑。那一年,有效投稿量达到了惊人的19525篇,相较于2025年的11603篇,增幅高达68%。这意味着在短短一年内,会议需要额外消化近8000篇论文。背后支撑这一庞大体量的,是18054名评审专家提供的76139份审稿意见。评审系统的负载已接近临界点,传统的同行评议模式在海量稿件面前显得捉襟见肘。为了维持评审的公平性与信息密度,配额制成为了维持系统运转的必要阀门。
然而,这种行政手段的介入,立刻引发了关于学术自由与科研效率的激烈讨论。支持者认为,这是遏制低质量灌水、保护评审资源的必要措施;反对者则担忧,这会抑制高产团队的研究活力,甚至阻碍某些跨领域、多分支探索的进展。在这场争论中,数量的边界成为了焦点,但更深层次的问题在于,当科研产出的速度远超人类评审的处理能力时,我们该如何重新定义学术交流的规则?
反讽式请愿:Dan Roy对“20篇红线”的犀利解构
面对ICLR的限额令,Google DeepMind访问研究员、多伦多大学教授Dan Roy发起了一场颇具戏剧性的“请愿”。他在社交媒体上公开呼吁取消这一限制,言辞间充满了明显的反讽意味。他质问:“为什么偏偏是20篇?这完全是一个随意设定的数字。”更进一步,他提出既然AI Agent已经能够独立完成许多渐进式研究工作,且评审工作也日益依赖大语言模型,那么限制投稿数量只会拖慢人工智能的发展。
Dan Roy的言论并非单纯的抱怨,而是一种高级的黑色幽默。ICLR官方曾强调,希望研究者利用代码助手提高效率后,去挑战更具雄心的问题,提交更完整成熟的成果,而非制造大量渐进式论文。Dan Roy则故意曲解这一初衷,假装支持“让Agent尽可能多地生产渐进式成果”,并讽刺性地指出“承认吧,评审工作都已经交给大语言模型处理了”。这种以子之矛攻子之盾的策略,精准地戳中了当前学术界的痛点。
他的反讽揭示了一个尴尬的现实:一方面,会议主办方呼吁“慢科学”,追求深度与创新;另一方面,技术工具的普及使得论文生产的边际成本大幅降低,导致“快科学”泛滥。当工具理性压倒价值理性,简单的数量限制或许只能治标,无法治本。Dan Roy的请愿书实际上是在追问:在一个由算法驱动科研的时代,我们是否还在用工业时代的计量方式来管理知识生产?
幽灵审稿人:21%评审意见疑似AI生成的警示
Dan Roy关于“评审工作交给大模型”的讽刺,并非空穴来风,而是有着坚实的数据支撑。在ICLR 2026的审稿高峰期间,卡内基梅隆大学著名AI研究员Graham Neubig发现部分审稿意见存在异常。出于对评审质量的担忧,他利用Pangram Labs开发的AI文本检测工具EditLens,对会议公开的75800条评审意见进行了扫描分析。
分析结果令人震惊:约有21%的评审意见被高度怀疑为“完全由AI生成”。这一比例之高,足以引发学术界对同行评议制度根基的动摇。同行评议的核心价值在于专家的独立判断与深度洞察,而AI生成的评论往往流于表面,缺乏真正的批判性思维。如果五分之一的审稿意见来自机器,那么论文接收的决定在多大程度上反映了其真实学术价值?
这一现象暴露了学术评价体系中的“军备竞赛”。当作者使用AI加速写作时,审稿人也在潜意识或显意识地使用AI加速阅读与反馈。这种双向的自动化导致了交流的空心化。作者不再精心打磨每一个论点,因为知道审稿人可能只是匆匆一瞥;审稿人不再深入推导每一个公式,因为相信AI能捕捉大致逻辑。最终,会议变成了一场算法之间的对话,而非人类智慧的碰撞。
此外,AI检测工具本身的准确性也存在争议。误判可能导致对诚实研究者的不公指控,而漏判则让投机者逍遥法外。在这种不确定性中,学术信任体系面临着前所未有的考验。Neubig的发现不仅仅是一个统计数据,它是对整个学术共同体诚信机制的一次严厉警告。
渐进式创新的陷阱:AI Agent重塑科研范式
ICLR限制投稿数量的另一个背景,是AI Agent对科研范式的深刻重塑。如今的大语言模型和代码助手,使得研究人员能够以前所未有的速度进行实验迭代。一个想法可以在几天内转化为代码、跑出结果并写成初稿。这种效率的提升本是好事,但它也带来了“渐进式创新”的泛滥。
所谓渐进式创新,是指在现有方法基础上进行微小的改进,如调整超参数、更换数据集或组合已有模块。这类工作技术门槛低,易于批量生产,但学术贡献有限。在AI工具的加持下,一个团队可以轻易地在一个月内产出数十篇此类论文。如果不对数量加以限制,顶会将迅速被这些低信息密度的文章淹没,真正具有突破性的原创研究反而可能被噪音掩盖。
然而,简单地将所有渐进式研究拒之门外也是不公正的。科学进步往往是由无数微小的步伐累积而成的。关键在于如何区分“有价值的增量”与“无意义的灌水”。ICLR的20篇限额试图通过物理手段减少后者,但并未提供区分前者的标准。这可能导致一种逆向选择:研究者为了规避风险,倾向于将一个大课题拆分成多个小课题分别投稿,或者相反,因为名额有限而放弃那些风险较高但潜力巨大的探索。
Dan Roy的反讽正是基于此:如果AI能高效完成这些渐进式工作,为何不充分利用这一能力?问题的核心不在于是否允许AI参与,而在于我们如何评估AI生成内容的价值。当前的评价体系尚未建立起适应AI时代的质量标尺,只能退回到最原始的数量管控上。
超越“一刀切”:构建适应AI时代的学术生态
面对投稿激增与AI滥用的双重挑战,ICLR的“20篇限额”或许只是一个过渡性的应急方案。长远来看,学术界需要构建一套更加精细化、智能化的评价与管理机制。首先,评审流程本身需要进行数字化重构。引入AI辅助初审,筛选掉明显不符合标准或重复率高的稿件,可以减轻人类专家的负担,让他们专注于高价值论文的深层评估。
其次,建立更透明的审稿溯源机制。要求审稿人声明是否使用AI辅助,并对AI生成的内容进行标注,有助于维护评审的透明度。同时,开发更先进的AI检测与反作弊技术,确保评审意见的人类智力含量。对于作者而言,也应鼓励其在投稿时说明AI工具的使用情况,促进负责任的科研实践。
此外,会议形式也可以多样化。除了传统的长篇论文,可以增设短论文、工作进展报告、负面结果分享等板块,分流不同类型的研究成果。这样既能容纳大量的渐进式探索,又能保证主会场的含金量。通过分层分类的管理,避免将所有稿件挤在同一赛道上竞争。
最后,学术社区需要重新审视“发表即成功”的文化导向。减少对论文数量的盲目崇拜,转而关注研究的复现性、代码开源质量以及实际影响力。当评价指标从“发了多少篇”转向“解决了什么问题”,研究者自然会调整策略,从追求数量转向追求质量。Dan Roy的反讽提醒我们,技术变革不可逆转,唯有制度创新与之匹配,才能避免学术生态的系统性崩溃。在这场人与算法共舞的学术新纪元中,保持人类批判性思维的主导地位,才是我们应有的坚守。