GPU空转率超60%?揭秘AI Infra如何榨干硅片极限性能
在人工智能浪潮席卷全球的当下,算力已成为数字时代的石油。然而,随着大模型从训练阶段全面转向推理应用,一个严峻的现实浮出水面:昂贵的GPU并未被充分利用。尽管科技巨头们不惜重金扩建数据中心,但华尔街的担忧并非空穴来风。历史经验表明,盲目的基础设施投入往往伴随着巨大的资源浪费。真正的破局之道,不在于无限制地购买硬件,而在于通过软件技术的革新,将现有硅片的潜力压榨至极限。这一领域被称为AI Infra(人工智能基础设施),它正成为决定AI应用成本与效率的关键战场。
许多从业者存在一个认知误区,认为只要GPU风扇在转,算力就在满负荷运行。事实却截然相反。卡内基梅隆大学的一项最新研究揭示了令人震惊的数据:在大型学术AI集群中,近20%的执行时间和约11%的能耗被浪费在等待上。特别是在推理场景下,由于请求的不连续性和系统调度的瓶颈,GPU的空转率甚至高达50%以上。这意味着,企业花费数百万美元采购的硬件,有一半时间是在“发呆”。这种低效不仅造成了巨大的资本浪费,更成为了阻碍AI应用规模化落地的核心障碍。
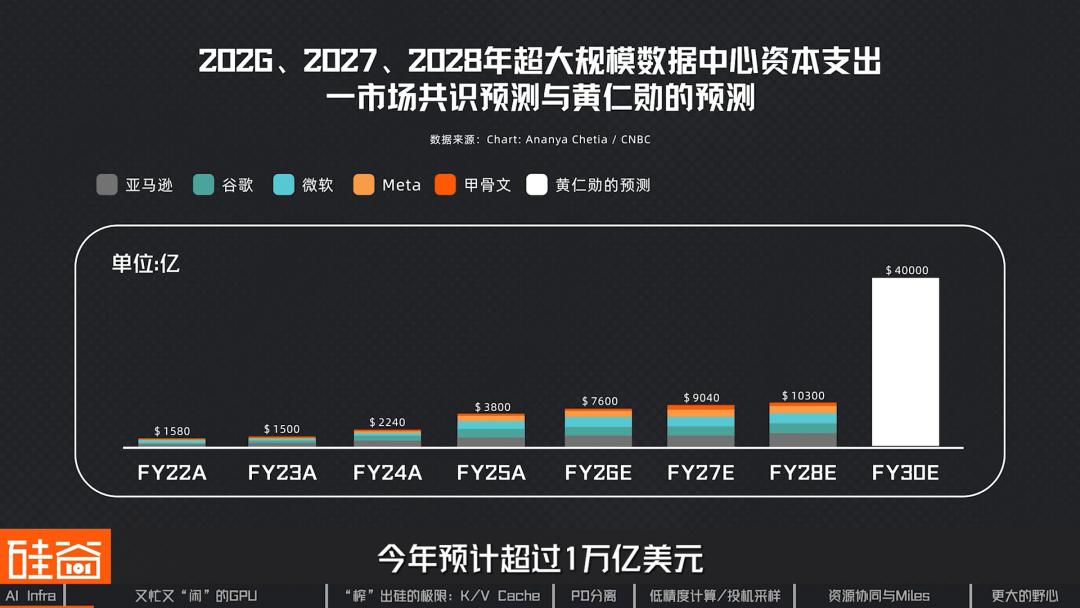
要理解这一现象,必须深入剖析AI Infra的四层架构。最底层是能源基础设施,决定了电力供应的稳定性;第二层是计算硬件,包括GPU、HBM高速显存及互联网络,设定了理论性能上限;第三层是系统软件,涉及CUDA内核、编译器及内存管理,负责将代码转化为硬件指令;最上层则是服务编排,包括推理引擎和资源调度器,直接决定任务的分配与执行顺序。前两层属于“硬约束”,优化周期长且边际效应递减;而后两层属于“软实力”,通过算法与工程优化,能在短时间内带来数倍的性能提升。当前行业的创新焦点,正迅速向系统软件与服务编排层转移。
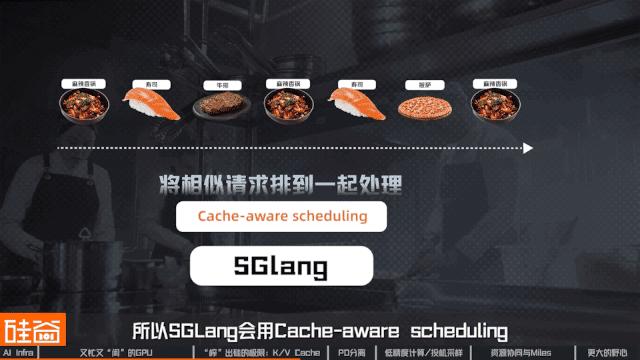
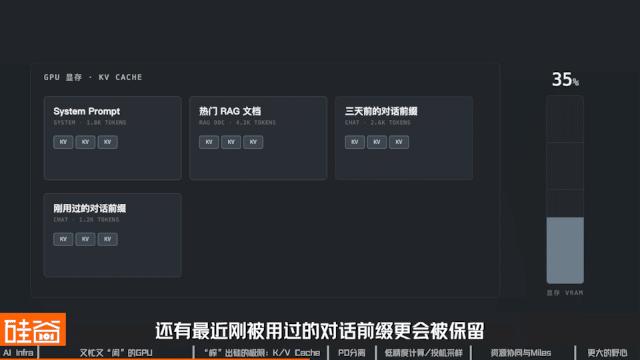
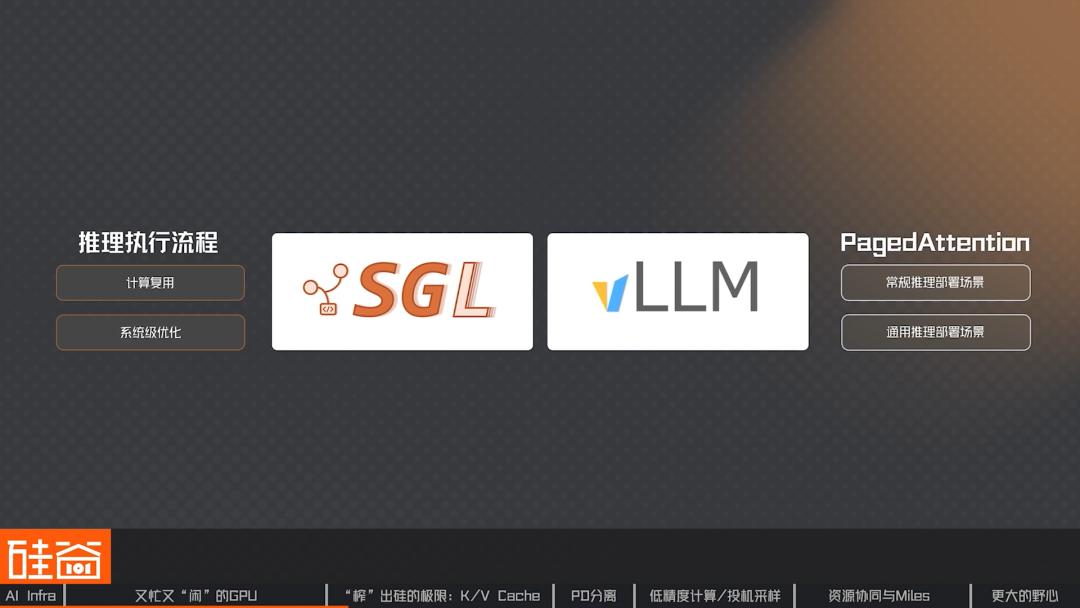
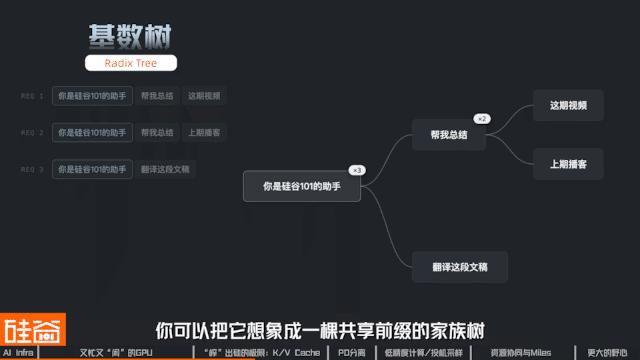
在系统软件与服务编排层,核心挑战可以归结为四个问题:哪些计算可以复用?哪些等待可以消除?哪些算力未被吃满?哪些资源缺乏协同?针对这些问题,以SGLang和vLLM为代表的开源推理引擎提出了革命性的解决方案。其中,KV Cache(键值缓存)的复用是降低“推理税”的关键。在传统模式下,相同的提示词前缀每次都需要重新计算,这在智能体(Agent)工作流中尤为浪费。SGLang引入的RadixAttention技术,利用基数树数据结构组织KV Cache,实现了跨请求、跨会话的前缀共享。这就好比餐厅后厨,如果连续几道菜都是麻辣口味,厨师无需每次重新准备底料,从而大幅提升了处理效率。
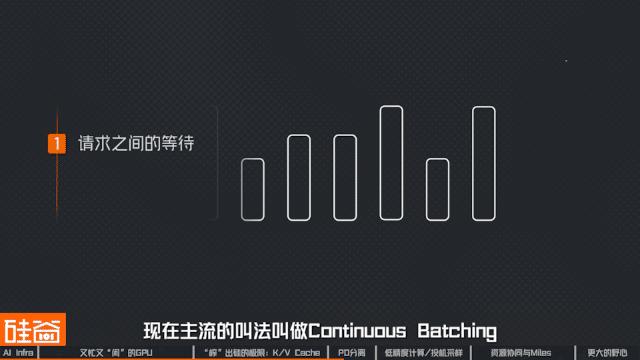
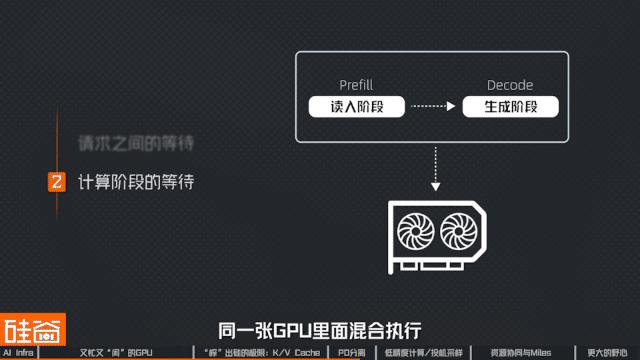
除了计算复用,消除等待也是提升利用率的重要手段。传统的批处理模式要求所有请求同时到达、同时结束,导致短请求被迫等待长请求,造成资源闲置。Continuous Batching(连续批处理)技术打破了这一限制,允许新请求随时加入批次,已完成的请求立即退出,使GPU始终保持满载状态。此外,Prefill/Decode分离架构进一步解决了计算阶段的等待问题。大模型推理分为预填充(读入)和解码(生成)两个阶段,前者计算密集,后者显存带宽敏感。将这两个阶段拆分到不同的GPU组并行处理,避免了相互拖累,显著提升了整体吞吐量。DeepSeek等前沿模型已广泛采用此架构,证明了其有效性。
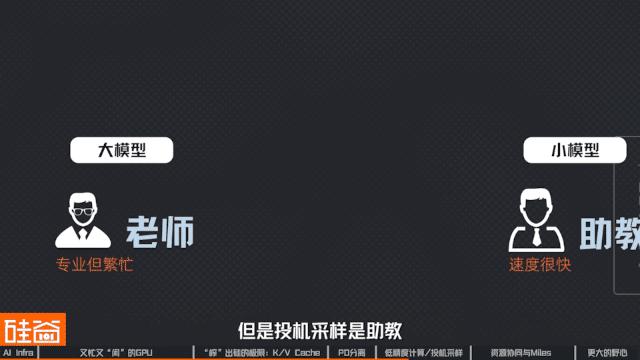
在算力释放方面,低精度计算与投机采样是两大利器。通过将模型权重、激活值或KV Cache转换为更低精度的数据格式,可以在不显著损失精度的前提下,减少显存占用并利用GPU更快的低精度算力单元。投机采样则引入了“草稿模型”的概念,让小模型先预测后续多个Token,再由大模型一次性验证。这种“助教起草、老师批改”的模式,在最佳情况下可将生成速度提升两到三倍。这些技术的落地,离不开推理引擎与硬件厂商的深度协同。如今,SGLang等引擎已成为新硬件发布的标配评测工具,实现了软件与芯片的Day-0支持,确保每一代新GPU的性能都能被即时释放。
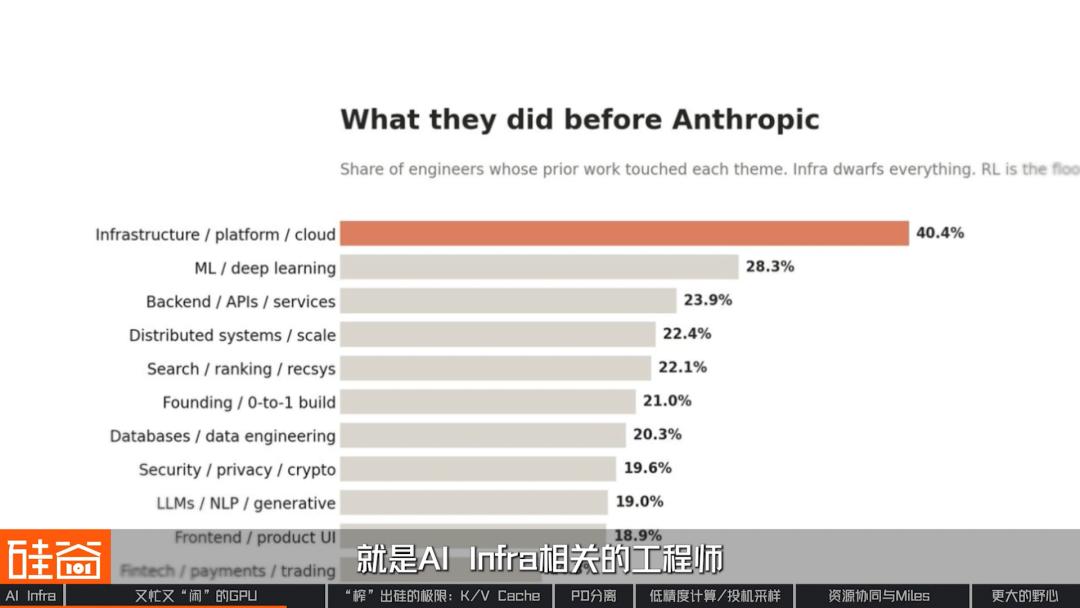
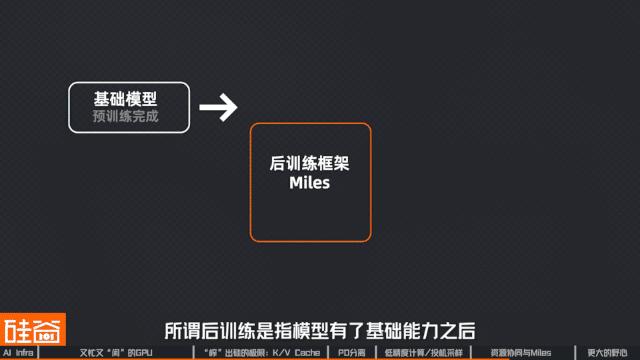
随着强化学习成为模型后训练的主流范式,AI Infra面临着新的挑战。强化学习涉及推理、评估和参数更新的交替循环,传统训练框架难以高效处理这种混合负载。为此,RadixArk推出了Miles训练框架,专门针对强化学习场景优化。Miles将训练与推理纳入统一系统,实现了两者之间的无缝衔接与资源协同。通过保持训练与推理过程中模型权重、内核策略的一致性,Miles有效减少了阶段切换带来的等待时间,构建了更高效的后训练闭环。这对于MoE(混合专家)等复杂架构的稳定训练尤为重要,确保了模型在迭代过程中的性能对齐。
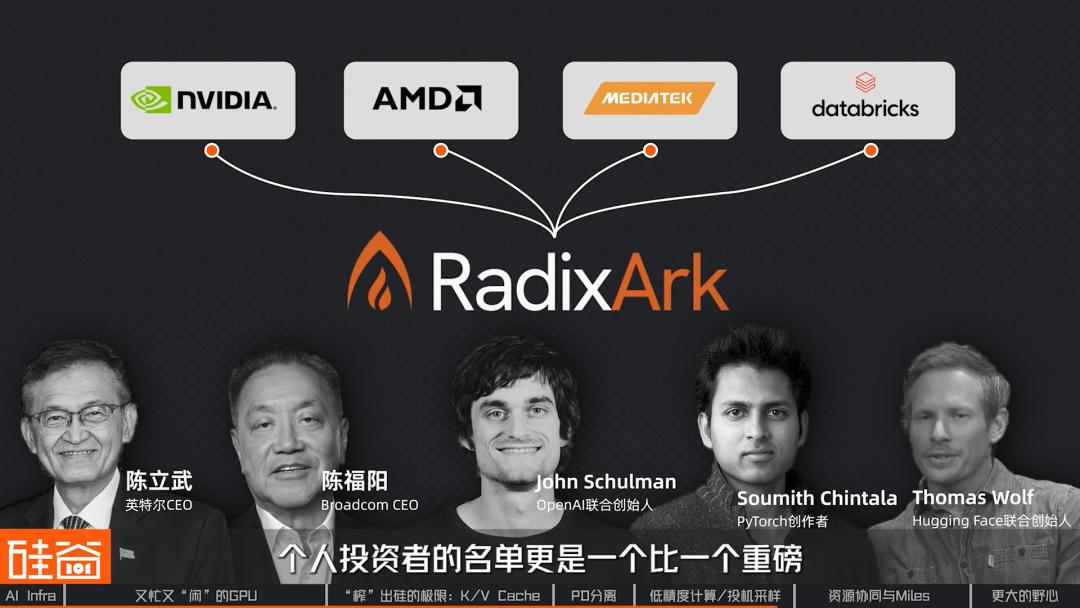
值得注意的是,AI Infra的价值已超越单纯的技术优化,正在重塑行业生态。过去,高效的推理能力是少数前沿实验室的独家壁垒;如今,随着SGLang、vLLM等开源项目的成熟以及RadixArk等商业化公司的崛起,这一能力正逐渐转化为行业公共基础设施。推理框架正演变为AI时代的“操作系统”,屏蔽了底层硬件的差异,让开发者能够专注于模型创新与应用开发。无论是英伟达、AMD还是新兴芯片厂商,都纷纷与这些推理引擎合作,构建开放的算力生态。
这种基础设施的普惠化,极大地降低了AI创新的门槛。初创团队不再需要组建庞大的底层工程团队,即可调用世界级的推理优化能力。这意味着,更多具有创新想法的开发者能够以较低的成本进入前沿领域,推动AI技术的多元化发展。从长远来看,当算力效率不再是瓶颈,AI应用的边界将被进一步拓展,智能体、个性化助手等复杂场景将迎来爆发式增长。
综上所述,榨干硅片极限并非一句口号,而是一场涉及算法、系统架构与工程优化的深刻革命。通过KV Cache复用、连续批处理、PD分离及强化学习专用框架等技术手段,AI Infra正在将GPU的利用率推向新的高度。这不仅缓解了算力短缺的压力,更为AI产业的可持续发展提供了坚实支撑。未来,随着软件定义的算力基础设施日益完善,我们有理由相信,一个更加高效、开放且充满活力的AI时代正在到来。在这个过程中,那些能够持续优化基础设施、降低使用门槛的企业与技术,将成为推动AGI实现的关键力量。