GPU利用率不足50%?揭秘AI Infra如何榨干硅片极限性能
在人工智能浪潮席卷全球的今天,算力被视为新的石油。然而,当我们凝视那些昂贵且稀缺的GPU集群时,一个被忽视的事实浮出水面:这些看似全速运转的硅片,实际上大部分时间处于“空转”状态。随着大模型从训练阶段全面转向推理应用,如何提升GPU的实际利用率,已成为决定AI商业成败的关键变量。这不再仅仅是硬件采购的问题,而是一场关于软件架构与系统工程的深度革命。
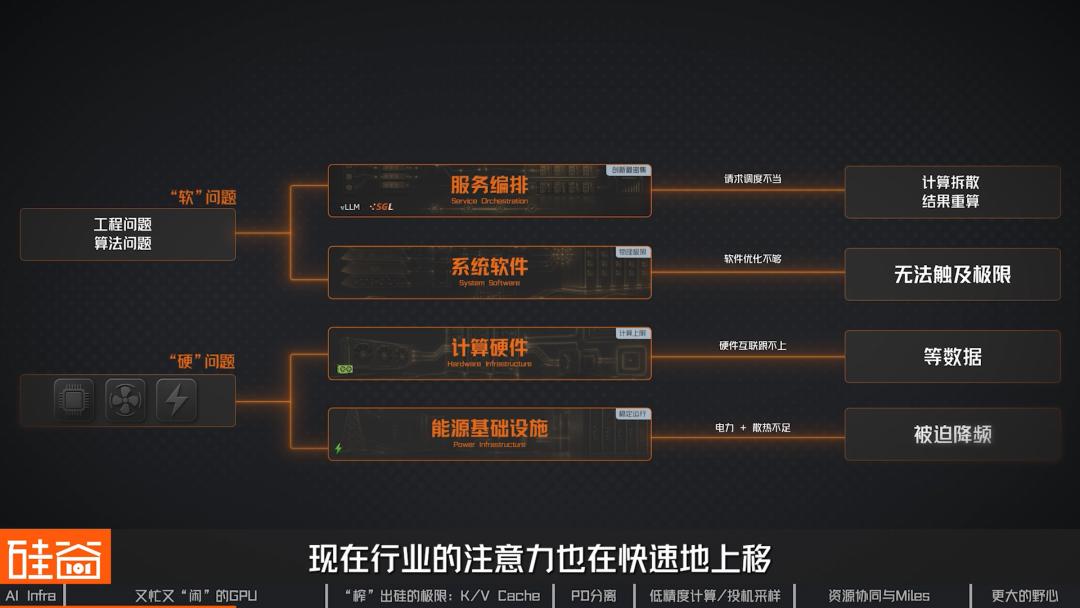
传统观念中,增加算力意味着购买更多的显卡。但卡内基梅隆大学的研究数据给出了令人震惊的答案:在大型AI集群中,近20的执行时间和约11%的能耗被浪费在等待上。在Azure Code负载中,这一比例甚至高达65%。这意味着,企业花费数百万美元购买的硬件,有一半以上的价值在沉默中流失。这种“执行时空转”现象,根源在于AI系统的复杂性。GPU并非孤立存在,它嵌入在一个由能源、硬件、系统软件和服务编排构成的四层架构中。任何一层的瓶颈,都会导致上游算力的闲置。
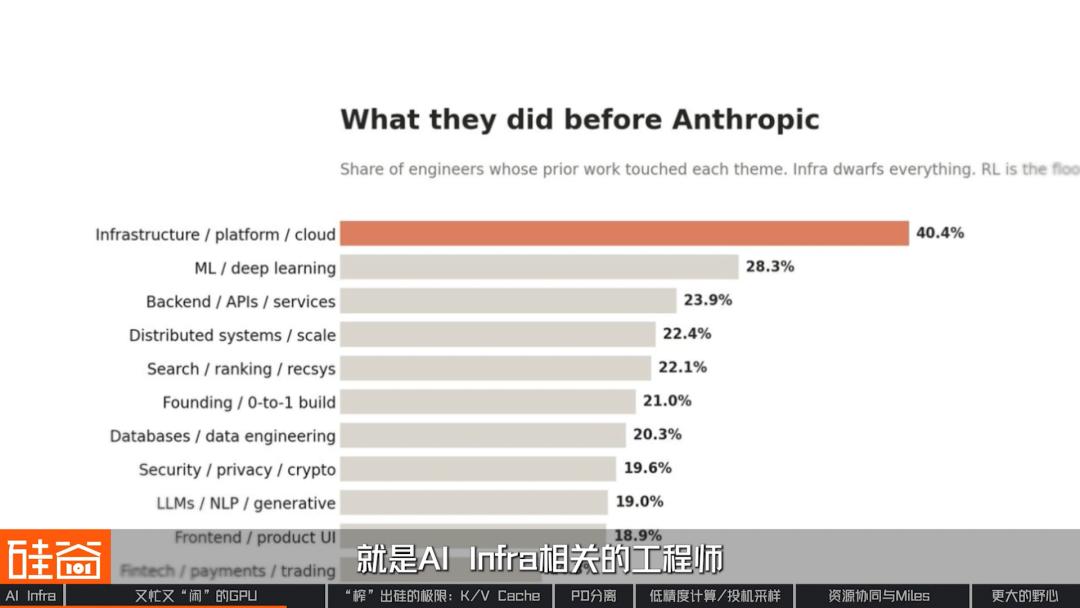
能源与硬件属于“硬约束”,其优化周期长且边际效应递减。真正的突破点在于后两层:系统软件与服务编排。这是工程与算法的竞技场,也是当前AI Infra创新的核心地带。以一台成本400万美元的NVIDIA GB200 NVL72机柜为例,若软件栈优化得当,将利用率从50%提升至90%,等同于凭空多出一台机柜的价值。这种通过软件重构带来的效率跃升,直接转化为企业的净利润,这也是为何Anthropic等巨头将大量资源投入Infra团队的根本原因。
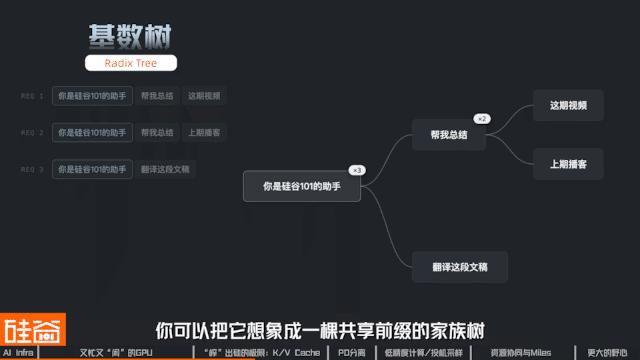
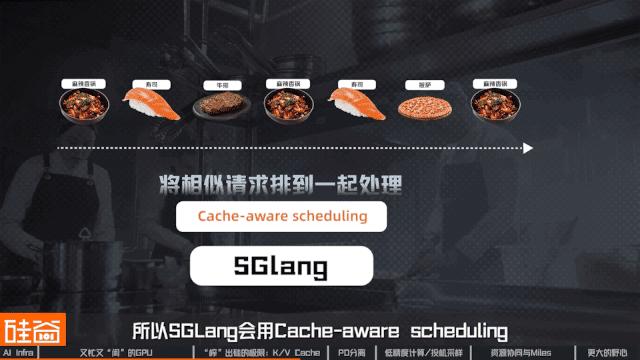
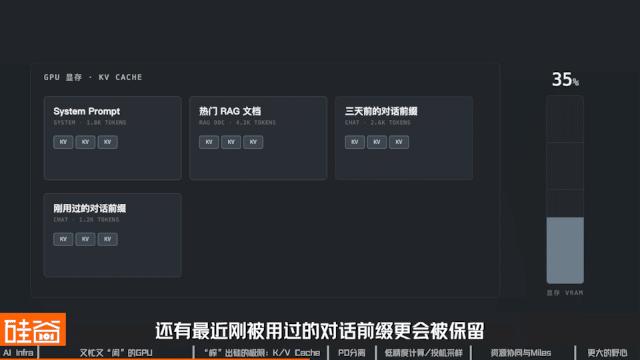
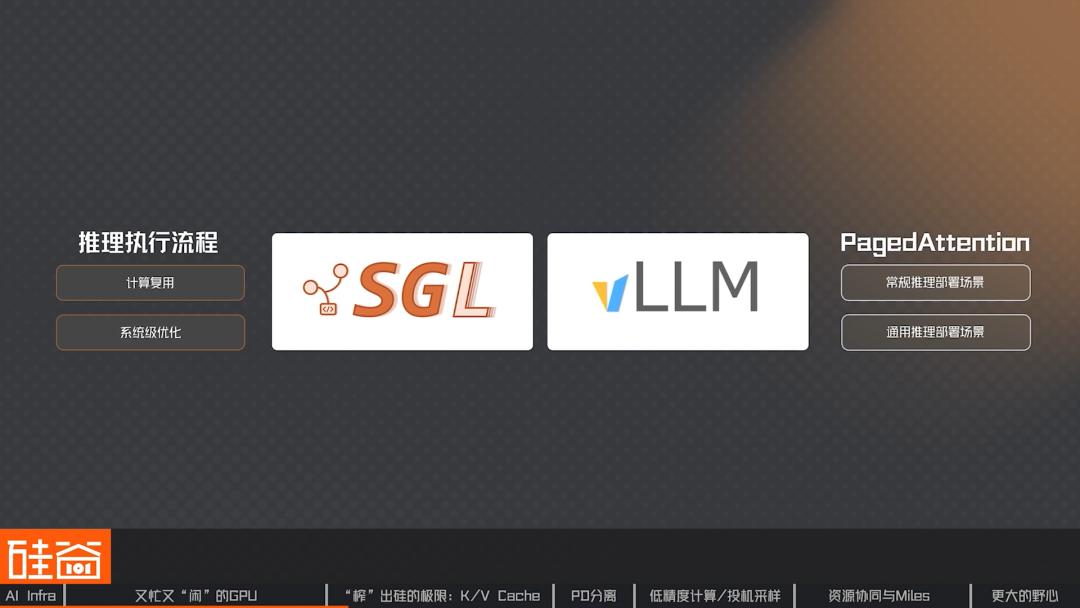
要解决GPU“吃不饱”的问题,首先必须攻克计算冗余的难题。在大模型推理中,KV Cache(键值缓存)的管理至关重要。传统的处理方式中,相同的系统提示词或上下文在每个请求中都被重复计算,造成了巨大的“推理税”。SGLang提出的RadixAttention技术,引入基数树数据结构,实现了跨请求、跨机器的KV Cache共享。这就好比餐厅后厨,如果连续几道菜都需要相同的底料,厨师无需每次重新准备,而是直接复用。通过缓存感知调度,系统将具有相似前缀的请求集中处理,大幅减少了重复计算。同时,智能的淘汰机制确保显存始终服务于高价值数据,从而在有限的硬件资源下支撑更高的并发量。
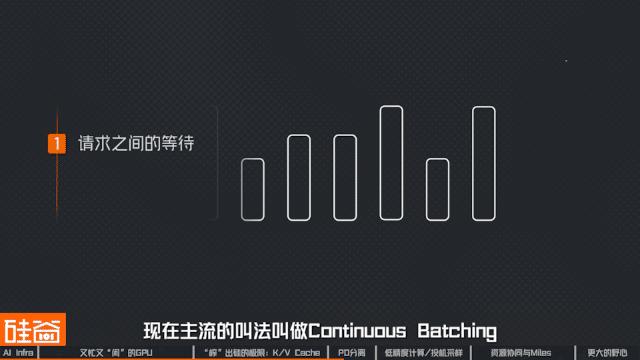
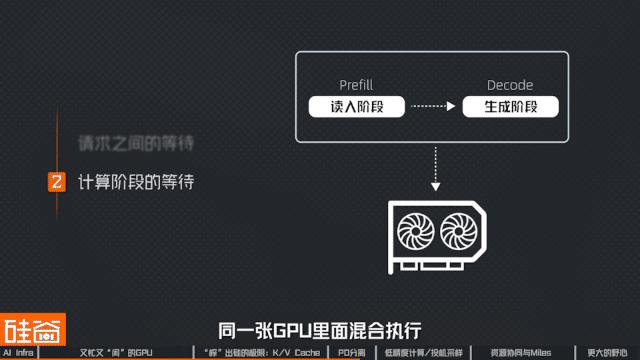
除了计算复用,消除等待是提升吞吐量的另一把钥匙。早期的推理引擎采用排队或静态批处理模式,导致短请求被长请求阻塞,GPU经常处于等待状态。Continuous Batching(连续批处理)技术的出现改变了这一局面。它允许新请求随时加入批次,已完成请求即时退出,如同随上随下的公交车,确保GPU始终满载运行。更进一步,Prefill/Decode分离架构将推理过程拆解为“读题”与“作答”两个阶段。由于这两个阶段对算力和显存带宽的需求截然不同,将其分配给不同的GPU集群并行处理,避免了相互拖累。DeepSeek等前沿模型已广泛采用此方案,显著提升了整体响应速度。
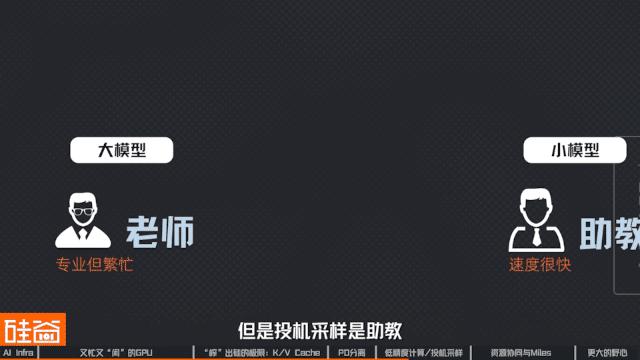
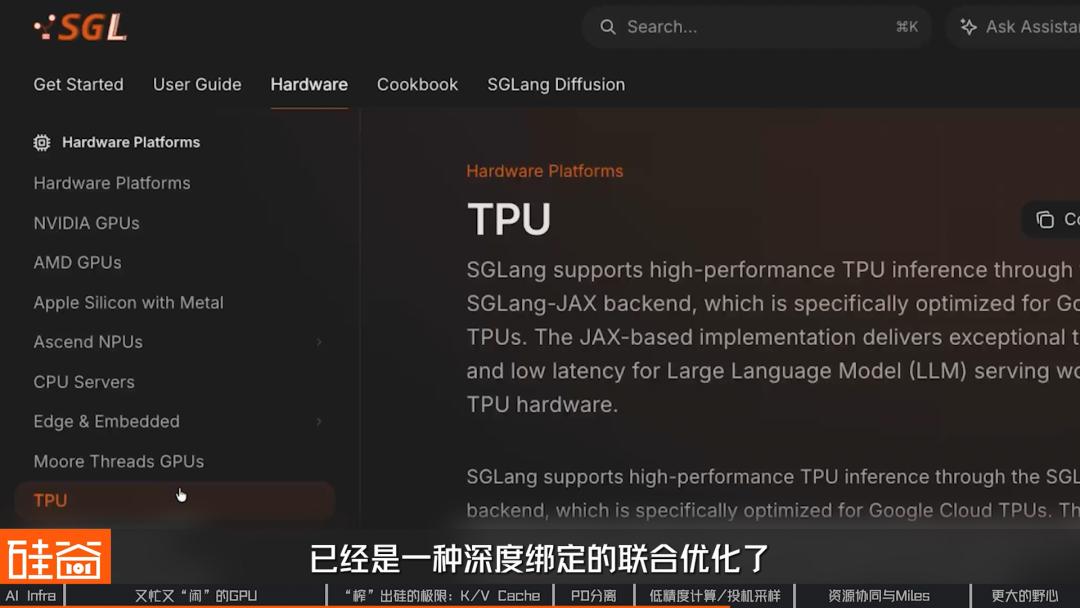
在挖掘现有算力潜力方面,低精度计算与投机采样提供了新的思路。通过降低模型权重或激活值的精度,可以在不显著损失准确率的前提下,减少显存占用并加速运算。而投机采样则引入了“草稿模型”的概念,让小模型快速生成候选文本,再由大模型进行验证。这种“助教起草、老师审核”的模式,在最佳情况下可将生成速度提升两到三倍。这些技术的落地,依赖于推理引擎与底层硬件的深度协同。如今,SGLang等引擎已成为新硬件发布的标配评测工具,芯片厂商在設計阶段便与其联合调优,确保硬件上市即具备极致性能。
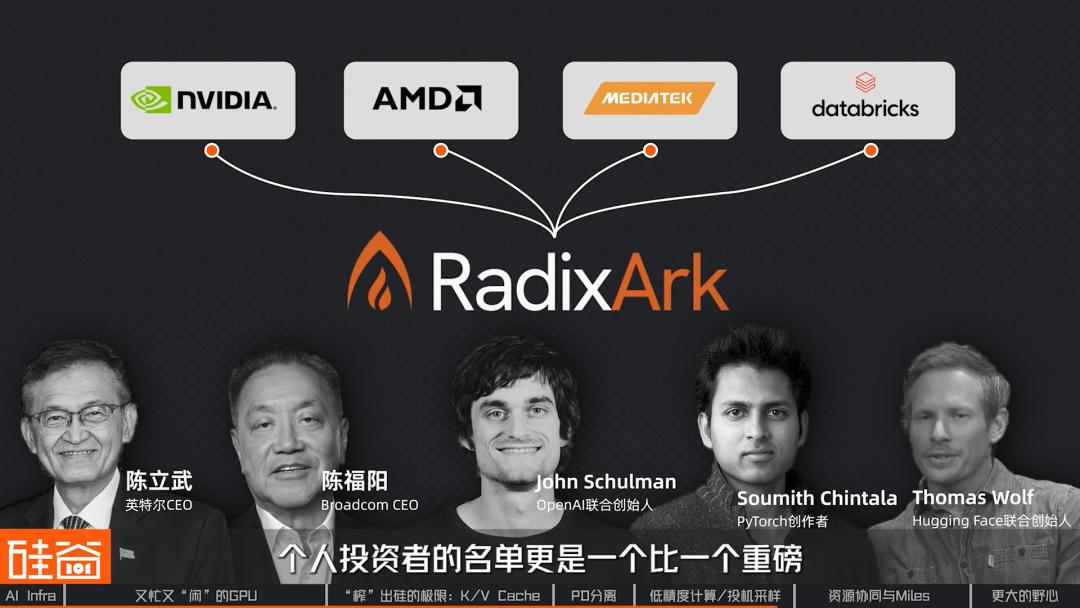
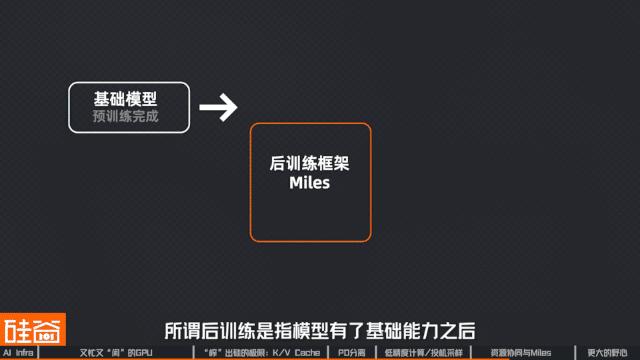
随着强化学习成为模型后训练的主流范式,AI Infra面临新的挑战。强化学习涉及推理、评估与参数更新的交替循环,传统框架难以高效协调这三种截然不同的负载。RadixArk推出的Miles框架,专门针对这一场景进行了优化。它将训练与推理纳入统一系统,实现了权重的无缝共享与策略对齐。特别是在混合专家模型(MoE)日益普及的背景下,Miles解决了训练与推理过程中路由策略不一致导致的性能损耗,构建了更高效的后训练闭环。这不仅提升了模型迭代速度,也降低了大规模强化学习的工程门槛。
当前,AI Infra正从巨头的内部工具演变为行业公共基础设施。SGLang与vLLM的商业化进程,标志着这一领域的成熟。它们不仅支持英伟达、AMD等多种硬件平台,更实现了对最新开源模型的Day-0支持。这意味着,开发者无需等待漫长的适配期,即可在最新模型发布当天完成部署。这种敏捷性极大地降低了创新门槛,使得中小型团队也能拥有与前沿实验室抗衡的基础设施能力。
展望未来,AI Infra的角色将愈发接近于“操作系统”。它屏蔽了底层硬件的异构性与复杂性,向上提供标准化的算力服务。随着开源生态的繁荣,越来越多的挑战者将涌现。他们不再受限于算力短缺,而是能够专注于模型架构与应用场景的创新。当每一块硅片的潜力都被软件极致榨取,当算力成为一种廉价且易得的公共资源,通用人工智能(AGI)的到来或许将比预期更快。这场由代码驱动的效率革命,正在重塑整个AI产业的格局,让技术红利真正普惠于每一个创新者。