MiniMax H3开源发布:手绘特效与端到端剪辑如何重塑视频后期逻辑
视频制作范式的根本性转折
视频后期制作长期以来被视为创意流程中耗时最长、技术门槛最高的环节。在过去的一年多里,尽管AI视频生成模型经历了Scaling Law的红利爆发,但其角色定位始终被局限在“素材提供商”这一初级阶段。创作者在获得一段高质量视频后,仍需将其导入专业的非线性编辑软件,进行字幕添加、色调校正、转场拼接、配乐同步以及特效合成等一系列繁琐操作。这种“生成+后期”的割裂模式,不仅极大地增加了内容生产的时间成本,也限制了创意表达的即时性与连贯性。
MiniMax最新发布的H3模型,正在从根本上重构这一工作流。作为业界首款开源的视频大模型,H3不仅仅是一个生成器,更是一个集成了剪辑逻辑、视觉美学、音频同步与特效合成的全能型创作中枢。它打破了“生成即结束”的传统认知,通过端到端的技术架构,将复杂的后期处理逻辑内化于模型本身。用户只需输入一段文本描述,即可直接获得包含精美特效、精准字幕、流畅转场及背景音乐匹配的最终成品视频。这一变革意味着,视频创作的核心竞争力正从“软件操作熟练度”向“创意构思与审美判断”转移,AI正在接管那些重复性高、规则明确的后期工序。
手绘美学与视觉特效的智能化落地
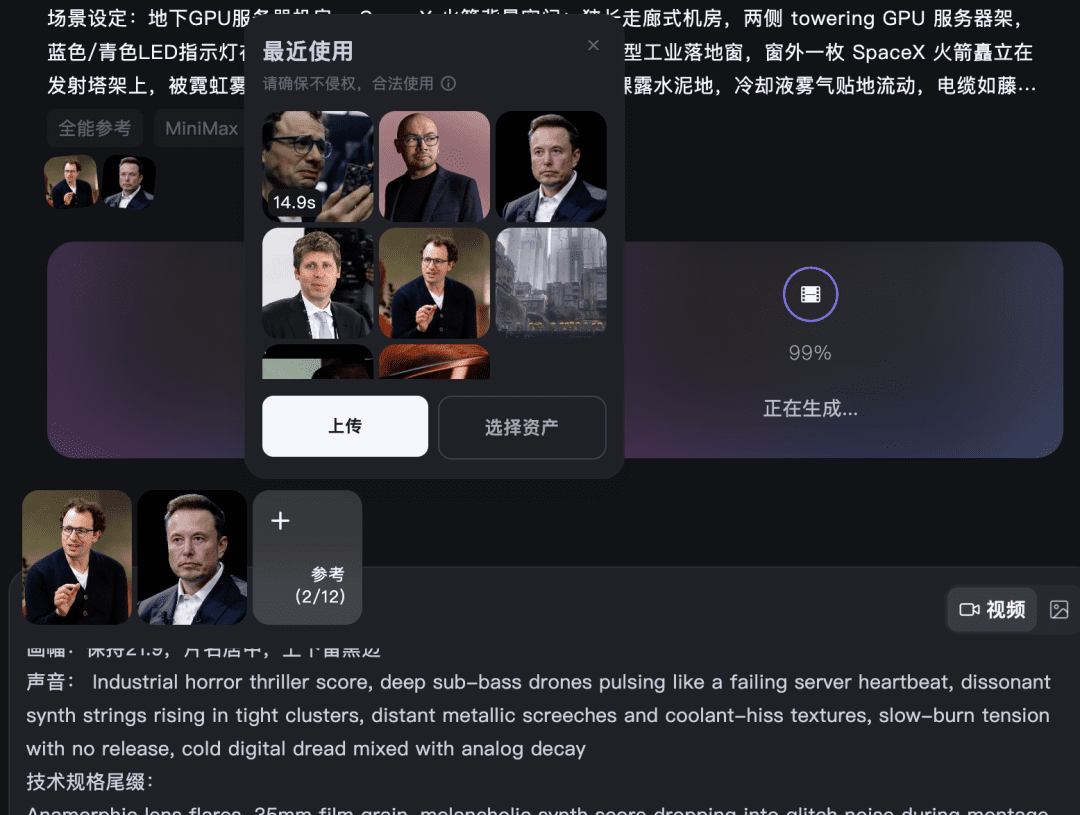
H3模型最令人惊艳的特性之一,是其对特定视觉风格——尤其是手绘风格特效——的卓越把控能力。在传统的视频后期中,手绘动画或手绘风格的转场往往需要人工逐帧绘制或通过复杂的After Effects插件实现,对制作团队的专业技能要求极高。而H3通过其强大的多模态生成能力,能够直接理解并渲染此类具有艺术感的视觉效果。
无论是添加灵动的花体字幕,还是制作具有电影质感的动态片头,H3都能做到“所见即所得”。这种能力并非简单的贴图叠加,而是深入到了光影、材质与动态轨迹的底层逻辑。例如,在生成“Apple发布会风格”的宣传片时,模型能够精准捕捉玻璃折射、渐变色彩过渡以及极简主义的空间布局,生成极具辨识度的平行宇宙视觉风格。这种对风格化指令的高度敏感度,使得视频制作不再受限于写实主义的束缚,极大地拓展了内容创作的美学边界。
此外,H3在复杂镜头语言的处理上也表现出惊人的稳定性。在测试“AGI复仇者联盟”类多角色互动的场景时,模型能够同时处理多个角色的表情逻辑、空间位置关系以及快速蒙太奇剪辑的节奏感。即使是极快节奏下的情绪爆发点(如角色崩溃、特写镜头切换),也能保持画面连贯性与情绪张力的完整传递。这种对叙事节奏的把控,标志着AI视频模型从“静态美学生成”向“动态叙事构建”的跨越。
文字渲染与多模态上下文的深度融合
在AI视频生成领域,文字渲染一直是一个公认的难点。与静态图像不同,视频中的文字需要在时间维度上保持形态一致,任何一帧的扭曲或变形都会导致视觉上的廉价感。此前,许多模型在处理汉字或复杂排版时容易出现笔画断裂、逻辑错乱等问题,严重限制了其在商业广告和品牌物料中的应用。
H3模型在这一痛点上取得了突破性进展。实测显示,H3生成的视频文字不仅准确无误,更具备了与画面融合的物理属性。例如,在生成“钻石项链”主题的视觉视频时,模型不仅是将文字叠加在画面上,而是为文字赋予了与主体一致的光影反射、景深虚化以及材质质感。文字随着镜头的运动产生自然的视差效果,这种“图文一体”的处理方式,使得信息传递与视觉美感达到了高度统一。
这一能力的背后,是H3对多模态上下文的深度理解。模型不仅仅将文字视为独立的字符序列,而是将其视为画面构图的一部分。它理解文字与背景、光影、镜头运动之间的语义关联,从而在生成过程中进行全局优化。这种对文字语义与视觉表现的统一建模,使得H3生成的视频可以直接用于商业投放,极大地降低了品牌方使用AI生成营销素材的门槛。
音频驱动与情感同步的创新机制
传统视频后期中,配音与画面的同步往往依赖人工调整,难以做到情绪与节奏的微观匹配。H3模型引入了音频驱动视频生成的创新机制,允许用户直接上传音频文件,让模型根据语音的情绪、语调和节奏自动生成相应的画面动态。
这并非简单的口型匹配,而是基于对音频情感特征的深度解析。模型能够识别音频中的停顿、重音、情绪起伏等细微特征,并转化为视觉上的运镜速度、角色微表情变化以及剪辑节奏。这种“音画共生”的技术路径,源于MiniMax在多模态语音模型上的长期积累。通过将语音理解能力与视频生成能力在统一架构中打通,H3实现了跨模态的情感共鸣。创作者无需精确计算每一帧的时长,只需关注音频的情感内核,AI即可自动将其转化为视觉语言。这一功能对于Vlog制作、音乐MV生成以及短剧创作而言,具有极高的实用价值。
开源生态与私有化部署的商业价值
H3发布的另一重重大意义在于其开源策略。在当前的AI视频模型市场中,大多数SOTA(State-of-the-Art)模型仅通过API提供服务,这不仅存在数据隐私泄露的风险,也限制了企业在特定垂直领域的深度定制能力。H3的开源,为行业提供了私有化部署的可能性,解决了企业对核心IP、品牌画风及专属工作流的保护需求。
对于内容创作机构和企业而言,私有化部署意味着可以使用自有的高质量数据进行微调(Fine-tuning),从而训练出具有独特品牌风格的小模型。这种基于行业数据的二次开发,能够显著提升生成结果的专业度与一致性。同时,H3的API定价极具竞争力,在2K分辨率下的成本仅为主流模型的一小部分,这使得大规模自动化内容生产在经济效益上成为可能。
开源还赋予了开发者社区更多的创新空间。从Infra层面的优化到应用层的插件开发,开源生态有望加速推理成本的下降与技术边界的拓展。MiniMax坚持“Intelligence with Everyone”的愿景,通过开源将智能技术 democratize(民主化),使得中小创作者也能拥有顶级大厂的创作工具。这种开放姿态不仅促进了技术的快速迭代,也为AI视频行业注入了新的活力。
迈向可商用的“Coding时刻”
回顾MiniMax H3的技术特征,其核心逻辑可以归纳为“多模态+语言”的涌现。通过构建Omni Transformer架构,模型能够统一处理图像、视频、音频、文本等多种模态的信息。在这个架构中,语言不再仅仅是提示词(Prompt),而是作为连接不同模态的“胶水”,发挥着泛化与推理的作用。
这种技术路线的选择,使得H3能够更精准地理解用户的复杂意图。无论是简单的风格迁移,还是复杂的剧本分镜执行,模型都能在语义层面进行解析与重组。视频生成不再是纯粹的随机采样(抽卡),而是变成了可控的、可预期的生产流程。
随着H3的发布,AI视频行业正式进入了“Coding时刻”。这里的“Coding”并非指编写代码,而是指将创意意图通过结构化指令转化为标准化生产流程的过程。视频生成从一种实验性的娱乐工具,进化为可信赖的商业生产基础设施。对于行业而言,这意味着更高的效率、更低的门槛以及更广阔的创意可能性。中国开源力量的崛起,正通过这样的硬核技术突破,在全球AI竞争中占据重要席位。未来,随着更多此类开源模型的涌现,视频内容创作将迎来真正的爆发式增长,而掌握多模态生成能力的创作者,将在新的媒介环境中占据主导地位。