服务进程存活却访问失败?Prometheus黑盒监控实战指南
突破传统监控盲区:从进程状态到用户体验的视角转换
在传统的IT运维监控体系中,绝大多数团队将重心放置在主机层面的资源指标上。CPU使用率、内存占用、磁盘I/O以及进程存活状态,构成了监控面板的基石。只要这些基础指标处于绿色区间,运维人员往往倾向于认为系统运行健康。然而,这种基于“内部视角”的监控逻辑存在显著的盲区。对于最终用户而言,服务进程是否存活并非核心关切,真正决定业务价值的是网站能否正常加载、API接口是否返回有效数据、以及网络链路是否畅通无阻。
现实中,大量故障呈现出“内通外不通”或“进程存活但服务不可用”的复杂形态。例如,DNS解析记录错误导致域名无法指向正确IP,防火墙策略变更拦截了特定端口,反向代理配置错误导致502 Bad Gateway,或者SSL证书过期引发HTTPS握手失败。更隐蔽的情况是,Web服务进程仍在运行,但由于数据库连接池耗尽或死锁,导致请求长时间挂起直至超时。这些故障在主机监控中几乎无迹可寻,却直接导致业务中断。
为了解决这一痛点,Prometheus生态中的Blackbox Exporter应运而生。它提供了一种“黑盒”式的主动探测机制,模拟真实用户的行为,从外部对目标服务发起HTTP、TCP、ICMP或DNS探测。通过这种方式,监控不再局限于服务器内部,而是延伸至网络链路和协议交互层面,从而实现对服务可用性的全方位感知。
部署基石:Blackbox Exporter的安装与系统级集成
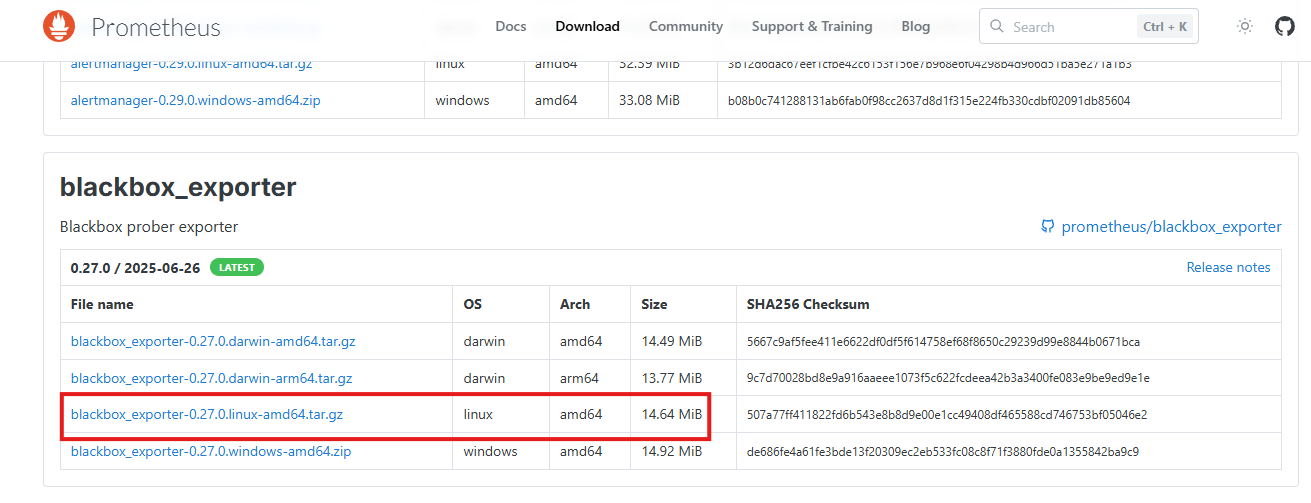
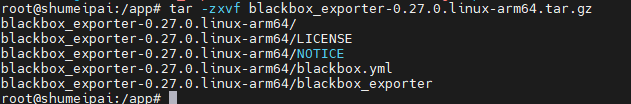
在Ubuntu环境中部署Blackbox Exporter,首先需要确立标准化的目录结构与服务管理方式。建议创建专用目录如/app来存放二进制文件,以保持系统整洁。从Prometheus官方下载对应架构(如Linux ARM64或AMD64)的压缩包,解压并重命名为简洁的blackbox_exporter,便于后续维护。
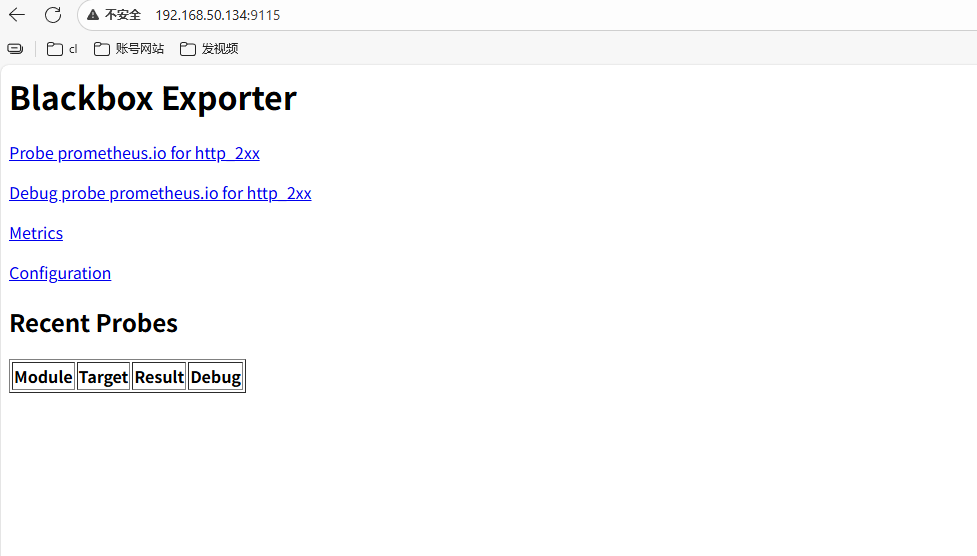
将Blackbox Exporter配置为systemd服务是实现高可用性的关键步骤。通过编写/usr/lib/systemd/system/blackbox_exporter.service文件,定义服务的启动参数、重启策略及依赖关系。配置文件中需指定ExecStart指向二进制文件路径,并加载配置文件。随后,执行systemctl daemon-reload重载守护进程配置,启动服务并设置开机自启。验证部署是否成功,可通过访问http://<IP>:9115查看默认指标页面,确认服务已正常监听。
核心配置:定义探测模块与采集策略
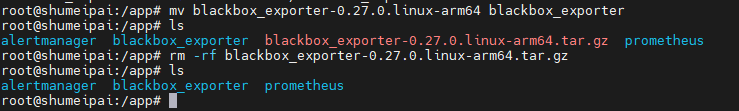
Blackbox Exporter的强大之处在于其模块化的探测配置。在blackbox.yml配置文件中,可以定义多种探测模块,涵盖HTTP、TCP、ICMP等协议。例如,http_2xx模块用于检查HTTP响应状态码是否为200系列;tcp_connect模块用于验证端口连通性;icmp模块则用于模拟Ping操作,检测网络延迟与丢包情况。
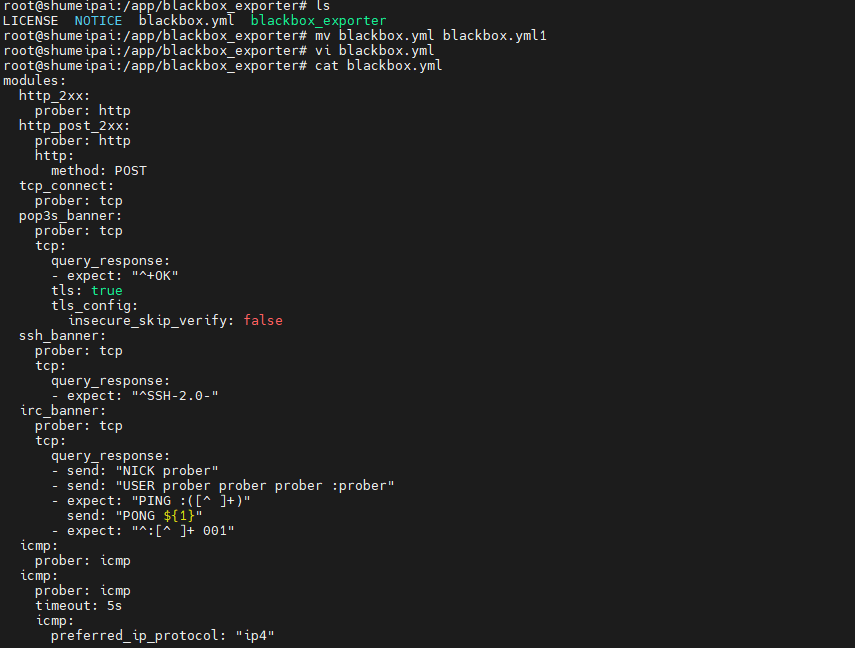
在Prometheus端,需要通过scrape_configs配置采集任务。对于HTTP探测,需设置metrics_path: /probe,并通过params指定使用的模块(如[http_2xx])。关键在于relabel_configs的配置,它负责将目标地址映射为探测参数__param_target,并将Blackbox Exporter的地址设为__address,从而引导Prometheus向Blackbox Exporter发起探测请求,而非直接抓取目标服务。
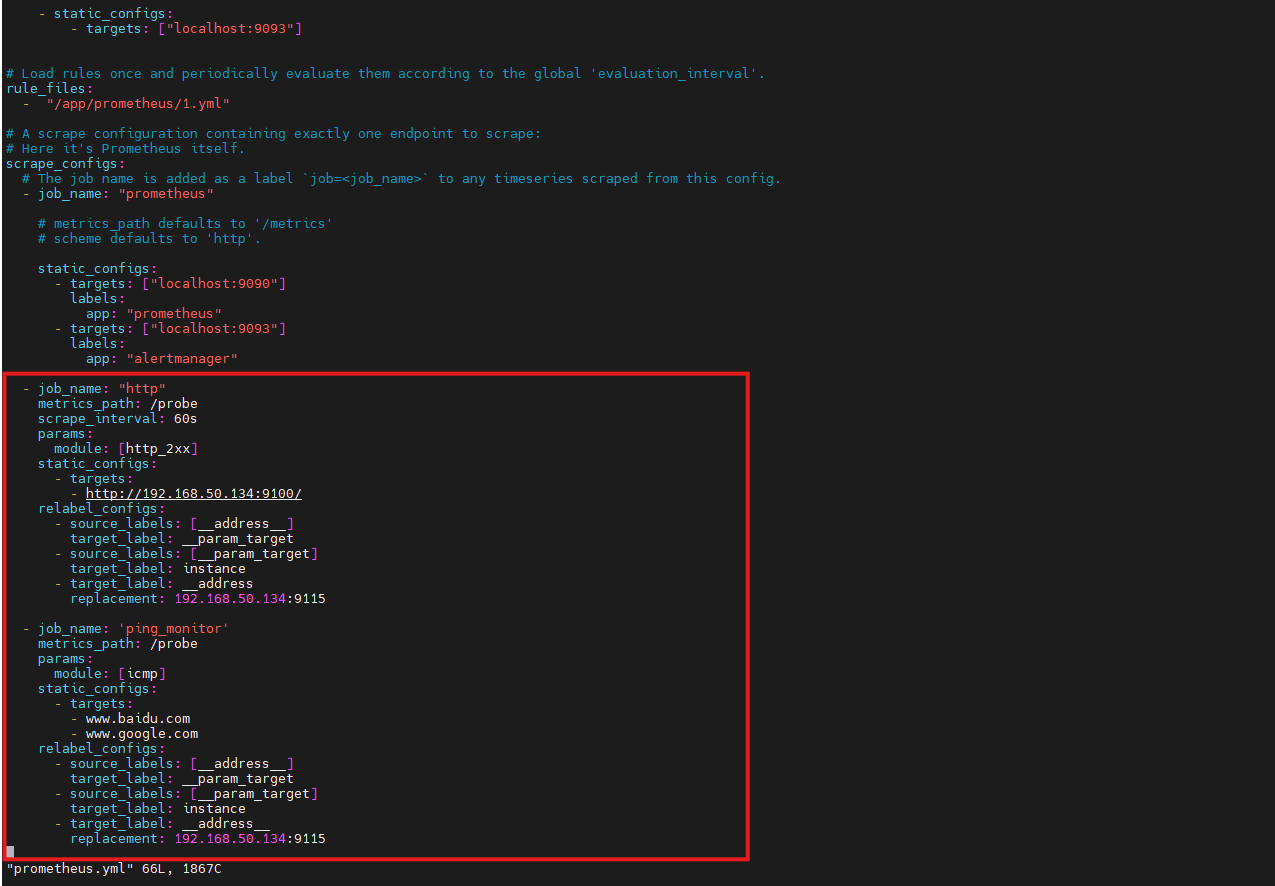
对于网络链路监控,配置ping_monitor任务,使用icmp模块探测关键域名或IP。通过设置合理的scrape_interval,如60秒,平衡监控粒度与系统负载。这种配置方式使得Prometheus能够持续收集探测结果,包括probe_success(成功与否)、probe_duration_seconds(响应时间)等关键指标。
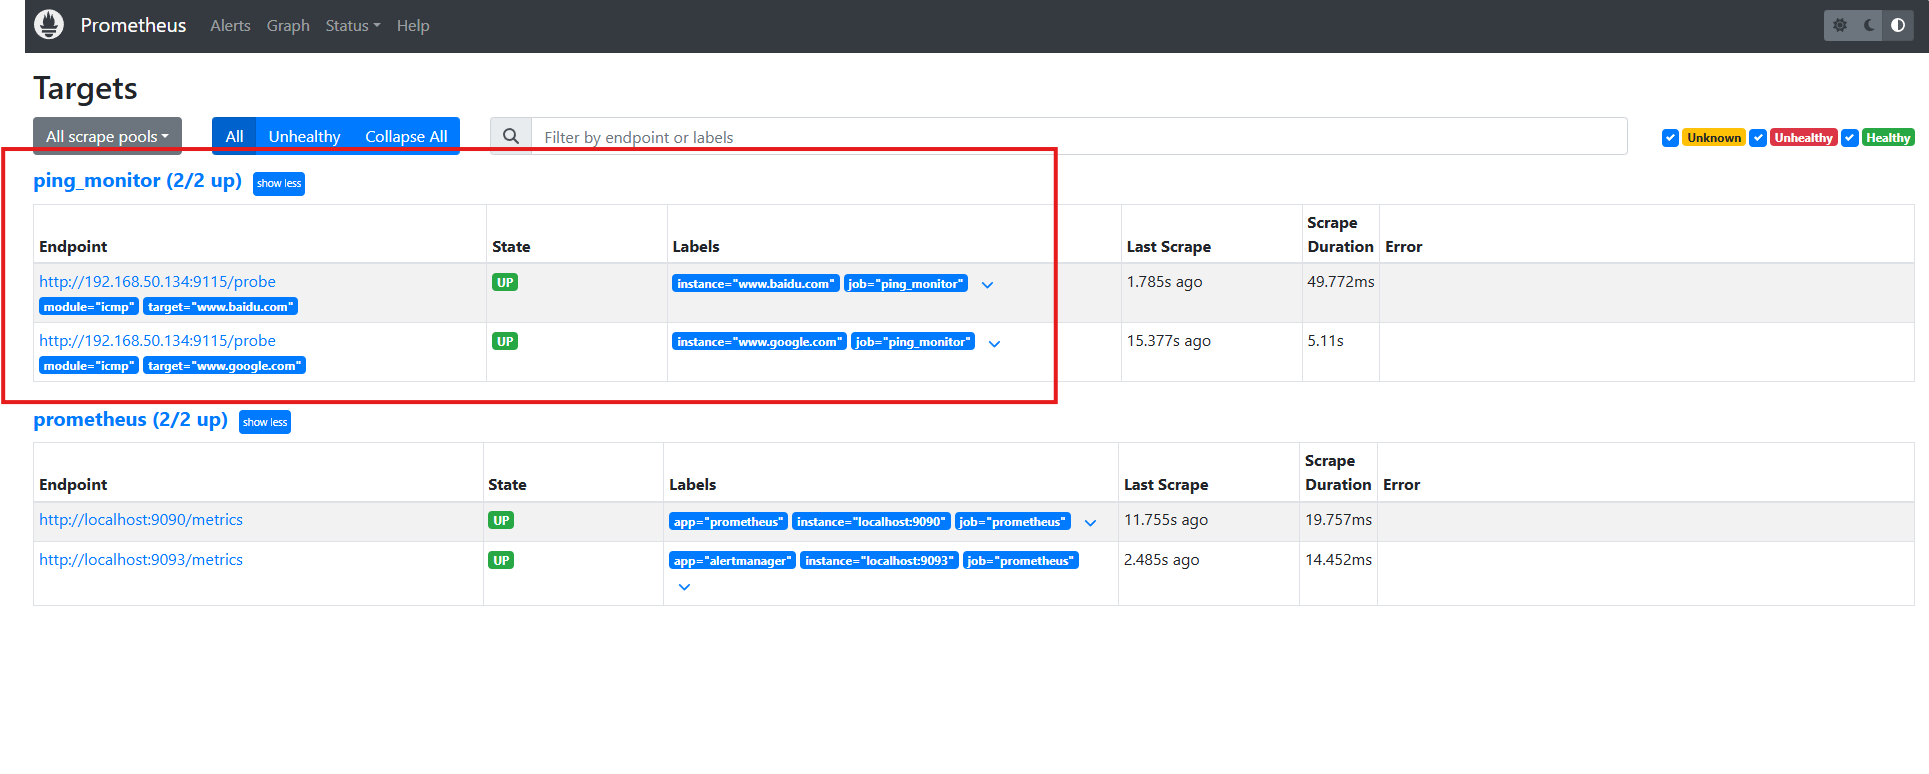
智能告警:基于数据驱动的故障发现
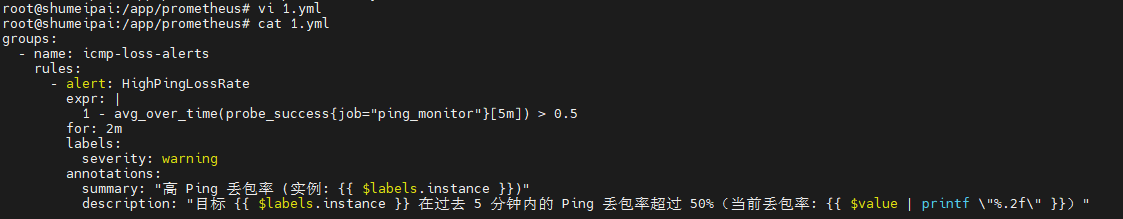
监控的价值在于及时发现问题。通过Prometheus的告警规则引擎,可以基于Blackbox Exporter收集的指标构建智能告警。例如,针对网络丢包问题,可以定义HighPingLossRate告警规则。该规则利用probe_success指标计算丢包率,当过去5分钟内的平均丢包率超过50%且持续2分钟时,触发Warning级别告警。
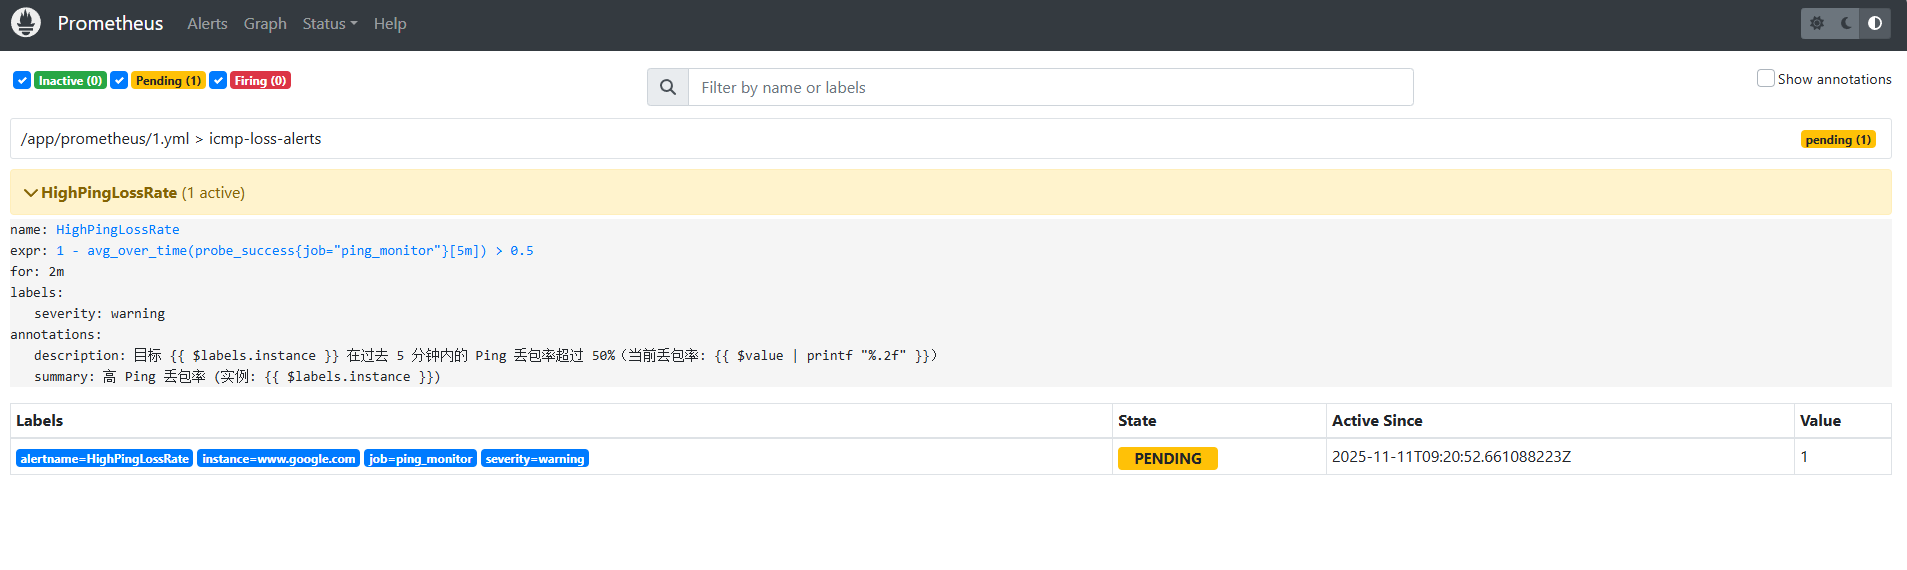
告警规则的配置需精确表达业务逻辑。通过PromQL表达式1 - avg_over_time(probe_success{job="ping_monitor"}[5m]) > 0.5,可以量化网络质量恶化程度。同时,在Annotations中嵌入动态标签,如实例名称和当前丢包率,使得告警信息具备高度的上下文相关性,帮助运维人员快速定位故障源。这种基于阈值的告警机制,能够有效区分瞬时抖动与持续性故障,减少误报。
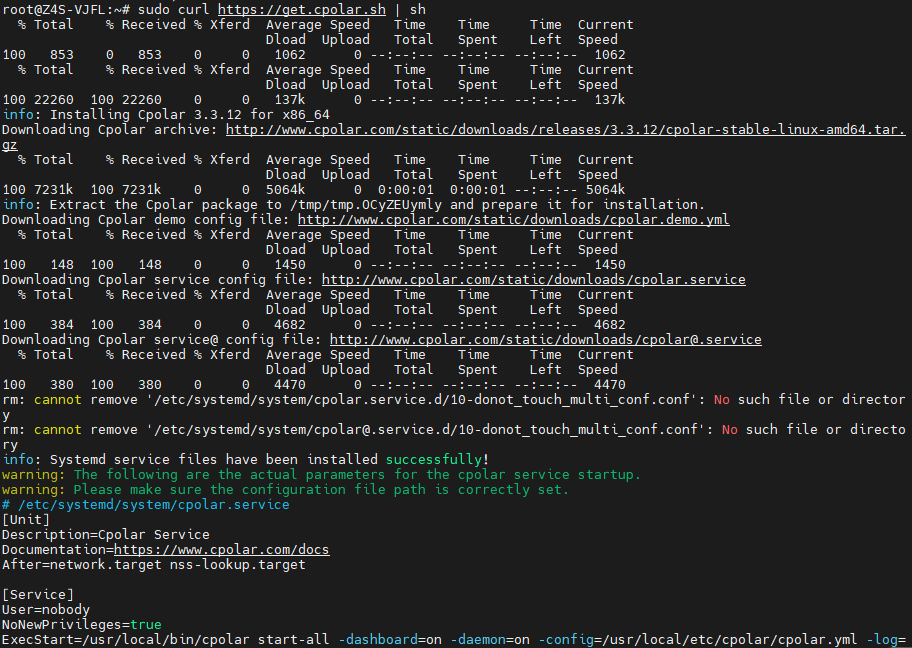
远程访问:打破物理边界的监控解决方案
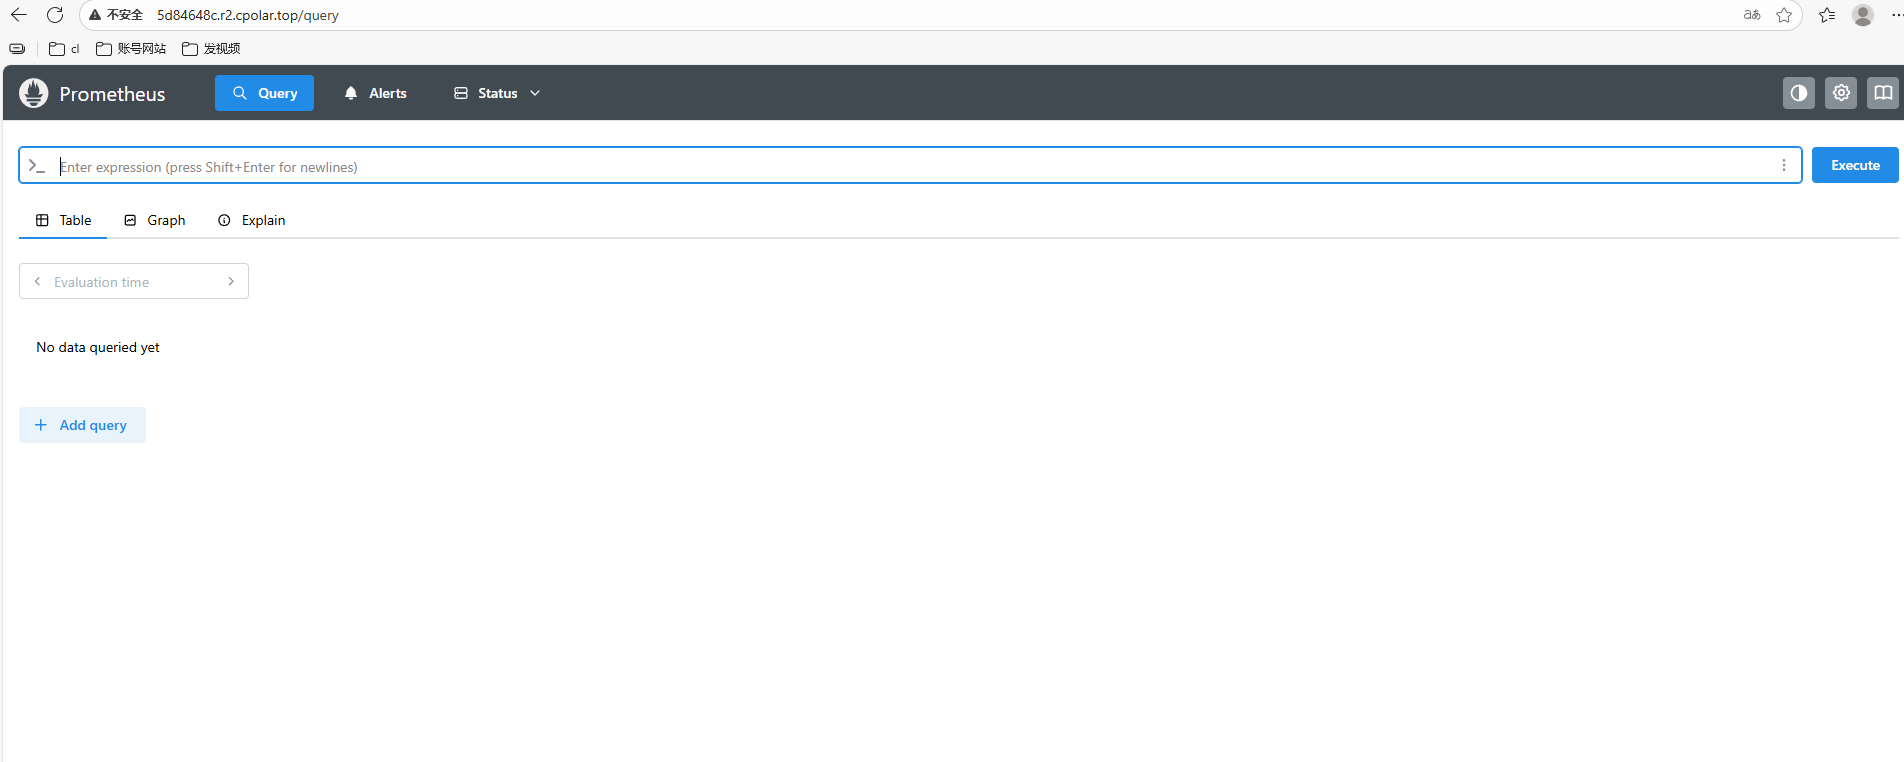
本地部署的Prometheus监控面板通常仅在内网可访问,这在远程办公或紧急故障排查时带来不便。通过内网穿透工具如cpolar,可以将本地Prometheus的9090端口映射到公网,实现随时随地访问。
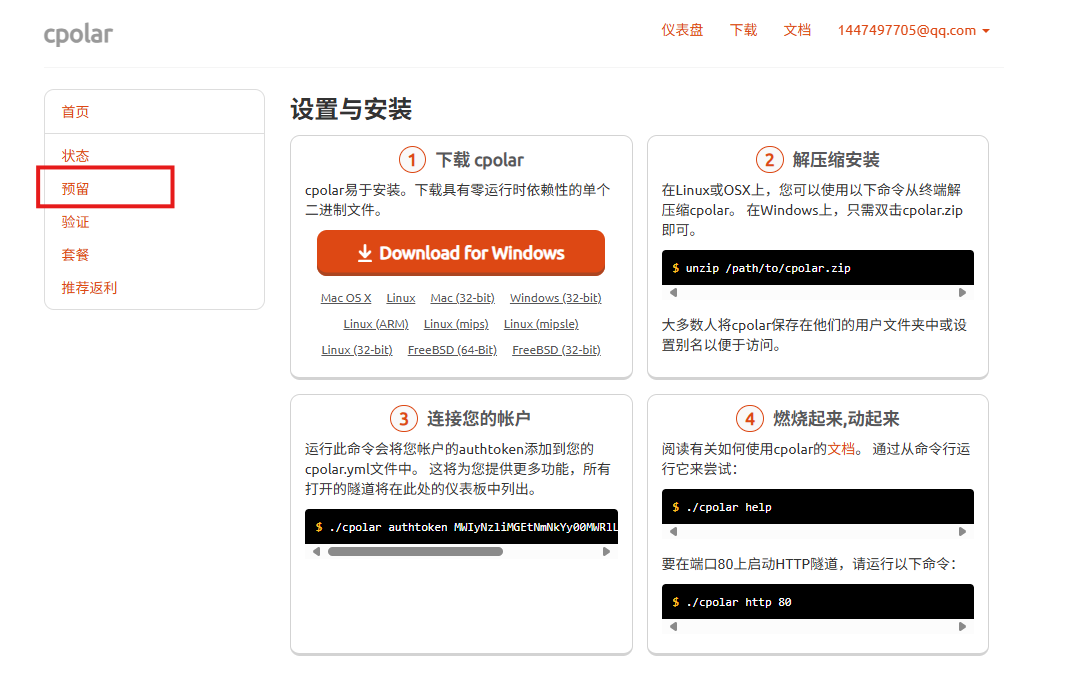
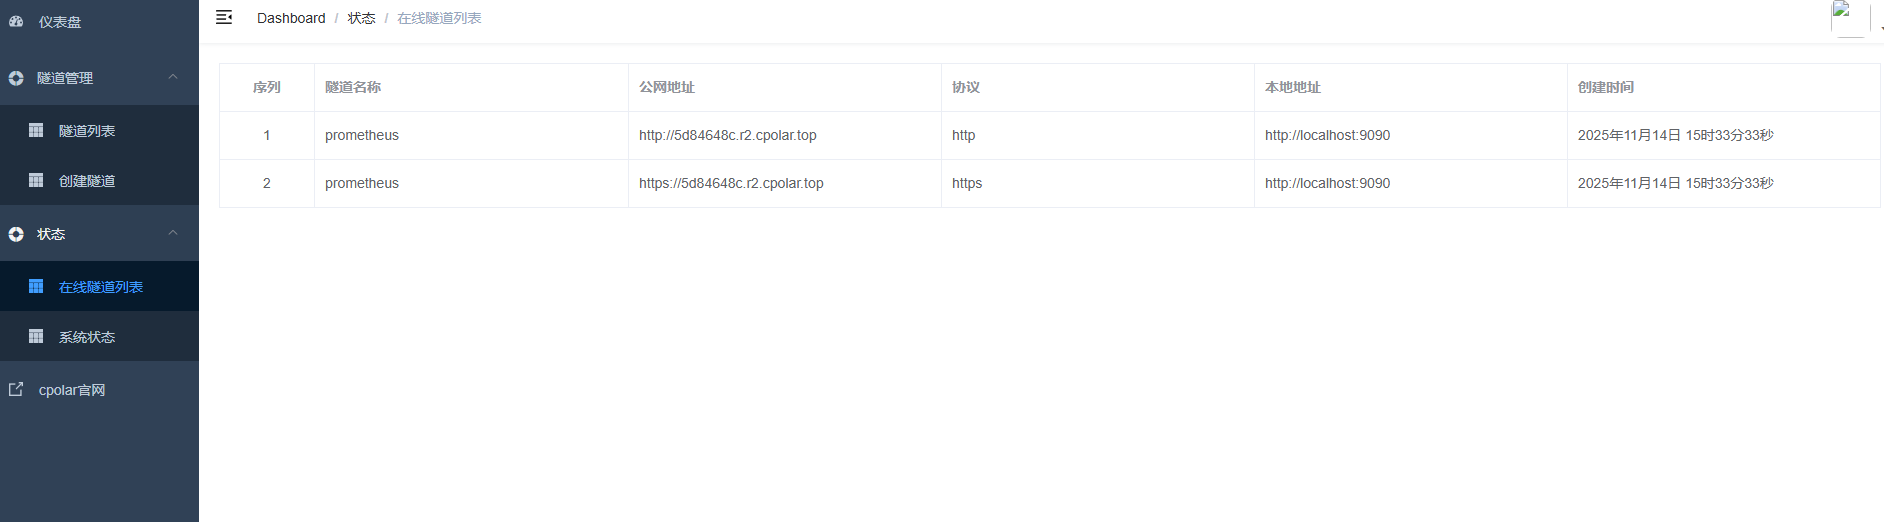
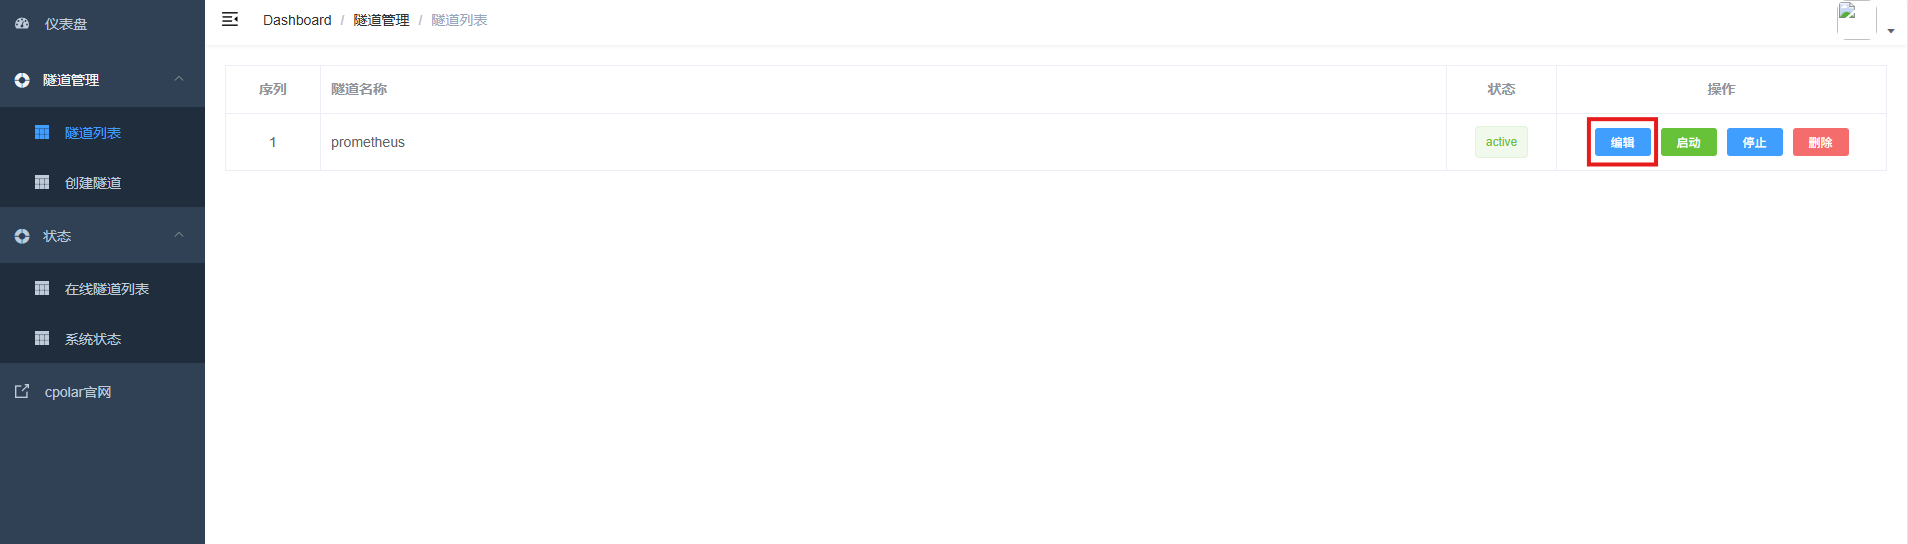
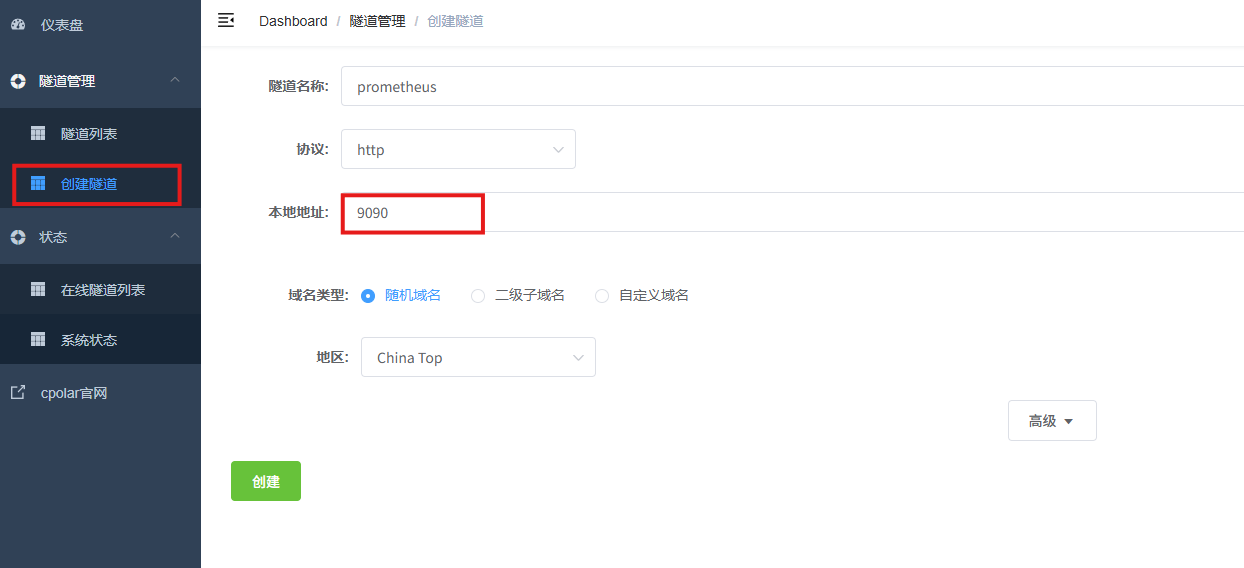
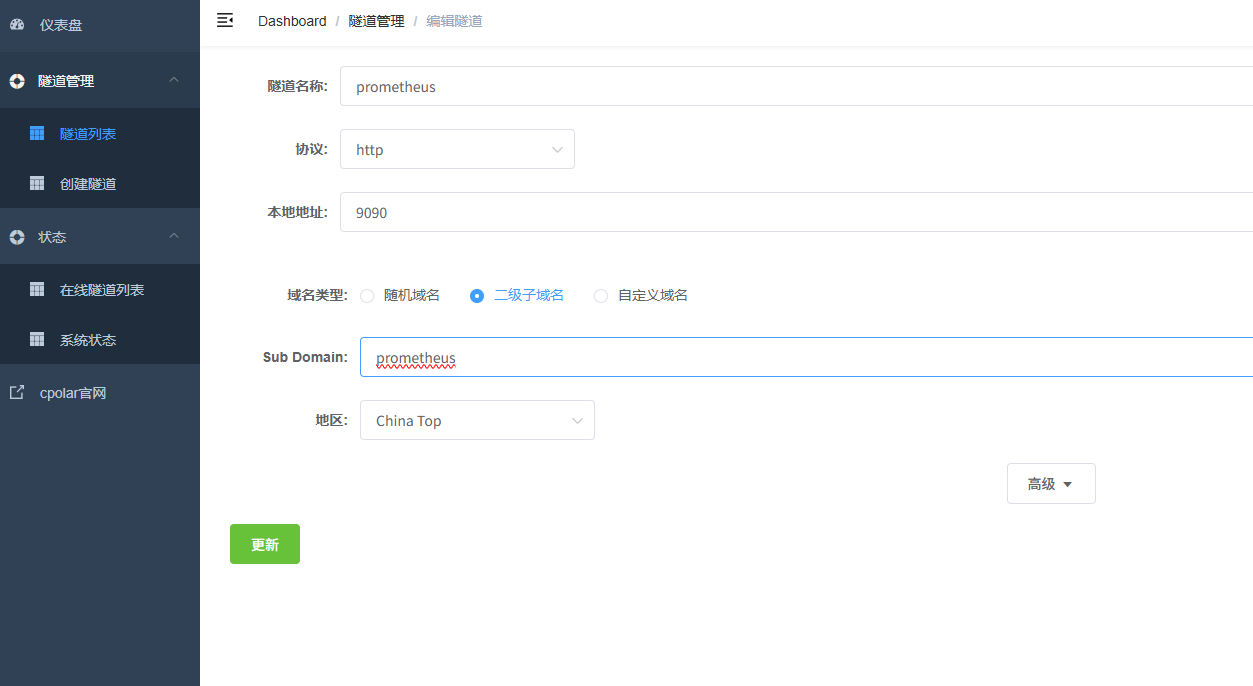
安装cpolar后,通过Web界面创建HTTP隧道,指定本地地址为9090,地区选择China Top。为确保持久性,建议保留固定二级子域名,避免随机域名变化导致的访问中断。配置完成后,生成的公网URL即可在任何设备上访问本地监控面板。这一方案不仅解决了远程访问问题,还通过固定域名提升了监控服务的稳定性与专业性。
深度解析:黑盒监控在复杂架构中的价值
在微服务架构中,服务间的调用链路复杂,故障点可能隐藏在任何一个环节。Blackbox Exporter的价值在于其独立于业务代码的探测能力。它不依赖应用内部暴露的指标,而是通过外部协议交互验证服务状态。这种“外部视角”能够发现内部监控无法覆盖的问题,如CDN节点故障、负载均衡器配置错误、或第三方API限流等。
此外,黑盒监控数据可以与业务指标结合分析。例如,当HTTP探测失败率上升时,结合应用层的错误日志和Trace ID,可以快速定位是网络层问题还是应用层逻辑错误。这种多维度的数据关联分析,提升了故障诊断的效率与准确性。
最佳实践与注意事项
在实际部署中,需注意以下几点最佳实践。首先,合理设置探测频率,避免过于频繁的请求对目标服务造成压力。其次,配置合理的超时时间,确保探测结果反映真实网络状况。对于关键业务,建议配置多地域的探测节点,以评估全球用户的访问体验。
安全性方面,Blackbox Exporter暴露的接口应限制访问权限,防止未授权探测。对于HTTPS探测,需正确配置证书验证,避免因证书过期或自签名证书导致误报。同时,定期审查告警规则,优化阈值设置,确保告警的准确性与及时性。
结语
Prometheus与Blackbox Exporter的组合,为现代运维监控提供了从内部资源到外部体验的全景视图。通过主动探测机制,运维团队能够提前发现网络链路、DNS解析及HTTP状态等潜在问题,变被动响应为主动预防。结合内网穿透技术,监控服务不再受物理网络限制,实现了真正的随时随地可访问。这一架构不仅提升了系统的可用性保障能力,也为复杂分布式环境下的故障排查提供了强有力的数据支撑。随着云原生技术的普及,黑盒监控将成为构建高可用系统不可或缺的基础设施。