276B参数反超万亿模型?Inkling-Small如何重塑开源AI格局
在人工智能领域,通常认为规模的扩大是性能提升的唯一路径,但Thinking Machines最新发布的Inkling-Small模型正在挑战这一固有认知。这款拥有2760亿总参数、仅120亿激活参数的混合专家(MoE)模型,不仅在多项核心基准测试中击败了参数量是其四倍的初代Inkling,更在数学推理、智能体编码及多模态理解上展现了惊人的效率优势。这一发布时机颇具戏剧性:就在公司联合创始人翁荔官宣回归OpenAI带队攻坚递归自我提升(RSI)项目后不久,Thinking Machines便抛出了这款全量权重的开源模型,仿佛在向行业宣告,即便面临核心人才流失,其技术引擎依然强劲有力。
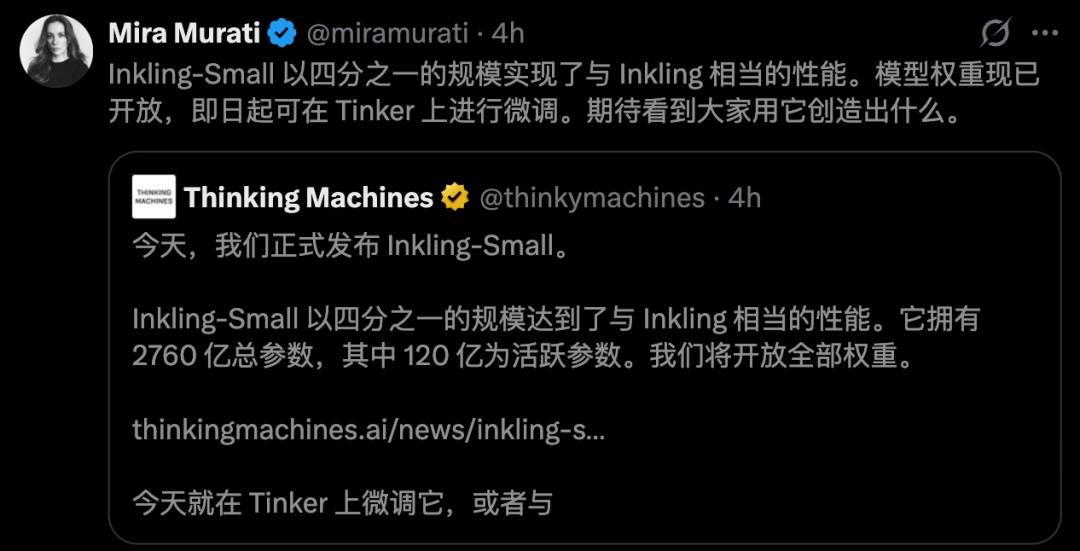
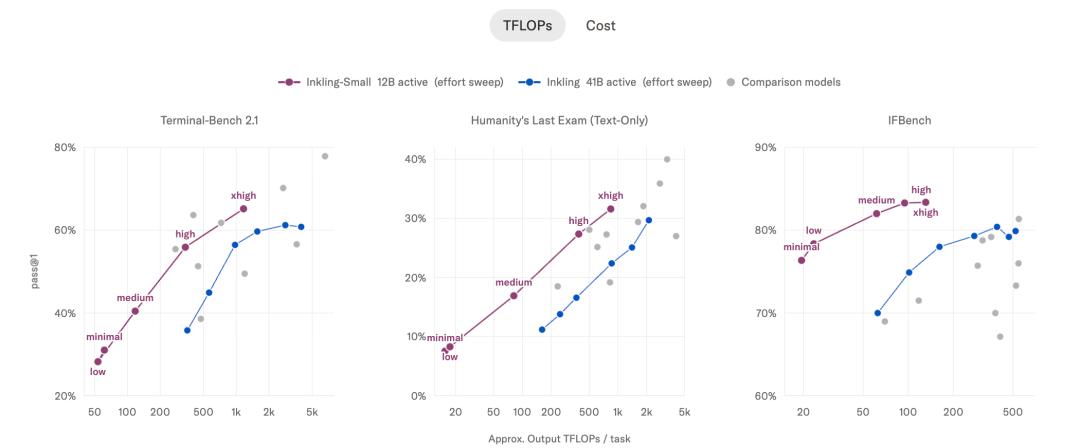
从技术架构来看,Inkling-Small并非简单的缩小版,而是一次精密的工程学胜利。其采用的MoE架构允许模型在每次推理时仅激活部分参数,从而大幅降低了计算负载。120亿的激活参数量被业界视为强化学习的“甜点区”,这意味着开发者可以在有限的硬件资源下进行高效的LoRA微调或全参数训练。相比之下,初代Inkling高达2TB的显存需求将绝大多数中小团队拒之门外,而Inkling-Sold则将这一门槛显著降低,使得基于8张B200显卡的配置即可实现流畅的高并发推理,解码速度在开启DSpark优化后可达648 tok/s。这种能效比的提升,标志着AI模型竞争已从单纯的参数军备竞赛转向了单位FLOP(浮点运算次数)性能比的精细化较量。
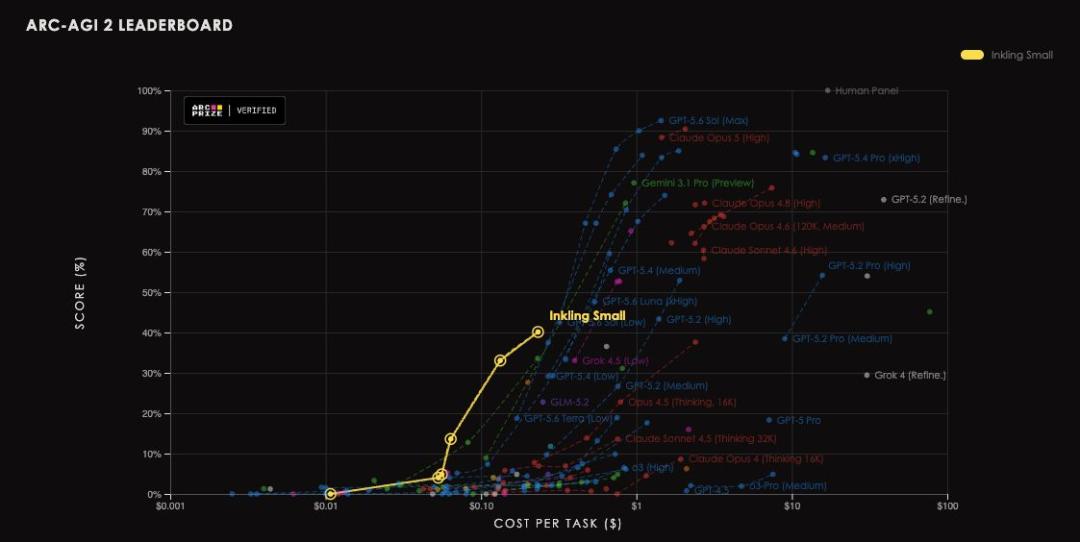
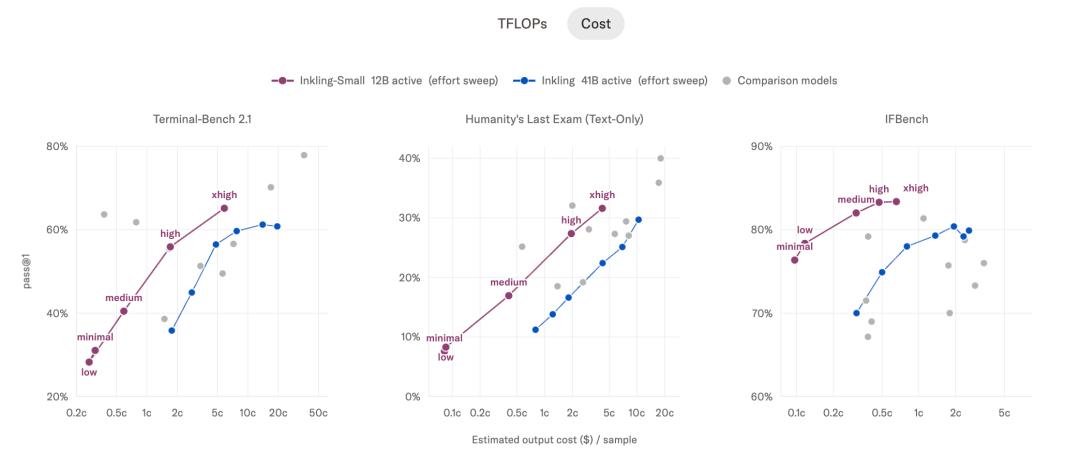
在性能表现上,Inkling-Small的数据令人瞩目。在HLE、Terminal-Bench和IFBench这三个衡量模型实际应用能力的关键指标上,Inkling-Small的每一单位计算资源所换取的性能均高于其前身。特别是在ARC-AGI-2基准测试中,它刷新了开源模型的最好成绩,证明了其在复杂逻辑推理和泛化能力上的突破。多模态方面,尽管体量缩小,但其在图表理解、视觉推理及长音频处理上的表现并未出现明显降级,几乎接近原版水平。这种“以小博大”的能力,得益于其独特的训练策略,即不再依赖海量的暴力预训练,而是通过更精准的数据配比和算法优化来挖掘模型潜力。
深入探究其背后的训练方法论,可以发现Thinking Machines构建了一条可复制的高效模型产线。官方披露的技术细节显示,Inkling-Small的成功主要归功于两步关键操作。首先,利用初代Inkling作为教师模型,进行On-policy蒸馏,生成一个高质量的预览检查点。这一步骤有效地将大模型的知识浓缩至小模型中,保留了核心的推理能力。随后,团队在这个检查点的基础上,进行了为期两周的高强度智能体编码强化学习。正是这短短两周的强化训练,让“学生”模型在特定任务上实现了对其“老师”的反超。这一过程不仅验证了蒸馏技术的有效性,更展示了强化学习在提升模型垂直领域能力方面的巨大潜力。
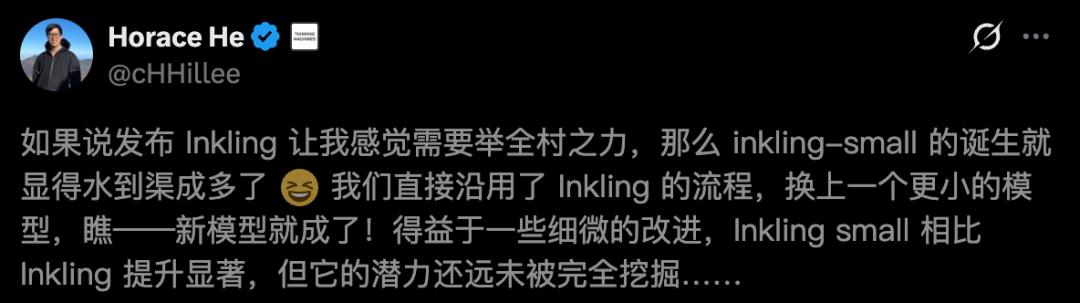
这种快速迭代的能力,反映了AI研发范式的深刻转变。过去,训练一个大模型往往需要数月甚至数年的周期,且一旦完成便难以大幅修改。而现在,通过建立标准化的数据管道和强化学习框架,模型的开发变成了持续优化的过程。Inkling-Small的诞生证明,第二个模型不仅仅是第一个模型的补充,更是整个技术栈成熟度的体现。它表明Thinking Machines已经掌握了一套能够反复产出高性能模型的方法论,这对于任何致力于长期AI研发的组织而言,都是比单一模型更为宝贵的资产。
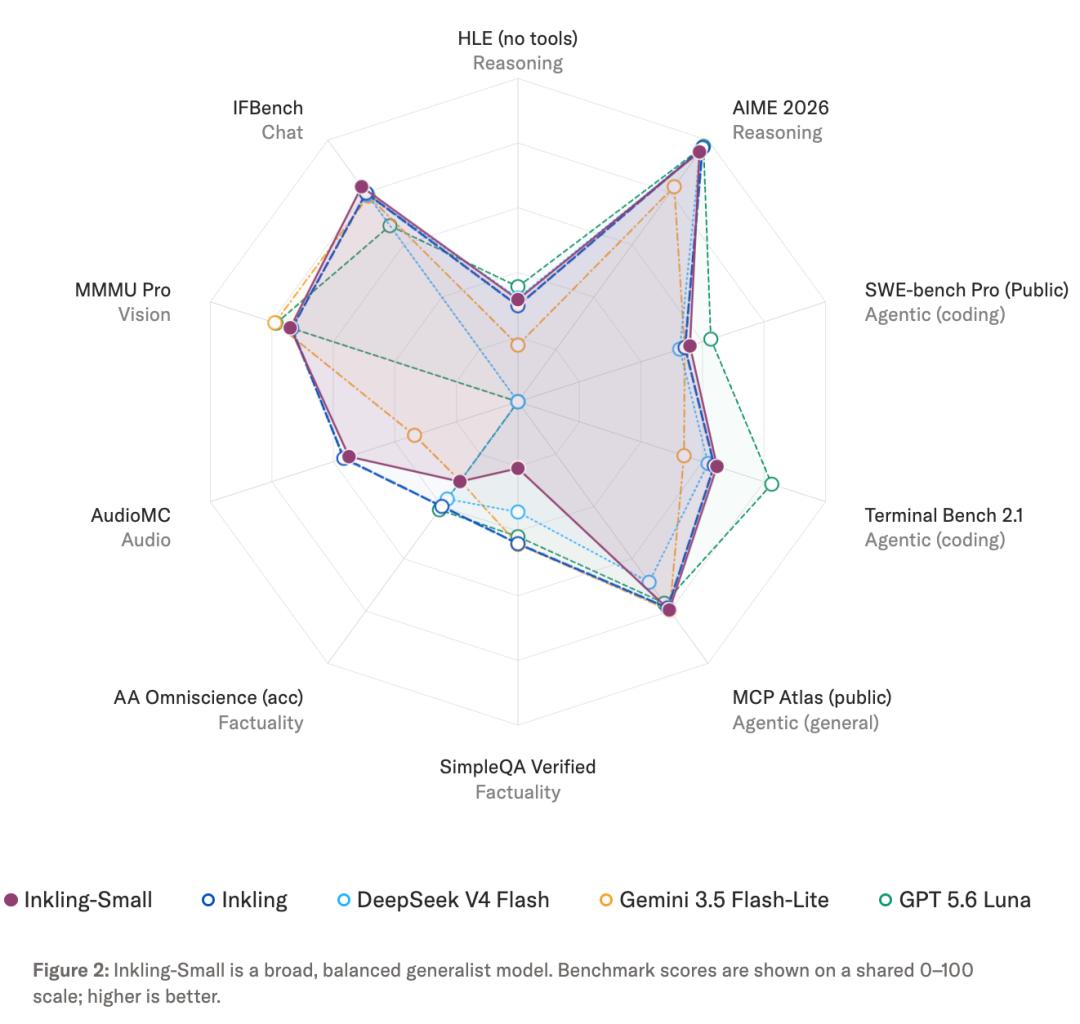
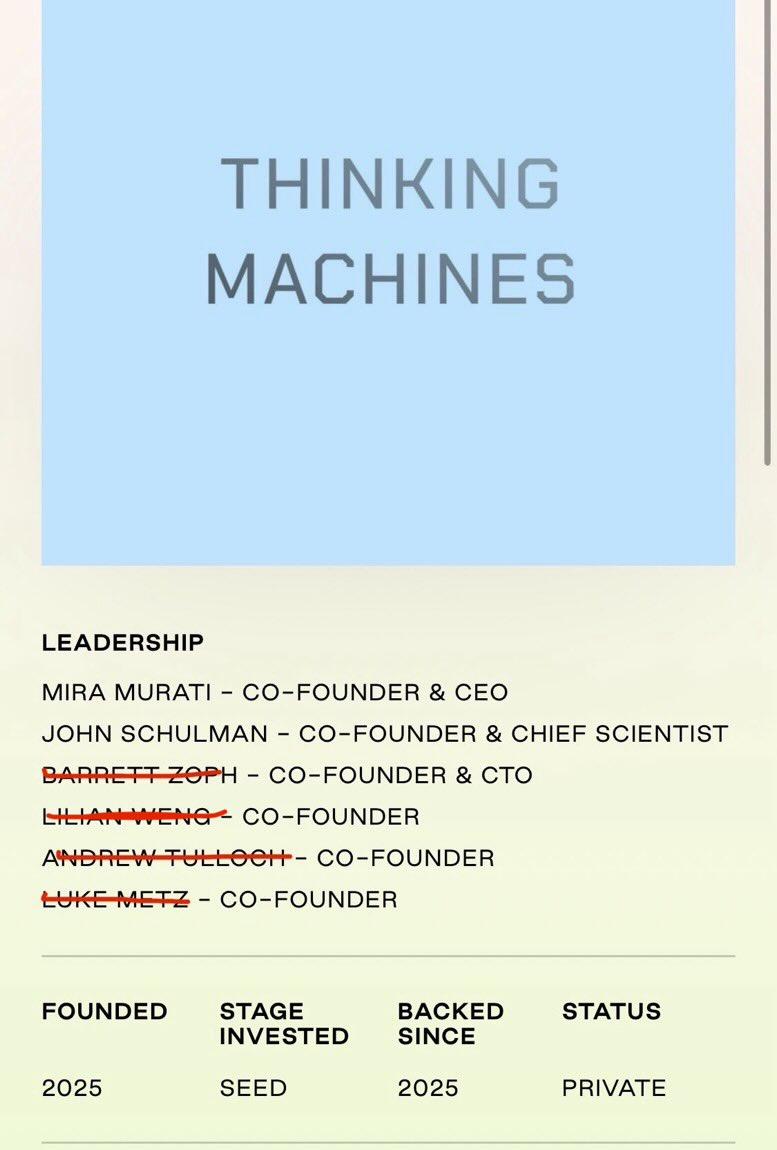
然而,技术的狂飙突进与团队的人员变动形成了鲜明对比。Thinking Machines初创时的“梦之队”阵容如今已分崩离析,六位联合创始人中已有四位离开,其中三人回流至OpenAI。这种人才流向似乎暗示着,尽管独立AI初创公司在技术创新上极具活力,但OpenAI凭借其庞大的资源池和前沿的研究方向,依然保持着强大的人才吸引力。翁荔的回归尤其引人注目,她所负责的递归自我提升项目被视为通向人工超级智能(ASI)的关键路径之一。在这种背景下,Thinking Machines选择在此时开源Inkling-Small,或许也是一种战略性的防御与进攻:通过开放生态来巩固其技术影响力,抵消人才流失带来的负面舆论。
对于广大开发者和企业而言,Inkling-Small的出现具有重大的实用意义。长期以来,高端AI能力被少数科技巨头垄断,主要原因在于高昂的训练和推理成本。Inkling-Sold通过将激活参数控制在120亿,使得中等规模的团队甚至个人开发者都有机会参与到顶级模型的定制与优化中。实测数据显示,在相同的硬件环境下,使用SGLang框架运行Inkling-Small,其推理效率远超同级别的其他开源模型。这意味着,企业可以以更低的成本构建专属的智能体应用,无论是在代码生成、数据分析还是多模态交互场景中,都能获得接近顶尖水平的服务体验。
此外,该模型对长上下文的支持也达到了100万token,这在处理长篇文档、复杂代码库或多轮对话历史时至关重要。原生多模态的设计使其能够无缝处理文本、图像、音频等多种输入形式,无需额外的适配器或复杂的预处理流程。这种一体化的设计思路,简化了应用开发的复杂度,让开发者能够更专注于业务逻辑的实现,而非底层模型的整合。随着AI应用逐渐从实验阶段走向生产环境,这种易用性和稳定性将成为决定模型普及程度的关键因素。
从行业宏观视角来看,Inkling-Small的发布可能预示着开源模型进入了一个新的阶段。早期的开源模型往往是对闭源模型的模仿或滞后跟随,而现在的开源模型开始在架构创新和训练效率上引领潮流。Thinking Machines通过展示如何用更少的资源实现更高的性能,为整个行业树立了新的标杆。这将迫使其他模型提供商重新审视其技术路线,是否需要在追求参数规模的同时,更加注重模型的稀疏化和高效化。未来,我们可能会看到更多类似的小参数、高激活效率的模型涌现,从而推动AI技术向更广泛的下沉市场渗透。
当然,挑战依然存在。尽管Inkling-Small在基准测试中表现优异,但在真实世界的复杂场景中,其鲁棒性和安全性仍需经过大规模应用的检验。此外,随着模型能力的增强,如何确保其不被滥用,以及如何解决版权和数据隐私问题,也是开源社区必须面对的挑战。Thinking Machines选择完全公开权重和训练细节,体现了其对透明度和社区协作的承诺,但这同时也要求使用者具备更高的技术素养和责任意识。
综上所述,Inkling-Small不仅仅是一个新的开源模型,它是AI技术发展路径的一个缩影。它展示了在算力约束下,通过算法优化和工程创新所能达到的极致性能。在人才流动加剧、行业格局瞬息万变的今天,Thinking Machines用这款产品证明了其技术底蕴和创新能力。对于开发者来说,这是一个值得深入研究和尝试的工具;对于行业观察者来说,这是一个观察AI效率革命的重要窗口。随着更多像Inkling-Small这样的高效模型出现,人工智能的民主化进程将进一步加速,真正的智能应用爆发期或许已近在咫尺。