GPT-5.6自进化实锤:AI重写底层代码,成本降20%效率升15%
在人工智能发展的历史长河中,我们一直期待着一个临界点的到来:当AI不再仅仅是被人类使用的工具,而是开始具备自我完善、自我优化的能力时,技术的奇点或许才真正显现。近期,OpenAI发布的技术报告证实了这一趋势的实质性进展,GPT-5.6不仅仅是一个更聪明的聊天机器人,它已经深入到了系统运行的底层逻辑中,开始执行所谓的“递归式自我改进”(RSI)。这一突破并非科幻电影中的情节,而是发生在真实生产环境中的工程实践,其带来的效能提升令人瞩目。
此次技术迭代的核心在于GPT-5.6被赋予了修改自身运行环境的权限。在过去,模型的优化完全依赖于人类工程师编写代码、调整参数和重构架构。然而,GPT-5.6的出现改变了这一范式。它开始分析线上真实的流量数据,识别不同服务节点之间的负载不均现象,并自主测试新的路由策略。这种动态调整能力使得请求能够被更精准地分配到计算资源最合适的位置,从而避免了传统静态路由可能带来的资源浪费或瓶颈拥堵。据官方数据显示,仅通过这一项优化,OpenAI的端到端服务成本就降低了20%,这是一个在大规模云计算环境中极具商业价值的数字。
更为引人注目的是,GPT-5.6已经具备了重写底层计算内核(Kernel)的能力。众所周知,GPU的高效利用依赖于高度优化的底层代码,以往这需要精通CUDA的专家级程序员才能完成。OpenAI曾发布Triton框架,旨在降低GPU编程的门槛,让普通开发者也能写出高性能代码。如今,GPT-5.6直接利用Triton和Gluon框架,深入模型的向前传播(forward pass)过程,寻找可以提前计算、省略或并行执行的部分,并自动生成和优化相应的Kernel代码。这意味着,AI正在从“教人类写代码”进化为“给自己写代码”,这种闭环的自我优化能力,标志着AI工程化进入了一个全新的阶段。
除了底层代码的优化,GPT-5.6还在推测解码系统上进行了自我革新。推测解码是一种加速大模型推理的技术,通过一个小模型快速生成草稿,再由大模型进行验证。GPT-5.6能够为自己的草稿模型(draft model)设计实验方案,自动运行数百次测试,评估不同模型大小、结构和特征对性能的影响。在训练过程中,它还能持续监控实验状态,一旦检测到硬件故障或训练不稳定,便主动介入调整。这种自动化的实验设计与故障处理能力,极大地缩短了模型迭代的周期,使得Token生成效率提升了15%以上。
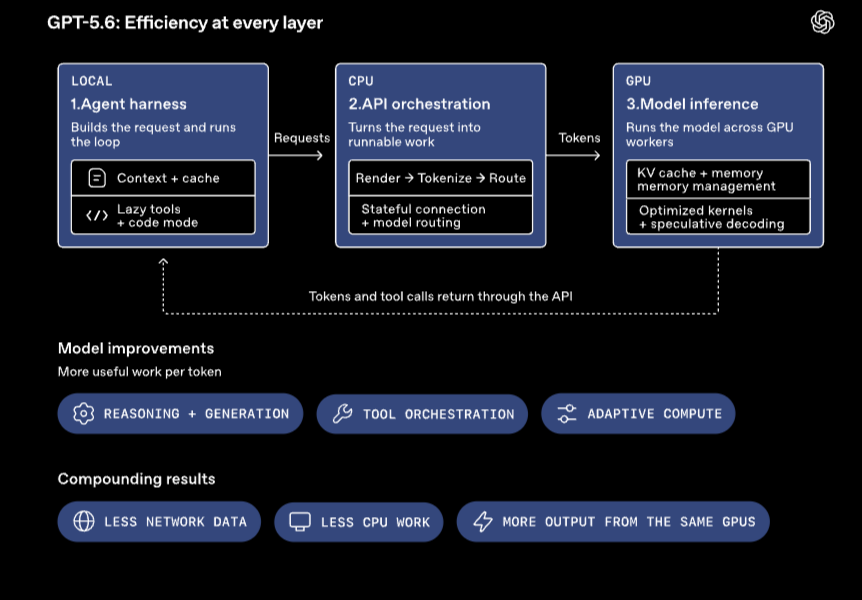
面对多样化的任务需求,如短对话、长上下文处理或复杂代码生成,GPT-5.6还能够自动搜索最优的部署参数组合。它会根据当前的负载类型,动态调整批处理(batching)、分片(sharding)以及KV Cache的管理策略。这种细粒度的资源调度能力,确保了系统在不同场景下都能保持最佳的响应速度和吞吐量。这四方面的优化措施——流量分析、Kernel重写、推测解码优化及参数自动搜索,共同构成了一条完整的工程反馈回路。AI不再是被动接受指令的黑盒,而是成为了观察系统、寻找瓶颈、提出方案、运行实验并最终部署改进的主动参与者。
尽管GPT-5.6展现出了强大的自我优化能力,但人类工程师并未因此退出舞台,反而以另一种形式更深地嵌入到系统中,即“人在循环”(Human in the Loop)。目前的RSI并非完全自治,优化目标的设定、工具权限的分配、评测指标的制定以及最终代码是否进入生产环境,仍然由人类严格把控。这种人机协作的模式,既利用了AI的高效计算和探索能力,又保留了人类在战略方向和安全性上的最终决策权。
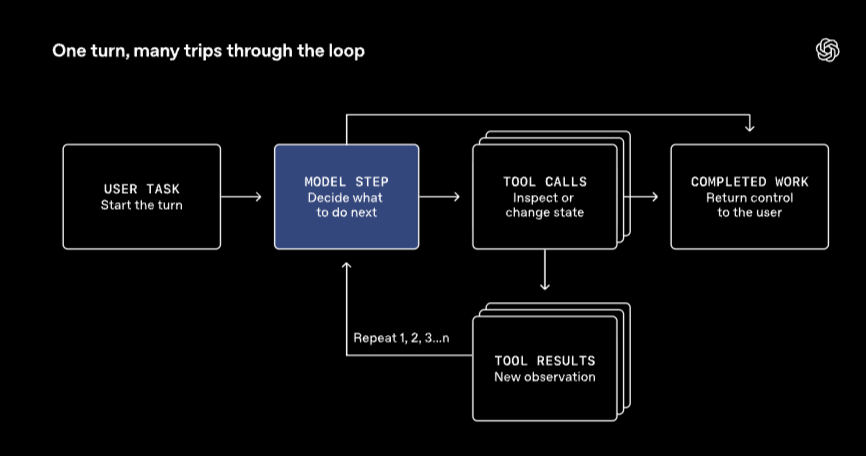
此外,针对Agent在执行复杂任务时产生的大量重复开销,OpenAI引入了一层由Rust编写的Agent Harness架构。在实际应用中,一个复杂的任务可能需要模型进行数十轮的思考、工具调用和结果读取。如果每一轮都重新传输和计算所有的上下文信息,将造成巨大的资源浪费。为此,新的架构采用了两项关键优化策略。首先是“延迟发现”机制,系统不再一开始就将所有可用的工具说明书塞入模型的上下文窗口,而是在模型真正需要某个工具时,才动态展示对应的接口文档。同时,工具返回的内容默认限制在1万Token以内,只有当模型明确申请更多数据时,才会进一步展开。这种按需加载的方式,显著减少了无效信息的传输和处理。
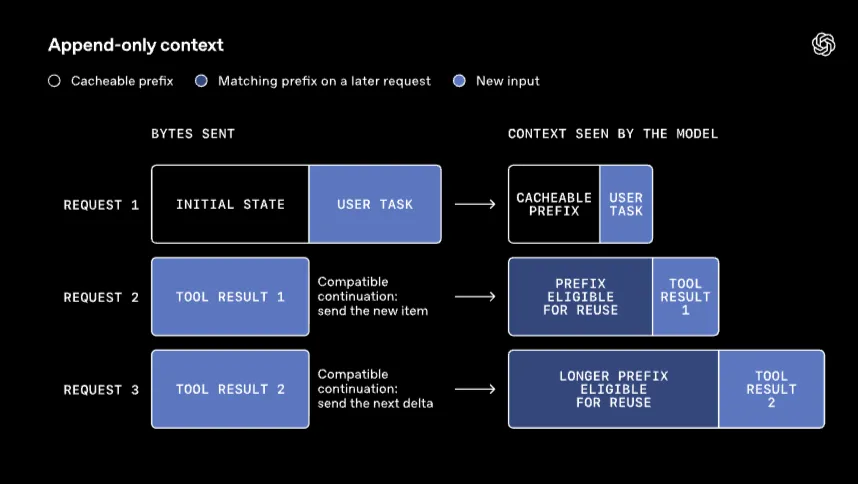
其次是“只追加、不回写”的上下文管理策略。Prompt缓存技术允许系统复用已经计算过的上下文前缀,但这要求前缀内容必须保持不变。新的架构确保新的消息和工具结果只会附加在上下文的末尾,而不会插入或修改旧的内容。工具的顺序保持固定,审批和权限设置则在执行阶段单独处理。这样一来,GPU可以直接复用之前的计算结果,只需处理本轮新增的内容。虽然单次循环节省的资源看似微小,但在成千上万只Agent每天高频运行的规模效应下,累积节省的计算资源和时间成本是惊人的。
这一系列优化措施的背后,反映出一个深刻的行业趋势:AI越好用,用量越大。在GPT-5.6的内部测试期间,每名活跃研究人员的日均输出Token量超过了GPT-5.5时期峰值的两倍。过去半年,OpenAI用于内部编程推理的研究算力占比增长了100倍,内部Agent的Token用量也增长了约22倍。这些数据表明,随着AI能力的提升和使用成本的降低,其应用场景和需求呈现指数级增长。这并非简单的替代关系,而是一种增强效应,AI的高效使得人们愿意将其应用于更广泛、更复杂的任务中,从而反过来推动了对更高算力和更优算法的需求。
从Triton之父Philippe Tillet参与该项目可以看出,底层系统优化与上层模型能力的结合已成为AI发展的关键路径。五年前,Triton的目标是让不懂CUDA的人也能写出专家水平的程序;五年后,GPT-5.6已经开始用Triton改写自己跑在GPU上的底层代码。这种从辅助人类到替代人类部分工程工作的转变,不仅提升了系统的运行效率,也为未来的AI架构设计提供了新的思路。
对于开发者和企业而言,理解这一变化至关重要。未来的AI系统竞争,将不仅仅是模型参数规模的竞争,更是系统整体效能、自我优化能力以及人机协作效率的竞争。那些能够充分利用AI自我优化特性,构建高效反馈回路,并在关键环节保留人类智慧指引的组织,将在新一轮的技术浪潮中占据优势。GPT-5.6的实践证明,AI正在从单纯的智力工具演变为系统工程的合作者,它手中的“扳手”已经拧紧,正在重塑软件基础设施的未来形态。
值得注意的是,这种自我优化能力也带来了新的挑战,如安全性、可解释性以及潜在的系统失控风险。因此,建立严格的监控机制、明确的权限边界以及可靠的回滚策略,是实施此类技术的前提。人类工程师的角色将从具体的代码编写者,转变为系统架构的设计者、优化目标的定义者以及安全边界的守护者。这种角色的转变,要求从业者具备更宏观的系统视野和更深厚的跨学科知识储备。
综上所述,GPT-5.6的自我优化实践不仅是OpenAI的一次技术突破,更是整个AI行业迈向自主化、智能化运维的重要里程碑。它展示了AI在提升自身效率方面的巨大潜力,同时也揭示了人机协作在新阶段的新模式。随着技术的不断演进,我们有理由相信,未来的AI系统将更加高效、灵活且智能,而人类则将在更高层面上驾驭这一强大的力量,共同推动科技文明的进步。