GPT-5.6自进化揭秘:成本降20%背后的全栈工程化革命
在大模型技术迭代进入深水区的当下,单纯追求参数规模的扩张已不再是唯一的竞争焦点。随着全球算力需求的指数级增长,如何在有限的硬件资源下实现更高效、更廉价的推理服务,成为衡量一家AI公司核心竞争力的关键指标。OpenAI近期释放的一系列信号表明,其战略重心正从模型能力的单点突破,转向涵盖底层内核、中间件调度至上层应用的全栈工程化优化。这一转变不仅体现在GPT-5.6系列模型在性能与成本上的显著改善,更体现在其利用自身模型能力进行“自我进化”的技术路径上。
GPT-5.6 Sol作为该系列的旗舰版本,其最引人注目的成就在于实现了推理服务部署成本大幅降低20%,同时让Token生成效率提升了超过15%。这一数据的背后,并非简单的硬件升级,而是一场针对软件栈的深度重构。传统的大模型优化往往局限于算法层面的剪枝或量化,而OpenAI此次采取的是更为激进的全链路优化策略。首先,在流量路由与任务调度层面,系统能够根据全球用户的地理位置、剩余算力容量以及芯片类型,动态分配请求。这种细粒度的负载均衡机制,确保了在高并发场景下,计算资源能够被精准地输送到最需要的地方,避免了局部过载或资源闲置。
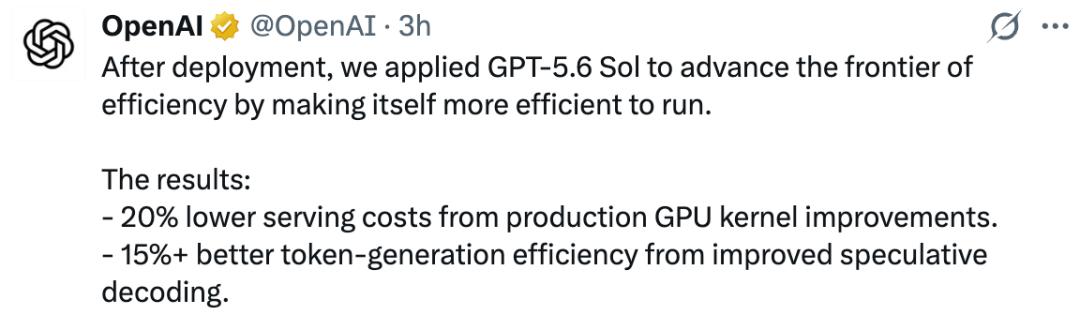
更为核心的是,GPT-5.6 Sol具备了自主优化底层代码的能力。借助Codex的代码生成优势,该模型能够分析线上真实的业务流量特征,识别出那些长期被忽视的算力失衡点。研究人员训练GPT-5.6掌握Triton和Gluon这两种开源GPU编程语言,使其能够直接编写和优化运行在显卡上的核心计算程序。这意味着,模型不再仅仅是被动的执行者,而是成为了系统性能的主动调优者。通过自主重新编写负责数学运算的核心代码,GPT-5.6 Sol显著提升了前向传播的计算效率,从而在硬件配置不变的前提下,挖掘出了巨大的性能潜力。
在推理加速技术方面,推测解码机制的迭代是另一大亮点。该技术通过部署一个轻量级的草稿模型先行预生成一串Token,再由主模型进行并行校验。如果预生成内容通过校验,系统只需执行一次主模型的前向计算即可输出多个Token,从而极大地削减了串行计算的开销。GPT-5.6 Sol在此过程中扮演了架构师的角色,它自主启动了数百组架构对比实验,针对预测模型的规模、网络结构等功能模块进行迭代,并在全流程训练中自动介入处置硬件故障或训练震荡等异常问题。这种自动化的超参优化能力,使得整体Token生成效率得以实质性提升。
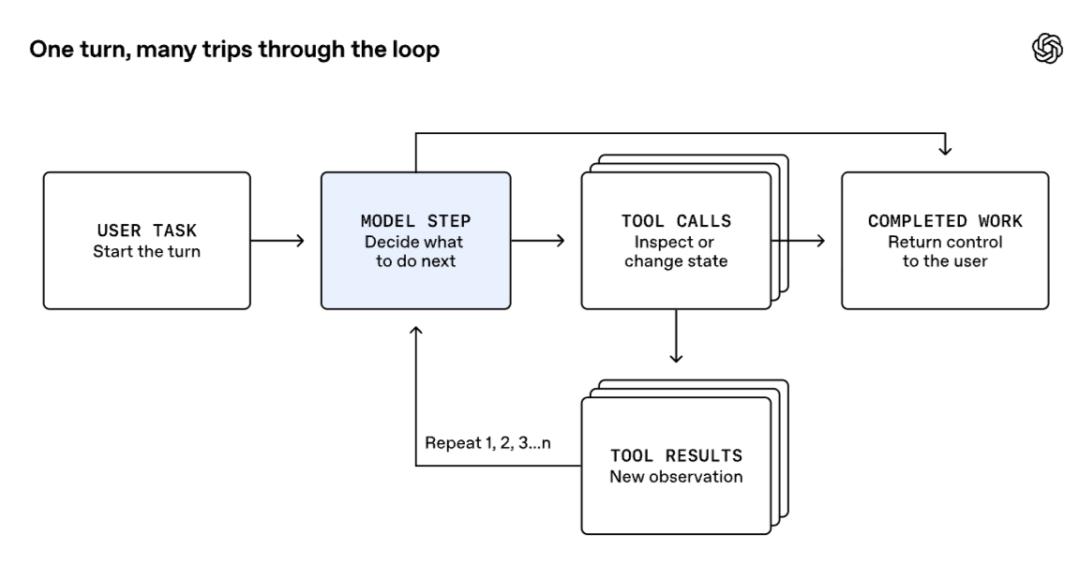
除了底层算力的优化,智能体调度基座的改进同样至关重要。在实际应用中,如ChatGPT Work和Codex等复杂任务往往涉及连续的模型调用及工具调用链路。每一次查看源代码、检索部署记录或运行测试,都需要发起独立的模型请求,这导致了大量的上下文拼装、数据传输及进程拉起耗时。若一项任务需要数十次调用,累积的时延与算力消耗将十分惊人。为此,OpenAI提出了三大手段来简化重复性工作流程:管控上下文膨胀、优化工具加载机制以及复用已有计算成果。
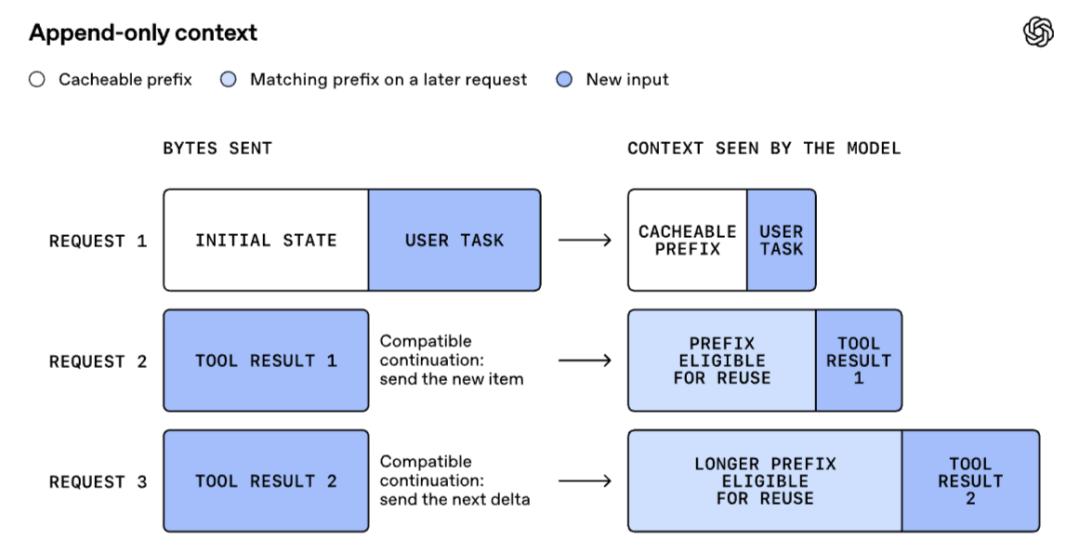
针对上下文膨胀问题,新的智能体调度框架引入了延迟加载检索机制。各类集成组件、自定义工具及插件仅在被实际调用时才会载入上下文,避免了无关信息占用宝贵的窗口空间。同时,系统默认将工具返回的输出内容限制在特定Token数量以内,防止单一工具无节制地挤占资源。在提示词缓存方面,框架采用了仅追加写入模式,确保新增消息不会破坏前文已计算完成的提示词前缀缓存。这种设计使得系统在多次交互中能够稳定复用已有的计算结果,大幅降低了重复推理的算力浪费。
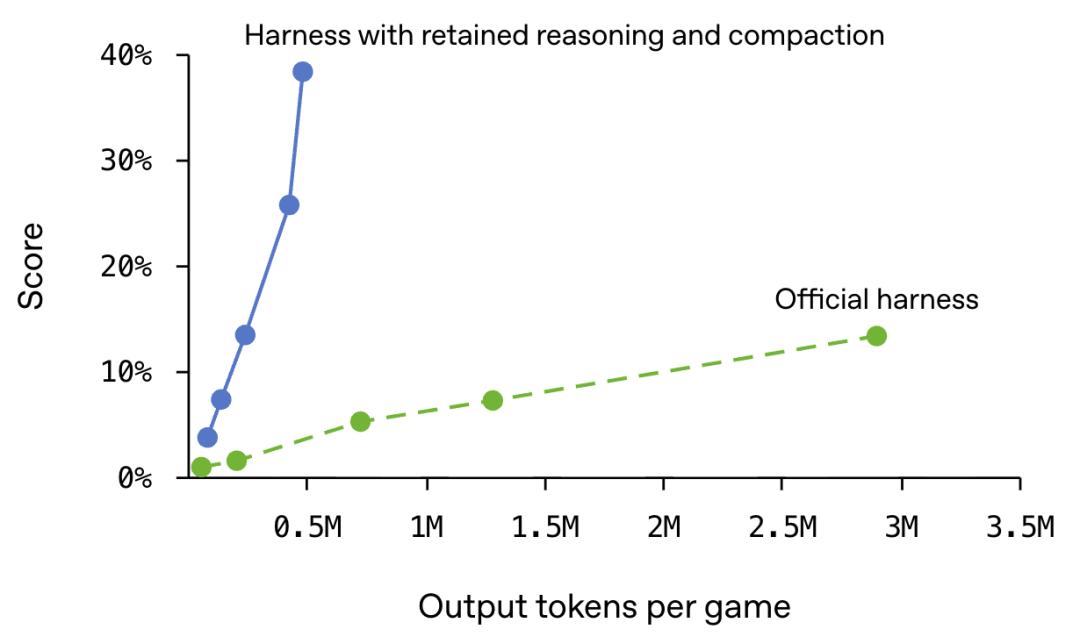
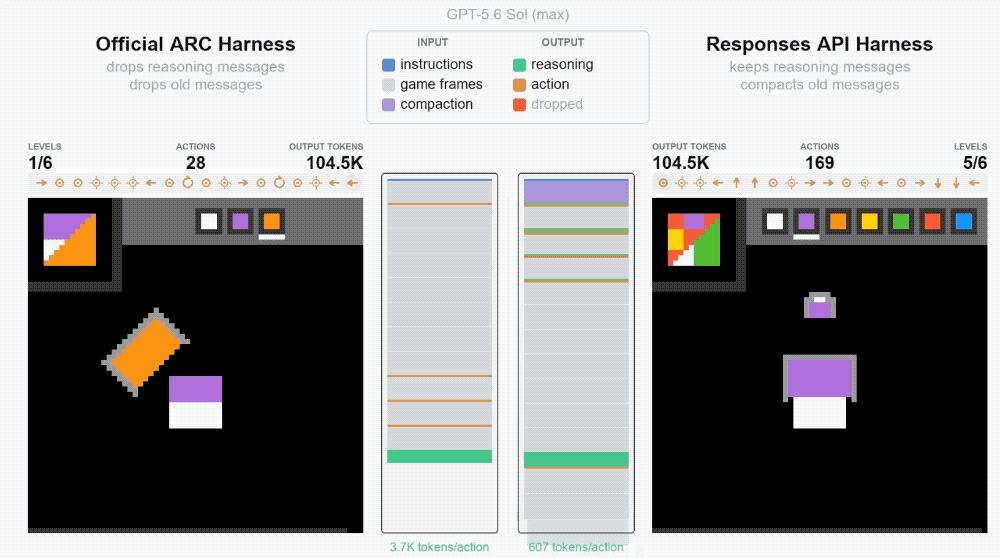
然而,优化的过程并非一帆风顺,ARC-AGI-3基准测试中的表现揭示了配置策略对模型性能的巨大影响。在该测试中,GPT-5.6 Sol初始正确率仅为7.8%,远低于预期。深入分析发现,这并非模型本身智力不足,而是由于通用的智能体调度框架清空了每一步操作后的私有推理思考过程,导致模型无法留存上一轮的推演思路。此外,滚动截断窗口机制使得早期的操作记录随交互累积而被剔除,进一步削弱了模型的长期记忆能力。
针对这一问题,OpenAI通过重构调度框架,启用了推理记忆留存与上下文压缩功能。新的Responses API允许模型在多轮工具调用间完整保留全部推理过程,并通过摘要压缩而非直接截断来处理超长上下文。这一改动使得GPT-5.6 Sol能够在更长的解谜流程中留存习得经验,最终将评测分数提升至38.3%,输出Token消耗量缩减为原来的六分之一。这一案例深刻说明,在大模型应用落地过程中,API配置与调度策略的重要性不亚于模型本身的训练质量。
与此同时,人才布局也是OpenAI强化技术壁垒的重要一环。据悉,前美国AI独角兽Thinking Machines Lab联合创始人翁荔有望重新加入OpenAI,协助开展AI自进化研究。翁荔在大型语言模型代理系统及自动化研究方面拥有深厚积累,她的回归预示着OpenAI将在智能体自主性与自我迭代能力上投入更多资源。结合OpenAI总裁格雷格·布罗克曼关于正在打造AI硬件的剧透,可以看出OpenAI正试图构建从芯片、底层软件到上层应用及硬件终端的完整生态闭环。
随着用户规模突破10亿人,服务企业数量达到200万家,OpenAI面临的挑战已从技术可行性转向规模化落地的经济性。GPT-5.6系列中不同定位模型的推出,如高性能的Sol、均衡型的Terra以及高性价比的Luna,正是为了满足不同层级用户的需求。这种分层策略配合全栈工程化的优化手段,使得OpenAI能够在保持智能性的同时,大幅降低调用成本,从而进一步拓宽大模型的应用边界。
当前的大模型竞争,已经迈入全栈工程化比拼的新阶段。未来的胜出者,不仅需要具备强大的算法研发能力,更需要拥有深厚的系统工程底蕴,能够在算力调度、内存管理、网络传输等各个环节实现极致的效率优化。OpenAI通过GPT-5.6展示的自我优化能力,为行业树立了一个新的标杆:即利用AI技术来优化AI基础设施本身。这种正向循环一旦形成,将极大加速技术迭代的周期,推动人工智能从实验室走向更广泛的产业深处,真正成为一种普惠且高效的基础设施。