Kimi K3开源登顶:2.8T参数背后的架构革命与开源生态破局
开源界的“活菩萨”:Kimi K3的技术突破与生态意义
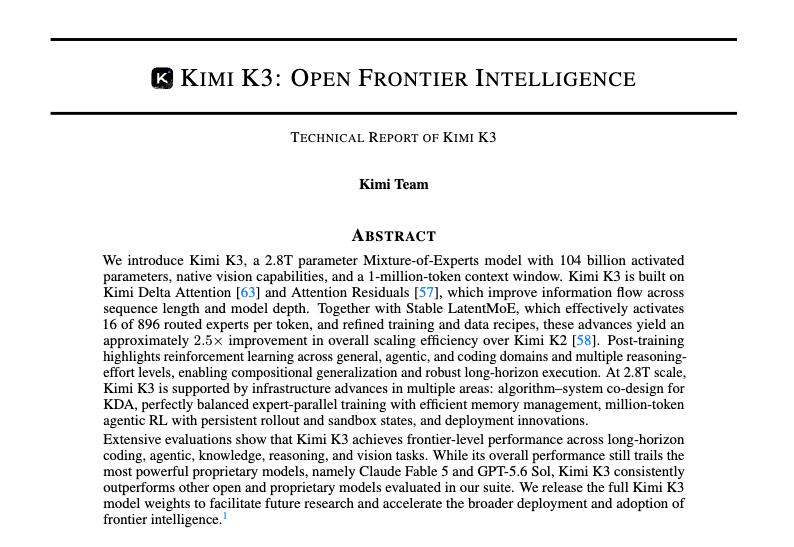
Kimi K3的正式开源,不仅是一次技术产品的发布,更是开源人工智能发展史上的一个里程碑事件。在Hugging Face平台上,该模型在发布半小时内便获得了超过4000个赞,这一热度反映了全球开发者对高质量开源模型的迫切需求。与以往不同,Kimi K3不仅提供了模型权重,还完整公开了技术报告及训练工具链,这种“焚诀”式的透明化策略,使其迅速成为业界关注的焦点。
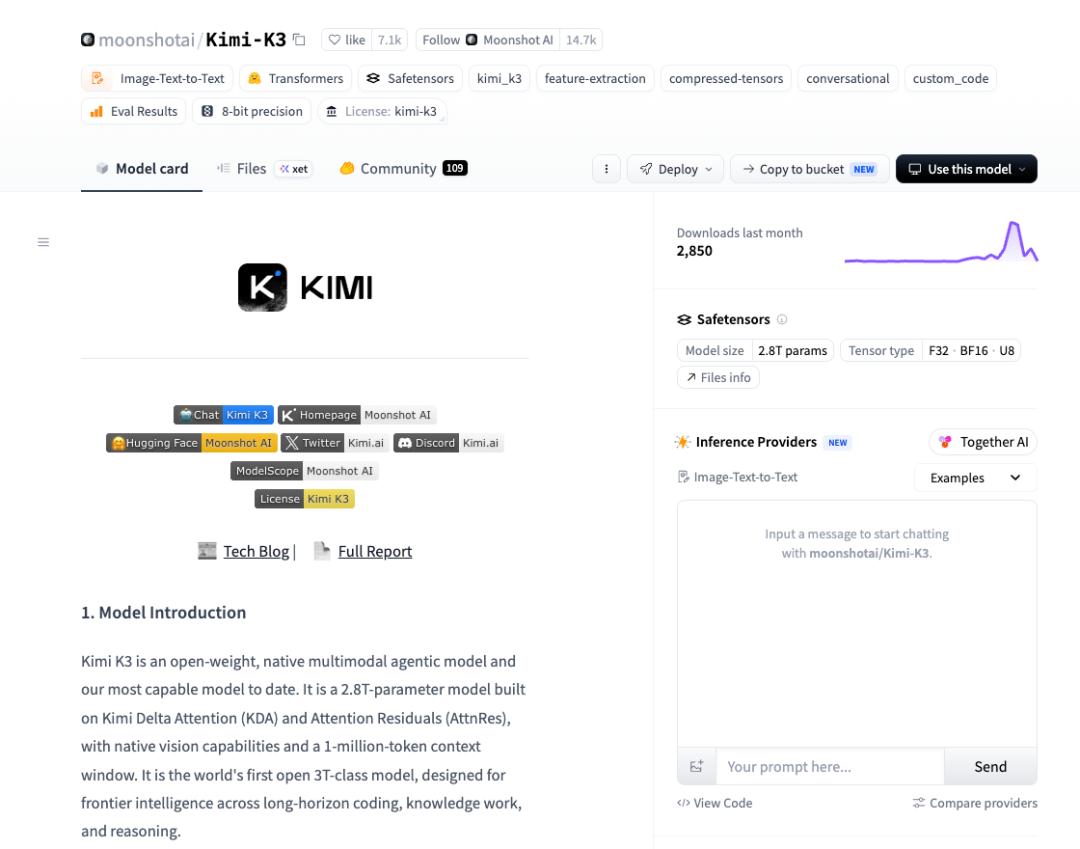
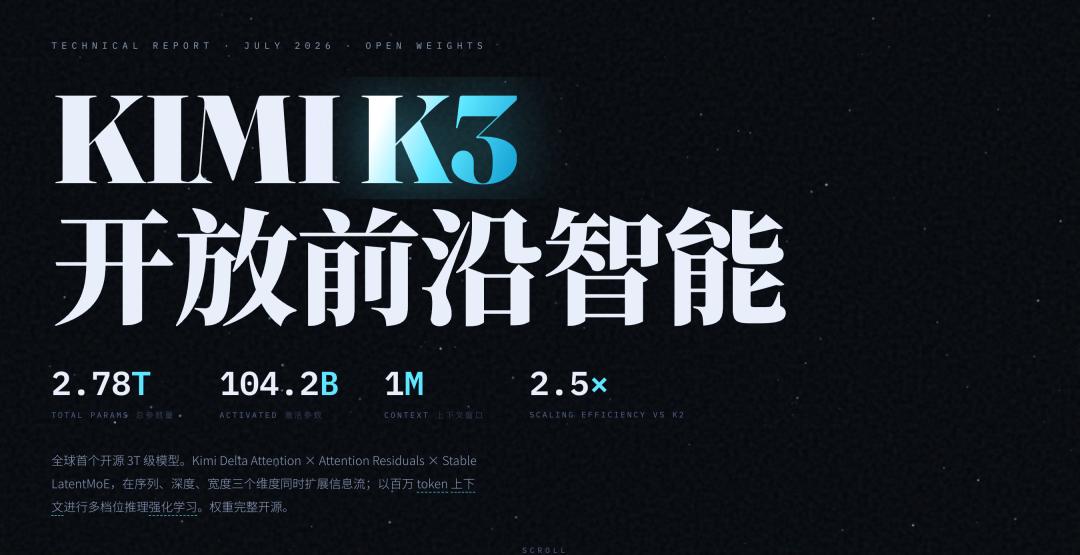
从性能指标来看,Kimi K3在多项基准测试中表现优异,综合排名位列世界第三,仅次于Fable 5和GPT-5.6 Sol。更为关键的是,它是目前TOP 3模型中唯一支持本地部署和微调的版本。这意味着用户不再依赖云端API,可以在本地硬件上运行这一顶级模型,极大地降低了使用门槛并提升了数据隐私安全性。其总参数量高达2.8T,激活参数达到1042亿,这一数据规模不仅超越了上一代模型三倍,更是DeepSeek V4 Pro的两倍,展现了其在处理复杂任务时的强大潜力。
架构创新:如何驾驭2.8T参数的算力挑战
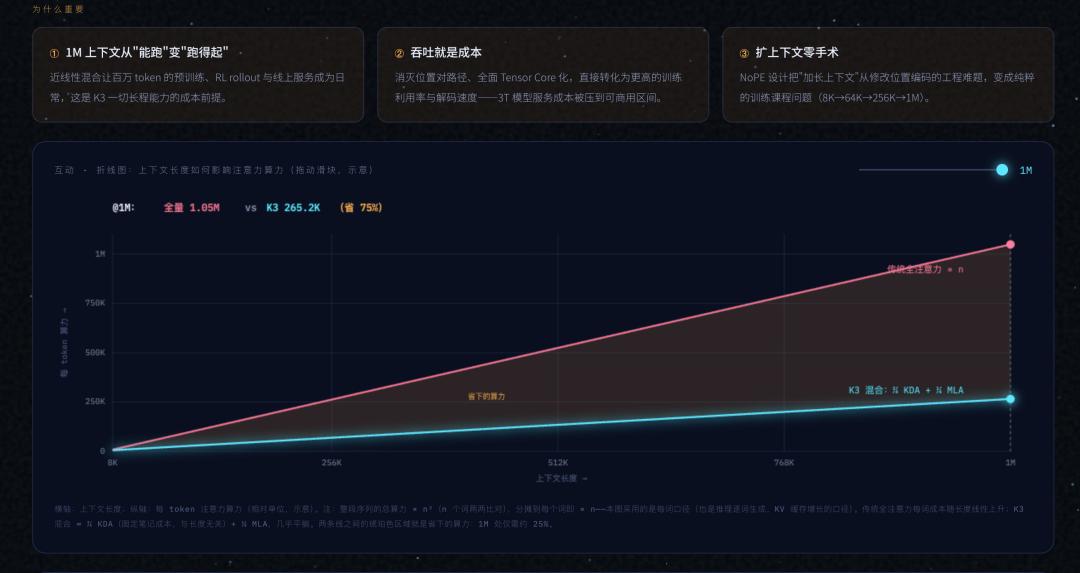
面对如此庞大的参数规模,Kimi K3在架构设计上进行了多项突破性创新,核心在于如何在保证性能的同时,有效控制计算成本并提升训练效率。传统的注意力机制在处理长文本时,计算复杂度随序列长度呈平方级增长,这成为了制约大模型发展的瓶颈。Kimi K3通过引入混合注意力机制,巧妙地解决了这一难题。
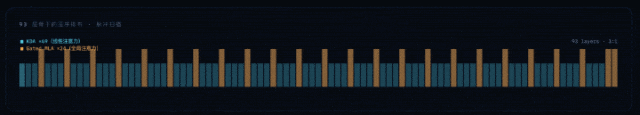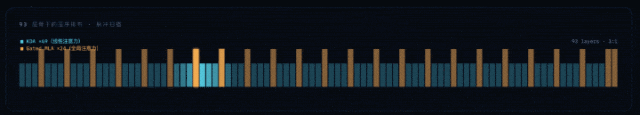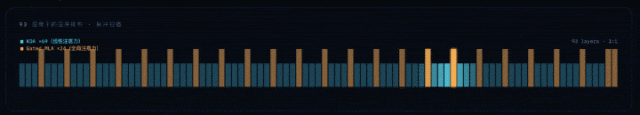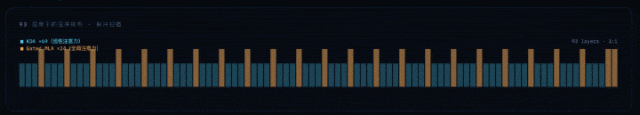
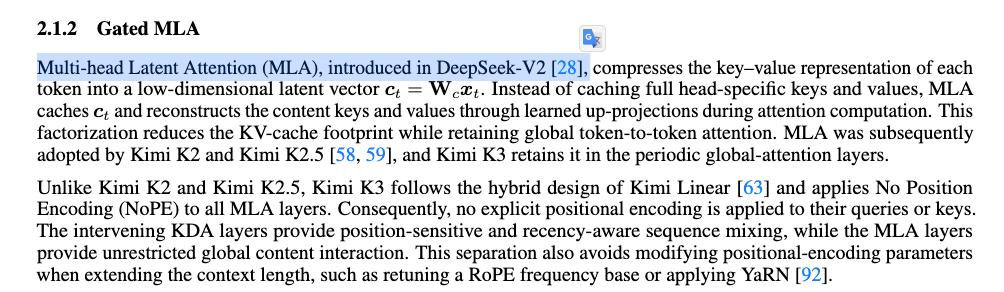
具体而言,Kimi K3采用了KDA(Kimi Delta Attention)机制。该机制在读取文本时,会将关键信息写入一个持续更新的状态向量中,而非简单地与所有历史Token进行计算。这种设计使得模型能够动态判断哪些旧信息需要保留,哪些可以逐步遗忘,从而大幅降低了长上下文处理的算力开销。为了防止关键信息在状态压缩过程中丢失,Kimi在三层KDA之后引入了Gated MLA(门控多头注意力)机制。这一设计相当于让模型在完成初步笔记整理后,再回头查阅原文进行校验,确保了信息提取的准确性。
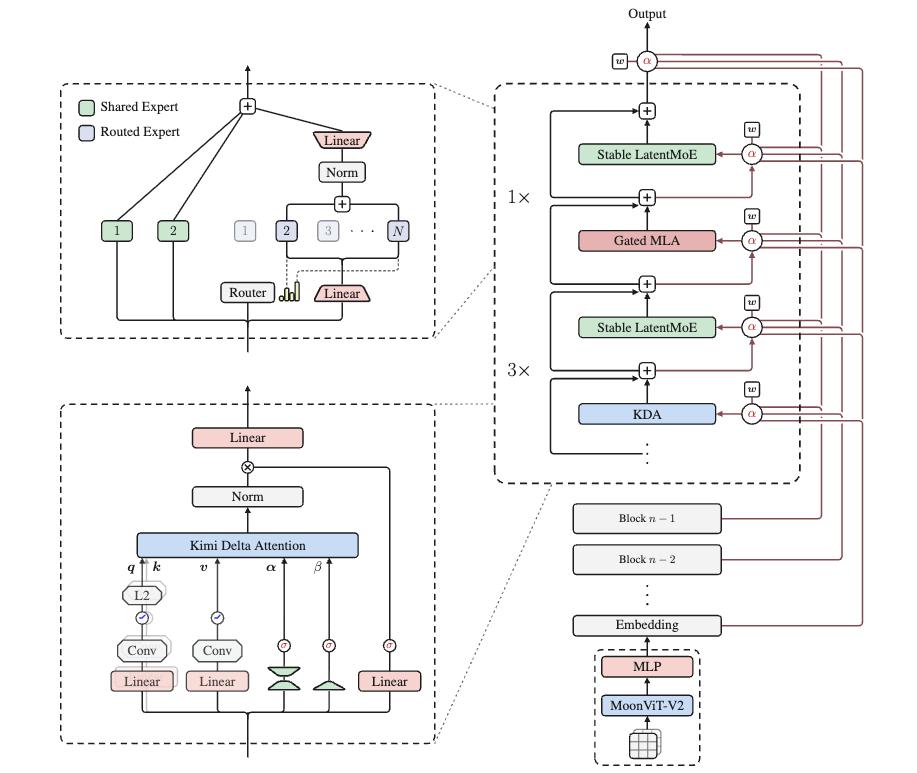
此外,Kimi K3还设计了Attention Residuals(注意力残差连接),进一步减少了信息在深层网络传递过程中的损耗。在专家模型方面,Kimi引入了Stable LatentMoE结构。该结构将原本7168维的信息压缩至3584维,随后分配给16个专家网络并行处理。更为精妙的是,系统为这些专家设置了限流和排班机制,有效避免了部分专家过载而其他专家闲置的不均衡现象,实现了任务分配的优化。
效率跃升:从K2到K3的训练范式转变
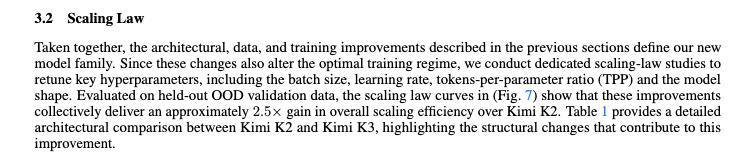
尽管参数量大幅增加,但Kimi K3的训练效率却比上一代K2提升了2.5倍。这一成就得益于架构创新与数据训练方法的共同升级。在数据层面,Kimi K3利用了开源社区多年来积累的技术成果,包括多头注意力机制、混合专家模型等成熟技术,并在此基础上进行了针对性优化。
这种“站在巨人肩膀上”的开发模式,是开源社区的核心优势。与闭源模型不同,开源模型之间存在着高度的技术共享与迭代关系。Kimi K3的技术报告中清晰地展示了其对DeepSeek等开源模型技术的借鉴与改进。例如,在训练稳定性和推理效率方面,Kimi K3吸收了开源社区过去几年的最佳实践,并通过KDA、Gated MLA等自研技术实现了性能突破。
这种技术传承与创新的良性循环,使得开源模型能够以更快的速度逼近甚至超越闭源模型。每一代开源模型留下的经验,都直接成为下一代模型的起点。这种层层递进的技术积累,使得开源模型在算力、资金和数据处于劣势的情况下,依然能够通过算法优化实现弯道超车。
地缘政治与技术平权:开源模型的全球博弈
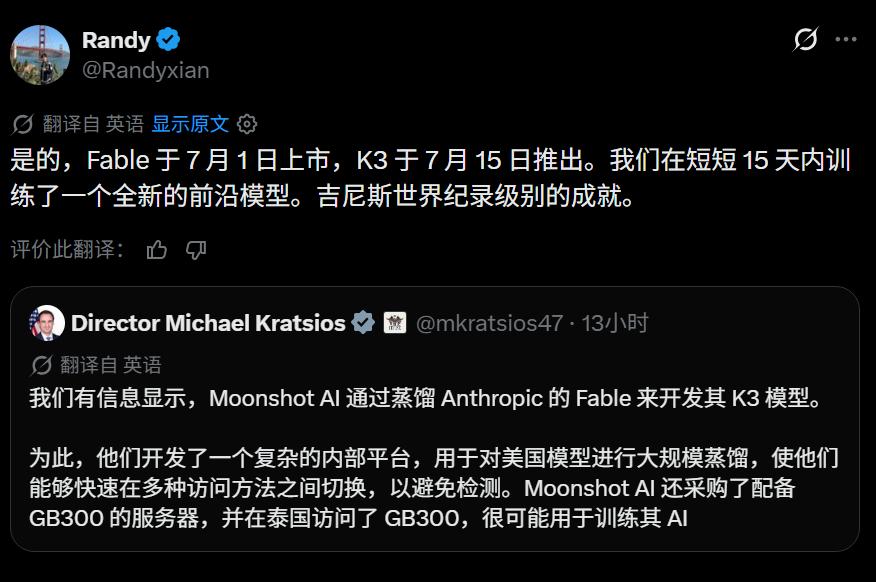
Kimi K3的发布不仅仅是一个技术事件,更引发了全球范围内的地缘政治讨论。美国部分政客指控Kimi K3是通过蒸馏美国大模型获得的,这种说法缺乏事实依据。Kimi团队对此进行了有力反驳,指出在短短几十天内蒸馏出超越现有顶级模型的技术是不现实的,这更像是某种政治偏见下的无端指责。
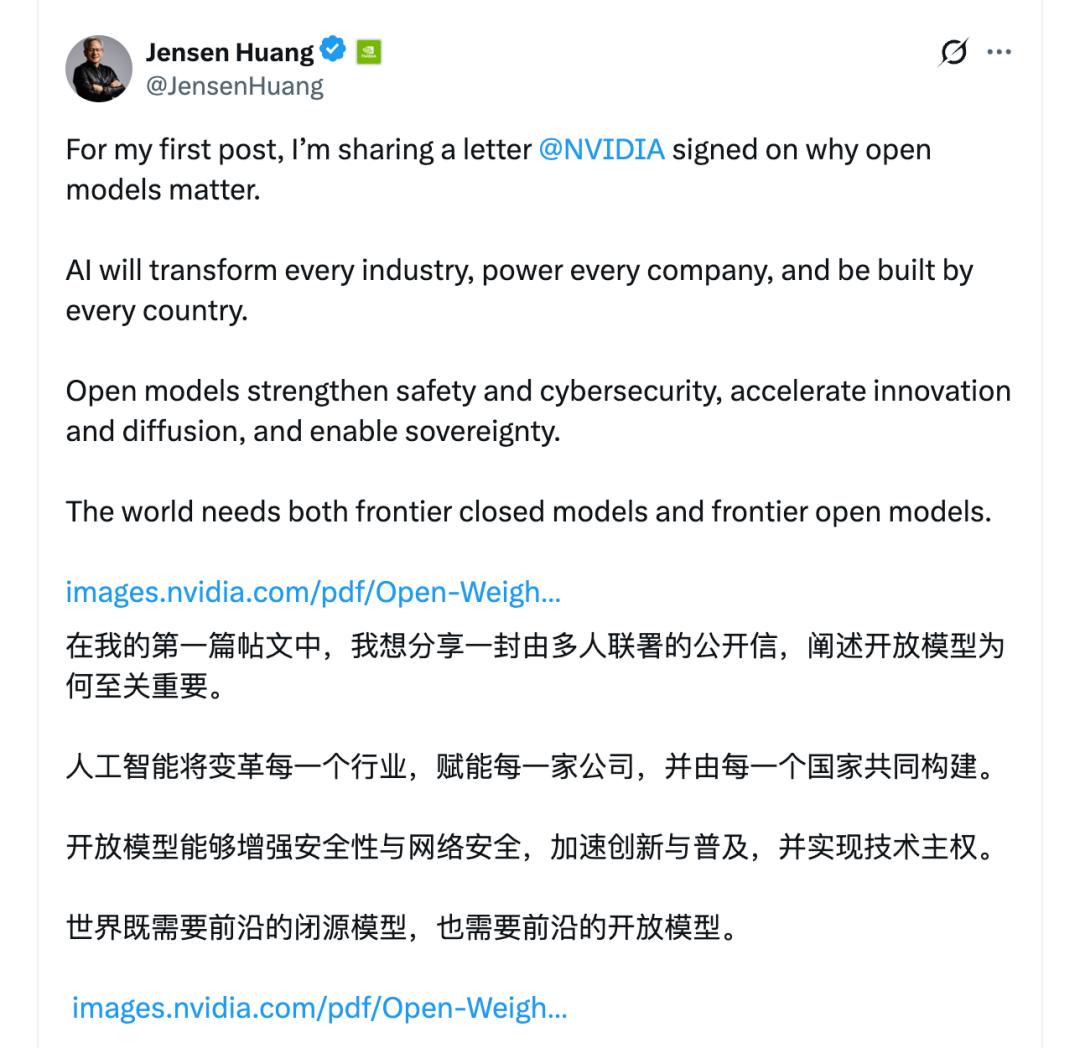
与此同时,美国政府计划对中国人工智能企业实施制裁调查,而中国商务部也做出了相应回应。在这一背景下,开源模型的价值被重新定义。英伟达CEO黄仁勋等科技巨头公开反对封禁中国开源模型,强调开源对于全球AI创新的重要性。相比之下,Anthropic等闭源巨头则继续强调模型安全,主张限制强大模型的扩散。
这种分歧反映了AI发展路径的根本差异。闭源模型倾向于通过技术垄断维持竞争优势,而开源模型则通过技术共享推动整体进步。Kimi K3的成功证明,开源模式不仅能够实现技术突破,还能在复杂的国际环境中保持竞争力。它打破了“开源模型必然落后”的刻板印象,展示了开源生态在技术创新中的巨大潜力。
未来展望:开源生态的持续进化
Kimi K3的开源,标志着大模型竞争进入了一个新的阶段。在这个阶段,技术平权、国家安全与地缘政治因素交织在一起,使得AI发展不再仅仅是公司之间的商业竞争,而是涉及全球治理的复杂议题。
开源社区通过持续的技术共享与迭代,正在逐步缩小与闭源巨头的差距。Kimi K3的成功经验表明,通过架构创新、效率优化和社区协作,开源模型完全有能力达到世界领先水平。这不仅为开发者提供了更多选择,也为全球AI治理提供了新的思路。
未来,随着更多像Kimi K3这样的优秀模型涌现,开源生态将更加繁荣。技术实力的展示,比任何言语都更有说服力。在AI发展的道路上,开源模式将继续发挥其独特优势,推动技术平权,促进全球创新。对于开发者而言,本地部署顶级模型的能力,意味着更大的自主权和更低的成本,这将进一步激发创新活力,加速AI技术在各行各业的落地应用。
Kimi K3的发布,不仅是对现有技术的突破,更是对开源精神的致敬。它证明了在开放协作的环境中,技术可以更快地进步,创新可以更多地涌现。随着开源生态的不断完善,我们有理由相信,AI将为人类社会带来更多福祉,而不仅仅是少数公司的商业利益。