Java后端重构:构建企业级AI网关,破解大模型调用治理难题
在企业数字化转型的深水区,生成式人工智能(Generative AI)已从概念验证阶段全面进入生产环境。对于坚守Java技术栈的后端团队而言,如何优雅、安全且高效地集成大语言模型(LLM),成为了架构演进中的核心命题。许多开发团队在初期往往采取一种“快速上手”的策略:直接在Controller或Service层中硬编码HTTP客户端,向模型供应商发起请求。这种模式虽然在原型阶段展现了极高的灵活性,但随着业务规模的扩大,其弊端迅速暴露:模型切换带来的代码侵入、难以追溯的审计日志、失控的Token成本以及模糊的安全边界。因此,将大模型调用视为一种特殊的、高价值且不稳定的外部依赖,并通过构建统一的AI Gateway将其纳入企业服务边界,是构建健壮企业级AI应用的必经之路。
传统的微服务架构中,我们习惯于通过API Gateway处理流量入口,通过Service Mesh处理服务间通信。然而,大模型交互具有其独特性:它不仅是简单的请求-响应模式,更涉及复杂的上下文管理、Prompt组装、流式输出处理以及高昂的计算资源消耗。如果缺乏统一的治理层,每个业务线各自为战,必然导致重复造轮子和技术债务的指数级增长。AI Gateway的核心价值在于“解耦”与“收敛”。它作为业务系统与模型供应商之间的中间件,屏蔽了底层模型的差异性与不稳定性,向上提供标准化的AI能力接口,向下负责复杂的路由、鉴权、限流与监控。这种架构设计使得业务开发人员可以专注于领域逻辑,而无需关心底层是调用了GPT-4、Claude还是开源的Llama系列,从而实现了技术选型的灵活性与业务迭代的敏捷性。
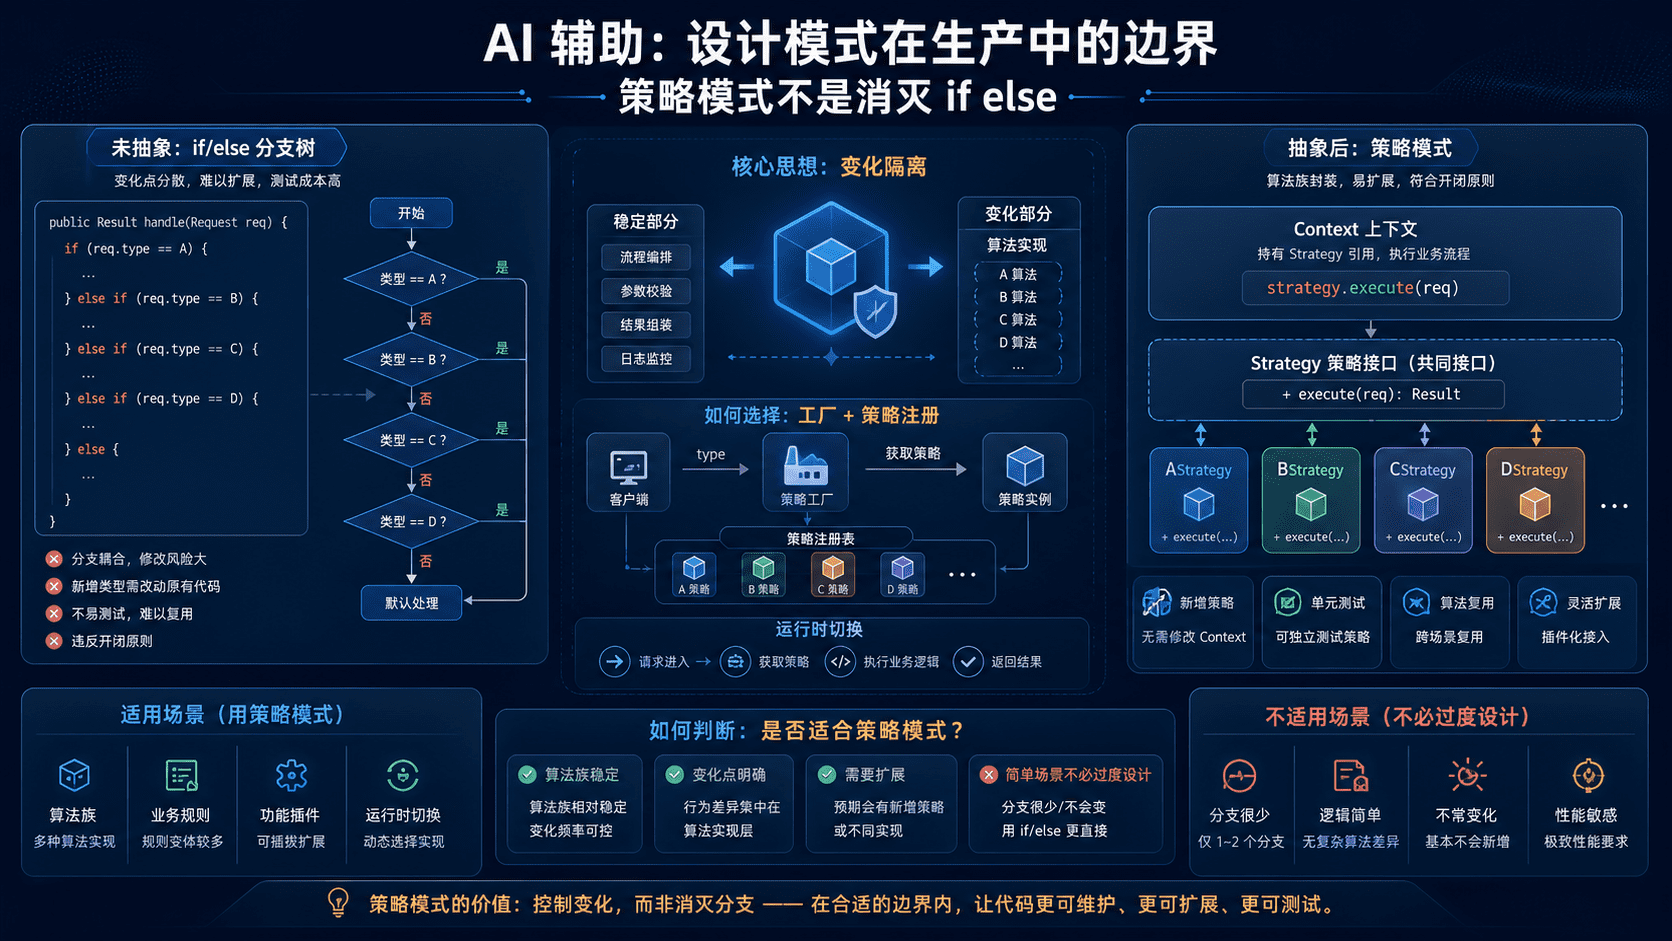
在Java生态中构建AI Gateway,Spring Boot依然是首选框架,但其内部组件的设计需要针对AI场景进行深度定制。首先,必须摒弃字符串拼接式的Prompt构建方式,转而采用结构化的请求对象。一个标准的AI请求应包含任务类型、租户标识、上下文数据、参数配置(如Temperature、Top-P)以及安全策略标识。网关内部通过策略模式匹配不同的Prompt模板引擎,根据任务类型动态渲染最终发送给模型的指令。这种方式不仅保证了Prompt的一致性,还便于后续对模板进行版本管理和A/B测试。例如,当需要优化某个客服场景的回答质量时,只需在网关层调整对应的Prompt模板,而无需重新部署上游的业务服务。
模型路由是AI Gateway的另一项关键能力。由于不同模型在性能、成本和擅长领域上存在显著差异,单一模型无法胜任所有业务场景。网关应具备智能路由能力,根据请求的特征动态选择最合适的模型。例如,对于简单的文本分类任务,可以路由至低成本的小参数模型;而对于复杂的逻辑推理或创意写作,则路由至高精度的旗舰模型。此外,路由策略还应支持故障转移(Failover),当主用模型供应商出现延迟过高或服务不可用时,自动切换至备用供应商,确保服务的连续性。在Java实现中,可以通过责任链模式或策略工厂来实现这一逻辑,结合Redis缓存实时获取各模型的健康状态与配额信息,做出最优决策。
安全性是企业级应用不可逾越的红线。大模型交互过程中,用户输入可能包含敏感个人信息(PII)、商业机密或内部代码。如果在发送请求前不进行严格过滤,极易造成数据泄露。AI Gateway必须内置强大的数据脱敏模块,支持基于正则表达式、命名实体识别(NER)或自定义字典的敏感信息检测与替换。脱敏操作应在Prompt渲染之前完成,确保原始敏感数据从未离开企业内网。同时,对于模型的输出内容,也需要进行后处理检查,防止模型产生幻觉、输出有害内容或泄露系统提示词(Prompt Injection)。对于高风险场景,如合同生成或财务建议,网关应强制要求引入人工审核环节,或将置信度较低的回复标记为“需确认”,从而在自动化效率与风险控制之间找到平衡点。
成本控制是另一个常被忽视但至关重要的维度。大模型的计费通常基于Token数量,且不同模型的单价差异巨大。如果没有精细化的成本监控,AI应用很容易成为企业的“费用黑洞”。AI Gateway需要建立完善的计量体系,记录每一次调用的输入Token、输出Token、模型类型、耗时以及所属业务线和租户。通过集成Prometheus等监控工具,可以实时展示各维度的成本分布,并设置预算阈值告警。当某个租户或接口的调用量异常激增时,网关可以自动触发限流或降级策略,阻止费用的无限膨胀。此外,通过缓存机制复用相似请求的结果,也能显著降低重复计算带来的成本浪费。
在代码实现层面,健壮的错误处理机制是区分玩具项目与生产级系统的关键。大模型服务受网络波动、服务端负载等多种因素影响,超时和临时性错误时有发生。因此,网关内部必须实现精细化的异常分类与重试策略。对于网络超时或5xx错误,可以采用指数退避算法进行有限次数的重试;而对于参数错误或权限拒绝等4xx错误,则应立即失败并返回明确的错误码,避免无效重试加剧系统负担。Java中的Resilience4j库提供了丰富的容错组件,如Circuit Breaker(熔断器)、Retry(重试)和Bulkhead(舱壁隔离),可以方便地集成到网关中,提升系统的韧性。例如,当某个模型供应商的错误率超过阈值时,熔断器会自动打开,暂时阻断对该供应商的请求,保护下游服务不被拖垮。
可观测性是运维和排查问题的基石。传统的日志记录往往只关注业务逻辑,而在AI场景下,我们需要记录更丰富的上下文信息。每一笔AI请求都应分配唯一的Trace ID,贯穿从业务发起、网关处理到模型响应的全链路。日志中应包含请求的关键元数据(如任务类型、模型版本)、脱敏后的Prompt摘要、实际消耗的Token数、首字延迟(TTFT)以及总耗时。通过这些数据,我们可以清晰地定位性能瓶颈:是Prompt过长导致传输慢?是模型推理速度慢?还是网络抖动?此外,结合分布式追踪系统(如Jaeger或SkyWalking),可以可视化整个调用链,帮助开发人员快速理解系统行为,特别是在微服务架构下,跨服务的依赖关系错综复杂,全链路追踪显得尤为重要。
测试策略也需随之升级。除了常规的单元测试和集成测试,针对AI网关还需要引入特定的测试用例。例如,构造极端长度的输入以测试截断逻辑,模拟模型超时以验证重试机制,使用包含敏感信息的payload以检验脱敏效果。更重要的是,需要建立一套评估体系,不仅关注技术指标(如QPS、延迟),还要关注业务指标(如回答准确率、用户满意度)。可以通过构建黄金数据集(Golden Dataset),定期对网关输出的结果进行自动化评估,确保模型升级或Prompt调整不会导致服务质量下降。这种持续集成与持续评估(CI/CE)的流程,是保证AI应用长期稳定运行的必要手段。
综上所述,将大模型调用纳入Java后端的服务边界,不仅仅是技术实现的改变,更是架构思维的升级。通过构建功能完备的AI Gateway,企业能够将不确定的外部AI能力转化为确定性的内部服务,实现从“粗放式调用”到“精细化治理”的转变。这不仅提升了系统的安全性、稳定性和可维护性,也为未来的多模型协同、私有化部署以及更复杂的AI原生应用奠定了坚实的基础。在这一过程中,开发者需要时刻保持对成本、安全和性能的敏感度,通过数据驱动的方式不断优化架构细节,真正释放人工智能在企业场景中的核心价值。