告别数据缝合怪:AI时代湖库一体架构如何重塑智能体底座
数据架构的演进困境:从拼凑到融合的必然
在过去的大半年里,许多技术团队在接入人工智能能力时,都经历了一场架构上的“阵痛”。传统的业务系统通常基于关系型数据库如MySQL存储核心交易数据,为了支持全文检索引入Elasticsearch,而为了实现语义搜索又不得不部署Milvus或Faiss等专用向量数据库。这种由多个独立组件堆砌而成的架构,被业界戏称为“数据缝合怪”。
这种架构的弊端显而易见。数据需要在不同系统间异步同步,任何一环的延迟或失败都会导致数据不一致。例如,当业务数据更新后,向量索引可能尚未生成,导致用户搜索到的结果是过时的。为了弥补这一缺陷,开发团队需要编写大量的补偿逻辑和监控脚本,这不仅增加了系统的复杂度,也极大地推高了运维成本。随着AI应用从实验阶段走向生产环境,这种松耦合的架构已难以满足高可用和低延迟的需求。
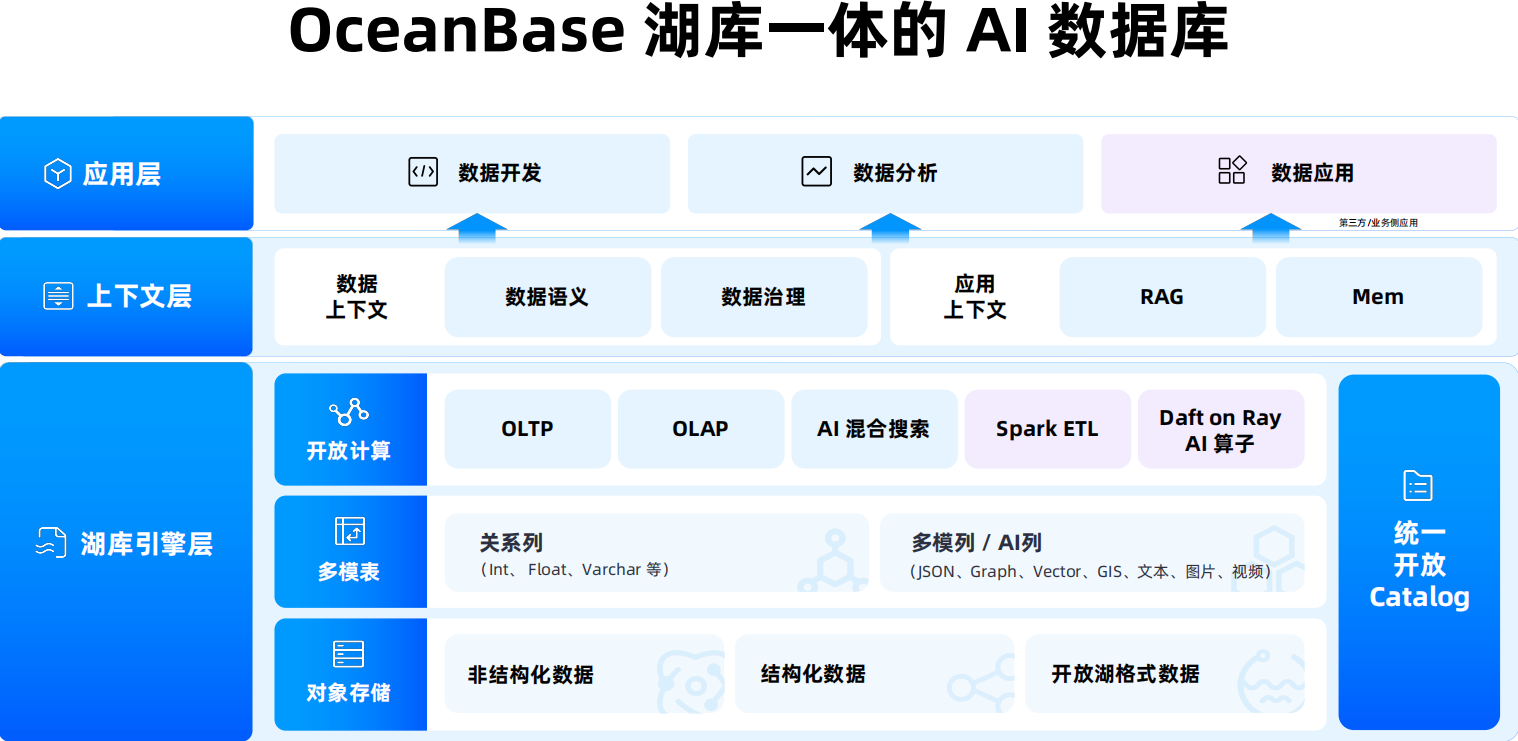
面对这一挑战,数据库领域正在发生深刻的变革。以OceanBase为代表的新一代数据库提出了“湖库一体”的概念,旨在打破数据存储的孤岛。这不仅仅是存储介质的合并,更是计算引擎的统一。通过将结构化数据、半结构化JSON、非结构化大对象以及AI向量特征融合在同一套内核中,湖库一体架构实现了数据入库即智能。这意味着开发者无需再关心数据在不同系统间的搬运与同步,所有数据形态都在同一个事务边界内保持一致,从而从根本上简化了AI应用的底层架构。
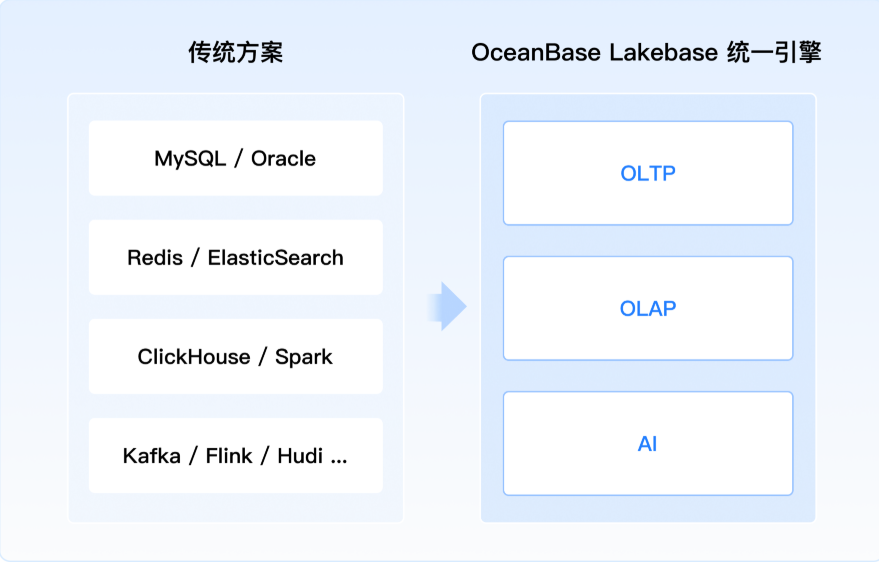
重新定义数据底座:湖库一体的核心内涵
要理解湖库一体,首先需要厘清它与“湖仓一体”的区别。湖仓一体主要解决的是大数据分析场景下,数据湖的海量存储能力与数据仓库的高性能查询能力之间的割裂问题,其核心关注点在于离线分析和批量处理。然而,在AI时代,尤其是智能体(Agent)广泛应用背景下,数据处理的实时性和交互性成为了新的关键指标。
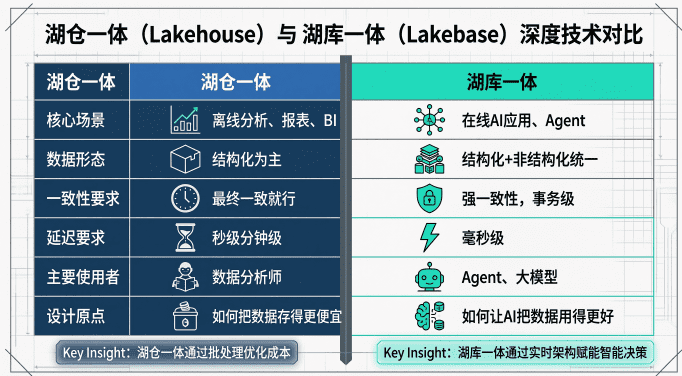
湖库一体则是面向AI原生应用设计的新型数据底座。它将数据湖的开放性、低成本海量存储能力,与传统数据库的强一致性、高并发实时处理能力深度融合。在这种架构下,数据不再仅仅是静态的资产,而是可实时计算的活跃要素。无论是传统的业务记录,还是用于语义理解的向量嵌入,亦或是图片、音频等多模态文件,都被统一纳管。
这种融合带来的最大价值在于“混合检索”能力的原生支持。在传统架构中,要实现关键词匹配与语义相似度的联合查询,需要在应用层分别调用搜索引擎和向量数据库,然后在内存中进行结果合并与重排序。而在湖库一体数据库中,这一过程可以在SQL层面直接完成。数据库引擎内部优化器能够同时利用倒排索引和向量索引,一次性返回经过加权排序的结果。这不仅大幅降低了网络开销,更显著提升了检索的准确率和响应速度,为上层AI应用提供了坚实的数据支撑。
多模表技术:实现数据形态的统一抽象
湖库一体落地的关键技术突破在于“多模表”的设计。这是一种极具创新性的数据抽象模型,它允许在同一张表中定义多种不同类型的列,包括传统的关系型字段、LOB大对象、JSON半结构化数据以及专门的AI向量列。
以智能客服场景为例,一张服务记录表可以同时包含客户ID(整数)、对话文本(文本)、录音文件(LOB)、元数据(JSON)以及对话内容的向量表示(Vector)。这种设计打破了以往必须将非结构化数据剥离存储的限制。对于LOB数据,系统采用分级存储策略:小对象直接行内存储以减少IO次数,大对象则切片存储于对象存储中,数据库中仅保留引用地址。这种机制既保证了访问效率,又控制了存储成本。
更为重要的是,多模表确保了数据写入的原子性。在向量化过程中,如果Embedding生成失败,整个事务将回滚,避免了出现“有文本无向量”或“有向量无文本”的数据残缺状态。在查询阶段,开发者可以使用标准的SQL语法进行复杂的混合检索。例如,可以先通过关系字段过滤出特定业务类型的记录,再在这些候选集中进行向量相似度搜索,最后结合全文检索评分进行重排序。这种“过滤-召回-排序”的一体化执行流程,极大提升了检索的精准度,真正实现了数据入库即具备智能检索能力。
智能体时代的数据库新需求
随着Vibe Coding和低代码平台的普及,应用开发门槛降低,智能体(Agent)逐渐成为软件交付的主力。Gartner预测,未来几年内超过三分之一的企业软件将由智能体参与构建。然而,智能体的行为模式与传统人类用户有着本质区别,这对底层数据库提出了全新的要求。
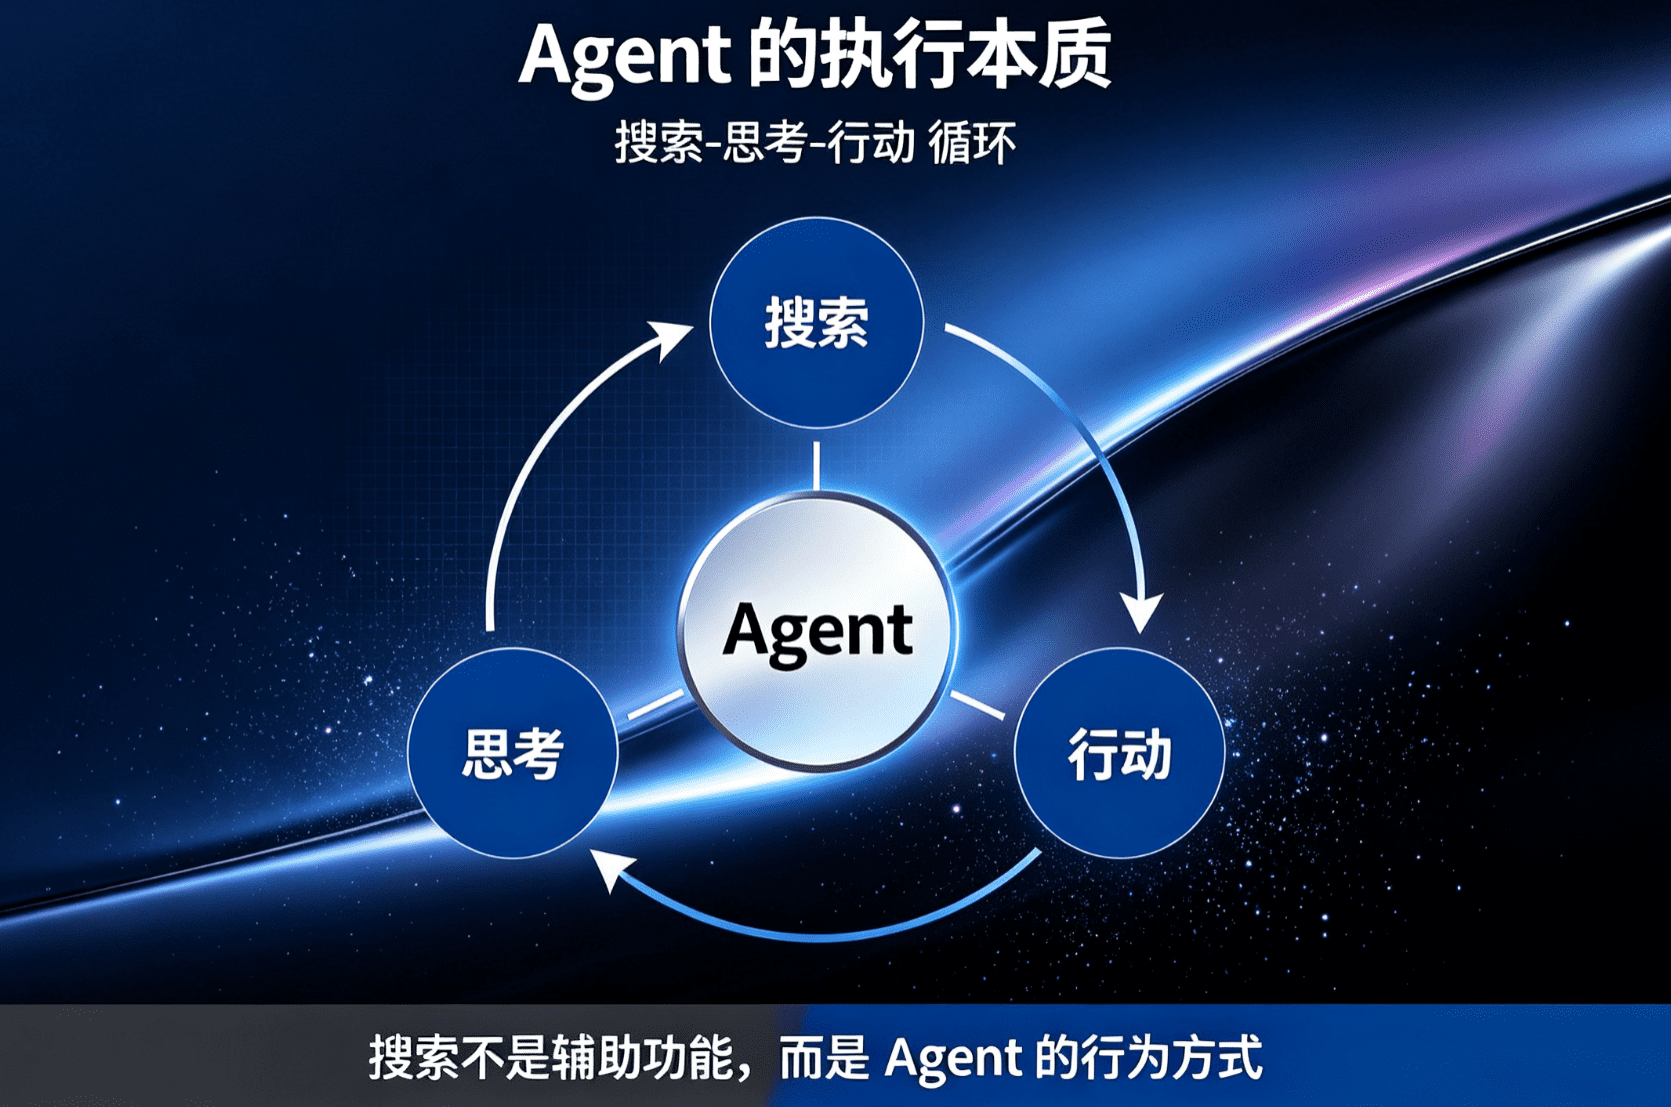
首先,智能体是搜索驱动的。它们的执行逻辑遵循“感知-思考-行动”的循环,其中感知环节高度依赖对上下文信息的快速检索。这不仅包括当前的对话历史,还涉及知识库、记忆库中的多模态数据。因此,数据库必须具备强大的混合搜索能力,能够高效处理高并发的向量查询和关键词匹配,为智能体提供高质量的上下文输入。
其次,智能体会犯错。在自主探索和代码生成过程中,智能体可能会执行错误的操作,如修改错误的表结构或写入脏数据。传统数据库缺乏有效的隔离机制,一旦出错往往造成生产事故。为此,现代AI数据库引入了类似Git分支的“Fork DB”功能。通过秒级克隆数据库实例或租户,开发者可以为智能体创建一个沙箱环境。智能体在其中自由试错,若结果符合预期则合并至主库,否则直接丢弃分支。这种机制极大地降低了AI开发的容错成本,保障了生产环境的安全性。
最后,智能体需要长期记忆。虽然大模型的上下文窗口不断扩大,但上下文不等于记忆。上下文是临时的、会话级的,而记忆是长期的、跨会话的用户画像和行为偏好。这些记忆数据需要以结构化加向量的形式持久化存储,并能在不同会话间无缝衔接。一体化数据库通过将记忆管理与业务数据置于同一事务边界,避免了因外部缓存(如Redis)与主库数据不一致导致的“记忆漂移”问题,确保智能体能够持续进化。
从数据堆砌到资产治理:记忆与语义的升华
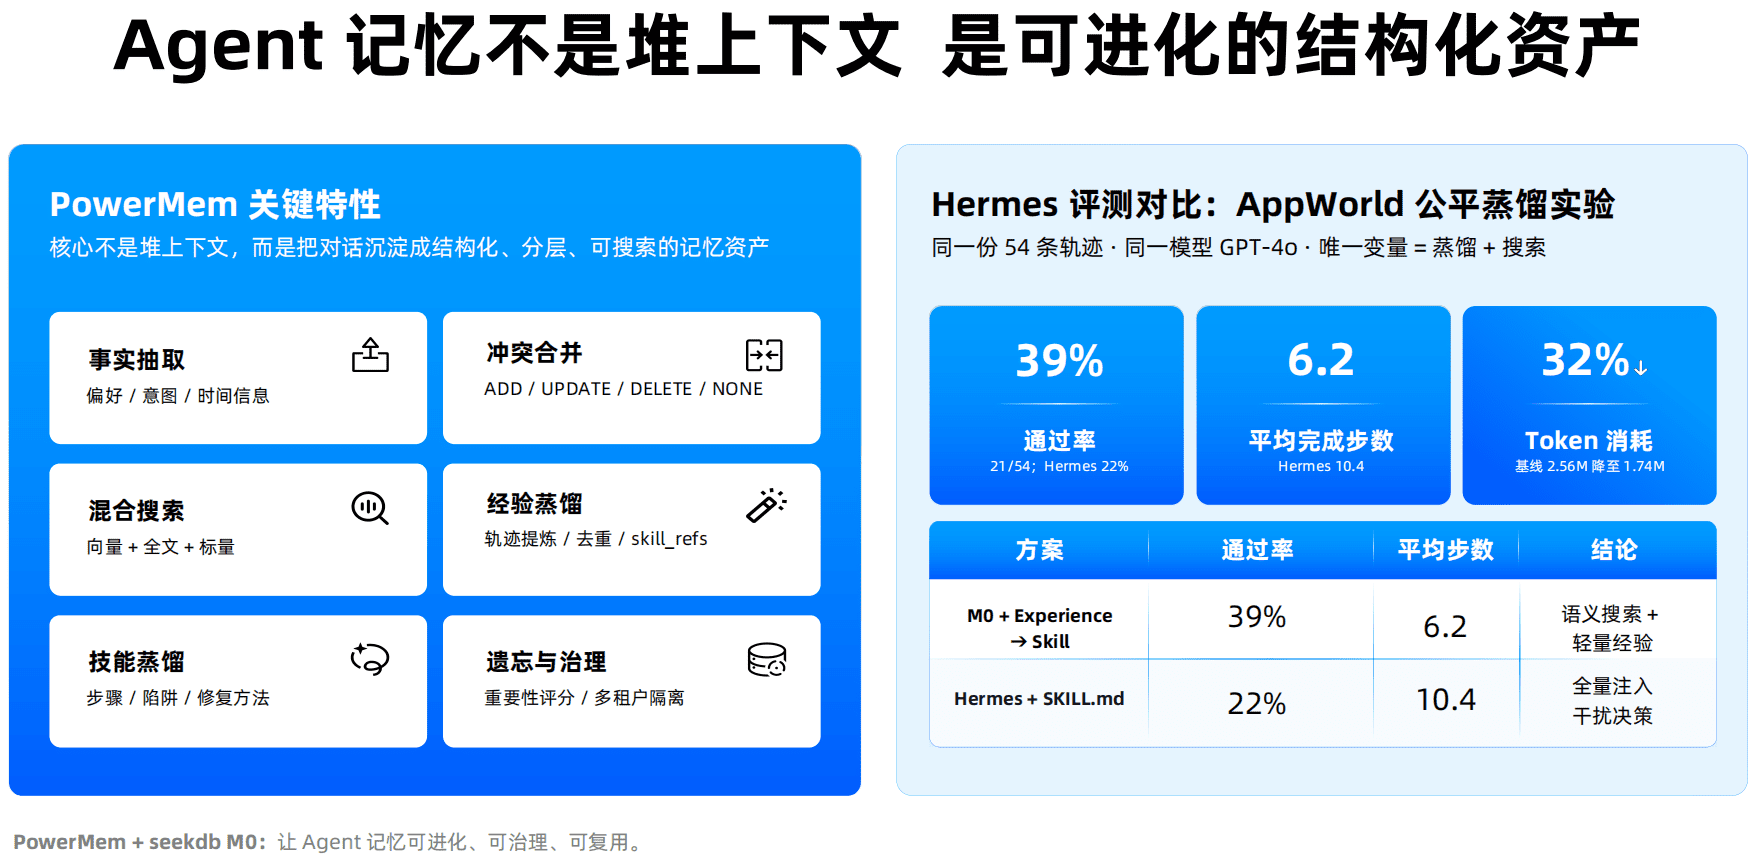
在解决了存储和检索的基础问题后,如何提升数据的质量和价值成为新的焦点。OceanBase推出的PowerMem智能记忆体,旨在将Agent的记忆从简单的文本堆砌转化为可治理、可复用的资产。通过自动压缩、摘要和关键信息提取,PowerMem帮助智能体在有限的上下文窗口中保留最有价值的信息,从而提升推理效率和准确性。
与此同时,数据语义的理解也是AI应用落地的难点。传统的数据字典往往滞后于业务发展,导致大模型难以准确理解业务指标的含义。OceanBase OSI(Open Semantic Interface)基于本体论思想,利用大模型自动从原始数据中发现业务实体、指标及其关联关系,构建动态的语义网络。这种自动化的语义建模能力,使得数据库不仅能存储数据,还能理解数据背后的业务逻辑,为上层应用提供更精准的上下文支持。
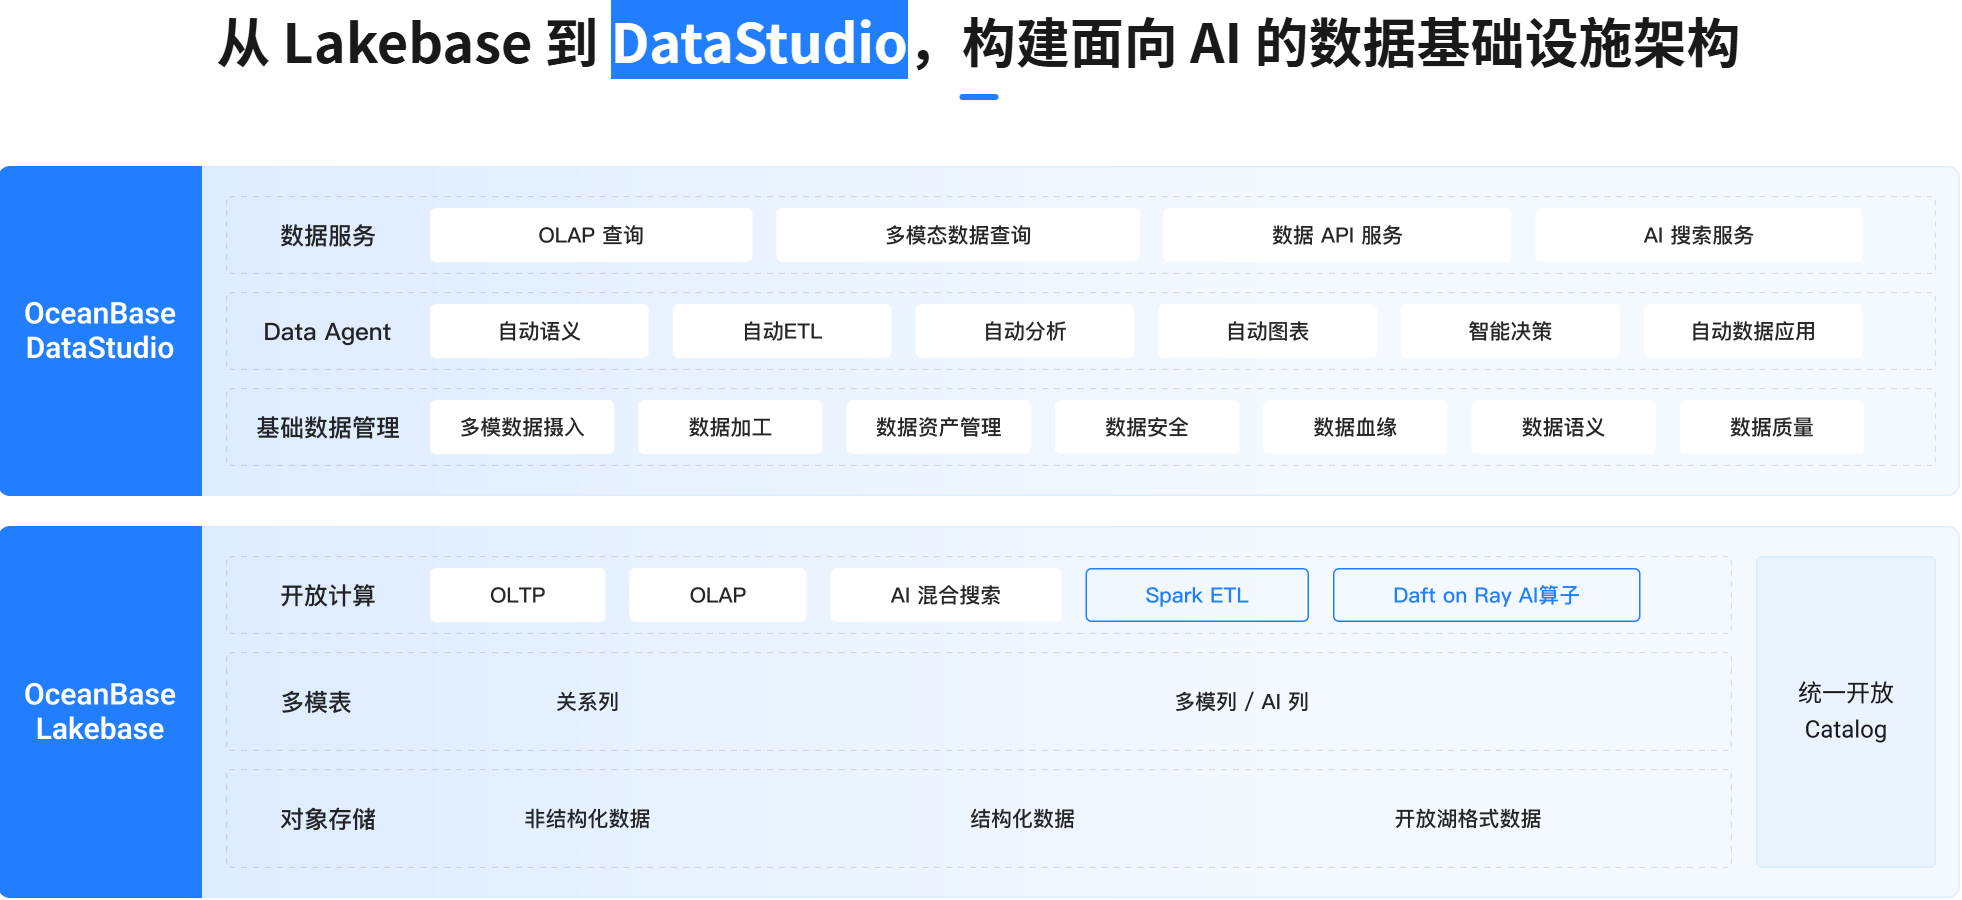
此外,为了降低开发者的使用门槛,Lakebase底座之上构建了DataStudio统一开发治理平台。该平台屏蔽了底层复杂的引擎细节,提供了可视化的数据管理、模型调试和API发布功能。开发者可以专注于业务逻辑的实现,而无需深入钻研数据库的内核原理。这种“把复杂留给自己,把简单留给客户”的设计理念,正是推动AI数据库大规模商用的关键。
结语:迈向AI原生的数据基础设施
回顾数据库的发展历程,从单机到分布式,再到如今的湖库一体,每一次演进都是由业务需求倒逼而来的技术革新。十五年前,双十一的海量交易压力催生了原生分布式数据库;今天,AI应用的复杂场景正在塑造新一代的智能数据底座。
湖库一体并非简单的概念炒作,而是应对AI时代数据碎片化、检索复杂化、交互实时化挑战的务实解决方案。它通过统一的数据模型、原生的混合检索能力以及针对智能体特性的优化,重构了数据与应用之间的关系。对于企业而言,选择湖库一体架构意味着更低的运维成本、更高的数据一致性以及更快的AI应用迭代速度。
未来,随着多模态数据的爆发和智能体协作网络的成熟,数据库将进一步向智能化、自动化方向演进。我们期待看到更多像OceanBase这样扎根于真实生产场景的技术创新,为AI时代的数字化转型提供坚实可靠的基石。在这个过程中,开发者也应积极拥抱变化,深入理解新架构的核心原理,以便更好地驾驭数据这一核心生产要素,释放人工智能的巨大潜力。