英伟达发布AI视频检测工具:92%准确率背后的现实困境与破局思考
深度伪造时代的“猫鼠游戏”升级
随着生成式人工智能(AIGC)技术的指数级跃迁,数字内容的真伪边界正以前所未有的速度消融。曾经,区分真假视频依赖于肉眼捕捉手指数量异常、口型错位或物体穿模等低级视觉破绽;如今,以Sora、Kling、Seedance为代表的新一代视频生成模型,已经能够通过复杂的扩散去噪过程,生成具备物理连贯性与光影真实感的视频片段。这种技术范式的转移,使得传统的基于像素级瑕疵的检测手段迅速失效。
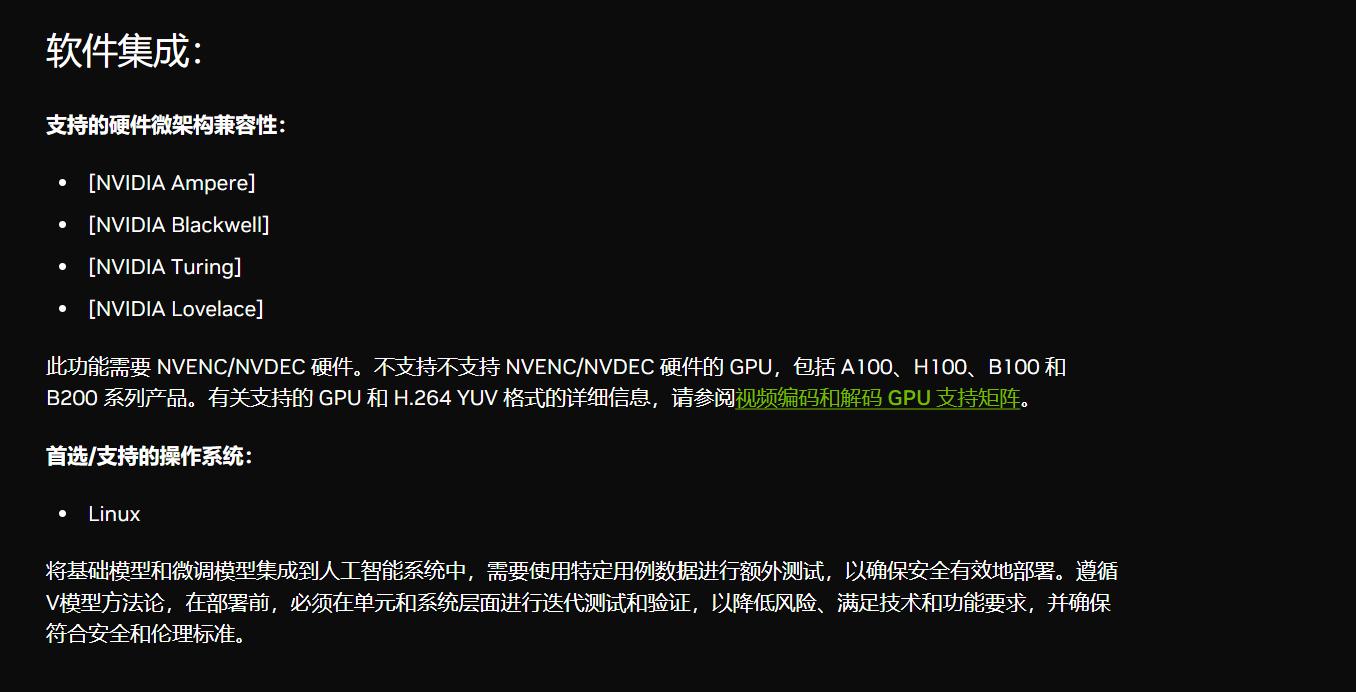
在这一背景下,硬件巨头英伟达(NVIDIA)正式入场,发布了Synthetic Video Detector NIM(以下简称SVD NIM)。这套工具并非简单地对画面内容进行语义理解,而是深入到底层的信号处理层面,试图通过捕捉生成模型在训练与推理过程中留下的统计指纹与频域异常,来识别AI生成的视频。英伟达宣称,在标准H.264编码的MP4视频测试集中,该工具的检测准确率高达92%。这一数据的发布,标志着AI安全领域从“人工规则对抗”向“统计学特征对抗”的范式转变。
然而,高达92%的准确率是否意味着我们终于找到了对抗Deepfake的终极武器?通过深入解析其技术原理、实测表现以及与其他检测工具的横向对比,我们可以发现,目前的AI视频检测技术仍处于“有效但脆弱”的过渡阶段。它解决了部分高难度鉴别问题,却尚未构建起坚不可摧的信任基石。
技术路径演进:从视觉破绽到频域指纹
要理解SVD NIM的价值与局限,首先需要厘清其技术路线与传统检测器的本质区别。早期的AI视频检测器主要依赖于“异常检测”逻辑,即训练模型去识别那些不符合人类运动规律或物理常识的特征。例如,检测眨眼频率异常、背景纹理重复或边缘锯齿化。这种方法在面对早期生成模型时效果显著,因为那时的模型连基本的物理一致性都无法保证。
SVD NIM则采取了完全不同的路径:频域分析与统计痕迹检测。视频生成模型(如基于Diffusion Models的架构)在生成内容时,本质上是一个去噪过程。在这个过程中,生成的像素值分布、频率响应模式以及噪声残留,往往与真实相机传感器捕获的光信号存在细微但可量化的差异。SVD NIM利用封装在NIM(NVIDIA Inference Microservices)架构中的DINOv2与DINOv3视觉编码器,对视频帧进行特征提取。它不关注“这是什么”,而是关注“这是怎么生成的”。
具体而言,该工具会将H.264编码的MP4视频解码为单帧图像,分析其空间频率分布。真实视频经过相机镜头光学模糊、传感器噪声注入以及压缩算法处理,其频谱特征具有特定的自然分布规律;而AI生成视频虽然视觉上平滑自然,但在高频部分往往存在生成模型特有的周期性残留或频谱平坦化现象。这种基于底层信号统计特性的检测方法,使得SVD NIM即使面对经过多次压缩、转码或分辨率调整的视频,也能保持较高的识别鲁棒性。
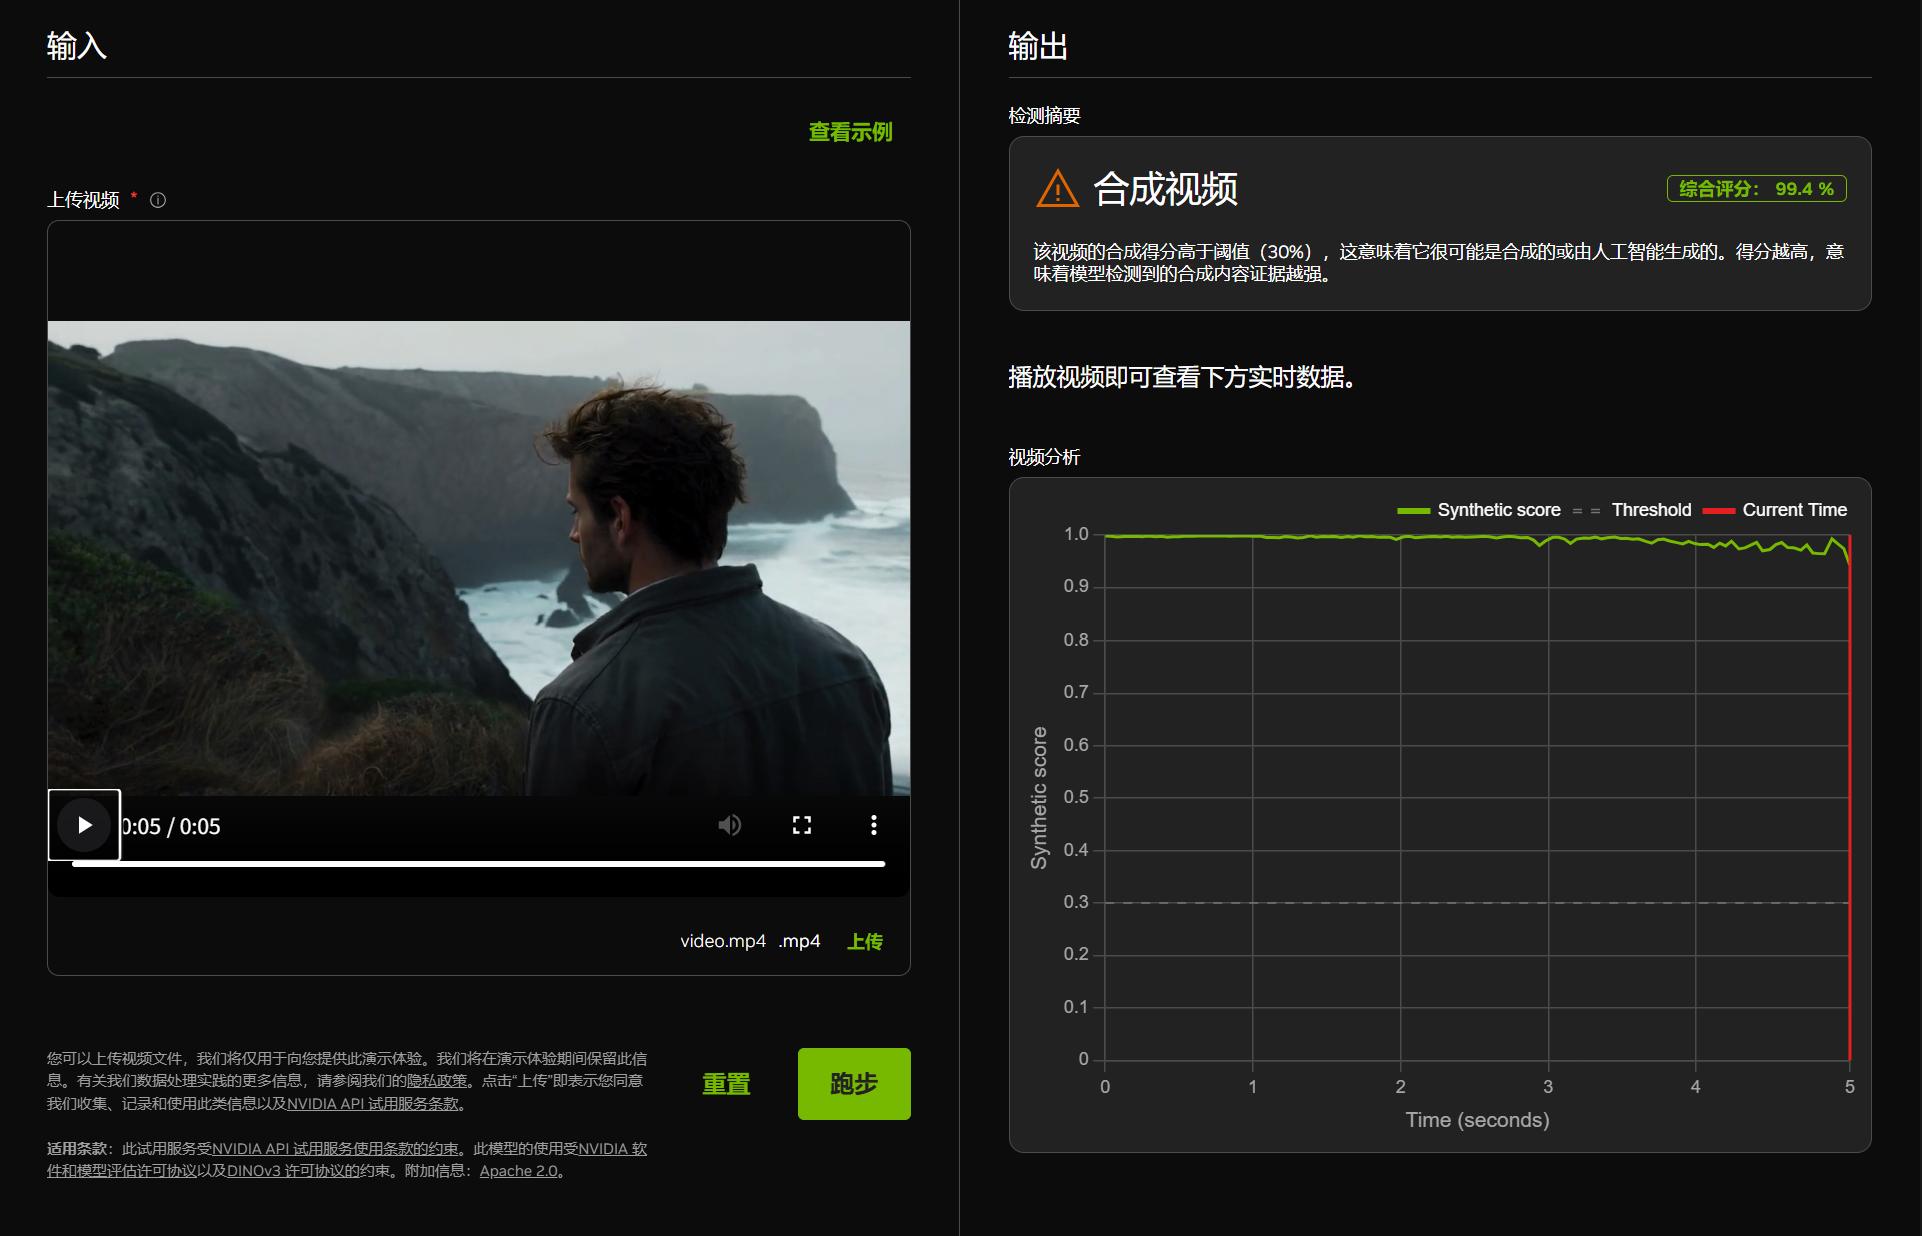
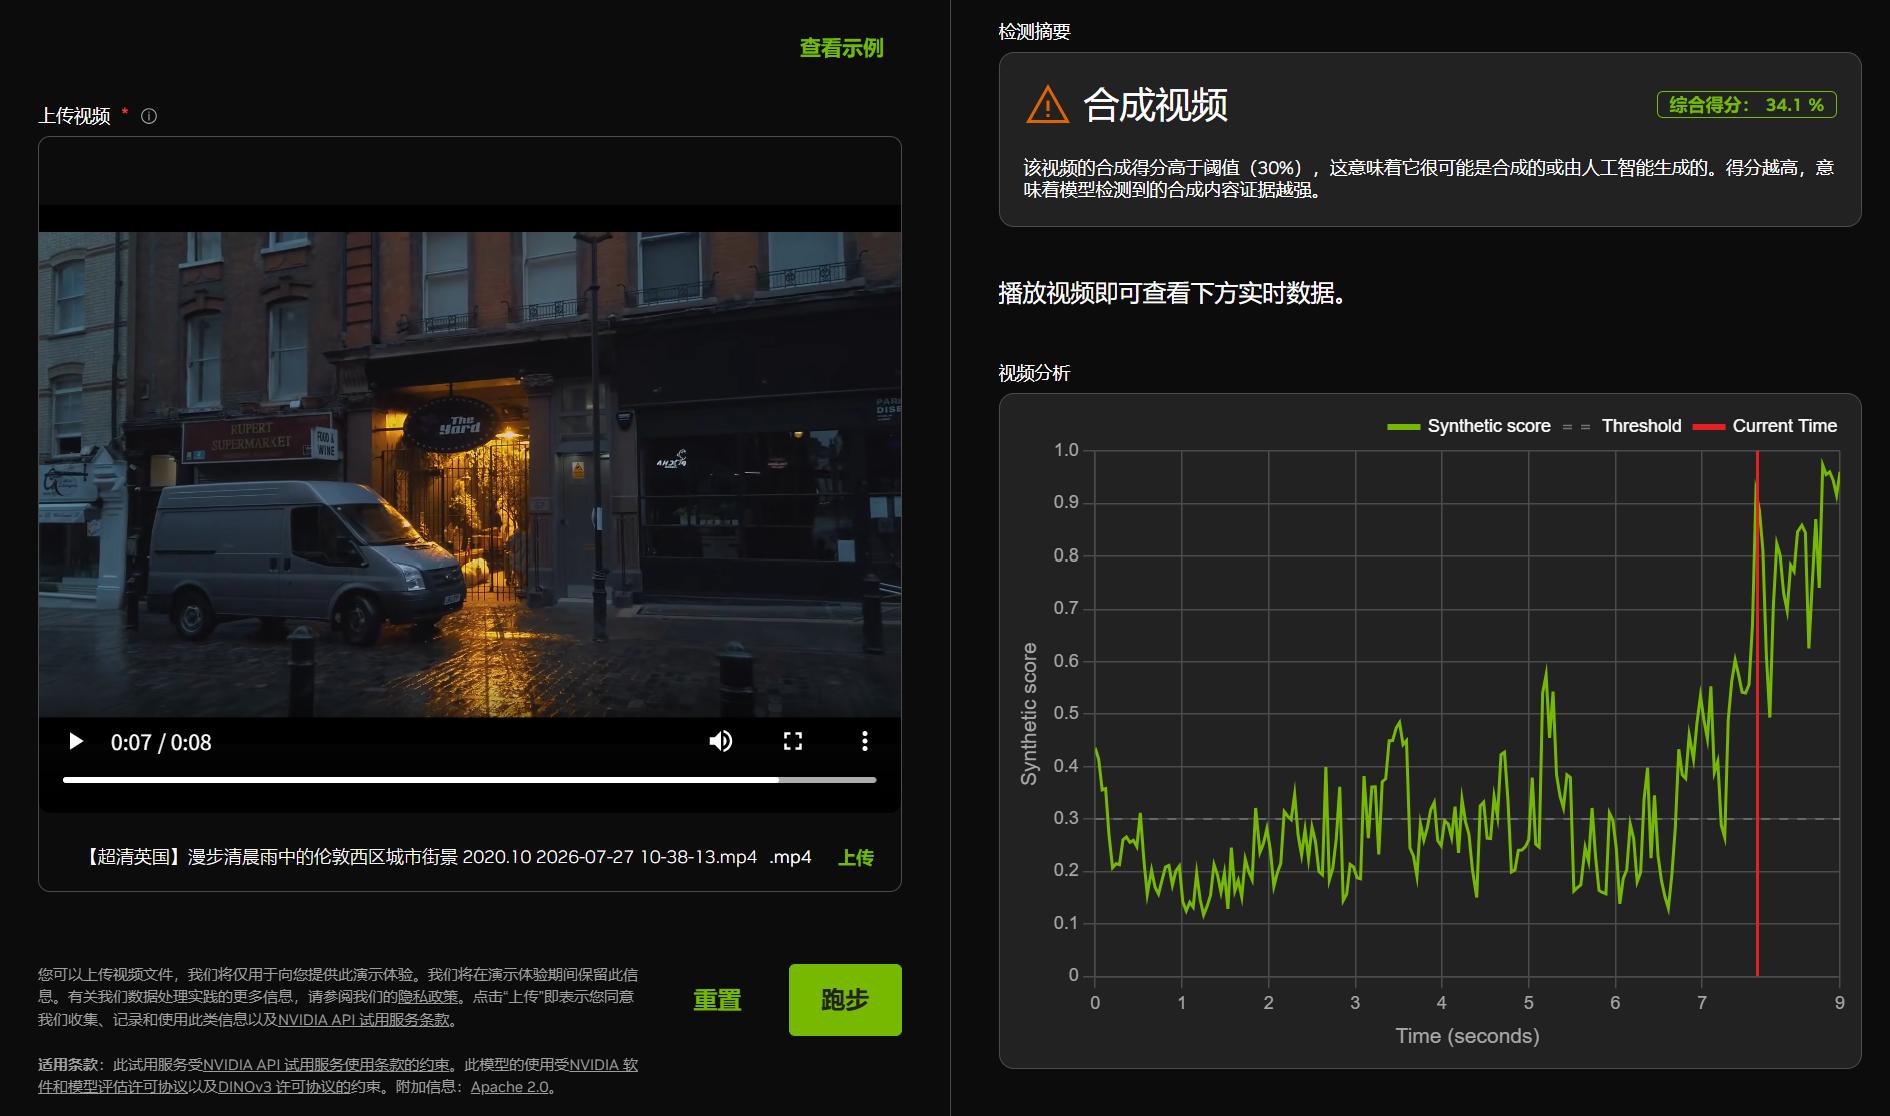
此外,SVD NIM采用逐帧打分并汇总的综合评估机制。这意味着它不仅能判断整段视频的真伪,还能通过可视化界面标出每一帧的“可疑度”,为人工复核提供线索。这种细粒度的分析能力,使其更适合用于内容平台的初筛机制,而非最终的定性判决。
实测数据剖析:高准确率背后的阈值陷阱
尽管英伟达宣传的92%准确率令人印象深刻,但在实际应用场景中,这一数字需要被置于严格的语境下解读。首先,该测试数据集为内部准备好的4000多个视频样本,且主要针对未压缩或轻度压缩的H.264格式。在真实的互联网传播环境中,视频往往会经过微信、微博等多轮二次压缩与格式转换,这会极大地改变视频的频域特征,从而显著降低检测器的准确率。
更关键的问题在于“阈值采样”对准确率的影响。在机器学习分类任务中,准确率通常取决于设定的置信度阈值。如果将阈值设定得极高(即极其严格),系统只会对特征极其明显的样本做出判定,这会减少误判(False Positives),但也可能导致漏判;反之,若降低阈值以提高召回率,则会产生大量误报。英伟达文档中提到的92%准确率,很可能是在一个相对严格的阈值下得出的,这意味着在真实部署中,为了维持高精度,系统可能会拒绝识别许多处于“灰色地带”的样本,或者将大量真实视频误判为AI生成。
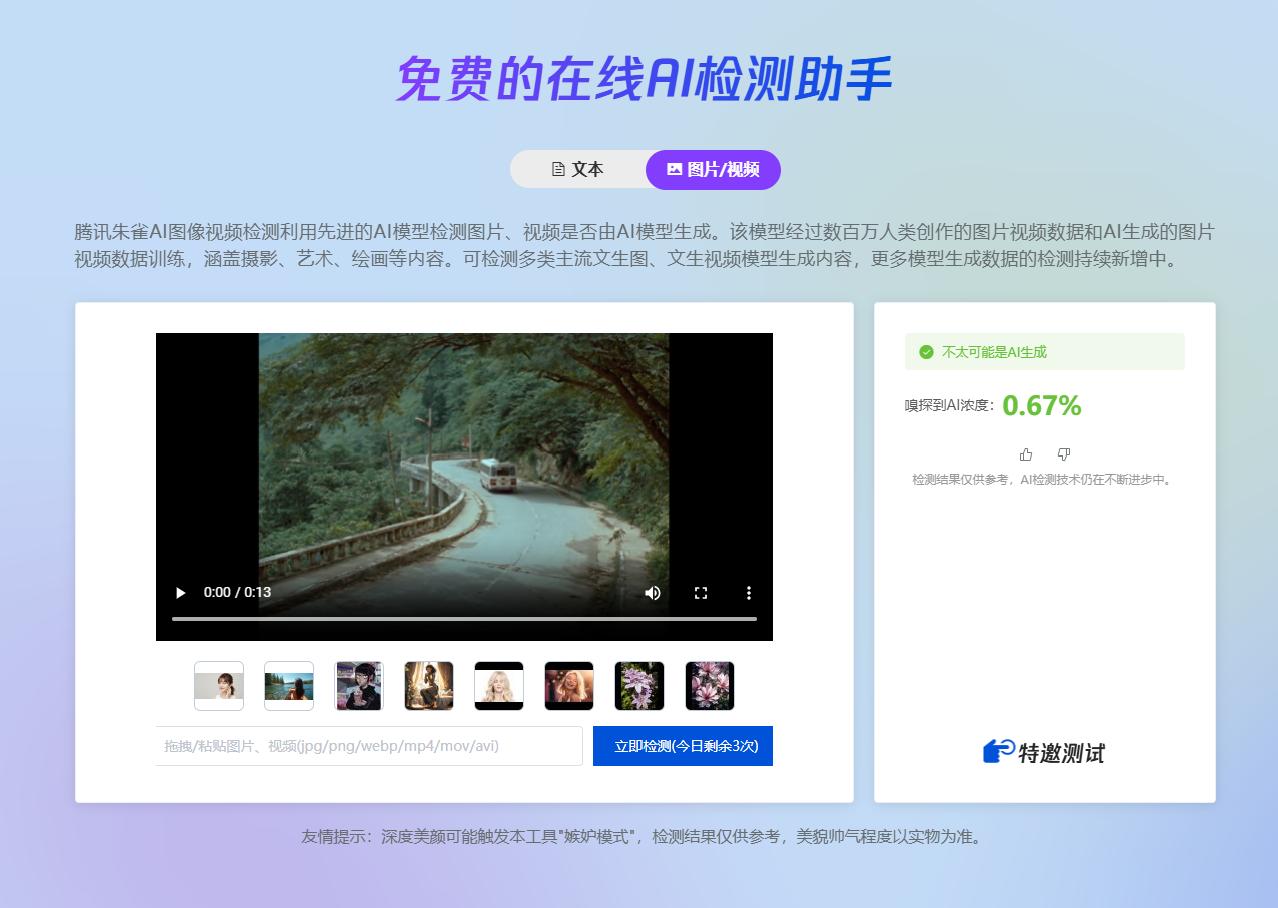
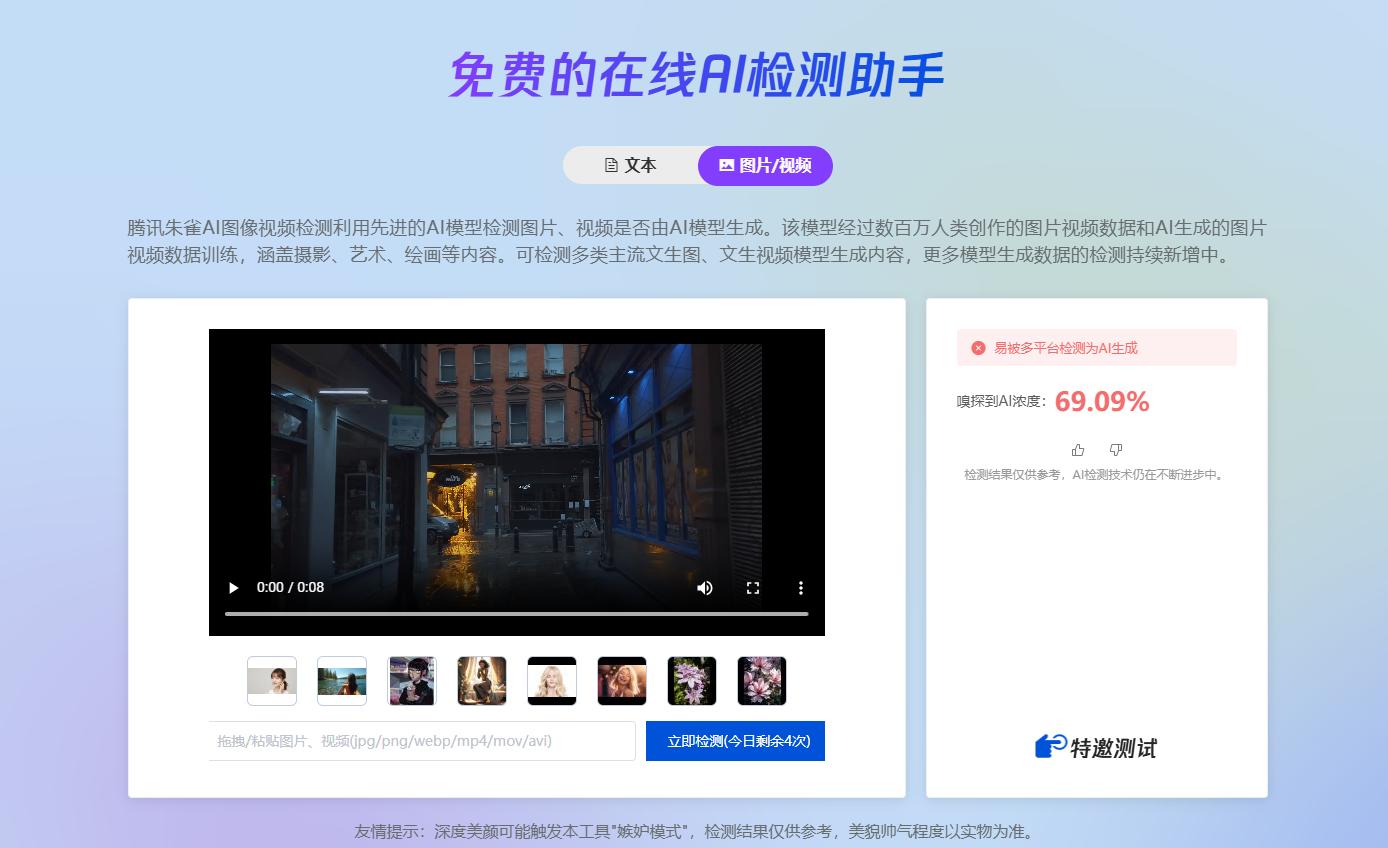
在具体的横向实测中,这种局限性暴露无遗。测试人员引入了一段由Seedance生成、模拟老电影质感且带有轻微镜头抖动的视频,SVD NIM给出了93%的高分判定。然而,当测试对象切换为一段画质极高、光影自然的真实Vlog视频时,SVD NIM仅给出了34%的低分,这表明其对于高保真真实内容的误判风险依然存在。相比之下,国内腾讯朱雀AI检测助手在视频检测上表现极不稳定,不仅对AI生成视频误判为真,对真实视频也常给出高置信度的AI判定,显示出其在特征泛化能力上的不足。
值得注意的是,检测速度也是影响部署可行性的关键指标。SVD NIM在处理一段仅13秒的短视频时,耗时长达两分钟,这对于需要实时审核的大规模视频平台而言,算力成本与延迟问题不容忽视。而反诈中心App内置的AI内容鉴定功能,虽然在图片检测上表现优异,实现了“三题全对”,但其服务器稳定性极差,多次测试均因无法上传内容而失败,反映出后端基础设施的高可用性短板。
行业现状反思:检测工具的“无力感”与局限
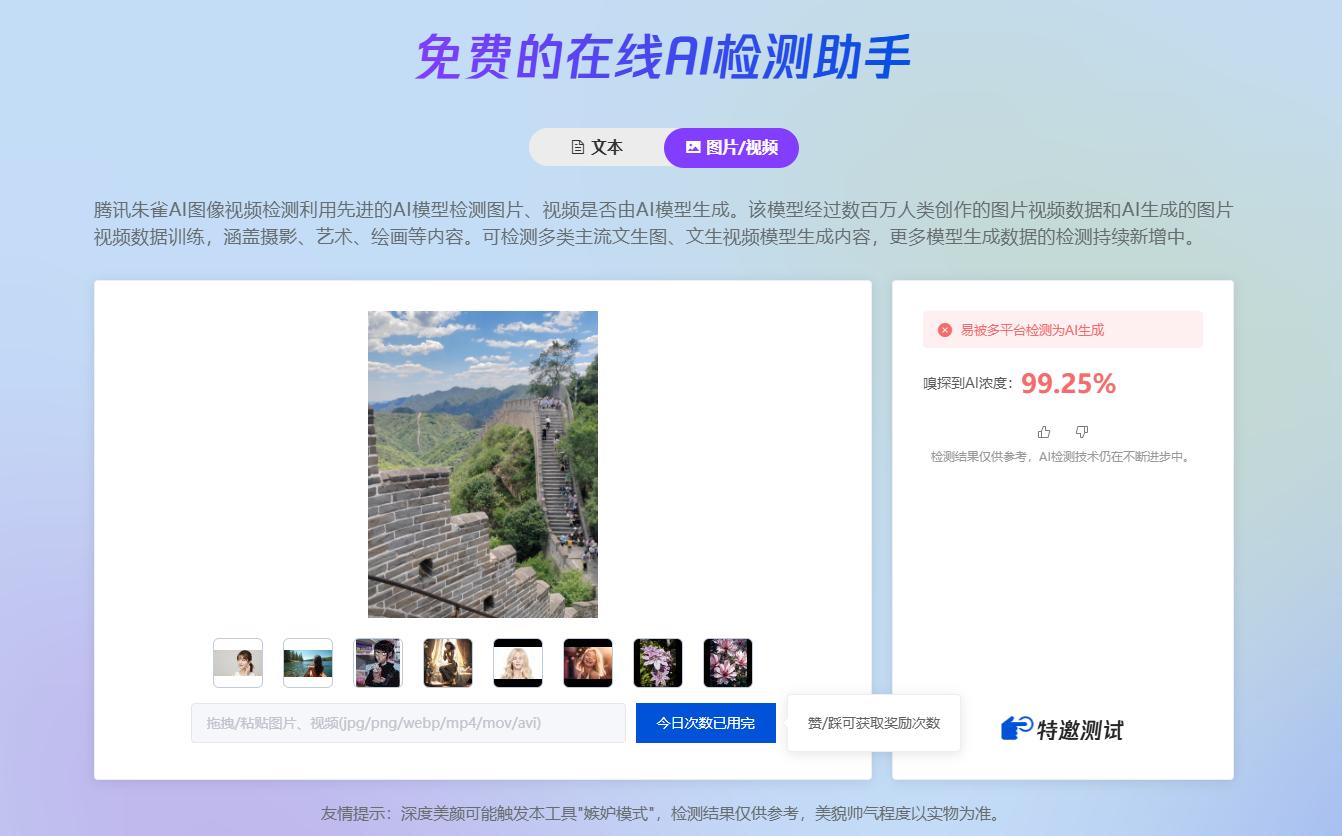
此次对英伟达SVD NIM及国内同类工具的实测,揭示了一个残酷的现实:目前的AI检测技术普遍存在“高门槛、低稳定性、易绕过”的特点。
从用户体验角度看,SVD NIM主要面向开发者与本地部署场景,需要Linux系统与NVENC/NVDEC兼容硬件,普通用户难以直接调用。而面向大众的腾讯朱雀与反诈中心工具,则受制于免费次数限制、上传失败频发以及误判率高等问题,无法成为可靠的日常鉴伪工具。这种“好用”与“可用”之间的巨大落差,使得检测工具难以真正下沉到公众层面。
从技术对抗角度看,AI检测面临“猫鼠游戏”的无限循环。一旦检测算法的特征模式被公开,生成模型可以通过针对性训练(如对抗训练)来消除这些统计痕迹。例如,生成器可以学习模仿真实相机的噪声分布,或者在后期处理中注入人工噪声以掩盖频域异常。这种动态博弈使得静态的检测模型生命周期极短,需要持续不断地更新迭代,这对于资源有限的中小型平台而言是巨大的挑战。
此外,跨平台兼容性与元数据丢失也是检测失效的重要原因。视频在微信、QQ等社交平台的转发过程中,往往会剥离EXIF等元数据,甚至进行重编码。如果检测技术严重依赖元数据或特定的压缩遗留特征,那么在经过一轮社交媒体传播后,检测准确率将断崖式下跌。实测中,经过截图、再压缩的AI图片,部分检测工具依然能够识别,但部分则彻底失效,这表明目前的检测技术尚未建立起对复杂传播链路的强鲁棒性。
破局之道:从“事后检测”转向“源头治理”
鉴于当前检测技术的局限性,业界共识逐渐从“事后鉴别”转向“源头标识”。与其花费高昂成本去鉴别一个可能被精心伪造的像素级痕迹,不如在内容生成的源头留下不可磨灭的数字指纹。
目前,全球范围内已在推动多项数字内容溯源标准。谷歌推出的SynthID技术,通过在图像生成过程中嵌入肉眼不可见的隐形水印,即使经过截图、裁剪、压缩,水印依然可被提取验证。Adobe等巨头推动的C2PA(Coalition for Content Provenance and Authenticity)标准,则致力于建立一个从相机传感器到最终发布的全链路内容凭证记录体系,确保文件从生成、编辑到发布的全过程可追溯。
在国内,网信办已明确要求AI生成内容必须添加标识,腾讯、阿里、字节等头部企业也在积极布局数字签名与平台提示技术。例如,在AI生成视频底部固定显示“由AI生成”的标签,或在元数据中嵌入加密的创作者ID与时间戳。
然而,建立这一体系仍面临诸多挑战。首先是标准互通问题,不同平台采用的水印或签名格式各不相同,跨平台的验证接口尚未统一。其次是开源模型的监管难题,用户通过本地部署开源模型生成的内容,往往无法自动绑定平台标识,形成了监管盲区。最后是隐私与安全的平衡,如何确保溯源信息不被恶意篡改或窃取,也是技术设计中的核心难点。
用户素养:最后一道防线
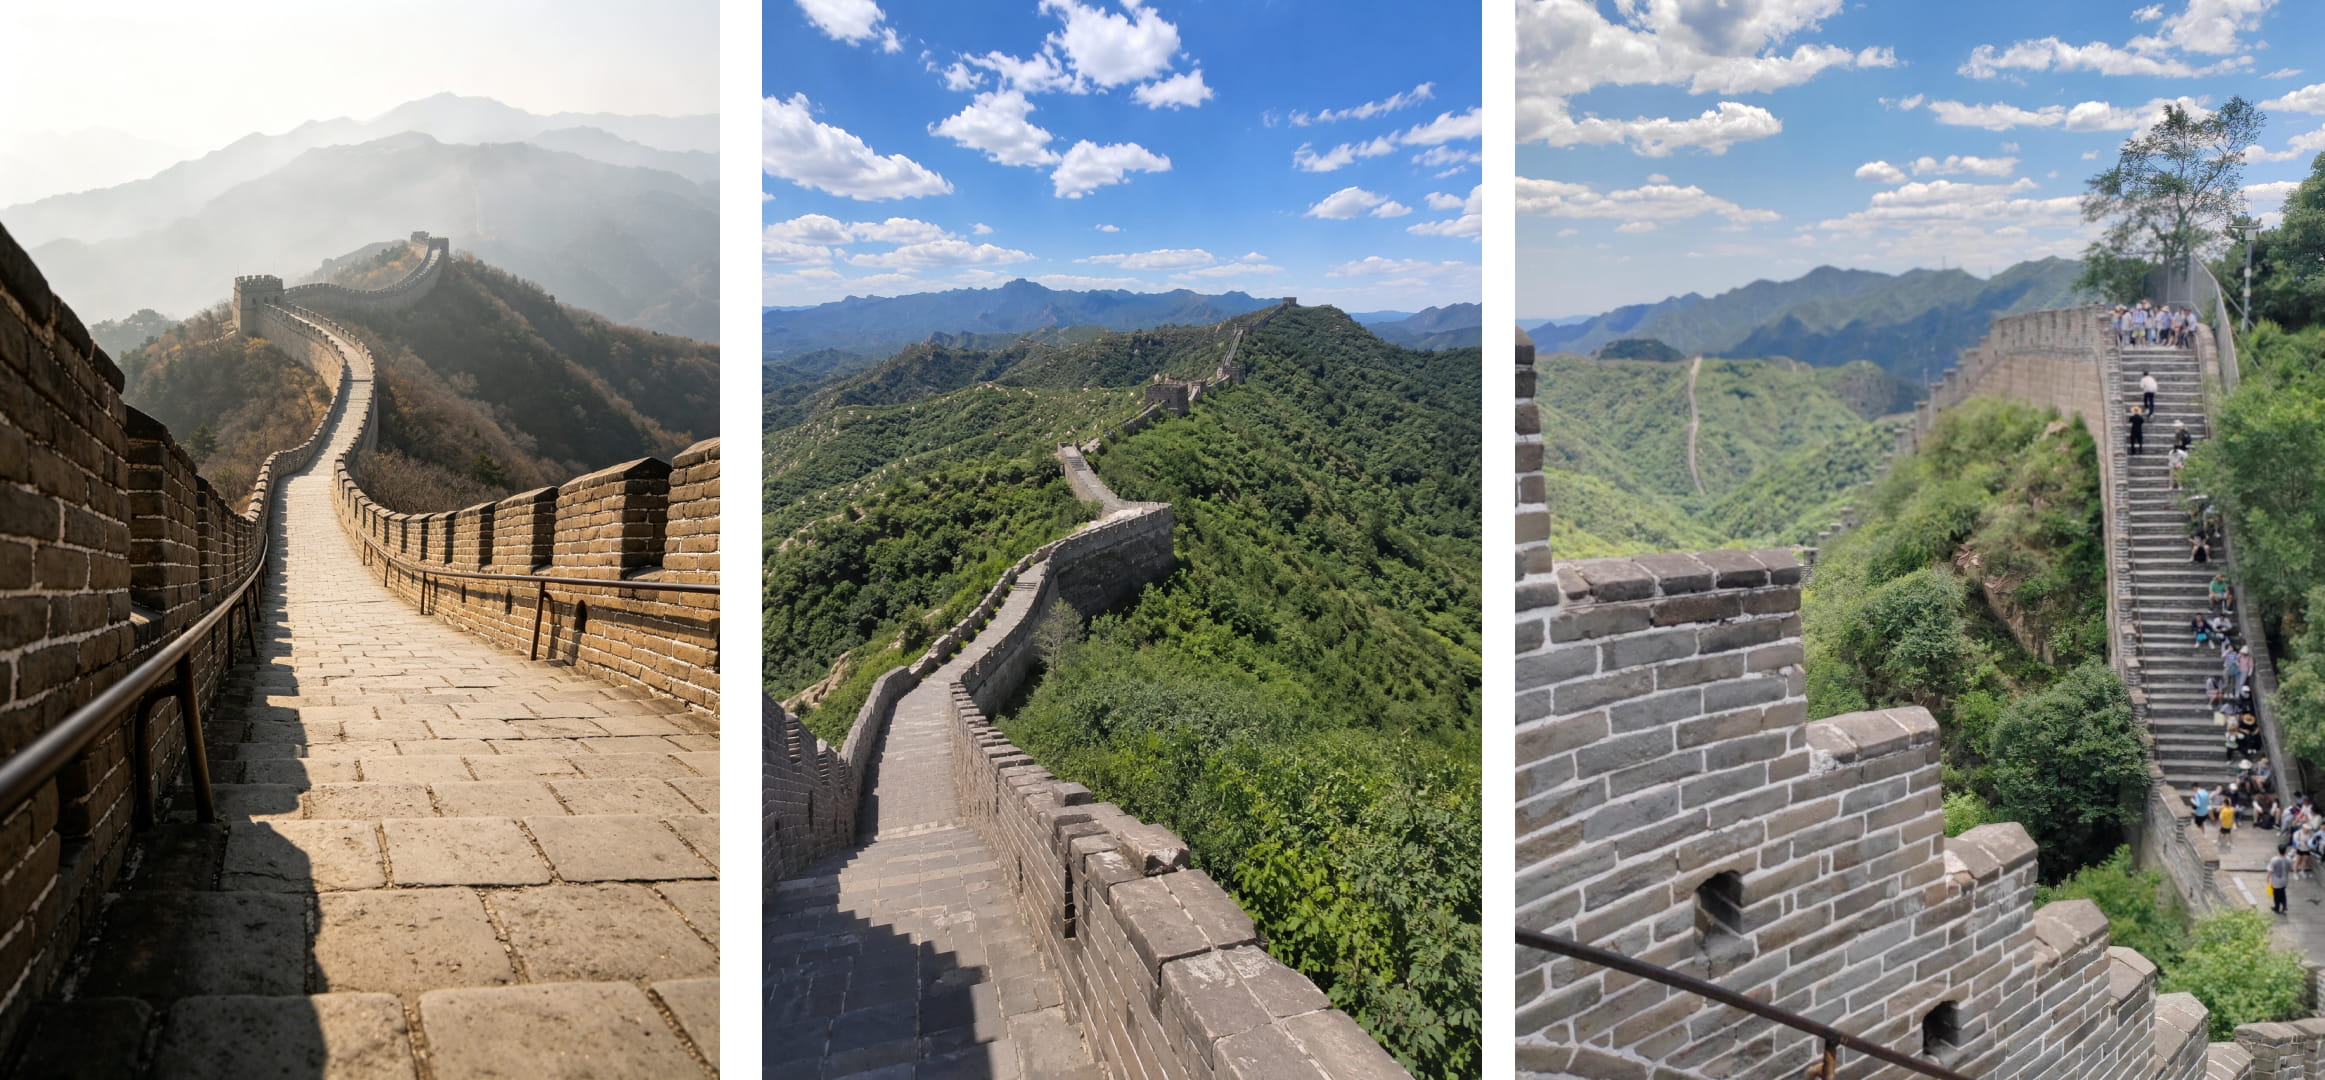
在技术标准完全统一、溯源体系全面打通之前,普通用户必须认识到:任何AI检测工具都只能提供概率性的参考,而非绝对的真理。
面对网络上流传的“黄仁勋跳伞”、“明星丑闻视频”等热点Deepfake内容,用户应保持批判性思维,不轻信单一的视频证据。多重验证、交叉比对信息源、关注官方渠道发布,是避免被误导的有效策略。同时,用户也应积极利用现有的检测工具作为辅助参考,但务必理解其误报与漏报的可能性,避免将检测截图作为唯一的“断案依据”在网络审判中使用。
AI视频分析工具的诞生,是人类应对技术滥用的一次重要尝试。英伟达的SVD NIM展示了统计学检测在解决高难度鉴伪问题上的潜力,但其暴露出的稳定性、易用性与泛化能力问题,也指明了未来技术演进的方向。未来的AI安全生态,将不再是单一检测工具的独角戏,而是源头标识、平台审核、用户素养与技术检测共同构成的多维防御体系。唯有如此,我们才能在享受AIGC带来创作红利的同时,守住数字真实性的底线。