2.8万亿参数背后:硅谷为何在OpenAI缺席下集体站队开源?
开源与闭源的重新平衡
7月下旬,硅谷的AI圈层经历了一次罕见的一致对外表态。英伟达创始人黄仁勋在社交媒体转发了一封题为《开放权重与美国AI领导力》的公开信,联署者迅速从最初的25家扩展至约50家,涵盖了微软、Meta、IBM、AMD、思科、Cloudflare以及GitHub等科技巨头。这一集体站队的核心信息明确而坚定:“世界既需要前沿闭源模型,也需要前沿开放模型。”
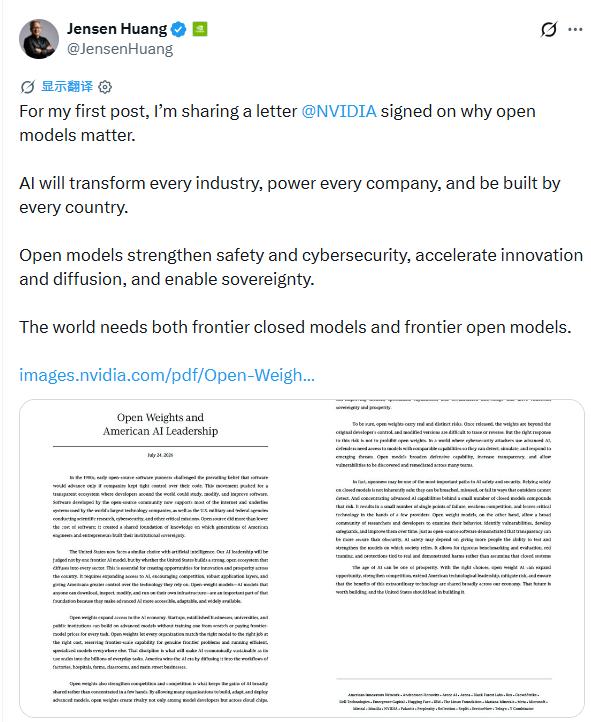
这种一致性背后,是一个正在被打破的技术边界。此前,开放模型长期被视为闭源旗舰产品的廉价替代品,虽然在部署灵活性上具有优势,但在核心智能能力上存在明显差距。然而,随着中国月之暗面发布Kimi K3模型,这一认知正在被修正。K3采用混合专家架构,总参数高达2.8万亿,却在智能体、编程等多项评测中跻身全球第一梯队。一款具备顶尖性能、可下载部署且推理成本可控的开源模型的出现,直接冲击了美国科技巨头长期构建的技术壁垒。
这场博弈的焦点,不再仅仅是技术优劣,而是关于未来AI产业生态主导权的争夺。当开源模型开始具备影响企业技术架构决策的能力时,原本泾渭分明的闭源阵营出现了裂痕。英伟达、微软等基础设施提供商之所以积极拥抱开源,是因为他们看到了一个更广阔的算力消费市场。对于依赖API订阅和服务溢价的模型提供商而言,强势开源模型的出现无疑是一种威胁;但对于提供底层硬件和云服务的企业来说,多元化的模型供给意味着更活跃的开发者生态和更持续的算力需求。
性能与成本的双重突破
Kimi K3的发布之所以引发震动,关键在于它同时满足了三个 previously 难以兼得的条件:性能接近前沿闭源模型、权重完全开放可修改、推理成本处于企业可承受范围内。2.8万亿参数的规模曾让业界担忧其推理成本将是天文数字,但混合专家架构(MoE)改变了这一局面。
在该架构下,每次推理仅激活896个专家模块中的16个,极大地降低了计算冗余。技术报告进一步揭示了其背后的创新:KDA(Kimi Delta Attention)以3:1的比例混合线性注意力与完整注意力层,既保证了长序列处理的效率,又在关键位置维持了精度,类似于视频编码中关键帧与差分帧的分工机制。此外,Attention Residuals通过在网络层间建立直连通道,有效补偿了线性注意力带来的信息损失,而Stable LatentMoE则通过统计方法平衡专家负载,使得极端稀疏的架构得以稳定收敛。
这些技术突破使得同等算力下模型的智能水平提升了约2.5倍。更重要的是,月之暗面公开了包括专家通信库MoonEP、高性能算子FlashKDA在内的训练基础设施,这表明开源不仅仅是权重的公开,更是整个技术栈的透明化。对于企业而言,这意味着他们不再需要被动接受闭源供应商的定价策略,而是可以根据自身需求,在内部服务器或私有云中部署和调整模型,从而实现对数据流向、访问权限和模型版本的完全掌控。
硅谷的利益重构与博弈
在公开信联署名单中,Anthropic的缺席显得格外引人注目。作为以“安全”为核心战略的领先AI公司,Anthropic长期警告开放先进模型权重可能降低网络攻击和生物研究等高风险用途的门槛。这种立场与其闭源商业模式高度一致:通过提供高安全性、高可控性的API服务来建立差异化竞争优势。
然而,对于英伟达、微软、IBM等公司而言,逻辑截然不同。英伟达通过销售GPU和AI基础设施获利,开源模型的丰富程度直接决定了下游企业的部署需求;微软需要同时经营云计算、模型API和应用产品,引入更多模型有助于降低Azure的运营成本,并增强其在Copilot等应用中的议价能力;Meta则长期依靠开放生态来维持其在全球开发者中的影响力。
近200家美国初创企业此前曾致信政府,反对全面禁止中国开源模型。他们担心,过度限制会抬高创业公司的模型成本,进一步巩固少数美国闭源巨头在市场中的垄断地位。这种利益结构的重组,使得硅谷在政策制定和技术路线上形成了新的张力。一方面,部分企业和政客担忧技术扩散带来的国家安全风险;另一方面,科技巨头和初创企业则看到了开源模型在降低成本、激发创新方面的巨大潜力。
算力市场的扩张逻辑
黄仁勋支持开源模型的深层逻辑,根植于对AI算力市场本质的理解。这符合经济学中的“杰文斯悖论”:当一种资源的使用效率提高、单位成本下降时,其总需求往往不降反升。
随着模型效率的提升,单次推理的成本降低,开发者将能够调用更多模型、运行更长时间,并将AI引入更多以前无法承担的任务场景中。黄仁勋将数据中心描述为“AI工厂”,输入电力和数据,输出Token。在这个工业化计算系统中,GPU、网络、存储和电力构成了共同的底座。无论模型公司是选择闭源API模式还是开源部署模式,训练集群、推理服务器、高速互联和软件工具链的需求都将持续增长。
开源模型尤其能够将更多中小企业带入这个市场。企业可能从一个开源模型开始试验,随后产生对云算力、模型托管、安全服务和商业解决方案的需求。随着模型进入生产环境,可靠性、延迟、并发处理和权限管理等问题将催生新的基础设施需求。黄仁勋所捍卫的,是一个模型供给更加多元、开发者数量更多、算力需求持续扩张的AI市场。
竞争转向系统能力与生态
2.8万亿参数之后,AI行业的竞争焦点正在从单纯的参数规模转向系统综合能力。混合专家架构使得总参数与实际计算量逐渐分离,模型的商业价值不再仅由参数量决定,而是由激活参数效率、训练数据质量、后训练方法、推理效率、工具使用能力以及部署成本共同决定。
下一阶段的竞争将集中在三个关键层面。首先是效率,企业核心关注的是完成特定任务所需的Token数量、调用轮次和算力消耗。其次是软件生态,围绕开放模型,开发者正在建设量化工具、推理框架、芯片适配和专业微调工具。Hugging Face已托管超过200万个公开模型,单一模型的竞争正在演变为模型家族和生态系统之间的竞争。最后是部署控制权,越来越多国家和企业希望拥有自己的模型和数据基础设施,开放权重模型因其可本地化、可修改和跨芯片兼容的特性,成为主权AI和企业私有部署的重要技术基础。
这一过程被业界称为开放模型的“Kubernetes时刻”。就像Kubernetes最初由谷歌开源并逐渐成为云计算基础设施标准一样,开放模型也可能沿着类似路径演进:模型权重成为基础层,周围生长出推理框架、云服务、硬件适配和行业应用。尽管目前模型架构、许可证和硬件平台依然高度分散,但方向已经清晰。
结语与展望
黄仁勋的表态并非单纯力挺某一特定国家的开源模型,而是对AI产业未来路径的战略选择。无论最终胜出的是美国闭源模型、中国开源模型,还是企业自行微调的行业模型,只要AI应用持续扩张,更多系统开始持续生成Token,英伟达就依然站在产业增长最稳定的环节上。
对于整个AI行业而言,开源与闭源的共存将成为常态。闭源公司将更多聚焦于产品体验、数据闭环、服务稳定性和专业场景的深度定制;而开放模型则依靠成本优势、部署控制权和生态创新扩大市场覆盖面。这种双轨并行的格局,不仅有助于降低技术门槛,激发更多创新活力,也将促使基础设施提供商不断优化服务,推动整个行业向更高效、更普惠的方向发展。在这场博弈中,技术本身的进步才是推动变革的根本力量,而产业的多元化与生态的繁荣,将是衡量AI时代成功与否的关键指标。