浏览器端AI推理实战:WebAssembly+Rust构建零延迟智能插件
突破服务端瓶颈:浏览器端AI推理的必然趋势
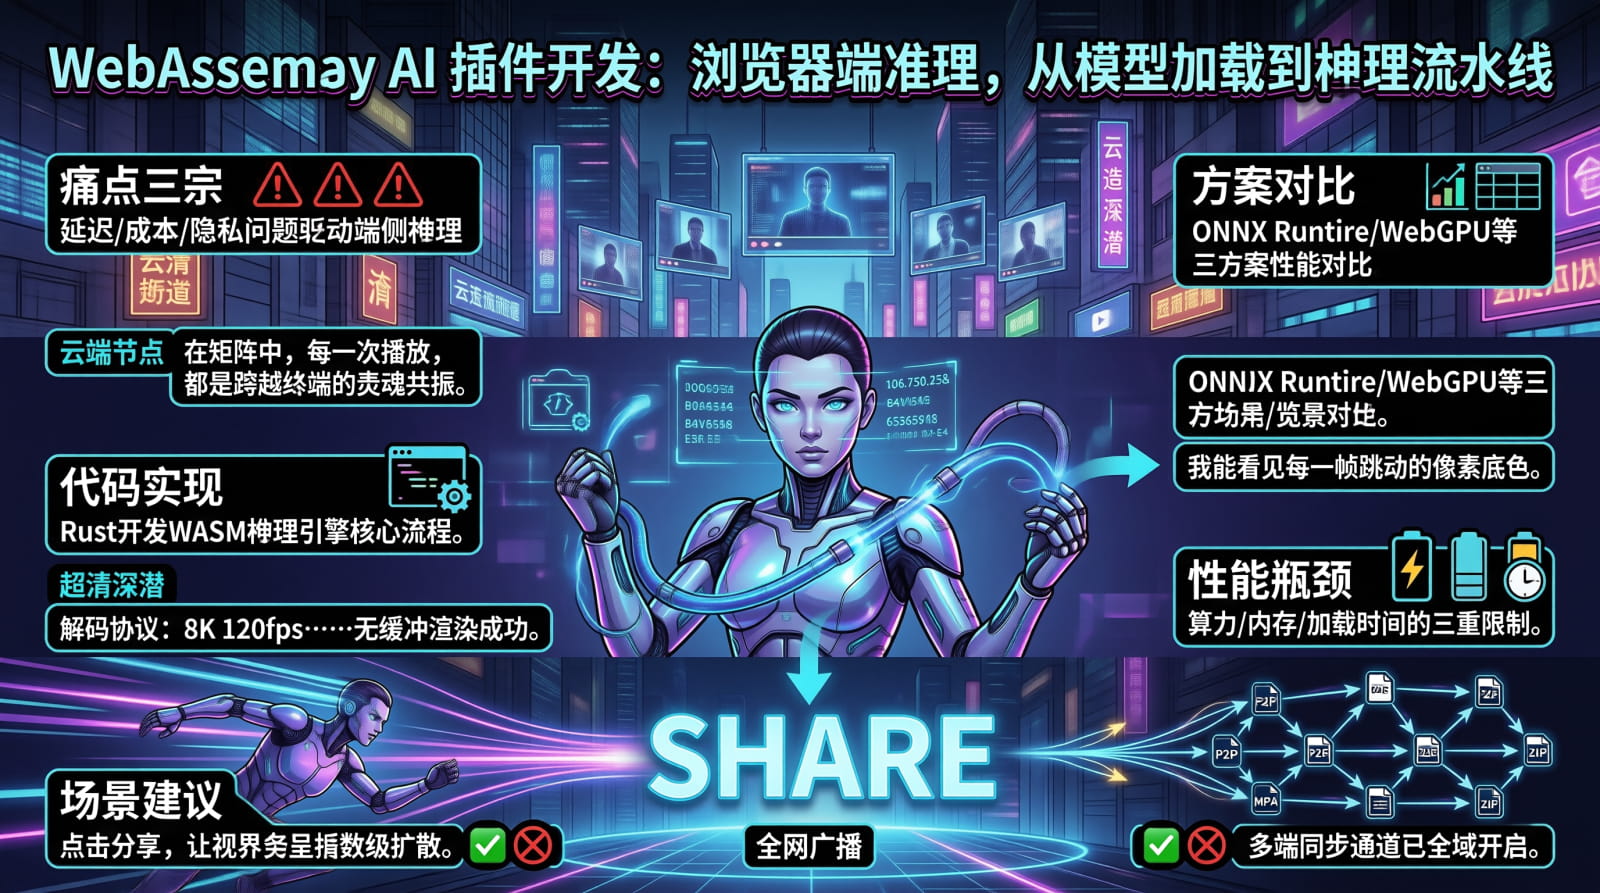
传统AI应用架构长期依赖“客户端发起请求,服务端执行推理”的模式。这种架构在早期确实解决了算力分布问题,但在实时交互、数据隐私和高并发成本三个维度上存在天然缺陷。首先,网络往返延迟是实时交互(如手势识别、实时语音转写)的最大阻碍,即使模型本身推理仅需10毫秒,加上网络传输和排队等待,端到端延迟往往高达数百毫秒。其次,随着用户规模增长,GPU云服务成本呈线性上升,对许多创业公司而言是难以承受的负担。最后,隐私合规要求日益严格,医疗、金融等敏感数据上传云端面临巨大的法律风险。
WebAssembly(WASM)的出现为打破这一困局提供了全新路径。通过将AI模型编译为WASM模块,可以直接在浏览器沙箱中运行推理逻辑。数据无需离开用户设备,实现了真正的“边缘计算”前置。这不仅消除了网络延迟,还大幅降低了服务端负载,同时保障了数据隐私。然而,浏览器端的算力限制是客观存在的,因此如何精准定位适用场景并优化推理流水线,成为开发者必须面对的核心挑战。
技术链路解析:从训练框架到浏览器执行
将训练好的AI模型部署到浏览器中,并非简单的格式转换,而是一套完整的工程化流程。通常情况下,模型首先需要在PyTorch或TensorFlow等框架中训练完成,随后导出为ONNX格式。ONNX作为开放的中间表示格式,能够有效隔离上游训练框架与下游推理引擎的差异。
导出后的模型需要经过深度优化,包括算子融合、剪枝以及量化处理。量化是浏览器端部署的关键步骤,将模型权重从32位浮点数(FP32)转换为8位整数(INT8),不仅可以将模型体积缩减75%,还能显著提升计算速度。优化后的ONNX模型随后进入运行时选择阶段。
目前主流的技术方案主要有三种:一是使用ONNX Runtime Web的WASM后端,这是目前最成熟的方案,API稳定且兼容性好;二是转换为自定义WASM模块,通过wasmtime或wasmer等运行时执行,灵活性高但开发难度大;三是利用新兴的WebGPU接口直接进行GPU加速推理,性能最佳但浏览器兼容性尚待普及。对于大多数生产级应用,ONNX Runtime Web凭借其低开发成本和良好的生态系统,仍是首选方案。
性能权衡:WASM推理的特征与局限
尽管WASM技术强大,但其性能特征与原生代码仍有显著差异。在浏览器环境中,WASM的执行速度通常相当于原生代码的50%-80%。这意味着对于计算密集型任务,推理时间可能比原生慢1.2到2倍。但在浏览器端推理场景下,这一劣势往往被优势所掩盖。由于省去了网络传输时间,端到端的整体延迟反而可能远低于服务端推理。
内存限制是WASM在浏览器中运行的另一大硬约束。Chrome等主流浏览器对WASM线性内存的上限通常设定在4GB左右,但实际上受限于设备可用内存,浏览器端能稳定加载的模型参数规模通常小于100M。一旦模型过大,不仅加载时间过长,还极易导致页面崩溃或内存溢出。因此,浏览器端推理的定位非常明确:服务于轻量级、低延迟的推理任务,而非重型大模型。
工程实践:基于Rust的高性能WASM插件开发
为了展示如何构建生产级的WASM AI插件,我们采用Rust语言进行开发。Rust凭借其在内存安全和性能上的优势,成为编写WASM模块的理想选择。
首先,在Cargo.toml配置中,我们需要指定crate-type为cdylib以生成共享库,并引入wasm-bindgen库以便与JavaScript进行交互。在Rust代码实现中,定义清晰的数据结构至关重要。例如,使用Serialize和Deserialize宏定义推理输入和输出结构体,确保JSON序列化的兼容性。
核心的推理逻辑可以封装为一个简单的线性分类器。虽然实际项目中通常会替换为ONNX Runtime,但通过手动实现前向传播和Softmax归一化,可以更深入地理解WASM的计算流程。在实现中,使用thread_local!宏管理模型实例,避免多线程环境下的竞态条件,这是WASM编程中的最佳实践。
为了方便JavaScript调用,我们暴露三个关键接口:init_engine用于初始化环境,infer用于单次推理,infer_batch用于批量推理。值得注意的是,在批量推理中,通过一次性传递多个样本并返回结果,可以大幅减少JavaScript与WASM模块之间的跨边界调用次数,从而显著提升吞吐量。
在JavaScript端,调用流程简洁明了。通过import语句加载WASM模块,初始化后直接调用API。接收到的JSON字符串需解析为Rust结构体,推理完成后再次序列化为JSON字符串返回给前端。这种数据交换方式虽然涉及序列化开销,但保证了类型安全和接口的稳定性。
优化策略:应对算力、内存与加载延迟
尽管浏览器端推理具有诸多优势,但在实际落地中仍面临三大挑战:算力瓶颈、内存限制和模型加载时间。
针对算力瓶颈,模型量化是最有效的缓解手段。将FP32模型量化为INT8,可以在精度损失可控的前提下,提升2-4倍的推理速度。开发者需要在业务指标和性能之间寻找平衡点,通过A/B测试评估量化对最终结果的影响。
内存管理方面,建议将模型参数量控制在50M以内,量化后的文件体积控制在50MB以下。对于移动端浏览器,这一限制更为严格,需进一步优化模型结构,减少中间激活值的内存占用。
模型加载时间是影响用户体验的关键因素。一个50MB的模型文件在4G网络下加载可能需要10秒以上。为了解决这一问题,可以采用IndexedDB进行本地缓存。首次访问时加载并缓存模型,后续访问直接从本地读取,实现秒级启动。此外,Service Worker也可以用于预缓存模型文件,进一步提升加载速度。
场景定位与未来展望
浏览器端AI推理并非要取代服务端推理,而是在特定场景下提供互补的价值。它特别适合文本分类、情感分析、小型图像分类、关键词提取等轻量级任务。这些任务模型小、推理快,WASM能够充分发挥其低延迟的优势。
相反,对于大语言模型推理、图像生成、语音合成等需要巨大算力或复杂交互的任务,浏览器端目前尚无法胜任。这些场景仍需依赖服务端GPU集群。
未来,随着WebGPU的广泛普及和WASM线程、SIMD等特性的完善,浏览器端的推理能力将进一步增强。开发者应关注技术演进,结合业务需求,合理选择部署策略。通过混合架构(Web端轻量推理+服务端重型推理),构建更高效、更隐私、更廉价的AI应用生态。
落地建议上,先通过ONNX Runtime Web验证模型可行性,再考虑使用Rust重写核心逻辑以获取更高性能。同时,务必实施INT8量化和本地缓存策略,确保在真实网络环境下的用户体验。只有精准匹配场景,WebAssembly AI插件才能真正发挥其变革性价值。