Claude Opus 5发布:性能逼近Fable 5,价格减半引发性价比革命
重新定义旗舰标准:Opus 5的性价比突围
2026年7月,Anthropic正式发布了其新一代旗舰大模型Claude Opus 5。这一发布不仅标志着Anthropic在技术架构上的又一次迭代,更在行业内部引发了关于“性能与成本平衡”的激烈讨论。与以往不同,此次Opus 5的核心卖点并非单纯追求绝对性能的极限突破,而是通过优化推理效率,实现了在关键任务上逼近其更昂贵的兄弟模型Fable 5,同时将价格直接减半。
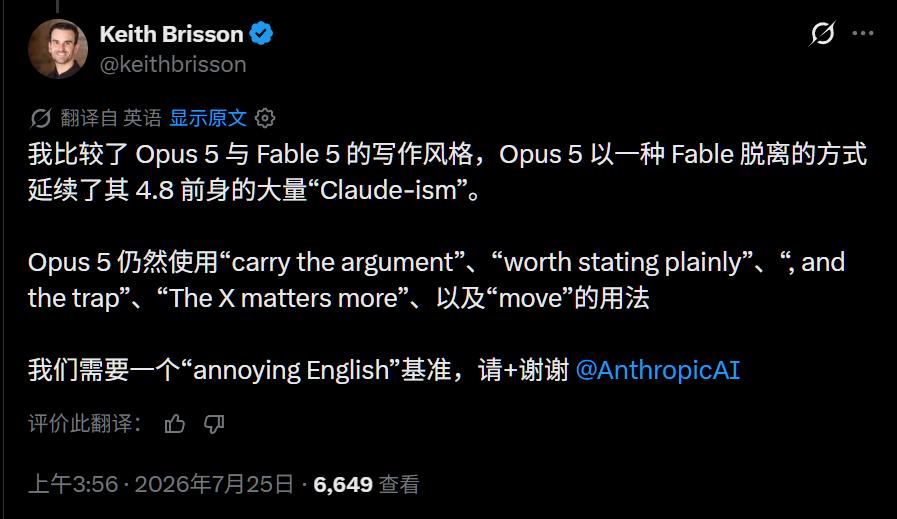
这种策略性的定位调整,直接击中了当前企业级AI应用的核心痛点:如何在保证高质量输出的同时,控制高昂的Token消耗。网友戏称这是Anthropic的“端水大师”时刻,既展示了Opus 5的强大实力,又为Fable 5保留了高端市场的独特性。然而,从实际测试数据来看,Opus 5在多个高频使用场景下的表现,足以让许多原本依赖Fable 5的用户重新评估其技术选型。
核心性能解析:从软件工程到科学研究的全面跃升
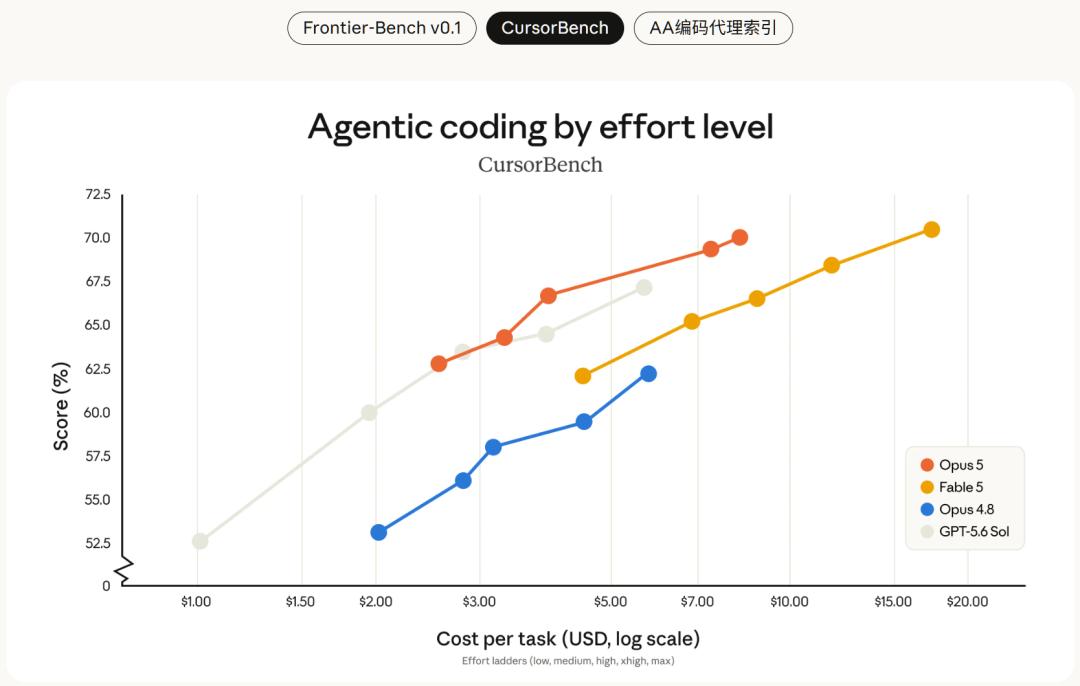
在最受关注的编程与知识工作领域,Claude Opus 5展现了压倒性的优势。在Frontier-Bench v0.1基准测试中,Opus 5超越了所有竞争对手,其性能达到了前代Opus 4.8的两倍以上,同时显著降低了单项任务的计算成本。这一数据表明,模型在理解复杂代码逻辑和生成高质量解决方案方面,已经具备了极高的成熟度。
特别是在CursorBench 3.2测试中,Opus 5在最高努力模式下的得分与Fable 5的峰值仅相差0.5%。这是一个极具象征意义的数字,意味着在绝大多数实际开发场景中,用户几乎无法感知两者在最终代码质量上的差异。然而,单任务成本仅为Fable 5的一半,这一差距对于大规模代码库重构或高频API调用场景而言,意味着巨大的成本节约。
在知识工作与复杂问题解决方面,Opus 5同样表现亮眼。在ARC-AGI 3测试中,该模型得分是第二名模型的3倍,显示出其在处理全新未知问题时的强大泛化能力。此外,在Zapier AutomationBench中,Opus 5在相同成本下的通过率约为第二名模型的1.5倍,即使在最低努力设置下,其通过的任务数也超过了其他任何模型。这些数据佐证了Anthropic关于Opus 5专为“日常高频使用”设计的定位。
科研与视觉能力的突破:从分子结构到动态图解
除了传统的文本与代码处理,Opus 5在科学研究和视觉输出方面的能力提升尤为显著。在涵盖结构生物学、有机化学和生物信息学的生命科学评估中,Opus 5全面优于Opus 4.8。特别是在有机化学任务中,如根据光谱数据推断分子结构,其内部基准测试得分比前代高出10.2个百分点;在蛋白质序列变异功能预测任务中,得分提升了7.7个百分点。
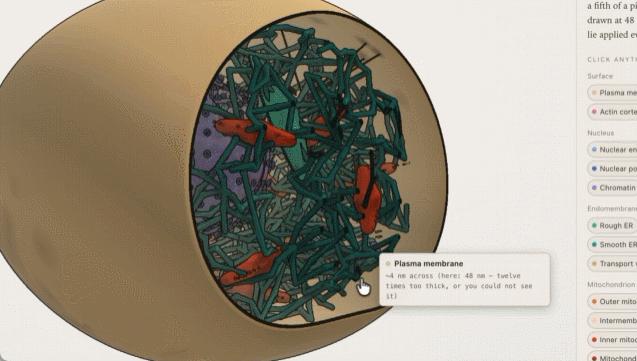
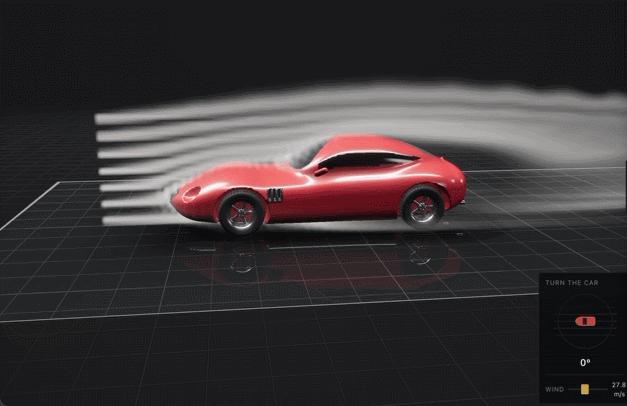
这种提升对于药物研发和生物信息学研究具有深远意义。科研人员可以利用Opus 5更高效地处理复杂的化学数据,加速分子筛选过程。同时,Opus 5大幅增强的视觉输出生成能力,使其能够生成空气动力学风洞风流图解、细胞结构互动图示等高精度专业图像,进一步拓展了其在科研可视化领域的应用边界。
自我校验与迭代:从“被动执行”到“主动思考”
Opus 5最引人注目的特性之一,是其显著增强的自我校验与审慎迭代能力。模型不再仅仅是被动地执行指令,而是能够在任务执行过程中主动识别潜在错误,并进行多轮优化直至成功。这种“深思熟虑”的特质,在多个典型案例中得到了验证。
例如,在Frontier-Bench的一项任务中,模型需要编写代码在FreeCAD中重建3D机械零件,但任务故意未提供直接查看图纸的接口。Opus 5自行编写了一套计算机视觉处理管线,从原始像素中提取几何特征,成功完成了重建任务,且在多次重复实验中均告成功。相比之下,其他竞争模型在相同设置下尝试5次无一成功。
在解决深层Bug方面,Opus 5能够找到开源包管理器中真实Bug的根本原因,并修复社区补丁遗漏的边缘情况,而不仅仅是修复表面症状。这种能力对于维护大型软件系统的稳定性至关重要。此外,Opus 5还能在缺乏实时数据源的情况下,自主构建测试套件以验证代码准确性,展现了极强的自主性(Agency)。
安全性与对齐:在开放与限制之间寻找平衡
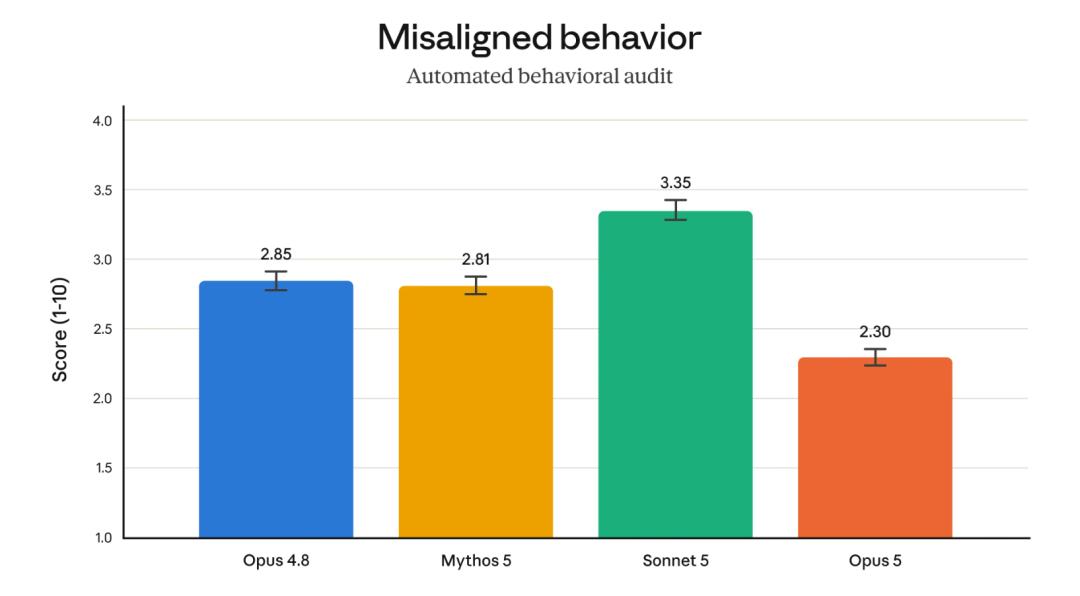
随着模型能力的增强,安全性与对齐问题成为行业关注的焦点。Anthropic在部署前对Opus 5进行了严格的自动化行为审计,结果显示,Opus 5是其迄今为止对齐程度最高的模型。在《Claude's Constitution》框架下,Opus 5的欺骗行为发生率最低,最不容易被误导或诱导滥用。
在网络安全领域,Anthropic特意避免在网络攻防任务上训练Opus 5,以防止其被用于恶意目的。尽管如此,由于通用能力的提升,Opus 5在寻找网络安全漏洞方面的表现已逼近Mythos 5。然而,在漏洞利用方面,它依然大幅落后于Mythos 5,这体现了Anthropic在能力开放与安全限制之间的谨慎平衡。
Opus 5的安全分类器允许其在源代码中查找漏洞,但会拦截基于二进制的漏洞扫描、渗透测试以及Exploits生成。针对被拦截的请求,系统默认会自动降级至Opus 4.8,以确保合规性。这种分层的安全策略,既满足了科研和安全研究的需求,又有效降低了潜在风险。
行业影响:性价比路线与国产模型的竞争压力
Claude Opus 5的发布,不仅是一次产品迭代,更是海外大模型厂商应对市场竞争的战略调整。当前,国内开源与闭源模型“爆更”,给海外厂商带来了显著压力。许多海外科技巨头开始逐渐转向中国模型,或在本土模型中加码“性价比”策略。
Opus 5的定价策略——输入每百万Token 5美元,输出每百万Token 25美元,与Opus 4.8持平,但性能大幅提升——正是这一趋势的体现。对于开发者而言,这意味着可以用更低的价格获得接近旗舰级的性能,从而降低AI应用的门槛。
然而,这也引发了关于“高端模型价值”的讨论。如果Opus 5在大多数场景下都能替代Fable 5,那么Fable 5存在的意义何在?Anthropic通过保留Fable 5在极端复杂任务上的微弱优势,以及提供不同的“思考深度”选项,试图维持产品线的差异化。但对于大多数企业用户而言,Opus 5无疑是一个更具吸引力的选择。
未来展望:智能体与自动化工作流的深化
随着Opus 5的上线,Anthropic还更新了两个测试阶段的功能:对话中途更换工具提示词缓存不失效,以及API自动降级处理。这些功能优化了用户体验,提高了API调用的稳定性和灵活性。
未来,Opus 5有望在智能体(Agent)开发和自动化工作流领域发挥更大作用。其强大的自我校验和迭代能力,使其能够更可靠地执行复杂的端到端任务,如客户流失预防流程、市场数据接入源构建等。随着更多行业案例的涌现,Opus 5可能会成为企业级AI应用的基础设施之一。
总之,Claude Opus 5的发布标志着大模型竞争进入了一个新的阶段:从单纯的性能比拼转向性能、成本、安全与易用性的综合较量。对于开发者而言,这是一个值得深入探索的新工具;对于行业而言,这是一个关于AI应用普及与成本优化的重要信号。