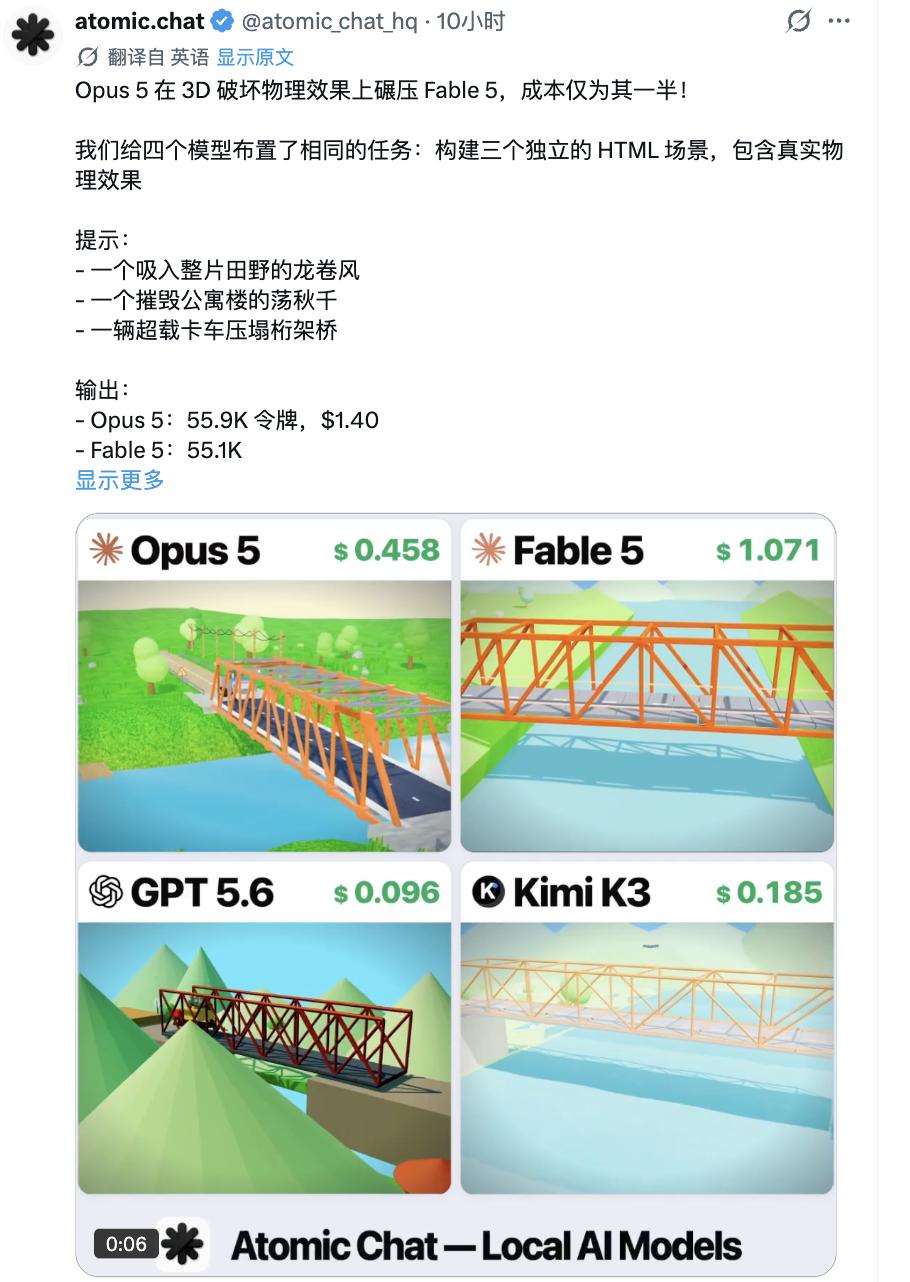
Opus 5登顶第一,还需Fable 5吗?AI模型定位重塑与性价比博弈
模型迭代加速下的新坐标:Opus 5的破局之道
进入2026年7月,大模型领域的竞争格局发生了微妙而深刻的变化。Anthropic正式推出Claude Opus 5,这一动作迅速在业界激起波澜。与过去单纯追求“绝对最强”的叙事不同,Opus 5的定位显得更为务实且充满策略性。它不再执着于在每一个单项测试中碾压所有对手,而是将重心转向了复杂任务中的步骤遗漏减少、中间结果的主动验证,以及在性能与成本之间的平衡。对于个人订阅用户而言,Opus 5已成为Claude Max的默认模型,标志着其正式进入高频日常使用的核心舞台;而对于追求极致能力的Fable 5,则更多面向API与企业级客户,个人用户虽可调用,但额度受限。
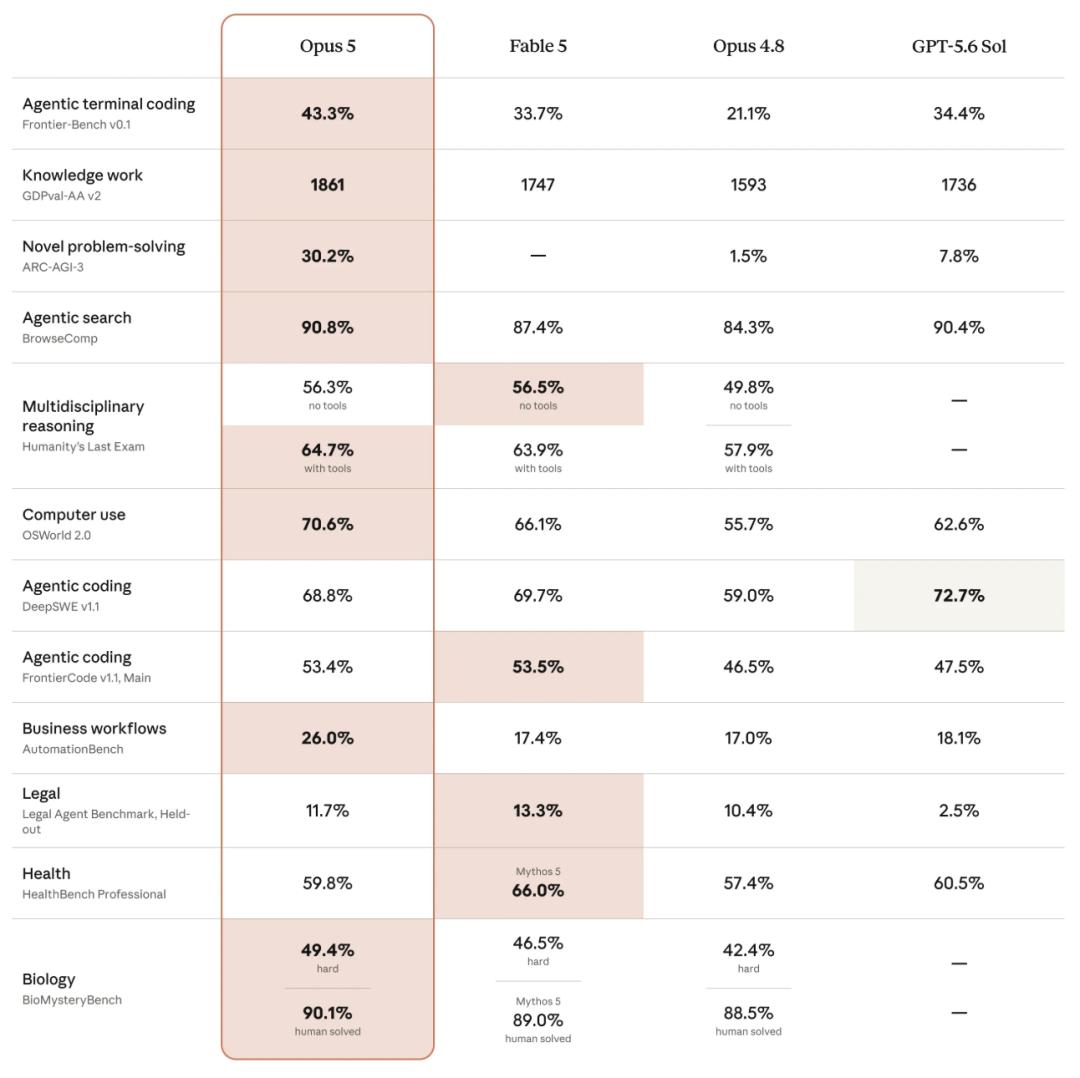
从官方披露的数据来看,Opus 5在软件工程、知识工作和智能体任务等方面的效率显著提升。在Frontier-Bench v0.1等关键测试中,其成绩不仅超越了上一代Opus 4.8,甚至在部分指标上逼近或超过了被视为能力天花板的Fable 5。然而,这种领先并非断层式的一边倒。Opus 5引入的可调节“Effort”(思考档位)机制,允许用户根据任务难度动态分配推理资源。高档位带来更强的处理能力,但伴随的是速度放缓和Token消耗的增加;低档位则追求效率与成本的最优化。这种灵活性,恰恰反映了当前AI应用从“炫技”向“落地”转型的核心需求。
榜单背后的真相:领先一分与断层优势的区别
要判断Opus 5是否足以替代Fable 5,首先必须客观审视其真实性能。在Anthropic公布的对比中,Opus 5选择了与当前最前沿的模型——包括Fable 5和OpenAI的GPT-5.6 Sol——进行直接交锋。结果呈现出一种“偏科”但极具实用价值的特征。
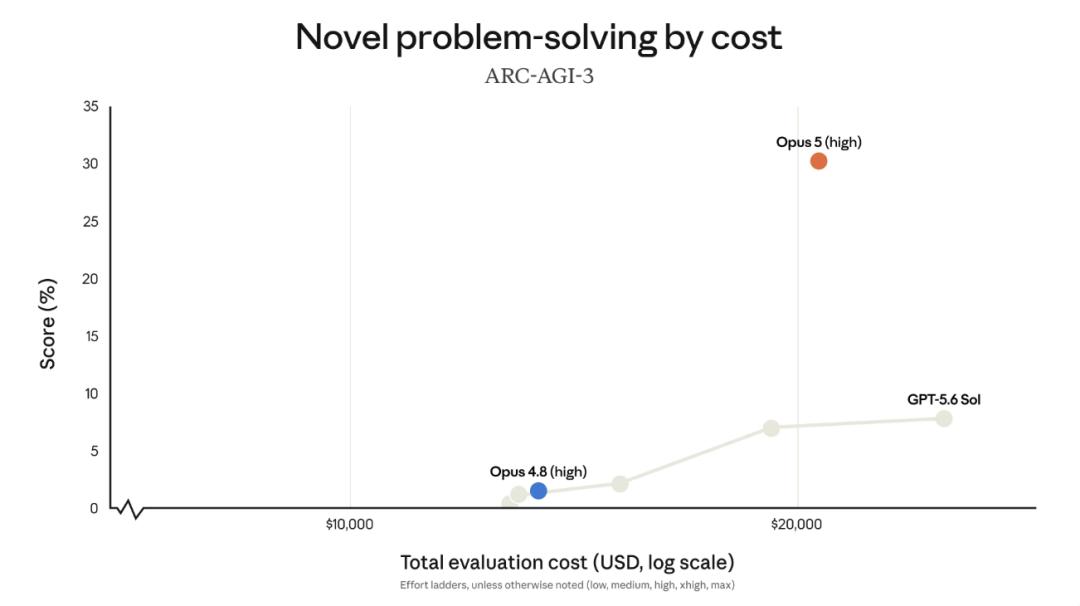
在需要多步操作、工具调用和持续纠错的场景中,Opus 5表现惊人。例如,在Zapier AutomationBench测试中,按单位任务成本计算,Opus 5的通过率是第二名Fable 5的1.5倍;在OSWorld 2.0中,它仅用不到Fable 5三分之一单项成本就超过了后者最好成绩。这些测试的核心不在于模型能否回答一道静态题目,而在于它能否像人类专家一样,规划路径、执行操作、发现错误并自我修正。这种“执行层面的成熟度”,正是Opus 5相较于前代模型最大的跃升。
然而,在纯知识推理层面,差距依然存在。在Humanity’s Last Exam测试中,若关闭工具辅助,Opus 5的得分略低于Fable 5(56.3% vs 56.5%)。这说明Fable 5在底层逻辑推理和知识储备上仍保有微弱优势。但在开放工具后,Opus 5凭借更强的搜索、调用和验证能力反超Fable 5。这一对比揭示了一个关键结论:Fable 5代表的是“纯模型能力”的上限,而Opus 5代表的是“系统执行能力”的优化。Opus 5并非在所有维度上都领先,其榜首位置更多得益于在综合智能体工作流中的稳定表现,而非单一能力的绝对统治。
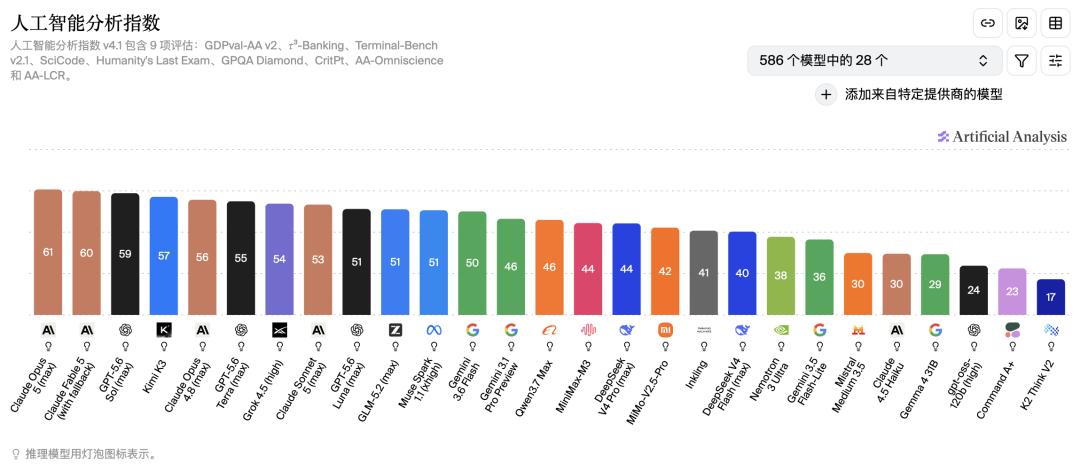
第三方榜单如Artificial Analysis的智能指数也印证了这一点。Opus 5 Max以61分位列第一,仅领先Fable 5一分。这种毫厘之间的差距,意味着在真实应用场景中,两者往往处于同一梯队。决定胜负的,不再是跑分数字,而是稳定性、Token成本控制以及最终交付的质量一致性。跑分给出了能力上限,但日常使用中的性价比,才是检验模型价值的真正试金石。
用户体验分化:从“全能天才”到“靠谱同事”
模型上线后的真实反馈,往往比官方数据更具说服力。目前,针对Opus 5的评价呈现出明显的两极分化,这实际上反映了不同用户群体对AI能力的不同期待。
正面反馈主要集中在编程原型开发和多模态内容生成上。有开发者分享,Opus 5能够快速生成包含代码、视觉效果甚至实时合成音乐的完整3D黑洞可视化器。这种快速构建产品原型的能力,对于独立开发者和创意工作者而言极具吸引力。它不仅能写出代码,还能整合资源,直接呈现可用的成果,极大地缩短了从创意到原型的周期。
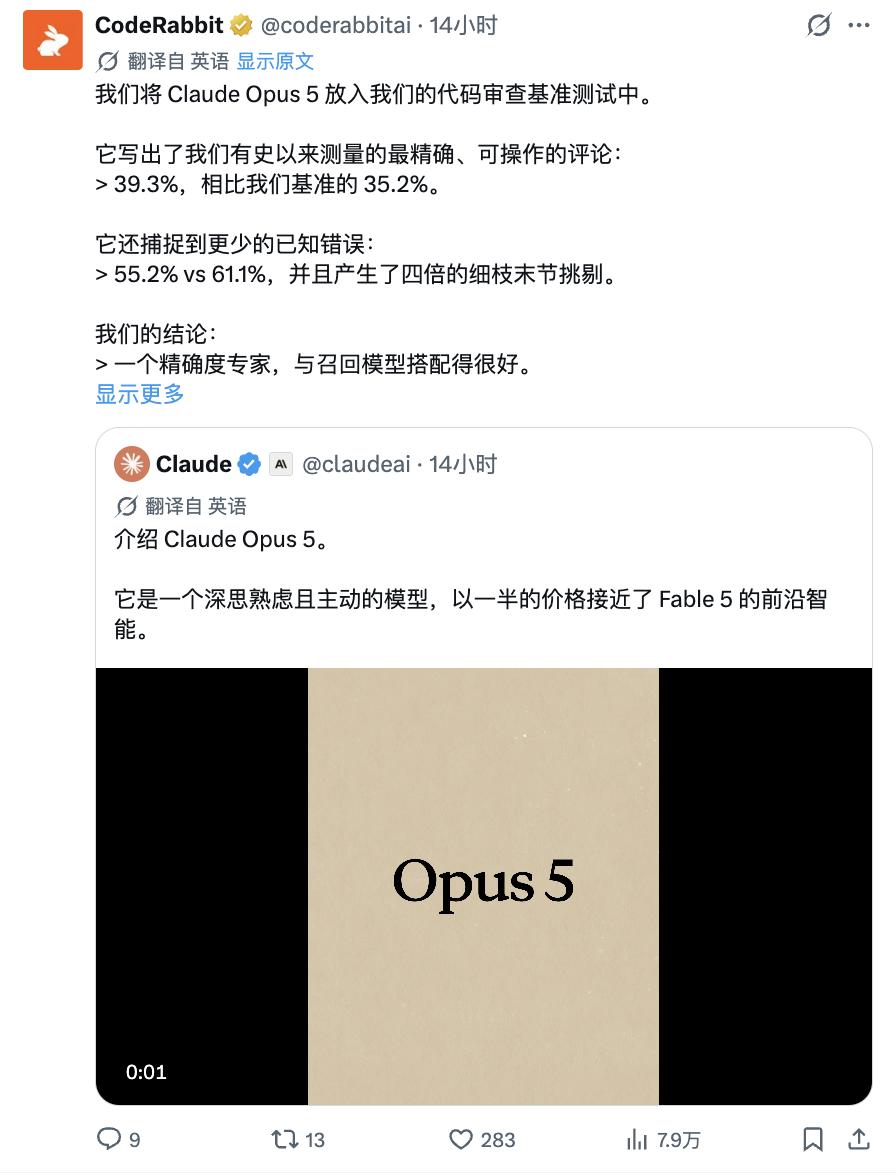
然而,负面反馈同样尖锐。部分用户指出,Opus 5在某些任务中会出现“过度思考”现象。当开启高Effort档位时,模型可能会陷入漫长的推理循环,甚至“我行我素”地偏离最初设定的目标。有测试显示,模型消耗了大量Token和上下文空间,却未严格按指令执行,导致ROI(投资回报率)低下。代码审查平台CodeRabbit的系统性测试也指出,Opus 5更适合处理开放式、设计导向的代码生成任务,但在逻辑错误、竞态条件等深层Bug的检测上,仍存在漏检风险。
资深开发者李默(化名)将Opus 5比作一位“做事靠谱但略有个性的同事”。这一比喻精准地概括了其定位:它比Opus 4.8有了质的飞跃,调试能力极强,是Fable 5额度耗尽后的理想替代者。但它并非完美无缺,原有的工作流和提示词技巧不能直接复用。用户需要重新学习模型的“性格”,调整任务拆分方式、合理设置Effort档位,并引入验证机制。这种“磨合成本”,是Opus 5在日常使用中必须面对的现实挑战。
战略重组:Anthropic的分级开放与风险控制
深入分析Opus 5的定位,必须将其置于Anthropic整体战略背景下审视。近期,Anthropic的模型更新频率惊人:5月发布Opus 4.8,6月推出Fable 5和Mythos 5,7月初上线Sonnet 5,月末又发布Opus 5。这种密集迭代背后,是公司对模型产品线清晰的重构。
行业对模型开放策略的分歧日益扩大。一方面,以月之暗面Kimi K3为代表的开源模型性能逼近前沿;另一方面,OpenAI等巨头则强调闭源与安全。Anthropic缺席了由英伟达、Meta等25家公司联合签署的呼吁开放权重的公开信,显示出其坚持闭源、分级开放和风险控制的一贯立场。此前,因安全管制,Fable 5和Mythos 5曾短暂下线,随后Fable 5恢复服务,而安全风险更高的Mythos 5仍仅限获批机构使用。
在此背景下,Opus 5的战略意义愈发清晰。它的源代码漏洞挖掘能力接近Mythos 5,但转化为实际攻击工具的能力较弱,这意味着它在保持高智能的同时,大幅降低了合规风险。对于Anthropic而言,Opus 5不仅是一款性能更强的产品,更是一个在合规框架下,能够安全、广泛地向普通用户和企业开放的“日常旗舰”。它填补了Sonnet 5(成本敏感型普遍需求)与Fable 5(极致复杂任务)之间的空白,成为开发者和管理员的首选默认模型。
与此同时,Anthropic正在大规模扩充算力基础。公司宣布将部署高达2吉瓦的AMD Instinct MI450系列GPU,并获得AMD最高50亿美元的战略投资。算力的扩张确保了Opus 5在提供接近旗舰性能的同时,能够维持相对亲民的价格(API价格约为Fable 5的一半)。这种“能力下沉、成本优化”的策略,旨在将AI的高阶能力普及化,而非仅仅服务于少数顶尖场景。
结语:互补而非替代,生态演进的必然
综上所述,Opus 5的登顶并不意味着Fable 5的退场。两者在大模型生态中扮演着截然不同却又相互补充的角色。Fable 5依然是Anthropic公开可用模型的能力天花板,负责处理那些对准确性、深度推理和长周期自主性要求极高的复杂任务,如高端科学研究、复杂战略规划等。而Opus 5的核心价值在于“普惠”与“效率”,它通过优化的执行引擎和可调节的资源分配,将接近旗舰的能力以更低的成本、更可控的风险交付给更广泛的用户群体。
对于企业和个人用户而言,选择何种模型不再是非此即彼的二元判断,而是基于任务属性的组合策略。日常编程、自动化流程、知识检索和常规内容生成,Opus 5以其高性价比和稳定性成为更优解;而在涉及高风险决策、前沿探索或极致性能需求的场景中,Fable 5依然不可或缺。Opus 5的出现,标志着AI应用从追求单一指标突破,转向构建多层次、高效率、低风险的实用化生态。在这种生态中,没有绝对的“最强”,只有“最合适”的工具。未来,随着模型迭代加速和算力成本下降,这种“分级旗舰”模式将成为行业标准,推动人工智能真正融入各行各业的日常 workflow 之中。