OpenAI连续17天异常:Agent时代宕机成本重构与架构启示
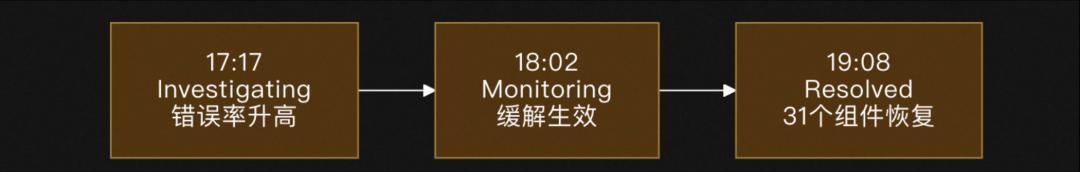
在人工智能深度嵌入企业核心业务流程的今天,基础设施的稳定性已不再仅仅是技术指标,而是直接关乎商业存续的生命线。2026年7月25日傍晚,全球AI领域的风向标OpenAI经历了一次极具警示意义的系统性震荡。其API接口、ChatGPT对话服务以及面向开发者的Codex代码生成工具同时出现大规模报错,涉及31个服务组件的性能下降。这次持续1小时51分钟的故障,并非孤立事件,而是将其推向了舆论的风口浪尖:在此之前,OpenAI已经连续17天没有出现过一天“完全正常”的服务状态。这一现象迫使我们重新审视在Agent(智能体)时代,算力基础设施的脆弱性与企业数字化架构的韧性之间的深刻矛盾。
此次故障的影响范围之广,远超以往单纯的聊天机器人卡顿。数据显示,受影响的组件中,API相关占12个,ChatGPT占15个,Codex占4个。对于普通用户而言,这可能只是几次刷新失败或响应延迟;但对于依赖API构建自动化工作流的企业来说,这意味着生产线的停摆。特别是Codex的中断,对软件开发领域造成了实质性打击。编程Agent在执行复杂任务时,往往需要长时间的上下文保持和连续推理,服务在关键节点的中断可能导致整个代码生成流程的崩溃,甚至造成数据一致性的破坏。这种“断点”效应,在传统的SaaS软件中或许可以通过重试机制缓解,但在基于概率生成的LLM(大型语言模型)工作流中,恢复成本极高,往往意味着从头再来。
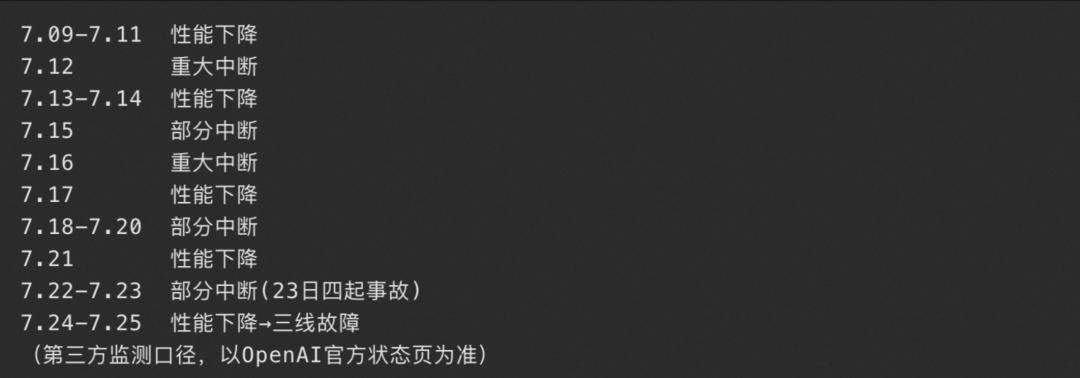
将时间轴拉长至过去一个月,OpenAI的服务状态呈现出一种令人不安的“带病上岗”常态。第三方监测平台的数据揭示了一个被官方低调处理的真相:自7月9日以来,该平台未记录到任何一天的“全绿”状态。期间不仅发生了两次重大停机事故,更多时候是在性能降级和部分中断之间反复横跳。7月23日单日四起独立事故,24日Codex Review报错,直至25日的三线齐崩,这种高频次的波动表明,其底层基础设施长期处于极限承压状态。合理的推测指向了夏季推理负载的持续爬坡与新模型发布节奏之间的失衡。随着多模态能力和长上下文窗口的普及,单次请求的计算密度呈指数级增长,而硬件扩容的速度显然未能跟上需求爆发的曲线。
在Agent时代,宕机的算法逻辑发生了根本性转变。两年前,ChatGPT的宕机主要影响的是C端用户的娱乐或辅助查询体验,损失的是用户耐心和品牌好感度。然而,当AI成为客服机器人、代码流水线、自动化审计系统的核心引擎时,服务中断直接等同于业务中断。111分钟的停机,对于一家依靠AI Agent处理每日数万订单的电商企业而言,可能意味着数百万美元的营收损失和难以估量的客户信任危机。此时,市场出现的“自动路由到健康替代模型”的服务,恰恰印证了单一供应商依赖的风险已被重新定价。多模型容灾不再是锦上添花的技术亮点,而是企业AI架构的生存标配。
面对这一现状,企业技术决策者必须重新评估SLA(服务等级协议)在选型中的权重。过去,模型能力的细微差距——如推理速度提升10%或准确率提高2个百分点——往往是决策的关键。但在高频故障的背景下,能力的边际收益远小于宕机带来的全额损失。能力差距可以按百分比计算,但宕机损失往往是100%的业务阻断。因此,构建具备弹性的AI基础设施架构,成为当务之急。这要求企业从“单点依赖”转向“多云多模型”策略,通过抽象层屏蔽底层模型的差异,实现请求的动态分发和故障自动切换。
这种架构转型并非没有挑战。首先,不同模型之间的输出格式、思维链逻辑存在差异,统一适配需要大量的工程投入。其次,数据隐私和合规性在跨云流转中面临更复杂的监管要求。然而,相较于业务停摆的风险,这些工程挑战是可以被量化和管理的。更重要的是,每次海外旗舰模型的故障,都为国产模型提供了承接溢出需求的窗口期。但这同时也提出了严峻考验:国产模型是否具备在同等高负载下保持稳定的能力?如果在承接流量高峰时自身也出现抖动,那么这种替代效应将是短暂且不可持续的。因此,提升自身基础设施的鲁棒性,是国产AI厂商抓住市场机遇的前提。
从技术演进的角度看,这次连续17天的异常状态,暴露了当前以大模型为核心的AI栈在工程化落地阶段的深层矛盾。模型训练的创新速度远远超过了推理基础设施的成熟速度。我们正处于一个“半成品工业化”的阶段,即使用尚未完全稳定化的基础设施工具来构建关键业务系统。这就要求开发者在设计Agent工作流时,必须引入更多的防御性编程思维。例如,增加本地缓存机制、设计断点续传逻辑、建立人工介入的回退通道等。这些传统软件工程中的最佳实践,在AI时代依然具有极高的价值,甚至因为AI的不确定性而变得更加重要。
此外,监控体系的升级也是应对此类风险的关键。传统的HTTP状态码监控已不足以反映LLM服务的健康程度。企业需要建立针对语义质量、响应延迟分布、Token消耗异常等多维度的监控指标。通过实时感知模型性能的微小退化,提前触发熔断或切换机制,从而将故障影响控制在最小范围。这种细粒度的可观测性,是构建高可用AI应用的基石。
值得注意的是,市场对于“解释”的需求正在发生变化。简单的“错误率升高”或“服务器维护”已无法平息企业客户的焦虑。他们需要了解故障的根本原因、预防措施的落实情况以及未来的容量规划。透明度成为信任的新货币。OpenAI工程团队后续的复盘报告,不仅是对此次事故的交代,更是行业观察基础设施演进方向的重要窗口。如果无法从根本上解决负载与容量的矛盾,类似的“带病上岗”可能会成为常态,进而加速行业向去中心化、分布式AI算力网络的演进。
综上所述,OpenAI的此次故障是一个明确的信号:AI基础设施的可靠性已成为制约Agent规模化落地的瓶颈。企业不能再将AI视为黑盒般的魔法,而应将其视为需要精心维护、具备冗余设计的复杂工程系统。通过多元化供应商策略、强化工程容错能力、升级监控体系,企业才能在享受AI红利的同时,有效规避系统性风险。对于整个行业而言,这也是从“追求模型参数规模”向“追求系统整体稳定性”转型的关键转折点。只有在稳定性得到保障的前提下,AI才能真正从实验场走向生产线,成为驱动数字经济的核心引擎。