机器人上下文扩展3数量级:RoboTTT如何实现5分钟肌肉记忆与实时自我进化
机器人智能的瓶颈:从“瞬时记忆”到“长期规划”
在具身智能(Embodied AI)的发展历程中,机器人一直面临着一个核心痛点:记忆窗口的极度狭窄。长期以来,受限于计算资源和模型架构,机器人策略模型只能处理极短的上下文窗口。这意味着,一旦环境发生微小变化或任务进入多阶段流程,机器人往往会迅速“遗忘”刚刚发生的动作和状态,导致在长程任务中频繁失误,无法像人类那样通过经验积累形成连贯的行为逻辑。
这种“金鱼记忆”极大地限制了机器人在复杂物理世界中的应用能力。尽管大语言模型(LLM)在文本领域已经实现了百万级别的上下文扩展,并在逻辑推理和长程规划上展现出惊人能力,但这一优势并未自然迁移到机器人领域。视觉传感器产生的海量数据使得上下文处理变得尤为困难,传统的方法往往只能通过压缩历史状态或引入循环神经网络来缓解,但这通常以牺牲信息完整性为代价。
然而,随着英伟达高级研究科学家Jim Fan与斯坦福大学教授李飞飞团队联合推出的RoboTTT(Test-Time-Training Robot Policies),这一僵局被打破。该研究提出了一种全新的机器人基础模型训练方案,旨在解决“上下文Scaling”这一关键问题。RoboTTT不仅仅是一个算法优化,它代表了一种范式转移:即通过让机器人在推理过程中进行“学习”,将上下文长度扩展至8K时间步,相当于5分钟的连续动作记忆。这一突破不仅超越了现有最先进策略三个数量级,更重要的是,它在保持推理延迟不变的前提下,赋予了机器人类似人类“肌肉记忆”的长期规划能力和实时自我修正能力。
核心架构解析:将测试时训练嵌入机器人基础模型
RoboTTT的核心创新在于将测试时训练(Test-Time-Training, TTT)机制深度嵌入到机器人基础模型中。与传统模型在训练阶段固化参数、推理阶段仅做前向传播不同,RoboTTT引入了“快速权重”(Fast Weights)的概念。在推理过程中,模型每接收一个时间步的传感器输入,就会执行一步梯度更新,将新的历史信息写入这些快速权重中。这些快速权重充当了模型的循环状态,使得模型能够在不增加隐藏状态大小的情况下,保留更长、更丰富的历史信息。
具体而言,RoboTTT的架构由两部分组成:视觉-语言模型(VLM)骨干网络和带有TTT层的DiT(Diffusion Transformer)动作头。VLM负责提取高维的视觉语义特征,而DiT动作头则负责生成具体的控制指令。在这一架构中,注意力层处理单个时间步内的空间信息,而TTT层则专门负责沿时间维度处理跨时间步的依赖关系。
为了提高计算效率,模型并未直接将所有的视觉-语言token输入TTT层,而是采用了一种高效的“寄存器token”(Register Tokens)机制。这些少量的token在时间维度上传递视觉-语言信息,既减少了计算负担,又保留了关键的历史线索。此外,为了确保模型在引入TTT层后仍能保留预训练模型的强大能力,研究人员设计了Tanh Gating机制。该机制对TTT的输出进行门控处理,再将其加回到注意力层的输出中,从而在增强时序建模能力的同时,防止了灾难性遗忘。
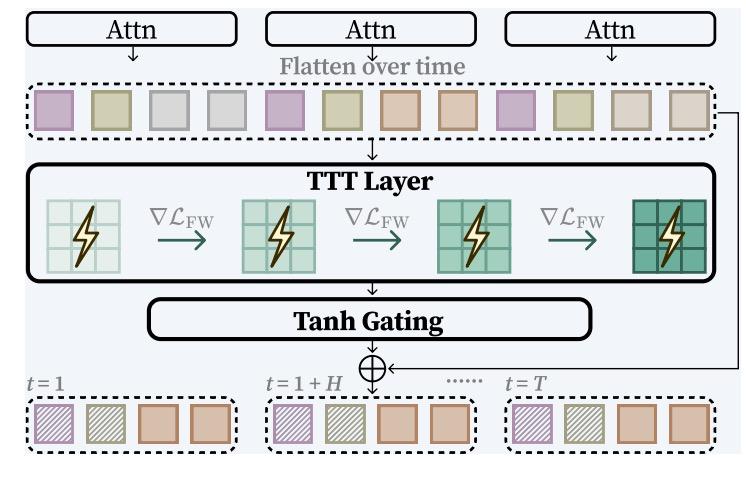
这种架构设计的精妙之处在于,它允许模型在部署后继续“学习”。每当机器人遭遇新的情境或纠正错误时,模型都会通过梯度下降更新快速权重,从而将这一经验内化为长期记忆。这种机制类似于人类的短期记忆转化为长期记忆的过程,使得机器人能够随着使用时间的增加而不断进化,实现真正的在线终身学习。
训练策略创新:序列动作强制与截断反向传播
要将上下文长度从几百步扩展到8000步,训练过程中的稳定性是一个巨大的挑战。RoboTTT团队设计了三项关键的技术创新,以确保长上下文下的有效训练:模型架构优化、序列训练策略以及长上下文约束机制。
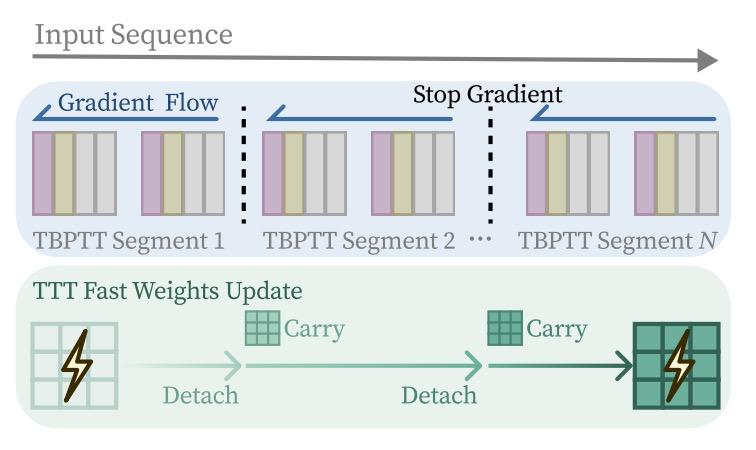
在序列训练方面,RoboTTT结合了序列动作强制(Sequence Action Forcing)和截断反向传播(Truncated Backpropagation Through Time, TBPTT)。在flow-matching训练框架下,序列动作强制为每个动作块独立采样噪声水平,这有助于稳定训练过程,防止梯度爆炸或消失。与此同时,TBPTT算法将长序列切分为较小的片段,只在片段内部进行梯度反传,但允许快速权重跨片段传递。这种方法巧妙地平衡了显存开销和时序依赖性的需求:既让TTT机制贯穿整个长序列,确保时间信息的有效流动,又将单步计算的显存占用控制在片段长度范围内,使得在消费级或常规AI硬件上训练超长上下文模型成为可能。
长上下文约束机制则是RoboTTT的另一大亮点。该机制允许模型将部分时间步仅作为上下文参考,这些时间步的信息会被写入快速权重,但不参与动作损失的计算。基于这一机制,模型可以从两类不同的上下文中汲取知识:
首先是视频模仿学习。在这个场景下,人类演示视频作为上下文输入,仅用于更新快速权重,而动作损失则在机器人自身的轨迹上计算。这意味着,测试时,机器人只需观看一段人类视频,就能将其中的操作逻辑“植入”自身,实现对未见配置的一次性模仿。
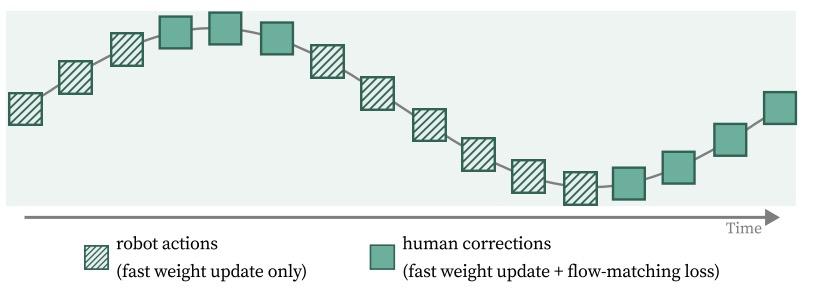
其次是DAgger(Dataset Aggregation)蒸馏技术。在传统的DAgger中,只有人类纠正的动作会被用于更新模型。而在RoboTTT中,完整的轨迹(包括次优的机器人动作和人类纠正动作)都被用于更新快速权重,但损失仅在人类纠正的动作上计算。这种设计使得模型不仅学习“什么是对的”,还学习“在犯错后如何纠正”。它将失败后的纠正方式编码到快速权重中,使机器人具备了一种隐式的纠错算法,能够在执行过程中实时调整动作,从而显著提升在复杂任务中的鲁棒性。
性能验证:长上下文带来的多维优势
研究团队在三个具有挑战性的长程双臂装配任务上对RoboTTT进行了全面评估,包括齿轮组装、玩具车组装和电路组件组装。实验结果清晰地展示了上下文长度扩展带来的多维优势,证明了“上下文即性能”的Scaling Law在机器人领域同样适用。
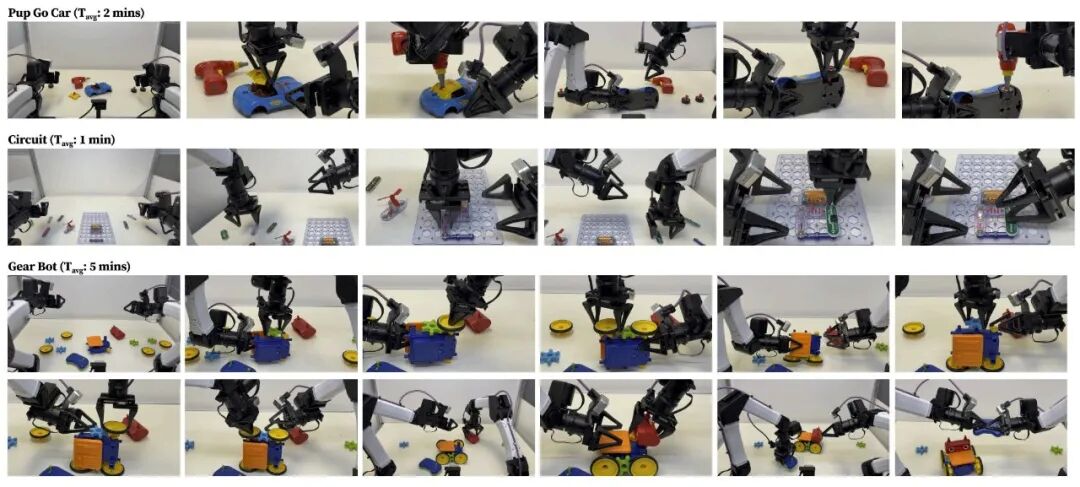
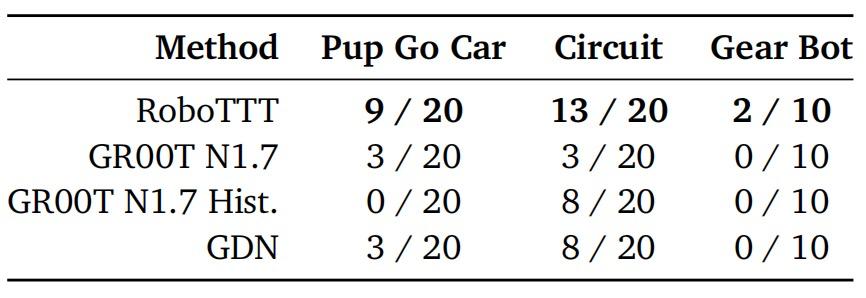
在主评估中,RoboTTT的平均任务完成分数达到79%,显著高于单步上下文基线GR00T N1.7以及将TTT层替换为Gated DeltaNet的GDN模型。特别是在平均耗时约5分钟、包含10个阶段的“齿轮机器人”任务中,RoboTTT是唯一能够完整完成任务的方法。这一结果表明,长上下文对于处理多阶段、长周期的复杂任务至关重要。
深入分析发现,简单拼接过去观测并不能可靠提升表现。例如,在Pup Go Car任务中,加入历史帧的GR00T N1.7 Hist得分反而低于只看当前观测的版本,这可能是因为短记忆窗口无法有效区分相似但不同的阶段。而RoboTTT凭借其对长期历史信息的精准捕捉,能够更好地区分当前任务阶段,在电钻未对准螺丝等细微操作失误后,能够自主重新对齐并再次尝试,展现出卓越的细粒度操作能力。
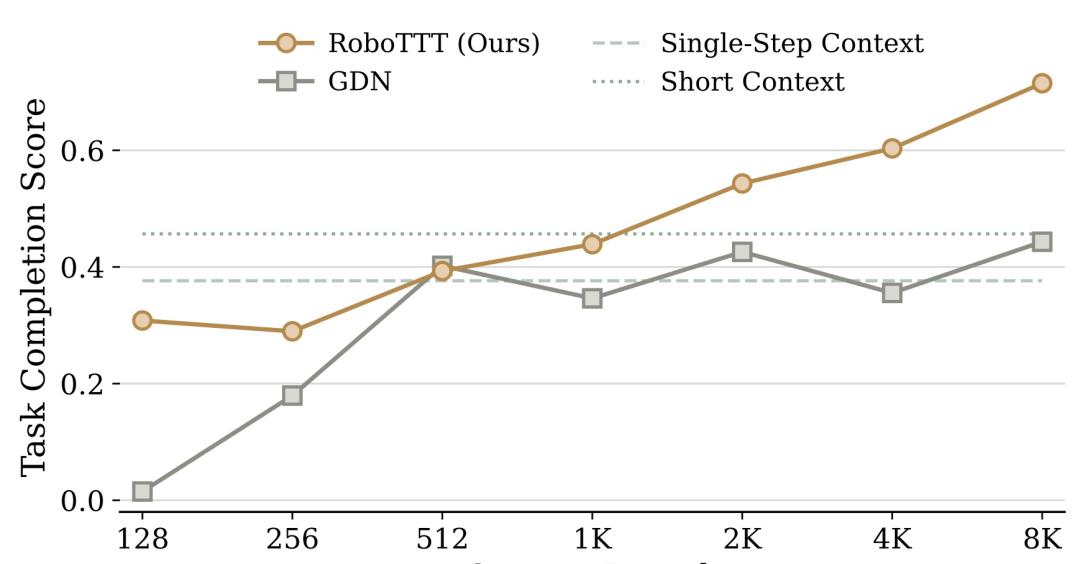
更令人瞩目的是预训练上下文长度与闭环表现之间的正相关关系。当预训练上下文从128步扩展到8K步时,RoboTTT-8K的平均任务完成分数达到71.5%,比1K版本高出63%。相比之下,使用线性关联状态的GDN模型并未表现出同样的性能提升。这一差异揭示了RoboTTT的核心优势:通过梯度下降更新快速权重,模型不仅利用了历史信息,还学习了如何初始化更新快速权重,这是一种典型的元学习能力,使其能够适应新的任务分布。
此外,RoboTTT在一次性模仿(One-shot Imitation)和扰动恢复方面也表现出色。在电路装配任务中,面对10次未见的全新配置,RoboTTT成功率高达60%,而GDN仅为33%。当人为移除已安装的部件或车顶时,RoboTTT能够根据自身的上下文记忆,判断任务进度并返回重新安装,其恢复率达到75%,远高于基线模型。这些案例充分证明,长上下文不仅提升了任务的完成率,更赋予了机器人类似人类的“常识”和“直觉”,使其能够在动态变化的环境中保持稳健的性能。
局限性与未来展望:迈向百万上下文
尽管RoboTTT取得了显著突破,但研究团队也客观地指出了其面临的挑战和未来方向。首先,扩展训练上下文长度带来了高昂的计算成本。虽然推理成本保持恒定,但训练8K甚至更长的上下文序列需要巨大的显存和算力支持。未来,研究人员需要探索更高效的TTT训练技术,如测试时训练网络(TNT)或其他稀疏更新机制,以进一步降低训练开销,使大规模训练更加可行。
其次,TTT层的目标函数仍有巨大的探索空间。当前的RoboTTT主要依赖于动作损失和梯度更新,但面向机器人的TTT层可以借鉴计算机视觉领域的最新进展,引入自监督学习、对比学习等更多样化的目标函数。这将有助于模型从更丰富的信号中学习,提升其泛化能力和感知精度。
最后,RoboTTT尚未覆盖所有可能的失败模式。目前的实验主要聚焦于装配任务,虽然表现出良好的鲁棒性,但在面对极端扰动或完全未知的物理环境时,其表现仍有待验证。未来,将RoboTTT与强化学习(RL)相结合,直接优化任务成功率,而不是仅依靠模仿学习,有望进一步提升机器人在真实世界中的执行表现。
Jim Fan曾在社交媒体上预言:“很快,即使是100万上下文,也不再是幻想。”RoboTTT的成功不仅验证了这一愿景的可行性,更为机器人基础模型指明了新的Scaling方向。随着上下文长度的不断扩展,机器人将不再仅仅是执行预设指令的工具,而是能够通过长期记忆、实时学习和自我修正,逐渐演变为具备高度自主性和智能性的合作伙伴。这一技术的成熟,将极大地推动具身智能从实验室走向家庭、工厂和更多日常场景,开启人机协作的新篇章。
结语
RoboTTT的出现,标志着机器人智能从“瞬时反应”向“长期记忆”迈出了关键一步。通过将测试时训练机制引入机器人基础模型,研究团队成功解决了长上下文建模的难题,证明了上下文长度是驱动机器人性能提升的关键维度。虽然仍面临训练成本和技术优化的挑战,但这一方向无疑为具身智能的未来发展提供了强有力的理论支撑和技术路径。随着技术的不断进步,我们可以期待看到更多具备“肌肉记忆”和“自我进化”能力的机器人,在复杂的物理世界中游刃有余,为人类带来更高效、更智能的服务。