2026算力变局:超节点为何成主流?路线分歧与交付挑战解析
算力密度的重新定义:超节点时代的到来
2026年下半年的AI算力市场,呈现出一种罕见的共识与分歧并存的局面。当所有目光仍聚焦于单一芯片性能的迭代时,算力基础设施的核心战场已悄然转移至“超节点”(Super Node)架构。这并非简单的硬件堆砌,而是一次对传统服务器集群范式的根本性重构。正如一位资深算力从业者所言:“虽然超节点整机价格高于同等卡数的普通服务器,但它的账算得过来。”这句看似矛盾的评价,揭示了行业对“算力密度”与“空间效率”的全新理解。
在过去,构建大规模算力集群往往依赖于成千上万台独立服务器的网络连接。这种架构面临着显著的通信瓶颈:跨机器的数据交换带宽受限、延迟高昂,导致GPU利用率常常不足60%。超节点通过高速互联技术,将大量GPU或加速卡从物理上的多台服务器,深度整合为逻辑上的一台“超级计算机”。这种Scale-up(纵向扩展)的方式,极大地缩短了芯片间通信距离,降低了延迟,从而大幅提升了单位Token的训练与推理效率。
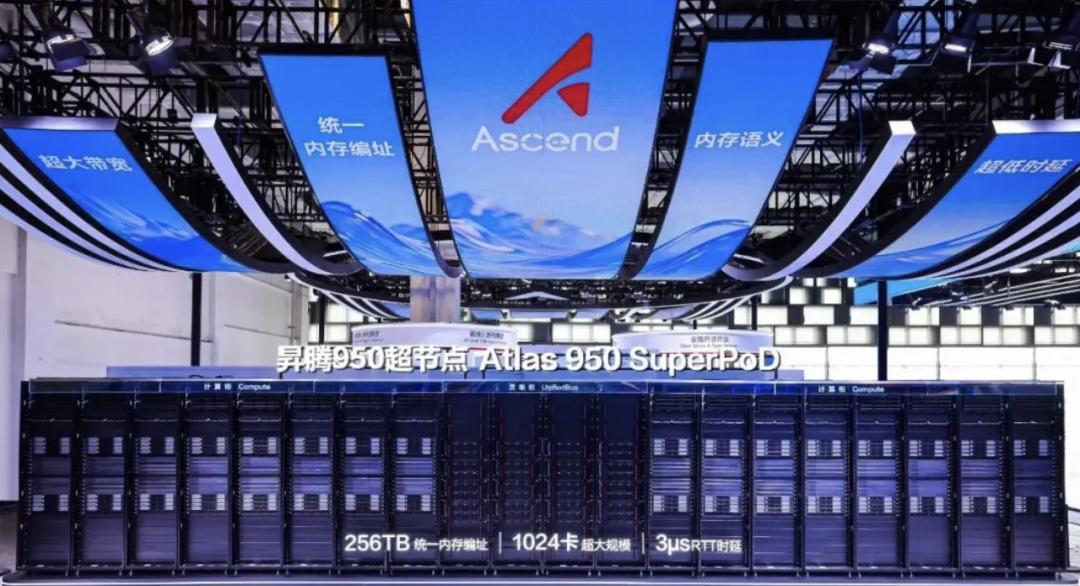
在2026世界人工智能大会上,这一趋势得到了直观印证。华为展示的由20个机柜组成的1024卡昇腾950超节点真机,中科曙光展示的640卡浸没式液冷超节点,以及百度、阿里云、浪潮信息等头部厂商的集中亮相,标志着超节点已从少数厂商的旗舰展示品,演变为行业基础设施建设的标准配置。百度昆仑芯人士指出,到今年底,国内主流算力企业基本都将具备超节点的批量交付能力。这种从“可用”到“好用”再到“必用”的转变,预示着AI Infra建设进入了一个新的存量博弈与增量创新并存的阶段。
爆发逻辑:需求、成本与工程的三重共振
超节点在2026年迎来爆发,并非偶然,而是模型演进、经济账本与技术成熟度三者共振的结果。
首先,大模型参数的指数级增长对硬件提出了硬性约束。Kimi等最新发布的万亿参数大模型,其训练与推理需求已远超传统集群的承载能力。业界普遍测算,训练一个万亿参数模型需约5000张卡,而3万亿参数模型则需万卡规模。更重要的是,随着Agent(智能体)应用的普及,推理场景下的上下文长度和并发调用次数呈几何级数增长。华为内部数据显示,AI Coding场景中一次任务触发的操作调用可达几万次,复杂长程任务甚至高达百万次。这种海量并发对内存池的大小和一致性提出了极高要求,超节点提供的大内存池特性恰好解决了这一痛点。
其次,总体拥有成本(TCO)的计算逻辑发生了根本变化。传统视角下,超节点的单卡成本似乎更高,但若引入基础设施综合考量,情况则截然不同。超节点的高度集成化意味着更少的机架占用、更低的数据中心空间需求,以及更高效的散热与供电管理。浪潮信息副总裁赵帅曾指出,通过超节点实现的性能提升若达10倍,耗电可能仅提升2倍,这种能效比使得企业在长期运营中更具优势。此外,超节点通过减少通信损耗,将传统集群中“10台机器算力相加仅等于6”的效率损失降至最低,从而在单位算力成本上实现了优化。
最后,工程化能力的成熟打破了规模化落地的壁垒。超节点并非单一芯片的突破,而是涉及芯片、存储、通信、交换、散热、供电及软件栈的系统工程。过去,只有少数巨头有能力整合这些复杂模块。如今,随着国内产业链的完善,头部厂商已具备将设计转化为可批量交付整机的能力。无论是华为的8192卡理论上限,还是百度的全栈自研演进,都表明超节点已从实验室走向生产线。
路线博弈:规模之争与生态之辨
尽管超节点成为共识,但“如何造超节点”的路线分歧日益明显,形成了三股主要势力。
第一派以华为、中科曙光和百度为代表,致力于构建“大节点”。华为展示千卡甚至万卡级超节点,认为万亿参数大模型和大规模多智能体并发需要巨大的统一内存池和算力域。百度天池超节点也从256卡向512卡演进,强调全栈自研以支撑混合云部署。中科曙光则通过浸没式液冷技术,在640卡的高密度部署中寻求极致能效,其十万卡集群已在全国超算互联网中满负荷运行。
第二派以阿里云、浪潮信息和沐曦为代表,强调“部署效率与经济性”。阿里灵骏真武M890以64卡为Scale-up单元,通过Scale-out网络扩展,并将此形态直接融入公共云服务,降低了客户门槛。浪潮信息推出32卡乃至64卡超节点,旨在让中小企业也能负担得起万亿参数模型的推理能力。沐曦同样以64卡为基础,强调对CUDA生态的兼容及横向扩展能力,试图在生态壁垒与硬件性能间寻找平衡。
第三派则试图跳出传统GPU与华为加速卡的既定框架,走“架构创新”路线。清微智能采用可重构数据流架构,芯片间直连无交换机,已交付4096卡超节点;东方算芯也推出了类似产品。这种架构旨在从物理层面消除通信瓶颈,为超节点带来全新的性能定义。
在规模之争中,“小节点派”认为64至128卡是最经济且稳定的形态,因为更大的Scale-up会带来不可忽视的通信延迟,尤其在训练并行策略中,几微秒的延迟可能导致GPU空等。而“大节点派”则坚持认为,在Agent时代,小节点的内存池已成为瓶颈,必须依靠更大规模的超节点来支撑复杂推理与训练。这场争论尚无定论,取决于不同企业对未来模型形态与应用场景的预判。
深层挑战:交付能力与供应链韧性
在激烈的路线竞争中,一个冷峻的现实是:超节点的价值最终体现在“稳定运行”与“批量交付”上。正如业内所言,现在比拼的不再是概念验证,而是能否在真实业务场景中,持续降低每Token成本。
硬件选型上的分歧也反映了供应链与技术路线的不确定性。液冷方面,风冷与浸没式液冷的选择涉及初期投入与长期运维成本的权衡;互联方面,铜缆与光纤的应用取决于带宽需求与距离限制。这些技术细节的每一个选择,都伴随着故障率、兼容性与供应链响应的挑战。
更为深远的影响来自软件生态。CUDA兼容性问题依然是国内厂商必须面对的鸿沟。阿里、沐曦等选择兼容路线以降低迁移成本,而华为等自研生态路线则追求长期的可控性与演进空间。有观点认为,随着Agentic Coding的兴起,人类直接编写CUDA代码的需求可能下降,CUDA的历史地位或将动摇。然而,短期内,生态兼容性仍是影响超节点商业落地速度的关键因素。
2026年的超节点竞赛,不仅是硬件性能的较量,更是供应链韧性、系统工程能力与生态构建能力的综合比拼。随着更多厂商进入这一赛道,真正的淘汰赛才刚刚开始。对于那些能够锁定优质供应链、实现稳定批量交付,并深刻理解模型与硬件协同优化规律的企业,将在未来的AI基础设施版图中占据核心地位。超节点,正成为这条漫长且不可逆的算力进化链上,最为坚实的一块基石。