从ECCV顶会到生产落地:360AI如何以精准可控重构工作流?
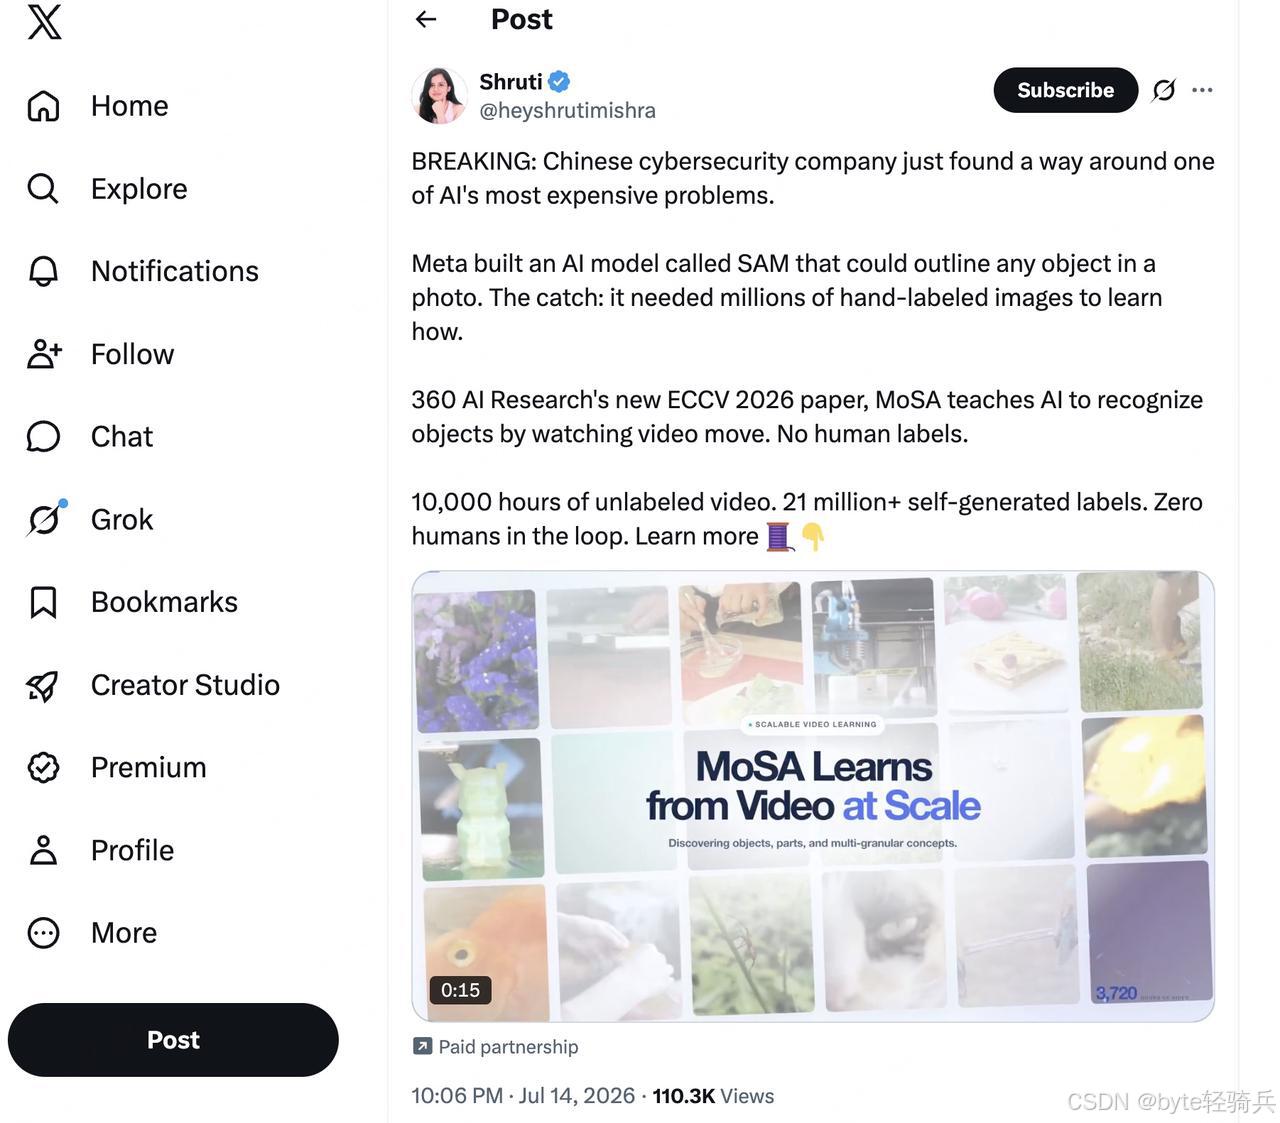
随着ECCV 2026论文录用结果的公布,学术界与产业界再次将目光聚焦于计算机视觉领域的最新突破。其中,360人工智能研究院提出的MoSA(Motion-Grounded Segment Anything)模型引发了海外技术圈的广泛热议。该模型创新性地提出无需人工标注,仅通过观察视频中的运动规律,即可让AI自主建立“物体”概念。这一无监督视觉基础模型路线,不仅刷新了行业对分割模型的认知边界,更提出了一个极具现实意义的命题:这些顶会级的学术创新,究竟能否跨越“象牙塔”,真正解决设计师、运营及开发人员在日常工作中的真实痛点?
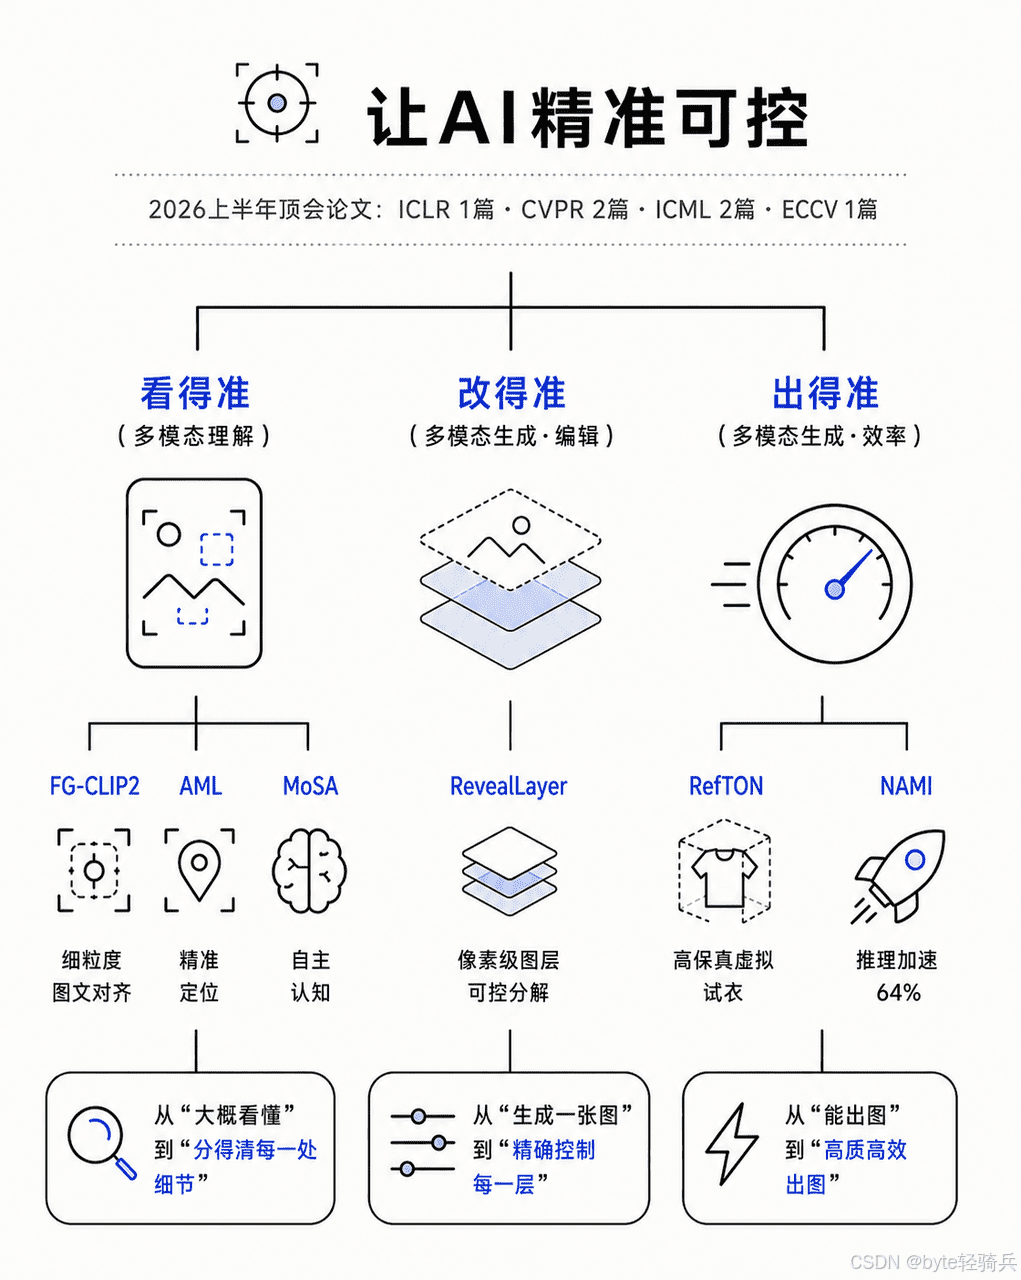
跳出纯学术视角的局限,深入梳理360AI在2026年上半年的技术布局会发现,MoSA仅是其庞大技术生态的一角。在此期间,360人工智能研究院在ICLR、CVPR、ICML、ECCV四大AI顶会上一举斩获6篇论文,研究覆盖多模态理解与多模态生成两大核心方向。更值得关注的是,其核心能力并未止步于论文PDF中的理论推导,而是迅速转化为具有商业价值的产品能力。以RevealLayer图层分解、FG-CLIP 2细粒度检索为代表的技术,不仅已上线SaaS平台,更深度嵌入360云盘、企业知识库等成熟产品中。本文旨在通过实际产品体验与行业分析,探讨以“精准可控”为核心的AI工具路线,如何重塑真实工作流。
拆解视觉元素:RevealLayer如何实现秒级图层编辑
对于设计师、电商运营及内容创作者而言,商业图片的拆解是一项耗时且枯燥的高强度工作。在传统工作流中,将一张成品图拆解为可编辑的分层素材,往往需要借助Photoshop等工具,通过钢笔工具精细勾勒边缘、修补被遮挡的背景区域、处理透明过渡效果。即便面对简单的静物图,这一过程也需耗时十余分钟;若涉及复杂场景或光影遮挡,耗时甚至可达数小时。更令人头疼的是,当需要修改局部元素时,由于图层粘连,往往不得不重新设计,效率极低。
现有的AI抠图或对象移除工具虽然能缓解部分压力,但普遍存在两大局限:一是仅支持“前景/背景”的二元拆分,无法实现多独立对象的按需提取;二是对遮挡场景处理粗糙,移除物体后背景常出现断层或残影,难以直接复用。
RevealLayer的问世,旨在解决这一核心痛点。它并非简单的图像分割,而是一套基于“遮挡感知”的图层分解框架。通过区域感知注意力机制(Region-Aware Attention)与遮挡引导适配器(Occlusion-Guided Adapter),该模型能够深入理解图像中的前景、背景及遮挡层级关系。在分离目标对象的同时,模型利用上下文推理能力,自动补全被遮挡的背景区域,生成自然完整的背景层。
在实际测试中,这一技术展现了极高的实用性。在电商商品修图场景中,框选珍珠项链即可提取边缘干净的独立图层,同时被遮挡的礼盒纹理与背景布褶皱也被自然复原,后续更换背景或调整光影无需重新修图。在AI生成图的二次编辑中,将AI海报拆分为文字、装饰、主体等独立图层后,可直接导入PS进行精细化调整,避免了反复生成提示词的低效循环。此外,在视频帧去穿帮应用中,拆分后直接删除前景层,其背景还原度也远超传统抹除工具。
支撑这一能力的背后,是团队构建的百万级自然场景多图层数据集RevealLayer-100K。该数据集覆盖了复杂遮挡、透明物体、阴影反射等高难度真实场景,使得用户无需精细的Mask标注,仅通过简单的框选即可获得PS级的分层结果,大幅降低了专业图像处理的技术门槛。
视觉理解升级:FG-CLIP 2重塑细粒度检索精度
如果说RevealLayer解决了生成与编辑环节的精准性问题,那么FG-CLIP 2则攻克了视觉理解层面的“精度瓶颈”。在许多用户的日常体验中,面对海量素材库,传统检索工具往往只能提供粗略匹配。例如,在云盘中搜索“塑料杯”,可能返回数百张结果,用户仍需手动翻阅以区分材质、图案或颜色差异。在企业知识库中,关键词匹配也常因语义差异导致漏检,严重影响信息获取效率。
传统CLIP类模型主要解决图文整体的语义对应问题,但在细粒度属性区分上存在天然局限。同样是杯子,塑料与玻璃的质感、条纹与格子的图案、浅黄与米白的色号,这些细微差异极易被忽略。FG-CLIP 2的核心突破,在于将图文对齐的粒度从“整体类别”下沉至“细节属性”。
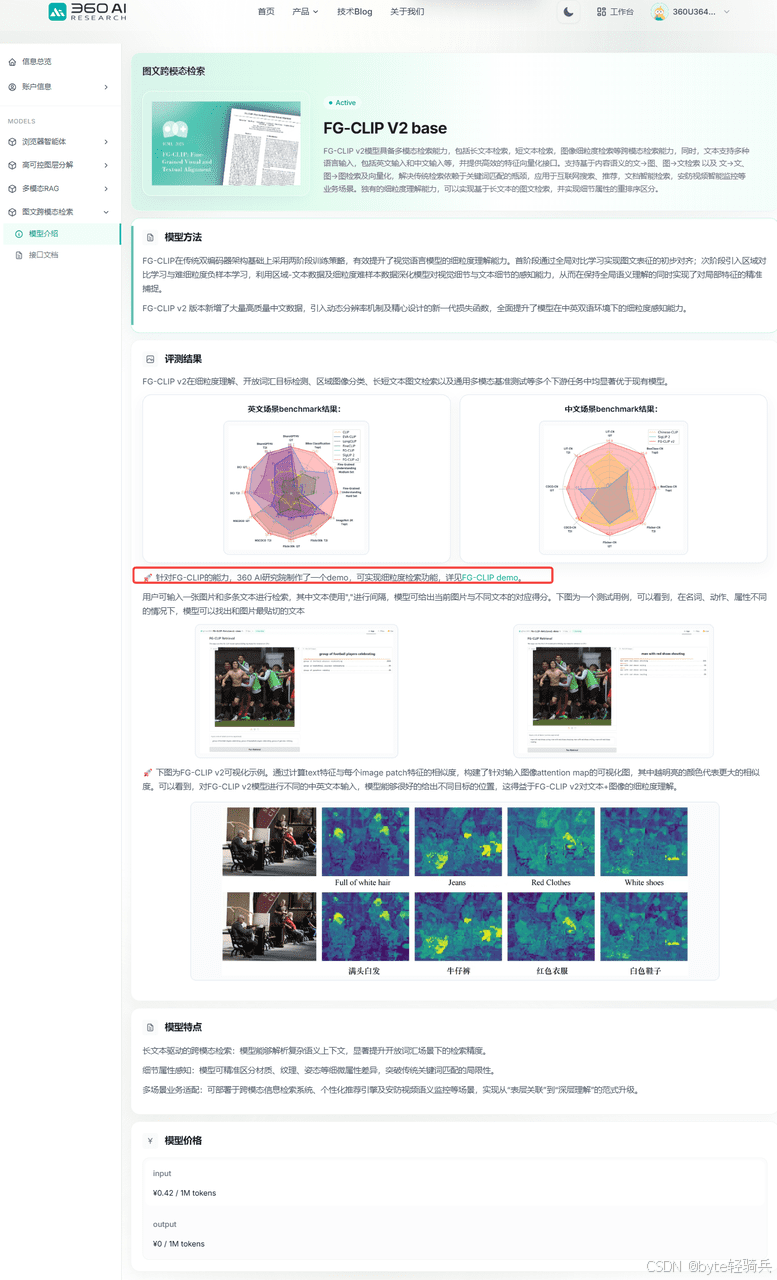
实测数据显示,FG-CLIP 2在处理高相似度样本时表现出色。当输入“带穿孔图案的淡粉色塑料杯”或“带格子图案的深棕色塑料杯”等复杂描述时,模型能精准命中目标,有效区分材质、图案与颜色,甚至能敏锐捕捉“塑料”与“纸杯”的质感差异。此外,该模型对长文本描述及中英文双语检索均有良好支持,为跨境内容团队及多语言素材库管理提供了有力支撑。
在产品落地层面,FG-CLIP 2已深度融入360AI云盘与企业知识库。个人用户可通过自然语言描述快速定位文件,摆脱了对文件名的依赖;企业用户则借助其跨模态检索能力,在图片、文档、PPT及视频封面中实现精准查找,解决了内部资料分散的顽疾。对于开发者而言,标准化的SaaS接口使得该能力可快速接入自有产品,应用于图文检索、内容推荐及安防视频分析等场景,无需从零训练即可获取顶级细粒度理解能力。
构建技术闭环:从多模态理解到可控生成的全链路布局
RevealLayer与FG-CLIP 2仅是360AI技术版图的两个切片。纵观上半年6篇顶会论文,可以看出其研究并非零散的单点突破,而是围绕“精准、可控、可靠”构建了一条完整的技术闭环。
在多模态理解侧,技术路线呈现逐层递进的矩阵特征。FG-CLIP 2(ICML 2026)解决了“看懂细节”的基础问题;AML(ICLR 2026)则进一步聚焦Agent的视觉Grounding能力,使AI能精准定位GUI界面元素或场景对象,为自动化办公与智能体交互提供核心感知支持;而MoSA(ECCV 2026)则指向了“自主认知”的终极目标,通过无标注视频中的运动信息学习物体概念,开辟了开放世界Agent视觉基础模型的新路径。
在多模态生成侧,技术攻关同样指向生产力的实质性提升。NAMI(CVPR 2026)通过桥接渐进式Rectified Flow架构,在保证画质的前提下将1024×1024图像的推理时间降低64%,破解了高分辨率生成“效果好就慢”的效率困境。RefTON(CVPR 2026)针对虚拟试衣场景,仅凭人物图与服装图即可生成高保真试穿效果,并能还原蕾丝、透明面料等精细设计。结合RevealLayer,这一链路实现了从生成效率提升、垂直场景高保真生成,到生成后可控编辑的完整闭环。
行业反思:AI工具下半场的核心竞争力
体验完上述落地产品,一个明显的行业趋势浮出水面:AI行业的竞争焦点正从“炫技”转向“实用”。当前市场上不乏能生成精美图像或流畅对话的模型,但真正能嵌入工作流、解决具体痛点、具备稳定可靠性的工具依然稀缺。
许多AI产品的开发逻辑是“拥有大模型后寻找应用场景”,导致功能设计往往重于实用价值。相比之下,360的技术路线遵循相反的逻辑:先识别真实场景中的普遍痛点,如拆图效率低、检索不精准、生成不可控、定位不稳定,再针对性地投入顶尖科研力量逐一击破。这种策略与360的安全公司基因密切相关。作为安全领域的长期深耕者,团队天然关注鲁棒性、抗干扰性及复杂环境下的可靠性,不愿为追求演示效果而牺牲稳定性。
在Agent时代与产业AI普及的背景下,这种特质显得尤为重要。Agent的本质是执行具体操作的生产力单元,而非聊天解闷的伙伴;产业AI的价值在于嵌入生产流程以提效降本,而非生成装饰性壁纸。当AI技术从“尝鲜阶段”迈入“实用阶段”,“精准、可控、可靠”将取代“参数规模”与“视觉冲击力”,成为衡量工具价值的核心指标。
从ECCV的前沿理论探索,到开箱即用的SaaS工具,再到嵌入云盘与知识库的底层能力,360的AI研究展示了一条清晰的“研究问题-模型能力-产品场景”转化路径。MoSA代表了视觉认知自主化的未来方向,而RevealLayer与FG-CLIP 2等落地成果,则正在将“精准可控的AI”转化为日常可用的生产力工具。对于开发者与行业从业者而言,这种扎根具体场景、解决真实问题的技术路线,或许比单纯的参数竞赛更具长远价值。毕竟,AI技术的终极意义,在于其能否切实提升工作效率,为现实世界的问题提供高效解决方案。