OpenAI连续17天异常:Agent时代宕机成本重构与架构启示
基础设施的临界点:从偶发故障到常态化波动
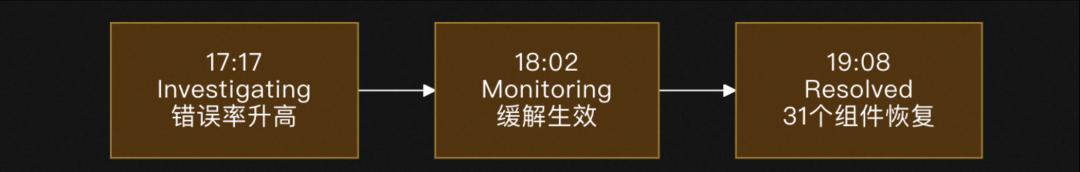
2026年7月25日的傍晚,全球人工智能领域的神经中枢经历了一次剧烈的震颤。OpenAI官方状态页显示,其核心服务体系——包括API接口、ChatGPT交互界面以及面向开发者的Codex代码生成工具——同时陷入瘫痪。这次事故并非短暂的闪断,而是持续了1小时51分钟的深度服务降级,涉及31个关键服务组件的性能大幅下滑。对于普通用户而言,这或许只是聊天机器人响应迟缓或代码补全失败的小插曲;但对于深度嵌入AI工作流的企业而言,这是一次严重的生产中断。
更令人警觉的是,这次“三线齐崩”并非孤立事件。回溯过去半个月的数据,第三方监测平台Bifrost的记录揭示了一个严峻的事实:自7月9日起,OpenAI没有一天处于“完全正常”的健康状态。在这17天内,系统经历了两次重大停机(Major Outage),其余时间则在部分中断(Partial Outage)和性能降级(Degraded Performance)之间反复横跳。这种高频次的波动表明,全球顶尖的AI基础设施正逼近其物理与工程设计的极限。夏季推理负载的持续爬坡,叠加新模型迭代带来的算力挤兑,使得底层集群长期处于压线运行状态。当冗余空间被压缩至零,任何微小的流量尖峰或内部配置变更都可能引发蝴蝶效应,导致系统性崩溃。
Agent时代的宕机账单:从体验损失到生产断裂
两年前,当ChatGPT首次出现大规模宕机时,公众的讨论焦点主要集中在“无法聊天”的体验缺失上。然而,到了2026年,AI的角色已经发生了根本性转变。它不再仅仅是一个问答助手,而是成为了企业数字员工的核心大脑。API背后连接的是自动化的客服系统、实时的代码流水线、金融审计流程以及复杂的Agent工作流。在这种语境下,111分钟的服务中断,意味着数以万计的自动化任务被强行切断,数据一致性面临挑战,甚至可能导致正在执行的关键业务逻辑整体烂尾。
以Codex为例,作为编程Agent的核心引擎,其稳定性直接决定了软件开发的效率。当服务在执行长周期代码生成或重构任务时突然中断,开发者不仅失去了当前的进度,还需要花费大量时间进行上下文恢复和错误排查。这种隐性成本远超订阅费用的损失。对于依赖AI进行实时决策的行业,如高频交易辅助或医疗诊断支持,宕机带来的风险更是不可估量。市场对此的反应极为敏锐,监测页面下方出现的“自动路由到健康替代模型”的广告语,恰恰印证了这一趋势:多模型容灾已经从一种高级架构选项,变成了一门刚需生意。企业开始意识到,单一供应商的可靠性瓶颈,已成为制约业务扩展的最大短板。
SLA权重重构:能力溢价让位于稳定性底线
在传统的大模型选型逻辑中,基准测试分数(Benchmark)和参数规模往往是决定性的指标。企业愿意为更强的逻辑推理能力或更长的上下文窗口支付溢价。然而,连续17天的异常记录迫使CTO和技术决策者重新审视评估体系。在Agent深度集成的生产环境中,模型能力的差距通常以百分比计算,而宕机带来的损失则是100%的归零。当智能体自主执行任务时,任何一次请求失败都可能导致整个工作流的阻塞,这种级联效应在分布式系统中尤为致命。
因此,服务等级协议(SLA)的权重正在急剧上升。企业开始要求供应商提供更具约束力的可用性承诺,并将赔偿条款与实际业务损失挂钩。单纯的“尽力而为”式服务已无法满足核心业务的需求。技术团队在架构设计时,不再盲目追求单一模型的极致性能,而是更加关注系统的整体韧性。这意味着,即使某个模型在特定任务上表现优异,如果其稳定性无法达到99.9%以上的标准,它将被排除在核心生产链路之外,仅作为备用或实验性资源使用。这种转变标志着AI应用从“尝鲜期”正式进入“工业化期”,稳定性成为比智力更基础的准入门票。
架构演进:多云多模型路由成为标配
面对头部厂商的不确定性,企业AI架构正在经历一场深刻的范式转移。单一大模型依赖被视为高风险的技术债务,而“多云多模型路由”策略正迅速从加分项演变为基础标配。这一架构的核心思想是通过抽象层屏蔽底层模型的差异,根据实时健康状况、成本效益和任务类型,动态将请求分发到不同的模型服务商。例如,当检测到OpenAI API延迟升高或错误率超标时,流量可以无缝切换至Anthropic、Google或其他具备同等能力的模型节点。
这种架构不仅提升了系统的可用性,还赋予了企业更强的议价能力和灵活性。它打破了供应商锁定(Vendor Lock-in)的僵局,使得企业能够在不同模型之间进行套利,优化总体拥有成本(TCO)。同时,这也推动了中间件市场的繁荣,专门从事模型路由、负载均衡和故障转移的技术服务商应运而生。它们提供的解决方案能够实时监控各端点的健康状态,并在毫秒级时间内完成切换,确保前端业务的无感体验。对于大型科技企业而言,自建混合模型池也成为一种选择,通过结合开源模型和闭源API,构建更加自主可控的AI基础设施。
国产模型的机遇与挑战:承接溢出需求的稳定性大考
海外旗舰模型的频繁故障,客观上为国产大模型提供了宝贵的市场窗口。当国际巨头因负载过载而服务降级时,国内企业急需寻找可靠的替代方案以维持业务连续性。这不仅是市场份额的争夺,更是对国产模型工程化能力的实战检验。然而,机遇背后隐藏着巨大的挑战。国产模型要想真正承接这些溢出的高端需求,首要前提是自身的稳定性必须扛住同样的负载曲线。
目前,部分国产模型在单项基准测试中已接近甚至超越国际水平,但在高并发场景下的长期稳定性、API接口的标准化程度以及生态工具的完善度上,仍存在差距。如果国产模型在承接流量高峰时同样出现频繁抖动或宕机,那么这种替代只能是暂时的,无法建立长期的信任关系。因此,国内AI厂商需要将重心从单纯的参数竞赛转向基础设施的夯实,包括优化推理引擎效率、提升集群调度能力以及建立完善的容灾机制。只有在极端压力下依然保持坚挺,国产模型才能从“备胎”转正,成为全球AI供应链中不可或缺的一环。
结语:在不确定性中构建确定性
OpenAI的连续异常并非终点,而是AI工业化进程中的一个警示信号。随着智能体技术的普及,AI系统将像电力和网络一样,成为社会运行的基础能源。对于基础能源而言,稳定性高于一切。未来的竞争,将不再是单一模型智力的比拼,而是整个生态系统韧性的较量。企业需要摒弃对单一技术神话的迷信,转而构建多元化、模块化、高可用的AI架构。只有在不确定性中寻找确定性的工程解法,才能在Agent时代的浪潮中立于不败之地。这场关于稳定性的博弈,才刚刚开始。