AI数据爆发:从标注到RL环境,千亿赛道的底层逻辑重构
数据角色的根本性重构:从原材料到持续燃料
在人工智能产业的宏大叙事中,算力与大模型往往占据聚光灯的中心,但一个被长期低估的细分赛道正在悄然重塑行业格局——AI训练数据。这一领域不再仅仅是模型训练的辅助环节,而是演变为决定模型能力上限的核心基础设施。数据显示,仅2026年上半年,头部数据公司的收入增速便呈现出指数级爆发态势。以Mercor为例,其年化收入在九个月内从5亿美元飙升至20亿美元以上;而Handshake更是实现了从千万级到近11亿美元收入的百倍增长。这种惊人的增长速度背后,是数据在模型训练体系中角色的根本性重构。
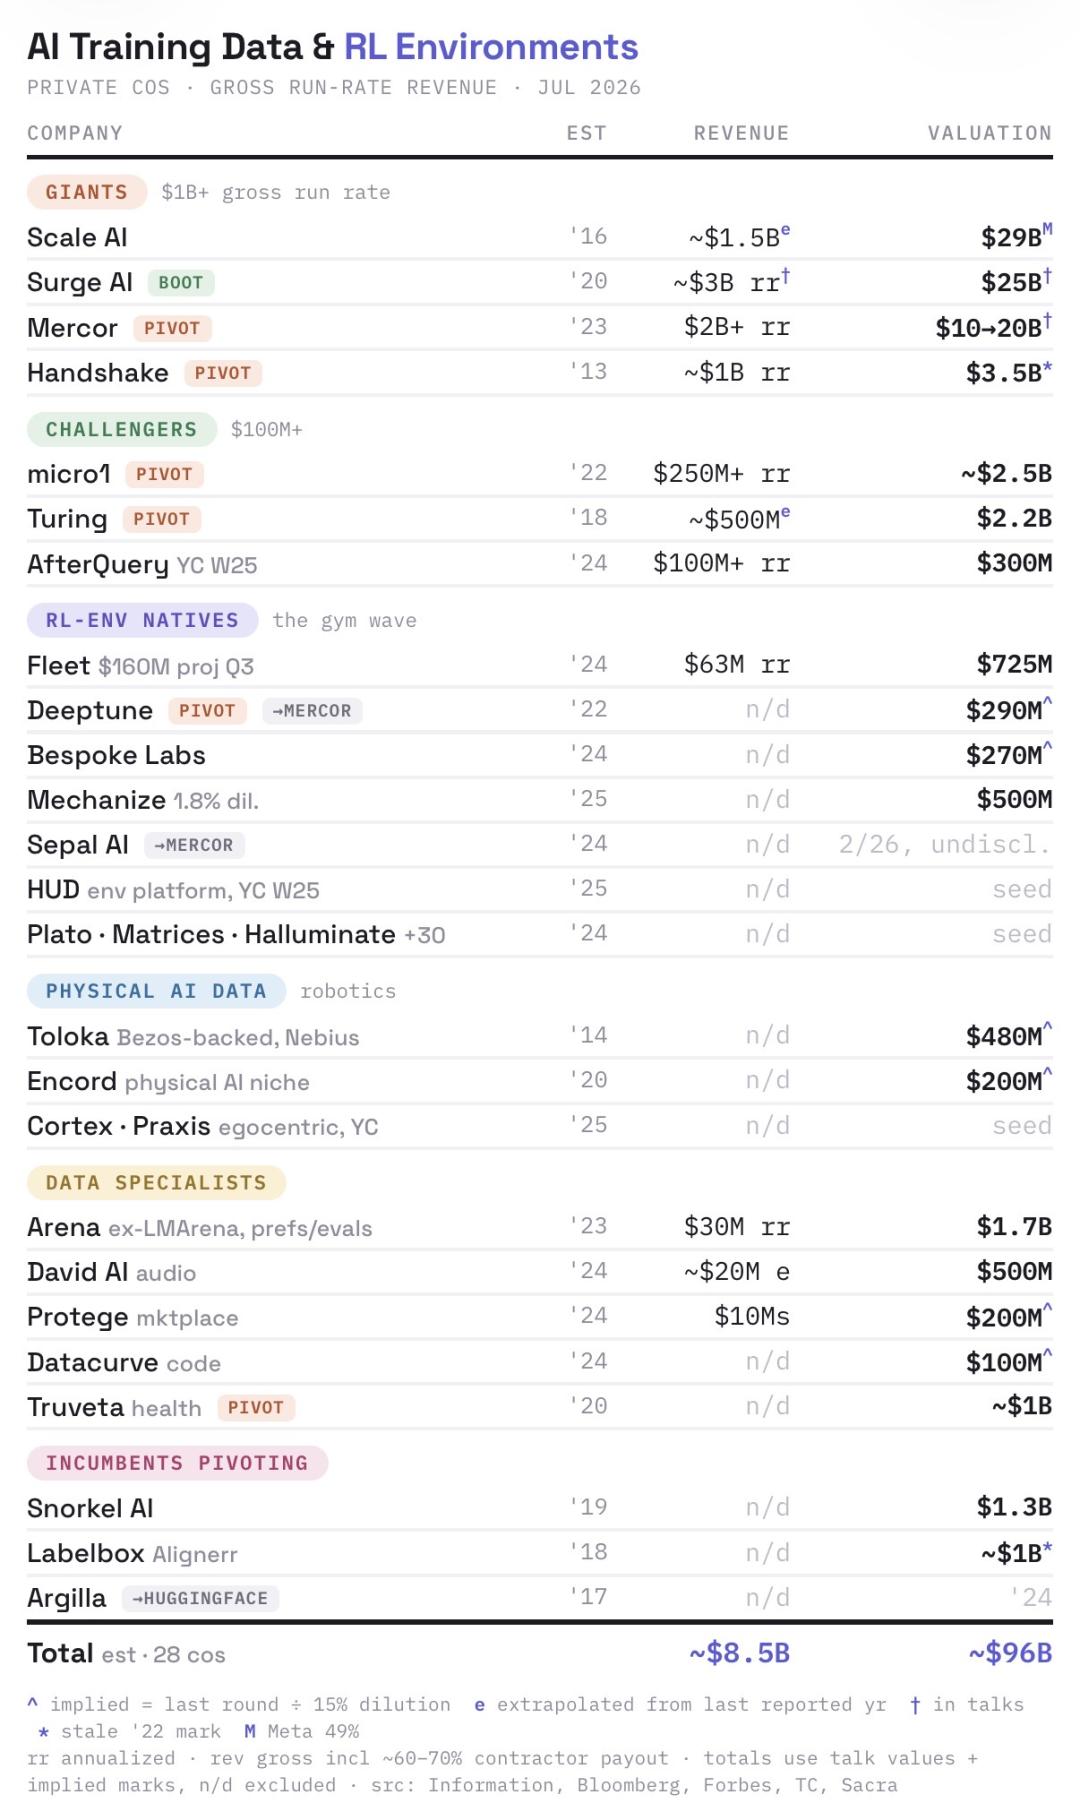
在过去的大模型发展初期,数据采购呈现出明显的“脉冲式”特征。实验室通常在新一代模型立项前进行集中采购,数据被视为一次性投入的原材料。然而,随着模型迭代周期的急剧缩短,这一模式已被彻底打破。从GPT-4到GPT-5系列的发布间隔已压缩至数周甚至数天,Anthropic等头部厂商的迭代节奏更为激进。高频次的迭代意味着模型需要持续不断地吸收新的、针对性的、高价值的数据来填补能力缺口。数据采购由此从低频的项目制转变为高频的日常动作,供给端也随之进化,Scale AI等公司甚至实现了按API调用的按需交付,最快一小时即可产出生产级标签数据。
需求侧的三重推力:频次、体量与单价
AI数据行业爆发式增长的底层逻辑,源于需求侧的三重推力叠加。首先是采购频次的常态化。模型迭代越快,发现的能力短板越多,对新增数据的需求就越频繁。这种高频需求迫使数据公司重构交付流程,从按月打包转向实时响应。
其次是单条数据信息密度的指数级膨胀。以代码智能体为例,早期的训练数据仅覆盖少数几个Python仓库,任务复杂度低,平均只需修改少量代码行。而最新的SWE-bench Pro基准测试,将范围扩展至四种编程语言和四十多个仓库,单条训练样本不仅包含需求理解、多文件定位,还涵盖跨文件修改与测试验证,其数据容量从几百个token激增至数万个token。这意味着,模型学习的不再是孤立的知识点,而是完整的工程工作流。
最后是数据单价的结构性上涨。传统的数据标注依赖众包工人,按件计酬,单价极低。但随着模型对数据质量要求的提高,标注工作逐渐由具备专业背景的博士、律师及资深工程师承担。Mercor等公司支付的STEM专家时薪高达90至110美元。这种从“劳动力外包”向“专业服务溢价”的转变,使得数据公司的毛利率显著提升。Mercor的毛利率已提升至35%-40%,Scale AI长期保持在50%以上,远超传统人力外包行业。数据不再仅仅是成本项,而是直接决定模型竞争力的战略资产,其定价权随之水涨船高。
趋势一:真实工作流数据取代人工标注
在数据供给端,一个显著的趋势是真实工作流数据(Type 1)正在取代人工设计任务数据(Type 2),成为新的稀缺资源。Type 2数据由专家在受控环境下完成,可控性强但缺乏真实世界的复杂性;而Type 1数据直接从真实业务中捕获,保留了问题从出现到解决的全链路信息,如GitHub上的代码提交记录,包含了需求描述、修改方案、代码评审及测试结果。
随着模型基础能力的增强,其在“做题”方面的表现已趋于饱和,下一步的提升依赖于对真实世界工作逻辑的理解。因此,供给端开始主动构建Type 1数据源。Handshake通过与OpenAI合作,组织自由职业者上传原生的办公文档和代码仓库,并启动“雇主数据计划”直接采购企业真实运营数据。Protege等新兴公司则聚焦于医疗等垂直领域,通过前置合规审查、AI精筛高价值阳性样本以及打包许可协议,将原本耗时数月的数据采购周期压缩至30天。这些公司本质上扮演了“数据买手”的角色,连接数据持有方与模型厂商,成为AI基础设施中不可或缺的一环。
趋势二:强化学习环境成为新宠
另一个关键变化是强化学习(RL)环境正在取代静态数据集,成为实验室采购的重点。随着AI从“对话时代”迈向“智能体时代”,模型的核心能力要求从回答问题转变为完成任务。静态数据集无法模拟动态交互,而RL环境提供了一个可控、可交互的模拟世界,让模型在其中通过试错、奖励与惩罚机制,自主探索并掌握任务执行能力。
目前,RL环境的构建主要有两种路径。一是模型厂商自建,如OpenAI为训练ChatGPT Agent搭建的“UI Gym”浏览器环境,单个网站环境搭建成本约2万美元,且规模庞大;Anthropic在RL环境上的年度投入预估超过10亿美元。二是外包给专业数据公司,Mercor收购Deeptune便是典型例证。Deeptune复刻了Excel、Salesforce等常用办公软件,构建高度仿真的沙盒环境。Mercor计划将RL环境业务的年化经常性收入提升至千万美元级别,显示出市场对这一领域的高度认可。
头部玩家的分化与价值链迁移
在行业快速演进的背景下,四大头部玩家——Scale AI、Surge AI、Mercor和Handshake——基于各自资源禀赋,走出了差异化的战略路径,但共同指向一个方向:从单纯的数据供应商向价值链更深处迁移。
Scale AI选择向下游延伸,致力于成为“政企AI总包商”。依托其深厚的数据积累,Scale AI开始为政府和大型企业开发内部AI应用,该业务板块年化收入已达2亿美元,预计将在18个月内超越传统数据标注业务,成为公司最大的收入来源。这种转型标志着数据公司开始直接参与模型的应用落地。
Surge AI则坚持向上走,走高端精品路线。作为一家未受外部融资、仅110人的公司,Surge AI专注于高难度的RLHF和安全评估,仅服务于OpenAI、Google等五家顶级实验室。其12亿美元的营收证明了在高端数据服务领域,专业深度比规模更具竞争力。
Mercor采取横向扩张策略,构建全球专家网络。通过招募博士、律师等专业人士制作专业训练数据,Mercor每天支付超过400万美元的报酬。同时,通过收购Deeptune进军RL环境,Mercor在专家网络之外布局了第二增长曲线,展现了极强的生态扩展能力。
Handshake则扮演“数据管道”的角色。凭借12年积累的1800万求职者资源和970家财富500强企业联系,Handshake不直接生产数据,而是高效搬运真实工作流数据。在Type 1数据成为稀缺品的当下,掌握供给两端的管道能力,使其占据了极具战略价值的生态位。
结语:数据工程的独立化与专业化
纵观整个AI数据行业的发展轨迹,单纯的数据标注正在迅速贬值,被压缩为价值链中利润最薄的一环。行业的主流趋势是向高附加值的数据工程、模型评测、合规处理及RL环境构建迁移。这一过程不仅提升了数据公司的盈利能力,也推动了AI产业分工的精细化。
上一代互联网巨头的能力边界由数据决定,而在这一轮AI竞赛中,数据已不再是巨头的副产品,而是一门独立的、奔向千亿美元规模的生意。对于从业者而言,理解数据角色的转变、把握真实工作流与RL环境两大趋势,并选择正确的价值链定位,将是应对这一变革的关键。随着模型能力的不断进化,数据作为AI燃料的价值将被进一步挖掘,行业格局也将随之持续重塑。