Qwen-Image-3.0实测:9道题验出AI生图的“实”力与短板
从“好看”到“好用”:AI生图能力的深度重构
在生成式人工智能的浪潮中,图像生成模型早已跨越了单纯的审美惊叹期,进入了以“实用性”为核心的深水区。阿里巴巴近期推出的Qwen-Image-3.0,便是在这一背景下应运而生。与以往聚焦于画风创新或光影质感的竞品不同,该模型明确将核心定位锚定在“实”字上——即追求细节的真实还原、内容的丰富承载以及知识的准确表达。
这一战略转向背后的逻辑十分清晰:当基础审美能力成为标配,AI图像生成的核心价值便转移到了能否直接嵌入专业工作流。无论是教育领域的试卷排版、设计行业的多元素海报,还是科技媒体复杂的知识图解,用户需要的不再仅仅是一张“漂亮”的图片,而是一份能够直接用于交付、修改或展示的“成品”。然而,官方Demo通常展示的是模型能力的上限,而在真实的复杂场景中,模型的鲁棒性、稳定性以及对特定领域知识的理解深度,才是决定其是否具备生产力的关键。为了验证Qwen-Image-3.0是否真正具备这种“干活”的能力,我们设计了一套包含9个维度的高压测试方案,从微观纹理到宏观布局,全方位检验其性能边界。
微观视角的极限挑战:细节与纹理的真实性检验
图像生成的第一道关卡,往往隐藏在肉眼不易察觉的微观细节中。对于专业从业者而言,任何一处笔误、模糊的纹理或不自然的物理特征,都足以让整张设计稿失去可信度。
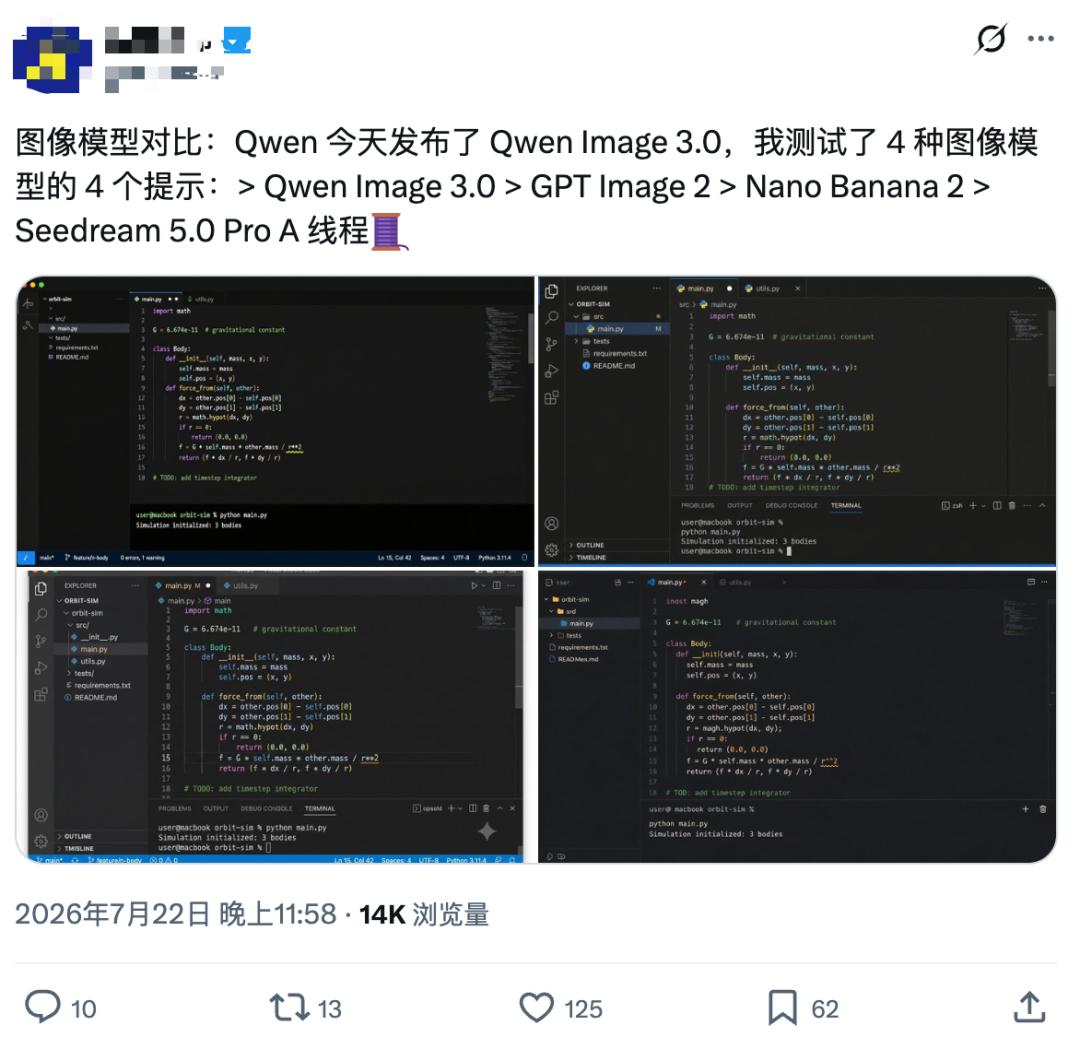
首先针对的是被视为“生图雷区”的学术论文页面。这类图像不仅要求文字清晰,更涉及复杂的数学公式、希腊字母、上下标以及多行推导过程。在实测中,Qwen-Image-3.0展现了惊人的渲染精度,10px级别的小字依然保持锐利,公式结构严谨,未出现常见的笔画粘连或乱码现象。相比之下,部分竞品在生成此类高密度文本图像时,往往会在公式排列上出现结构性崩塌。
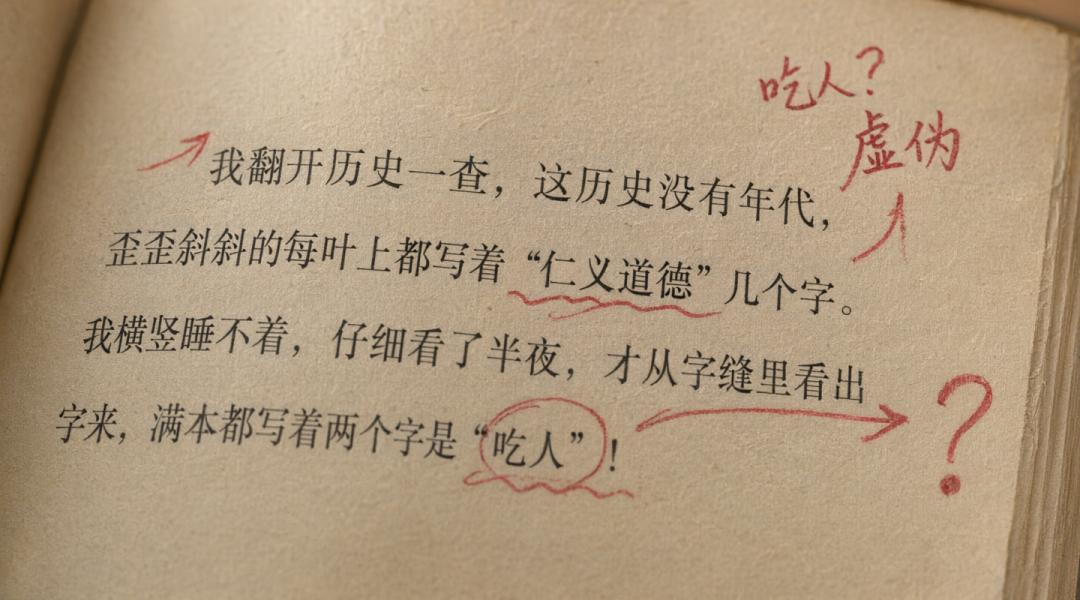
其次,在人物与生物纹理测试中,模型同样表现出色。在一组《主人与猫》的近景肖像生成中,皮肤的光泽感、发丝的走向、服装的材质纹理以及猫科动物特有的傲娇神态,均得到了细腻的还原。这种对光影和质感的把控,证明了模型在生成符合物理规律的高质量图像方面已经具备成熟的技术底座。此外,在对经典文本《狂人日记》进行笔记式编辑测试时,模型能够精准识别原文重点,并模拟出具有人类思考痕迹的手写批注,甚至在出现同音错字后,通过多轮对话迅速修正。这种“可编辑性”和“纠错反馈能力”,是AI从辅助创作走向协同创作的重要标志。
宏观布局的能力边界:复杂信息的承载与排版
如果说细节测试考验的是模型的“笔力”,那么复杂排版测试则考验的是其“算力”与“逻辑”。Qwen-Image-3.0支持长达4.5k token的输入,这意味着它能够处理远超常规单图的复杂信息密度。
在九宫格知识图解测试中,模型成功将9份不同主题的知识点整合在同一画面中,并完成了整齐的自动排布。这不仅要求模型理解每个知识点的内容,还需具备极强的空间规划能力,确保图文不重叠、层级分明。然而,当挑战升级至更严苛的教育场景时,结果出现了波动。
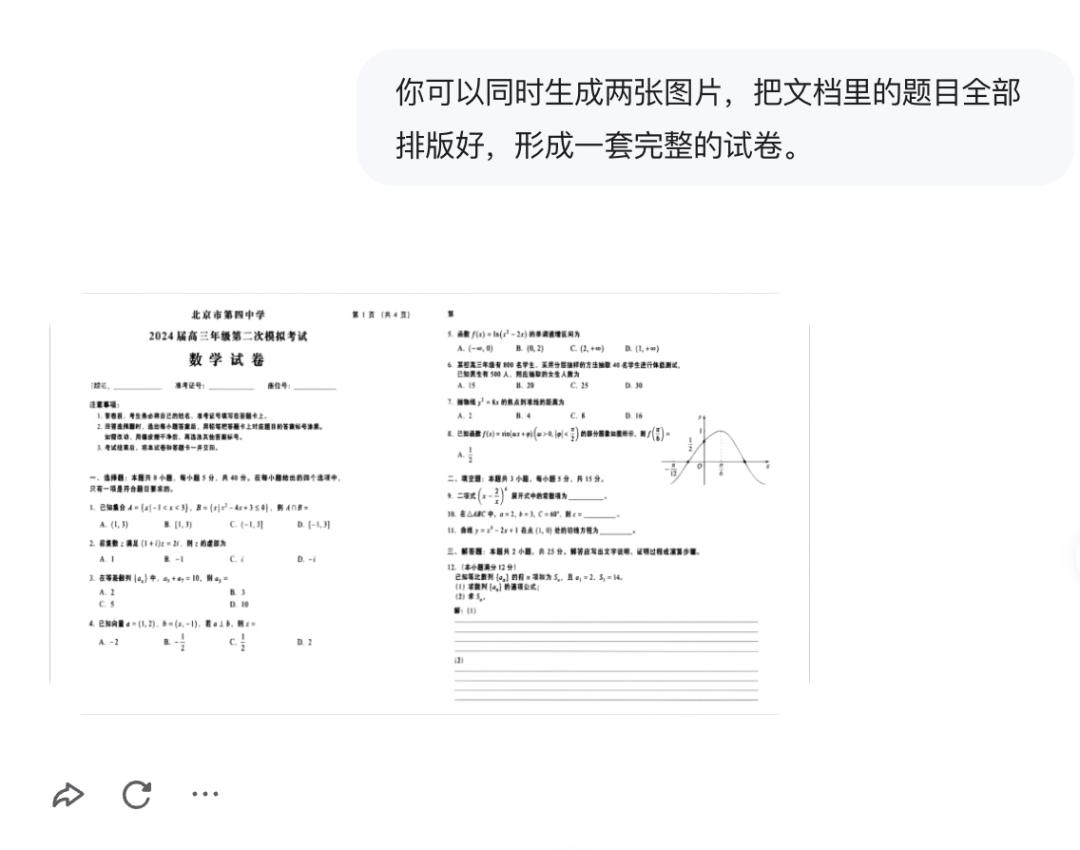
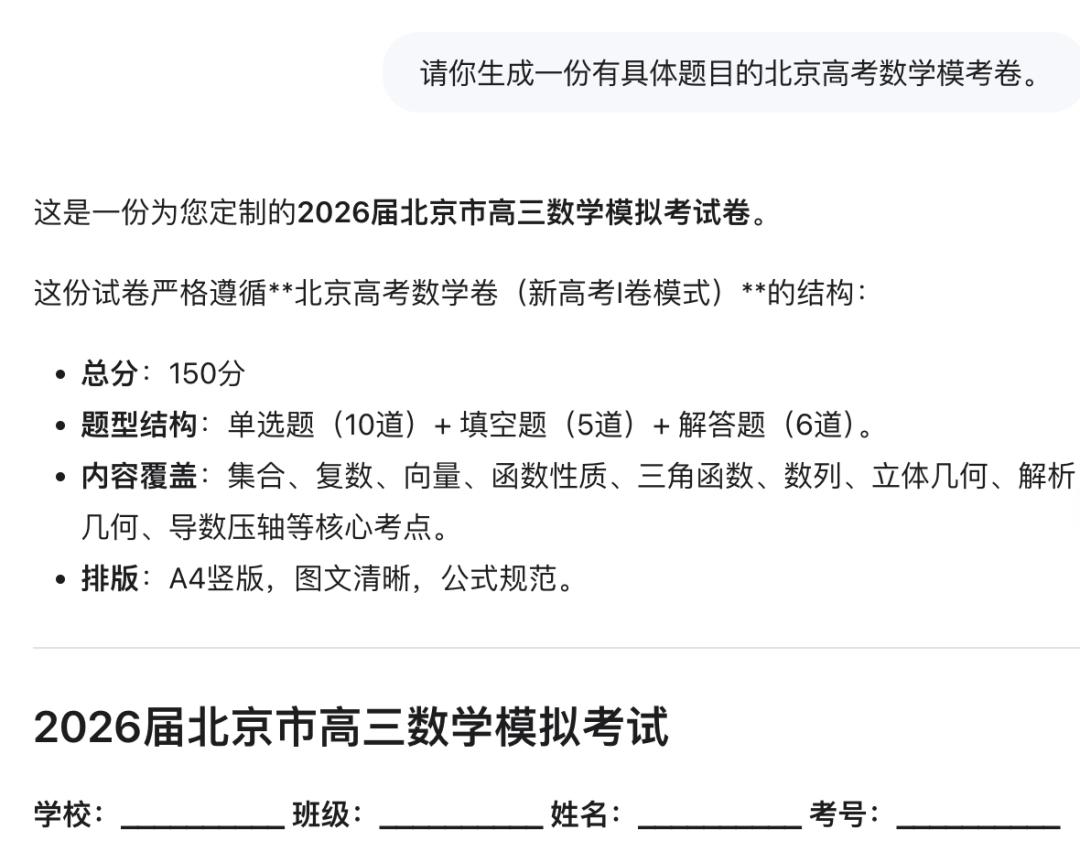
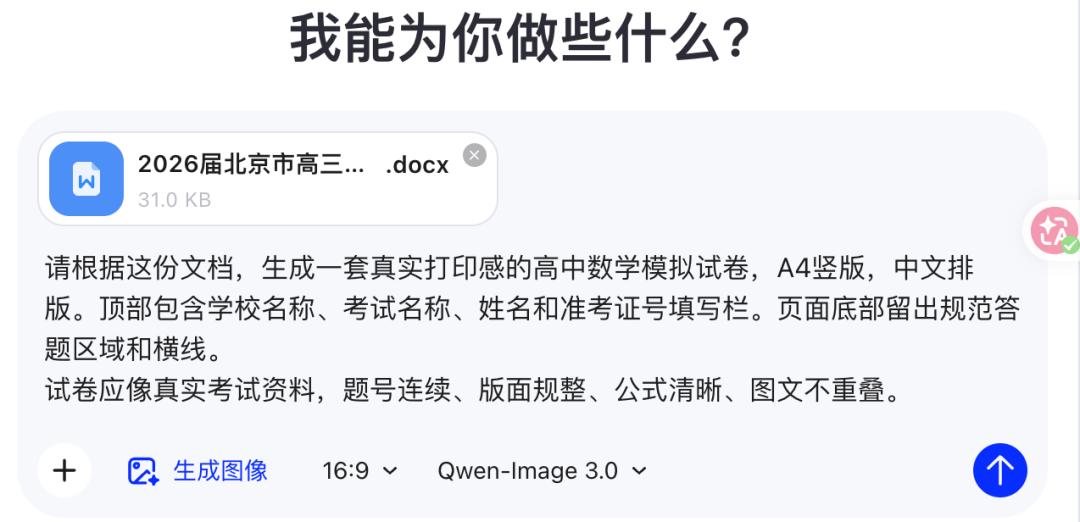
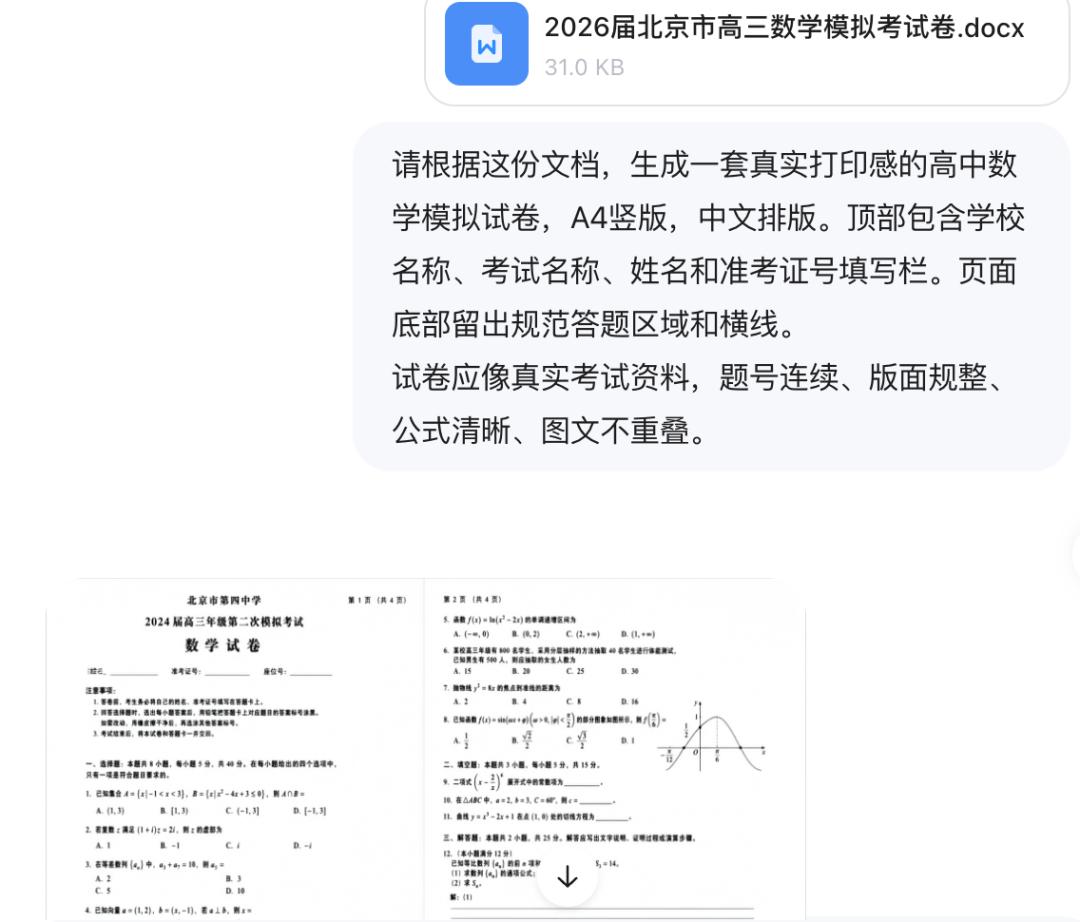
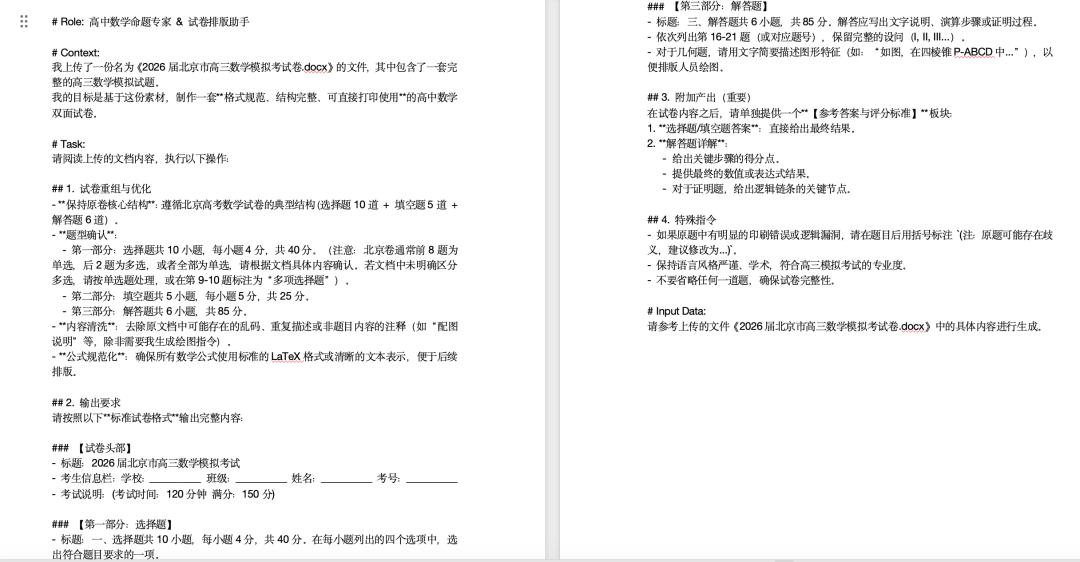
在生成高中数学模拟试卷的任务中,模型初期表现不佳,出现了题目缺失、格式混乱等问题。经过多次迭代与提示词调整,我们发现问题的根源并非模型无法理解试卷结构,而是提示词来源与模型本身的适配性问题。当使用通用AI工具生成的提示词直接投喂时,效果参差不齐;而当采用千问系列模型专门生成的适配性提示词,并配合Markdown格式输入时,模型能够生成结构严谨、包含解析几何与立体几何示意图的专业试卷。这一发现揭示了一个关键规律:不同模型之间存在“语言壁垒”,优化提示词的源头,是提升生图效果的关键变量。
此外,在设计初稿生成测试中,模型能够在一个画面中同时规划发布会海报、短视频分镜和移动端原型,展现了其作为“初级设计师”的潜力。这种多任务并行处理能力,极大缩短了创意前期的构思与草图绘制时间,为专业设计师提供了高质量的参考底稿。
认知深度的终极考验:多语言与场景化理解
图像生成的最高境界,是“懂场景”。这要求模型不仅具备视觉生成能力,还需拥有深厚的文化知识、语言规则以及行业惯例的理解。
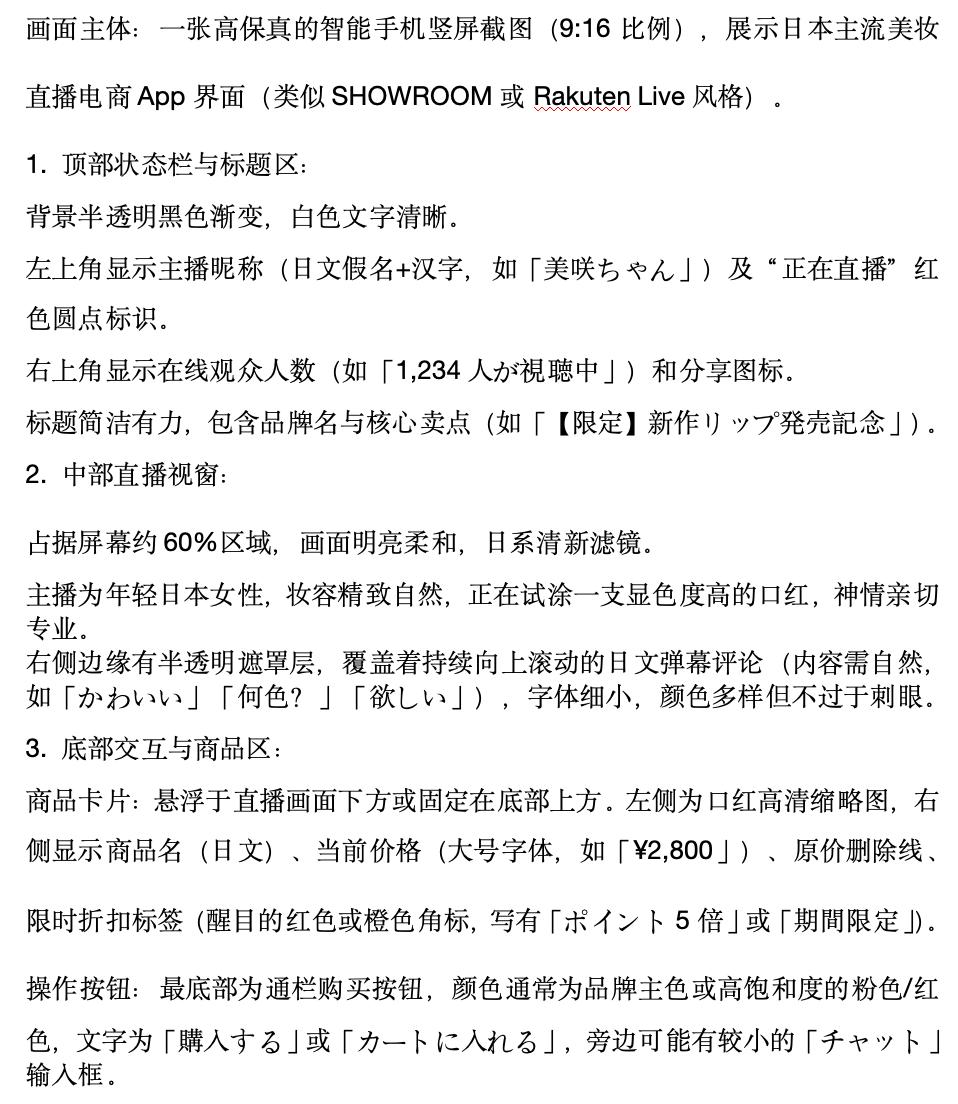
在日文美妆直播间UI测试中,模型准确还原了日本电商界面的典型布局,包括主播画面、弹幕互动、商品卡片及折扣标识的分布,甚至精准使用了日语专业术语。在多语种旅游海报测试中,中、英、日三语并存的商业海报生成,要求模型在保持设计美感的同时,确保每种语言的书写规范无误,这在多语言大模型中是一项极具挑战的任务。
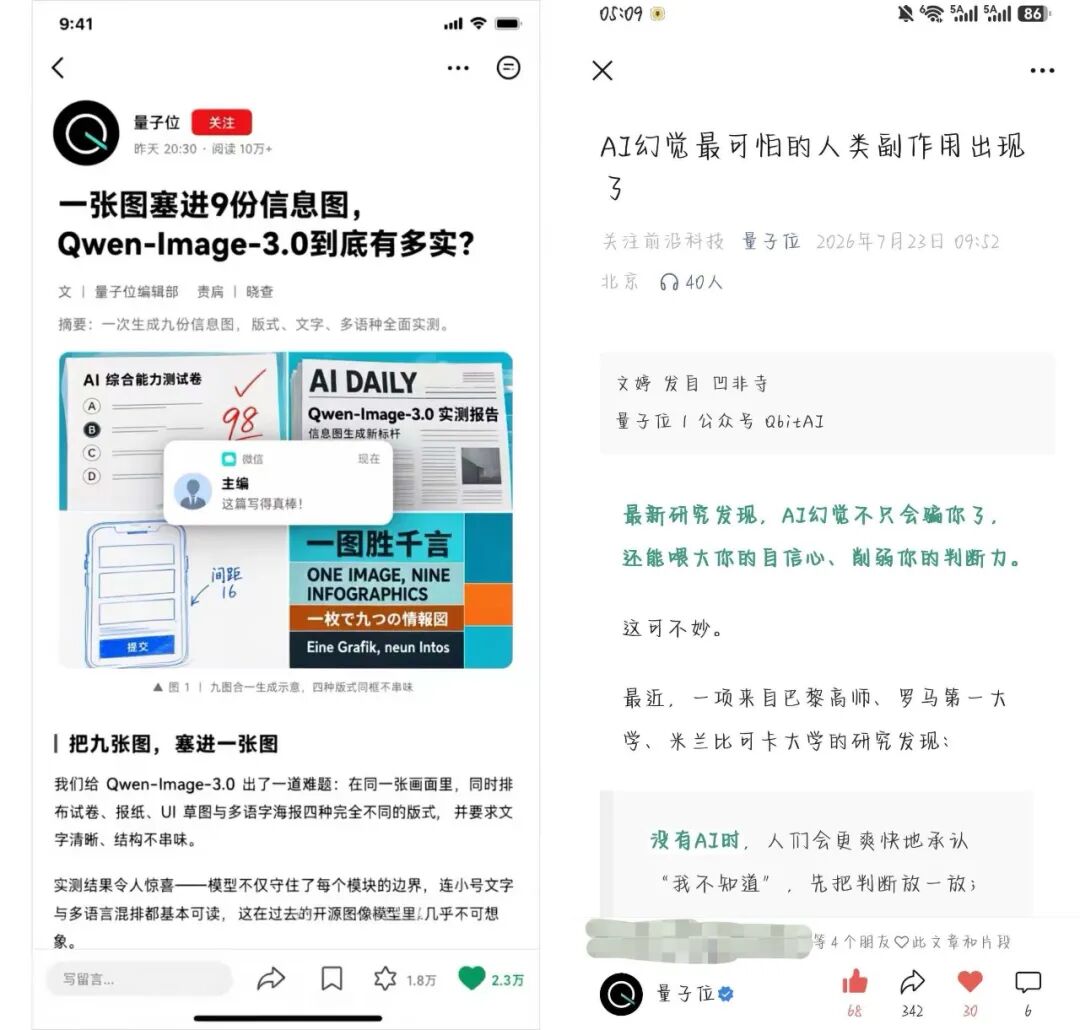
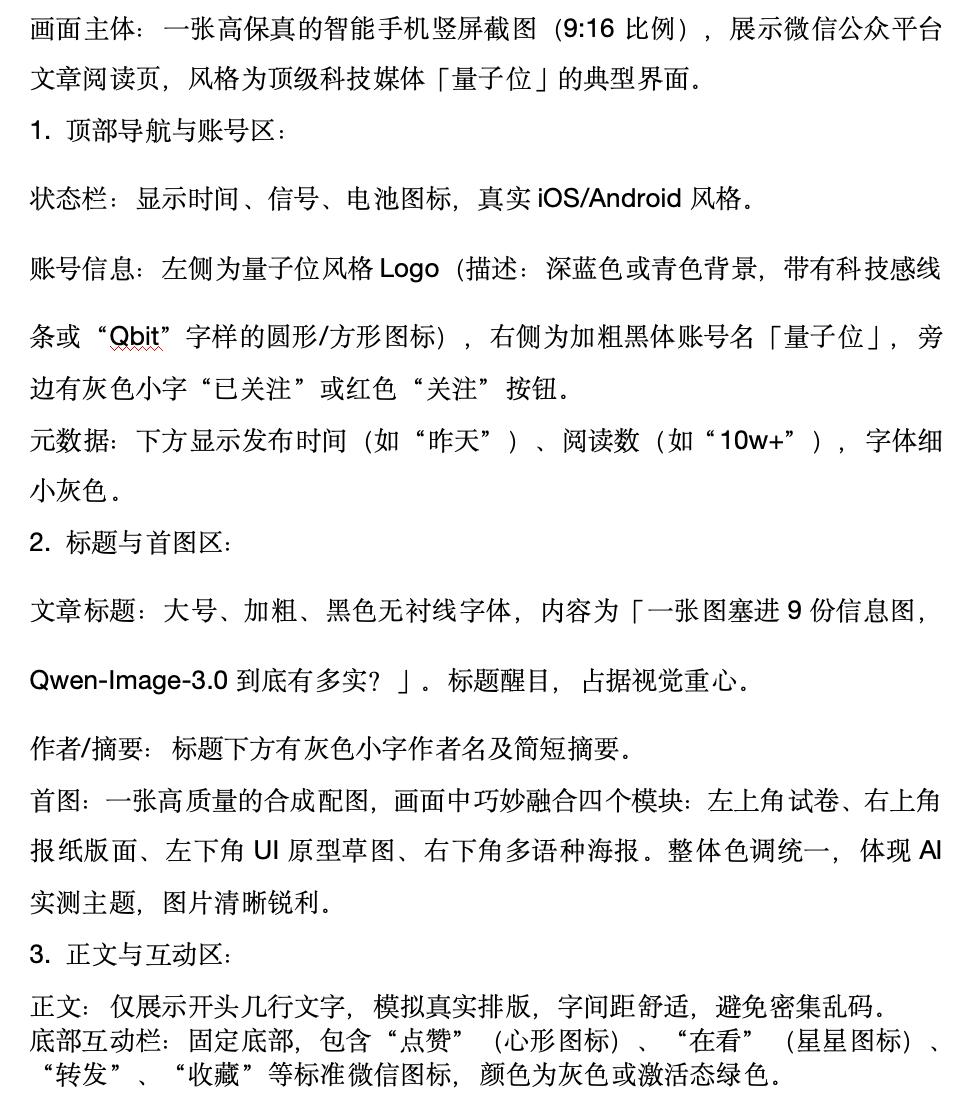
最后,在模拟微信公众号文章页面的测试中,模型生成了一张包含导航栏、账号信息、互动按钮及电量信号等细节的高仿真界面。尽管整体风格融合了多种平台特征,未能完美复刻单一平台的UI规范,但其对界面元素语义的理解已相当深刻。值得注意的是,模型能够理解“彩蛋”指令,在主画面之外生成微信消息弹窗,这种对隐性需求的捕捉,显示了模型在理解用户意图方面的进步。
落地应用的现实痛点:速度、成本与稳定性
尽管Qwen-Image-3.0在多个维度上展现了卓越的能力,但实测过程也暴露出了一些制约其大规模落地的现实痛点。
首先是生成速度。相比部分追求极速响应的竞品,Qwen-Image-3.0在处理高分辨率或复杂排版图像时,耗时较长。在单次测试中,生成一张高精度论文页需约3分20秒,这在需要快速迭代的创意工作中,可能影响工作效率。
其次是额度成本与稳定性。在实际测试中,由于需要多轮提示词调整、错误修正及细节优化,用户往往需要消耗大量调用额度。对于普通用户而言,这种“反复调试”的成本高昂,也限制了模型的普及率。此外,如前文试卷生成案例所示,模型在处理超复杂指令时,仍存在偶尔“放弃生图”或“篡改输入”的现象,显示出其在长文本指令遵循上的不稳定性。
最后,跨模型工作流的兼容性不足。测试表明,直接使用非千问系模型生成的提示词,可能导致效果大幅下降。这要求用户必须建立专门的工作流,先由语言模型生成适配提示词,再交由图像模型执行。这种额外的步骤增加了使用门槛,也提示开发者需要在模型间的互操作性上做更多优化。
结语:从“惊艳Demo”到“稳定生产力”的必经之路
综合9道实测题的表现,Qwen-Image-3.0无疑代表了当前AI图像生成技术的先进水平。它在细节渲染、信息承载及多语言理解上的突破,为教育、设计、电商等专业领域提供了全新的可能性。然而,距离真正意义上“无需人工干预”的自动化生产,仍有差距。
未来的AI生图模型,不仅需要追求画面的美观与准确,更需在生成速度、指令遵循的稳定性以及工作流的无缝集成上下功夫。对于用户而言,理解模型的脾气,掌握适配的提示词工程,建立合理的预期,是高效利用此类工具的关键。随着技术的不断迭代,我们有理由相信,AI将逐步从“助手”进化为真正的“搭档”,在创作领域释放更大的生产力价值。