Claude蒸馏自身:从操作录制到技能沉淀,AI自动化新范式解析
从SOP编写到示范学习:AI交互范式的底层重构
在传统的AI协作模式中,用户往往扮演着“指挥官”与“文档工程师”的双重角色。每当我们需要AI执行一项非标准化的复杂任务时,如整理海量素材、处理带有特定命名规范的财务报表,或者配置复杂的企业OA流程,用户必须将脑中模糊的直觉、肌肉记忆中的操作习惯,转化为精确、冗长且逻辑严密的文字说明。
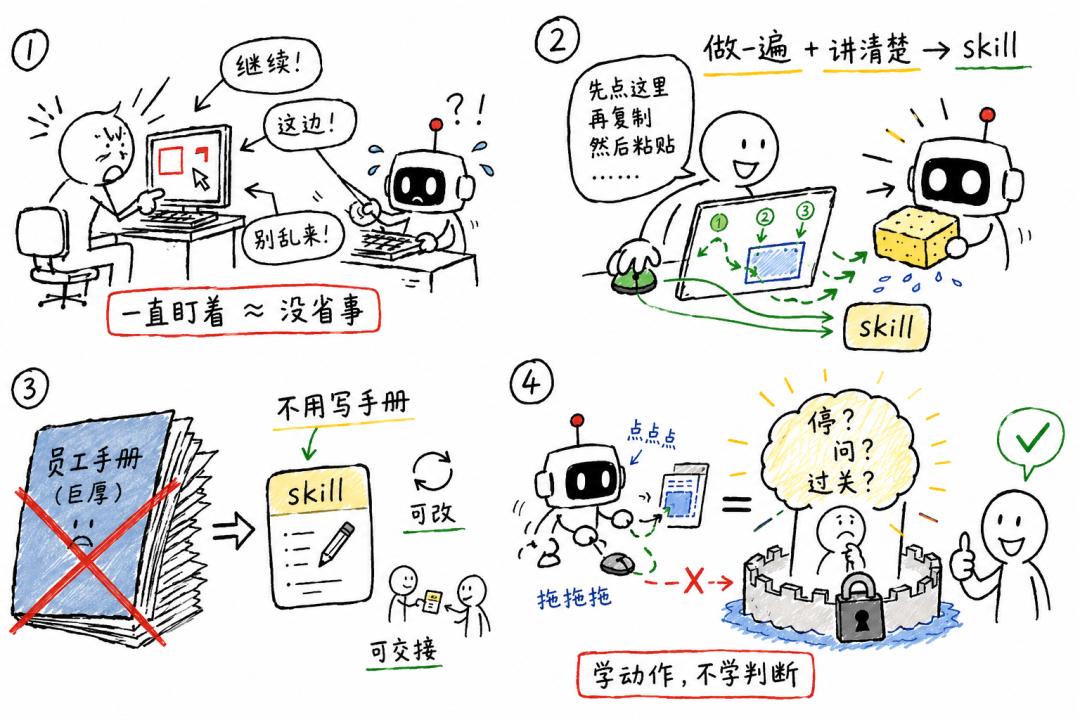
这种转换过程极其痛苦。正如许多内容创作者的经历所示,整理配图看似简单,但要向AI解释“为什么这张是官方截图”、“遇到重名文件如何处理”、“哪些文件绝对不能动”时,往往需要撰写一份堪比员工手册的SOP(标准作业程序)。这种高昂的认知负荷,使得许多重复性工作难以真正实现自动化。
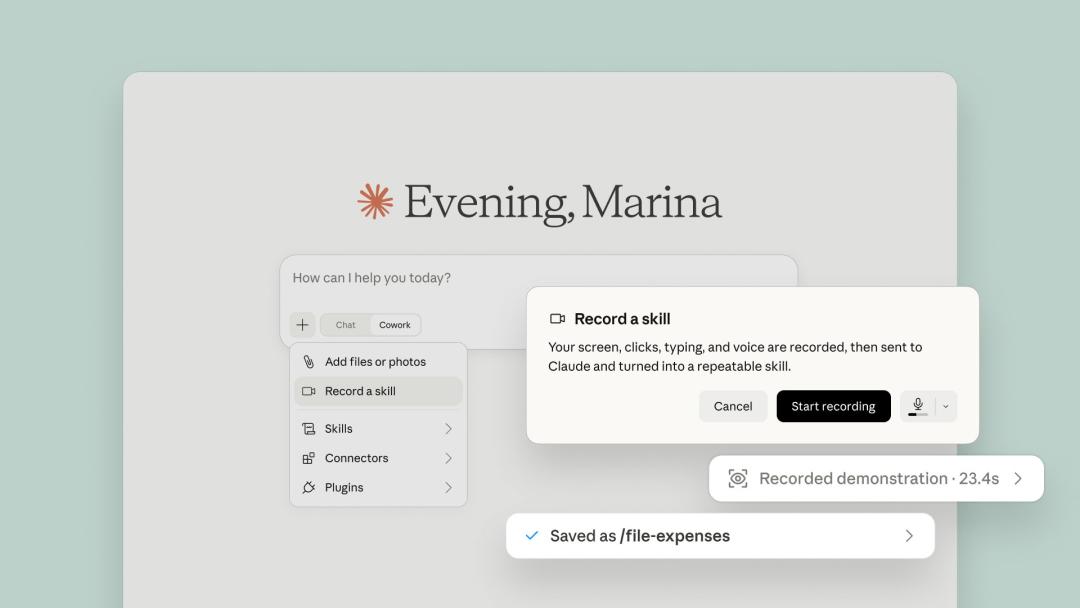
Anthropic近期在Claude桌面应用的Cowork模式中推出的“Record a skill”功能,标志着AI交互范式的一次重要跃迁。它不再要求用户先写规则再执行,而是允许用户在执行任务的同时,通过语音实时输出背后的逻辑与决策依据。Claude随后会将这一视听结合的示范过程,提炼并存储为一个可反复调用的“Skill”(技能)。
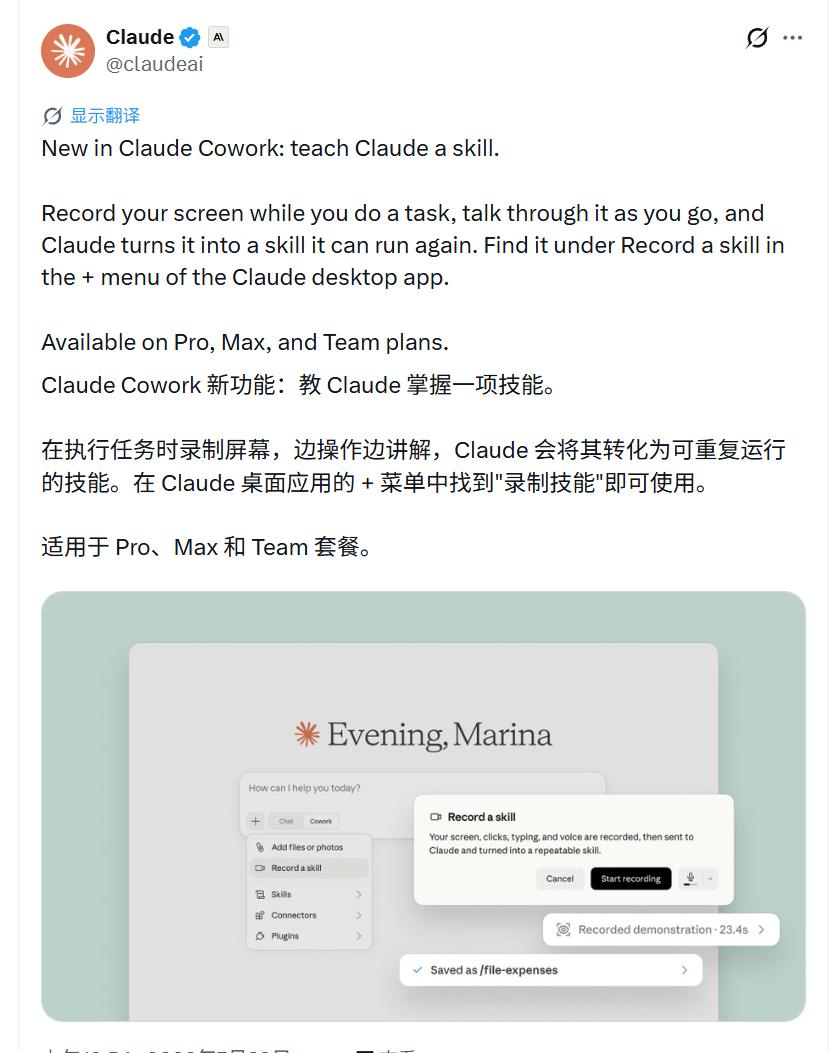
这一变化的核心意义在于,它将AI的学习方式从“文本指令驱动”转向了“行为与逻辑示范驱动”。正如网友所言,“做给AI看,比解释47遍强多了”。这不仅降低了自动化门槛,更重要的是,它捕捉到了那些深藏于人类操作习惯中的隐性知识——那些“只可意会不可言传”的细节,往往正是自动化最难攻克的部分。
技术溯源:Codex的先手与Claude的差异化路径
虽然Claude的“Record a skill”近期引发热议,但并非行业首创。OpenAI早在6月18日便在其Codex产品中上线了“Record & Replay”功能。两者在技术路线上呈现出有趣的异同。
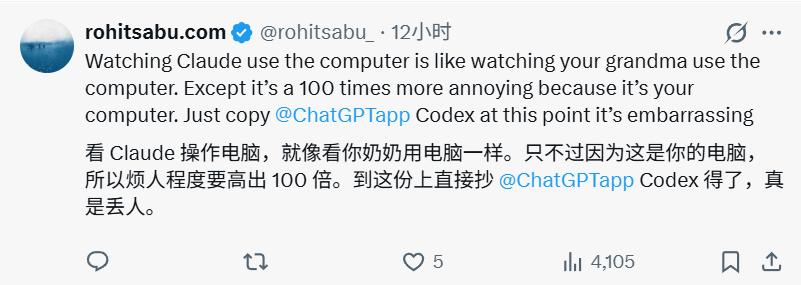
OpenAI的方案侧重于“视觉与操作”的还原。用户需在Mac电脑上开启Computer Use权限,允许Codex观察屏幕并控制鼠标键盘。Codex通过录制操作序列、窗口状态及补充的任务背景,生成一套包含输入、步骤及验证结果的Skill。其优势在于对视觉界面元素的直接映射,适用于报销、订位等步骤固定但界面交互繁琐的任务。
然而,纯操作录制存在显著局限。正如程序员鱼皮在实测网易云音乐FLAC下载流程时发现,Codex虽然能复现流程,但存在运行速度慢、偶尔点击错误等问题。更关键的是,它难以捕捉操作背后的“为什么”。如果用户只是机械地点击,AI学到的仅是“点击坐标”,而非“业务逻辑”。一旦界面微调或输入数据格式变化,基于坐标或固定路径的自动化极易失效。
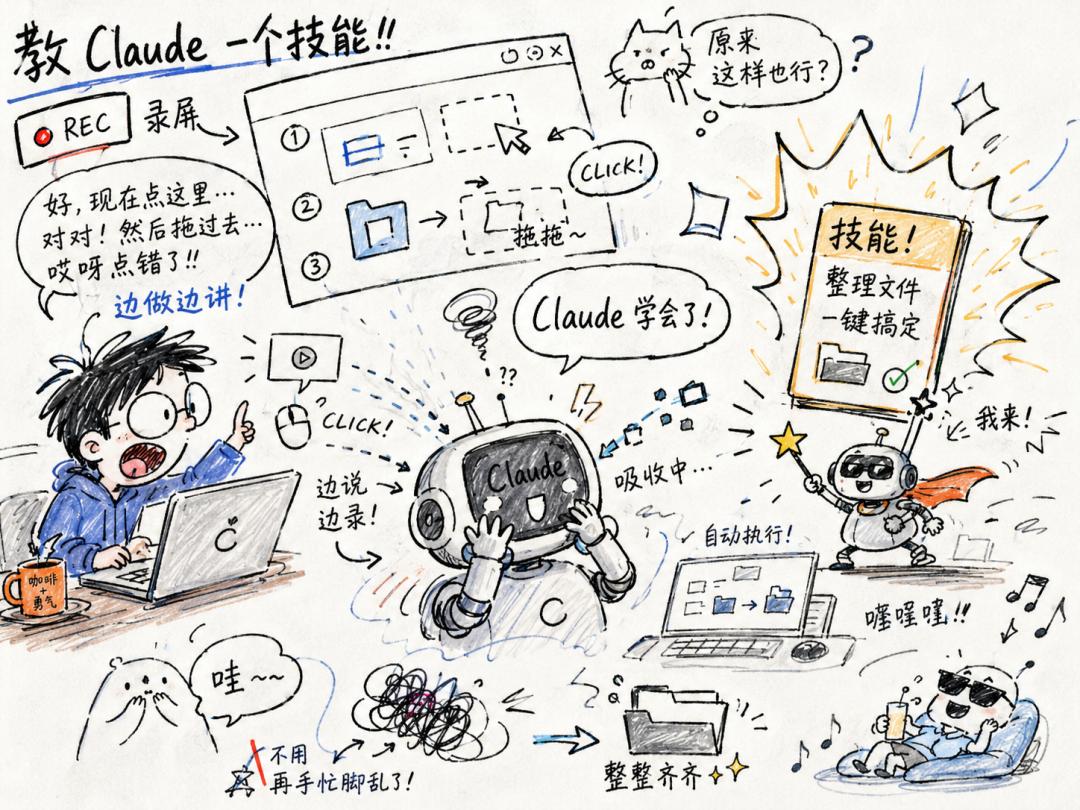
Claude的差异化策略在于引入了“语音旁白”机制。在录制过程中,Claude不仅记录屏幕画面和操作轨迹,更重点捕捉用户的语音解说。这种“视听双轨”模式,旨在让AI区分“动作”与“意图”。例如,在文件整理任务中,用户若说“我把这个拖到官方文件夹”,AI仅记录移动操作;若说“官方素材以official-开头,下次文件名会变,请按此规则分类”,AI则习得了分类逻辑。这种对逻辑抽象能力的追求,是Claude试图超越简单按键精灵的关键。
核心方法论:如何让AI学会“思考”而非“复读”
“Record a skill”功能的效能上限,完全取决于用户在录制过程中的表达能力。许多用户在使用初期遭遇失败,并非因为AI智商不足,而是因为提供的“教学素材”质量过低。若用户仅播报鼠标动作(如“我点击了这里”、“我输入了名字”),AI生成的Skill将沦为一次性的宏命令,缺乏泛化能力。
要训练出一个具备鲁棒性的Skill,用户需在录制时进行高频的“元认知”输出。建议遵循以下五个维度的旁白策略:
- 明确交付标准:清晰界定任务完成的标志。例如,“当清单生成且所有文件分类无误,并保存在指定路径时,任务结束。”
- 阐释判断逻辑:解释分类、筛选的依据。例如,“如果文件名包含日期且前缀为‘report_’,则归入月度报表文件夹。”
- 识别变量与常量:指出哪些元素是动态变化的,哪些是固定的。这有助于AI避免过拟合特定的一次性数据。例如,“今天的日期是变量,文件夹结构是常量。”
- 预设异常处理:提前定义边界情况。例如,“若遇到重名文件,不要覆盖,而是暂停并报告错误;若遇到未知前缀,询问用户而非自行猜测。”
- 定义结束条件:明确何时停止迭代。例如,“处理完当前文件夹下的所有图片后,停止录制。”
通过这种方式,用户实际上是在向AI传授一套可迁移的思维模型,而非单一的操作脚本。这使得生成的Skill能够适应新的数据批次和微小的环境变化,实现真正的自动化。
验证与验收:如何区分“真学会”与“过拟合”
Skill生成后的验收环节,是决定功能可用性的关键步骤。许多用户习惯于用同一批数据进行测试,这会导致严重的“过拟合”误判——AI可能只是记住了特定文件的排列顺序,而非掌握了分类规则。
科学的验收应采用“三轮测试法”,逐步增加数据的复杂度与不确定性:
第一轮:换数据测试。使用一批全新的文件,改变文件名的长度、数量、顺序,甚至混合不同前缀。观察Skill是否能依据录制的逻辑正确分类。若仅能处理原始数据,说明其未掌握逻辑。
第二轮:异常注入测试。故意在文件夹中放入无意义的文件、重名文件或不符合命名规范的异常文件。观察AI的反应。优秀的Skill应当能够触发预设的异常处理机制(如暂停、报错或询问),而非自信地执行错误操作。这是检验AI鲁棒性的核心指标。
第三轮:隐式触发测试。在不直接调用Skill名称的情况下,仅通过自然语言描述任务目标,观察AI是否能自动联想并调用相应的Skill。同时,连续运行多次,检查是否存在资源竞争、重复编号或覆盖文件等累积性错误。
只有通过这三层考验的Skill,才具备实际生产环境的部署价值。否则,它仅仅是一个记录好的视频回放,不具备任何智能决策能力。
风险警示与伦理边界:隐私、效率与人的主体性
尽管“自我蒸馏”功能极具吸引力,但其落地仍面临严峻的现实挑战。
首先是隐私与安全风险。录制过程会捕获整个屏幕画面、点击轨迹及语音内容,且数据会发送至云端处理。在办公场景中,用户极易在不知不觉中录下敏感信息,如银行密码、客户数据、内部战略文档等。因此,官方建议用户在独立环境中进行演示,但这大大限制了真实复杂工作流的直接复刻。用户需建立严格的数据隔离机制,避免在生产环境中直接录制涉及核心机密的流程。
其次是效率权衡问题。录制、生成及调试一个Skill的时间成本,远高于其单次运行节省的时间。对于偶尔发生的任务,自动化可能得不偿失。该功能的核心价值在于高频、长周期、步骤繁琐且逻辑复杂的重复性工作。对于低频任务,传统的快捷键或脚本可能更为高效。
最后,是人的主体性问题。AI“蒸馏”走的仅仅是操作层面的经验,而非核心的判断力。何时该停顿、何时该介入、如何平衡效率与质量,这些高阶认知能力仍由人类掌控。Claude的功能并非替代人类,而是作为人类经验的延伸与固化器。
随着技术的迭代,我们正从“指令式AI”迈向“示范式AI”的新阶段。这一转变降低了AI的使用门槛,但也提高了对用户的认知要求。用户不再仅仅是使用者,更是训练师。能否通过精准的示范,将隐性的专业能力转化为显性的机器技能,将成为未来职场竞争力的重要分水岭。Claude的“Record a skill”只是一个起点,其背后的核心逻辑——如何让AI理解并继承人类的隐性智慧——将是人工智能领域持续探索的深水区。