算力生死局:超节点如何重构AI基础设施与供应链博弈
在人工智能浪潮席卷全球的当下,算力的争夺战已进入深水区。曾经被视为核心资产的独立GPU加速卡,正逐渐退居幕后,取而代之的是一个更为庞大、复杂且紧密耦合的系统形态——超节点。这一转变并非简单的硬件升级,而是AI基础设施底层逻辑的根本性重构。当大模型的参数量突破万亿大关,传统的“单机八卡”模式已无法支撑日益膨胀的计算需求,行业被迫向“万卡”乃至“十万卡”集群演进。在这种背景下,超节点作为一种具备“一台计算机”特征的高密度计算系统,成为了连接芯片物理极限与应用层无限需求的唯一桥梁。
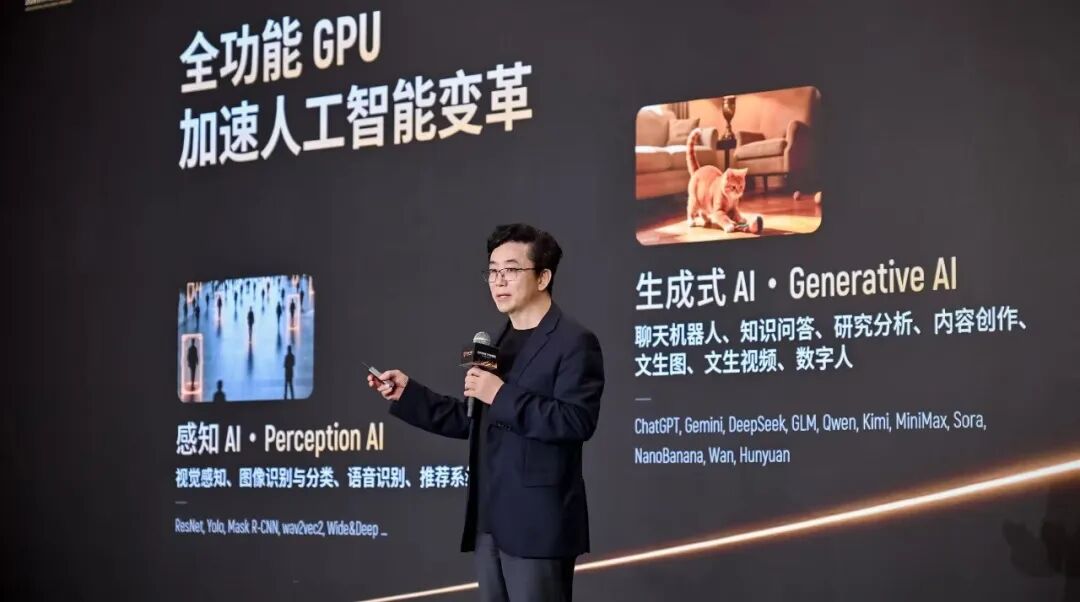
超节点的崛起,本质上是算力供需矛盾激化后的必然产物。随着Kimi K3等超大参数模型的发布,训练与推理的成本呈指数级上升。对于大模型厂商而言,算力不再仅仅是生产工具,更是决定生死的核心资产。数据显示,行业普遍存在1美元收入对应约0.8美元算力成本的现象,这意味着算力效率直接决定了企业的盈利能力和估值空间。因此,头部云厂商和政企客户不再满足于零散的服务器采购,而是将规模化的超节点部署作为标配。这种趋势直接推动了相关产业链的资本狂欢,紫光股份、浪潮信息等基础设施提供商的股价飙升,正是市场对这一确定性增长赛道的强烈回应。
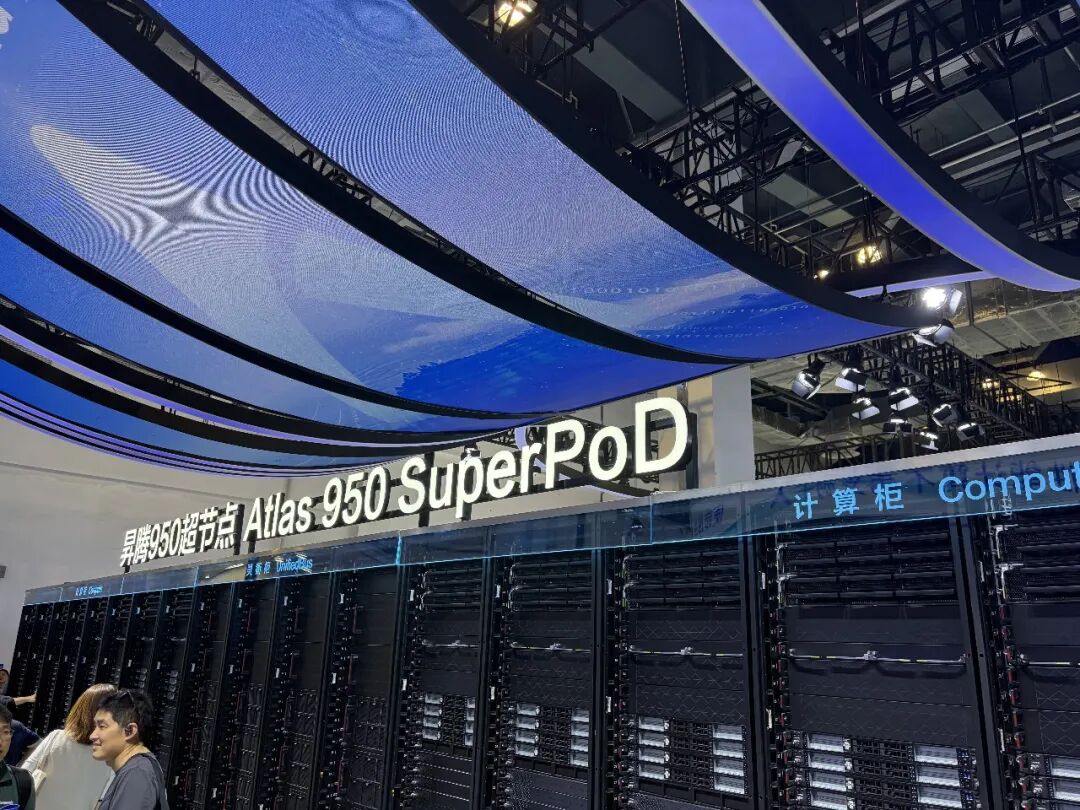
然而,超节点的价值不仅仅体现在算力规模的扩张上,更在于其系统工程的复杂性。它要求芯片、互联协议、散热系统、电力供应以及软件栈之间实现深度的协同优化。华为推出的“昇腾950超节点”便是全栈自研路线的典型代表,通过从芯片架构到散热设计的全链条掌控,实现了系统效率的最大化。相比之下,中兴通讯等厂商则选择了开放生态路径,通过整合壁仞科技、沐曦股份等多家合作伙伴的芯片资源,为客户提供灵活的多芯协同方案。这两种路线并无绝对优劣之分,而是针对不同客户群体和应用场景的差异化选择。全栈自研适合追求极致性能和控制力的大型科技企业,而开放生态则更能满足多样化、定制化的市场需求。
在超节点的内部架构中,一个显著的变化是CPU地位的重新崛起。过去,GPU被视为AI计算的绝对核心,CPU仅负责简单的任务调度。但在多智能体(Agent)时代,复杂的逻辑推理、记忆管理和上下文处理更多地依赖于CPU和内存系统。随着Agentic AI应用的普及,CPU与GPU的比例正在发生逆转,从早期的8:1逐渐向1:1甚至1:2演变。这意味着,未来的智算机房将不再是单纯的GPU集群,而是以CPU为中心,融合GPU、高速存储和网络交换的综合计算平台。这一变化对供应链产生了深远影响,导致服务器级CPU出现供不应求和价格上调的现象,进一步加剧了算力资源的紧张局势。
与此同时,存储和网络互联也成为制约超节点性能的关键瓶颈。智能体应用需要依赖海量的知识库和上下文缓存(KV Cache),这对存储的容量、带宽和低时延提出了极高要求。高带宽内存(HBM)作为关键组件,其供应紧张程度甚至超过了GPU本身。在网络层面,随着集群规模的扩大,传统的铜缆互联在带宽和距离上已触及物理极限,光互联技术成为必然选择。然而,光模块对温度极其敏感,与高功耗AI芯片封装在一起时,热耦合问题变得异常棘手。这不仅考验着厂商的光电集成能力,更对散热系统的设计提出了全新挑战。
散热与能源管理是超节点商业化落地中不可忽视的另一大难题。超节点的高密度部署意味着单位面积内的功耗急剧增加,传统的风冷方案已难以应对。虽然液冷技术被视为解决方案,但其高昂的改造成本和复杂的维护要求让许多企业望而却步。华为推出的风冷超节点试图在不进行大规模液冷改造的前提下,通过优化气流设计和热分布来解决高密度散热问题,这是一种务实的工程创新。此外,超节点的电力架构设计也远比想象中复杂,它涉及到供电链路的协同设计、电能转换效率以及电网稳定性等多个维度。任何环节的短板都可能导致整个集群的性能下降甚至故障停机。
从商业角度来看,超节点的高昂成本决定了其目前仍是少数科技大厂和头部创业公司的游戏。数百万至数千万元的投入,要求企业必须精确计算投资回报率(ROI)。关键在于Token的吞吐效率能否“跑满”,即硬件资源是否被充分利用。如果算力闲置,再先进的超节点也是负担。因此,越来越多的企业开始转向算力租赁模式,通过九章云极等算力运营平台获取弹性算力资源。这种模式类似于高速公路和换电站,将重资产投入转化为按需付费的服务,降低了中小企业的进入门槛,同时也提高了社会整体算力资源的利用效率。
展望未来,超节点的竞争将从单纯的算力数字比拼,转向系统完整性和生态兼容性的较量。谁能提供更稳定、更高效、更易用的全栈解决方案,谁就能在市场中占据主导地位。这要求厂商不仅要有强大的硬件制造能力,还要具备深厚的软件优化经验和生态系统构建能力。例如,奕行智能推出的RISC-V AI算力超节点,展示了非x86架构在特定场景下的潜力;而摩尔线程建立的模型训练工厂,则体现了软硬件一体化服务的价值。这些探索表明,超节点市场并非赢者通吃,而是可能形成多元共存的格局。
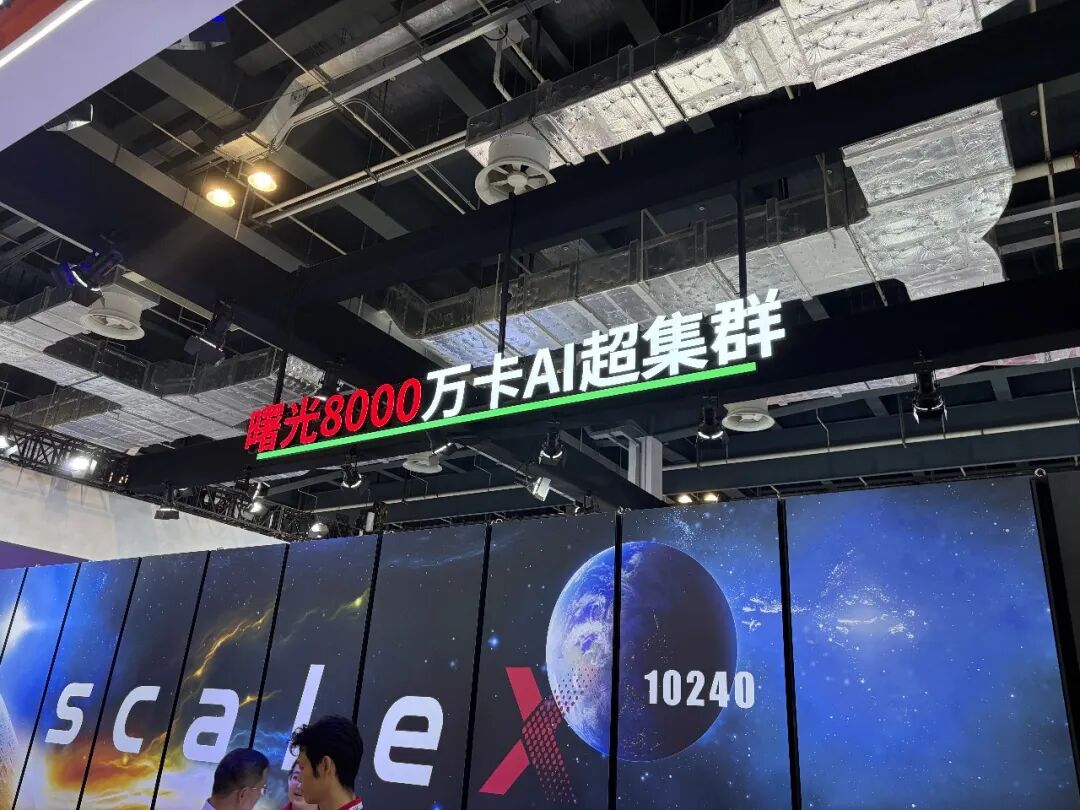
在这场基础设施战争中,GPU的重要性相对下降,而系统级优化能力的重要性显著提升。企业需要重新审视自身的算力战略,从关注单点硬件性能转向关注整体系统效率。这包括优化CPU与GPU的资源分配、提升存储系统的读写速度、改进网络互联的低时延特性,以及完善散热和能源管理系统。只有通过这些系统级的创新,才能在激烈的市场竞争中立于不败之地。
此外,超节点的发展还将深刻影响全球半导体供应链的重构。随着中国厂商在超节点领域的快速崛起,国产芯片、互联协议和基础软件的成熟度将得到进一步提升。这不仅有助于降低对外部技术的依赖,还将推动全球算力基础设施向更加多元化、自主化的方向发展。在这个过程中,技术创新与商业模式的创新将相辅相成,共同推动人工智能产业迈向新的高度。
综上所述,超节点不仅是AI算力发展的必然趋势,更是检验科技企业系统工程能力的试金石。它要求企业在芯片、软件、散热、网络等多个维度上进行深度整合与创新。对于那些能够驾驭这一复杂系统的企业来说,超节点将成为其通往人工智能巅峰的有力武器;而对于那些固守传统思维的企业来说,这可能是一道难以跨越的鸿沟。在未来的算力竞争中,唯有那些具备全局视野和系统思维的玩家,才能在这场生死局中脱颖而出。